Co je DINOv3 Vision Transformer?
DINOv3 Vision Transformer pro analýzu povrchů infrastruktury
Samoučící se učení a DINO
Samoučící se učení (SSL) je paradigma strojového učení, kde se model učí smysluplné reprezentace z neoznačených dat definováním pretextové úlohy, která nevyžaduje lidské anotace. Model musí předpovídat některou část dat z jiných částí, využívaje inherentní strukturu a vzorce ko-výskytu v samotných datech. V počítačovém vidění se metody SSL vyvinuly od ručně vytvořených pretextových úloh, jako je předpovídání úhlu rotace obrázku (RotNet), řešení skládaček z promíchaných dlaždic nebo kolorizace černobílých obrázků, k sofistikovanějším kontrastivním a destilačním přístupům. Základní výhodou SSL je, že umožňuje trénink na webových datech bez prohibitivních nákladů na ruční anotaci. Pro aplikace v infrastruktuře, kde jsou označené datové sady vad vzácné a drahé na vytvoření (vyžadující certifikované inspektory a inženýry), umožňují backbone založené na SSL efektivní učení rysů z obrovského množství neoznačených snímků před jakýmkoli doladěním specifickým pro úlohu.
TarmacView hodnocení vozovek je v aktivním vývoji a zatím není nabízeno.
Kontrastivní učení metody jako SimCLR, MoCo a SwAV se učí reprezentace přitahováním augmentovaných pohledů stejného obrázku (pozitivní páry) k sobě v embeddingovém prostoru, zatímco odpuzují pohledy různých obrázků (negativní páry) od sebe. Tyto metody vyžadují pečlivé zacházení s negativními vzorky, příliš málo negativ snižuje výkon, příliš mnoho zvyšuje výpočetní náklady. Nekontrastivní metody jako BYOL, SimSiam a DINO se zcela vyhýbají potřebě negativních párů pomocí asymetrických síťových architektur a operací zastavení gradientu k prevenci kolapsu reprezentace. DINO (self-DIstillation with NO labels), představený Caronem a kol. v Meta AI v roce 2021, patří do této nekontrastivní rodiny a stal se jedním z nejvlivnějších metod SSL v počítačovém vidění. Původní článek DINO demonstroval, že SSL a Vision Transformery mají jedinečnou synergii, mechanismy self-attence ve ViT přirozeně vytvářejí sémantické segmentační mapy bez jakéhokoli dohledu, což je vlastnost, která vzniká z interakce mezi strategií vícenásobných ořezů a cílem self-destilace.
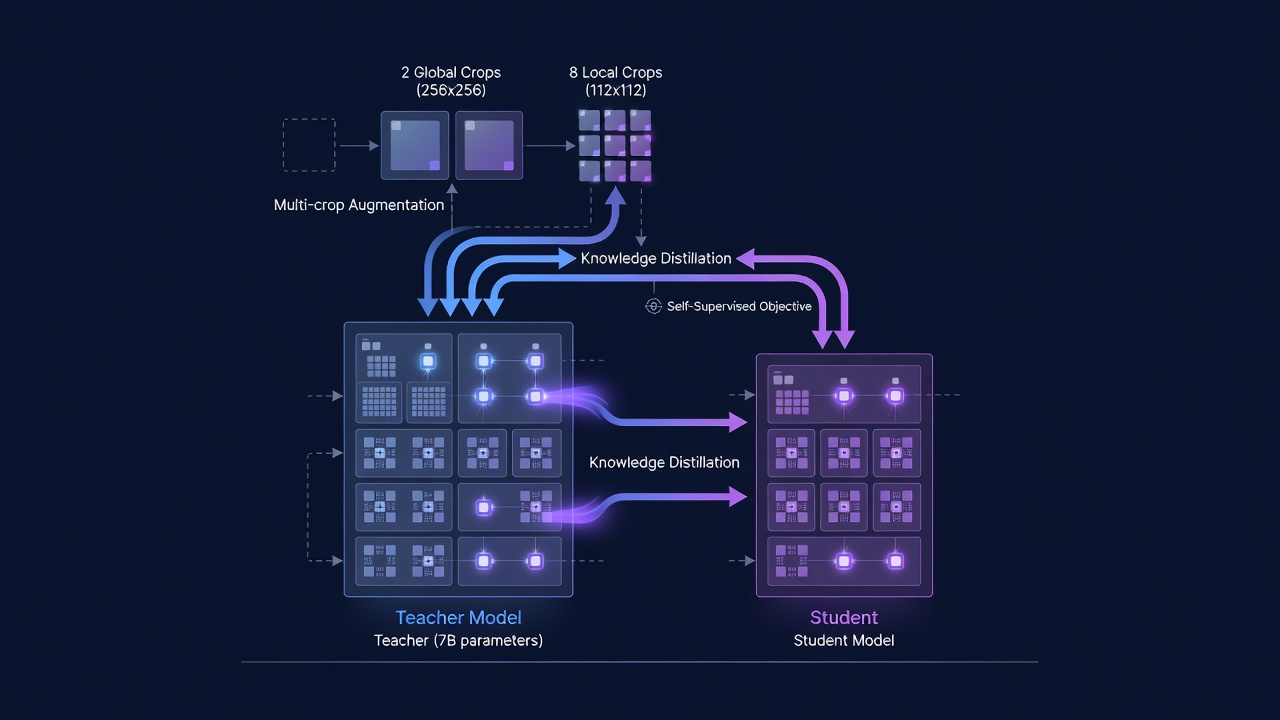
Tréninkový rámec DINO funguje následovně. Pro každý vstupní obrázek jsou generovány dva globální pohledy (pokrývající více než 50 % plochy obrázku, typicky 224x224 pixelů) a několik lokálních pohledů (menší ořezy pokrývající méně než 50 % plochy obrázku, typicky 96x96 pixelů) pomocí náhodného ořezu s změnou velikosti, barevného rozptylu a Gaussova rozostření. Všechny pohledy procházejí sítí studenta (Vision Transformer). Globální pohledy také procházejí sítí učitele, která sdílí stejnou architekturu jako student, ale má různé parametry. Parametry učitele se neučí pomocí gradientů, místo toho jsou aktualizovány jako exponenciální klouzavý průměr (EMA) parametrů studenta. Základním tréninkovým cílem je, aby výstupní distribuce studenta odpovídala výstupní distribuci učitele pro globální pohledy, zatímco lokální pohledy poskytují další tréninkový signál pouze prostřednictvím studenta. Toto uspořádání učitel-žák, známé jako self-destilace, vytváří učící signál, který nevyžaduje štítky, student se učí vytvářet konzistentní reprezentace napříč různými augmentacemi stejného obrázku, což ho nutí zachytit invariantní sémantický obsah spíše než povrchní detaily na úrovni pixelů.
DINOv1 (2021) demonstroval tři klíčové emergentní vlastnosti samoučících ViT. Zaprvé, mapy pozornosti z tokenu [CLS] na dlaždice obrazu přirozeně segmentují objekty od pozadí, což je vlastnost, která vzniká čistě ze samoučení bez jakýchkoli segmentačních štítků. Zadruhé, naučené rysy vykazují vynikající výkon k-NN klasifikace, jednoduchý klasifikátor nejbližšího souseda v prostoru rysů DINO dosahuje 78,2% top-1 přesnosti na ImageNet bez jakéhokoli doladění. Zatřetí, rysy DINO vykazují silnou sémantickou korespondenci napříč různými instancemi stejné třídy objektů, což umožňuje aplikace ve vyhledávání obrázků, ko-segmentaci a segmentaci objektů ve videu. Tyto vlastnosti učinily DINO základní metodou v prostředí samoučícího se učení a připravily půdu pro DINOv2 (2023) a DINOv3 (2025).
Architektura ViT
Vision Transformer (ViT) architektura, představená Dosovitskiym a kol. v Google v roce 2021, adaptuje architekturu Transformer z zpracování přirozeného jazyka na počítačové vidění tím, že zachází s dlaždicemi obrazu jako s analogií slovních tokenů. Na rozdíl od konvolučních neuronových sítí (CNN), které zpracovávají obrazy prostřednictvím lokálních receptivních polí s vestavěnou translační equivariancí, ViT aplikují globální self-attence napříč všemi dlaždicemi současně, což modelu umožňuje zachytit dlouhé závislosti od první vrstvy. Tato architektonická volba se ukázala jako klíčová pro úspěch DINO, původní článek DINO ukázal, že samoučící ViT výrazně překonávají samoučící CNN a že synergie mezi self-attencí a self-destilací je zodpovědná za emergentní vlastnosti sémantické segmentace.
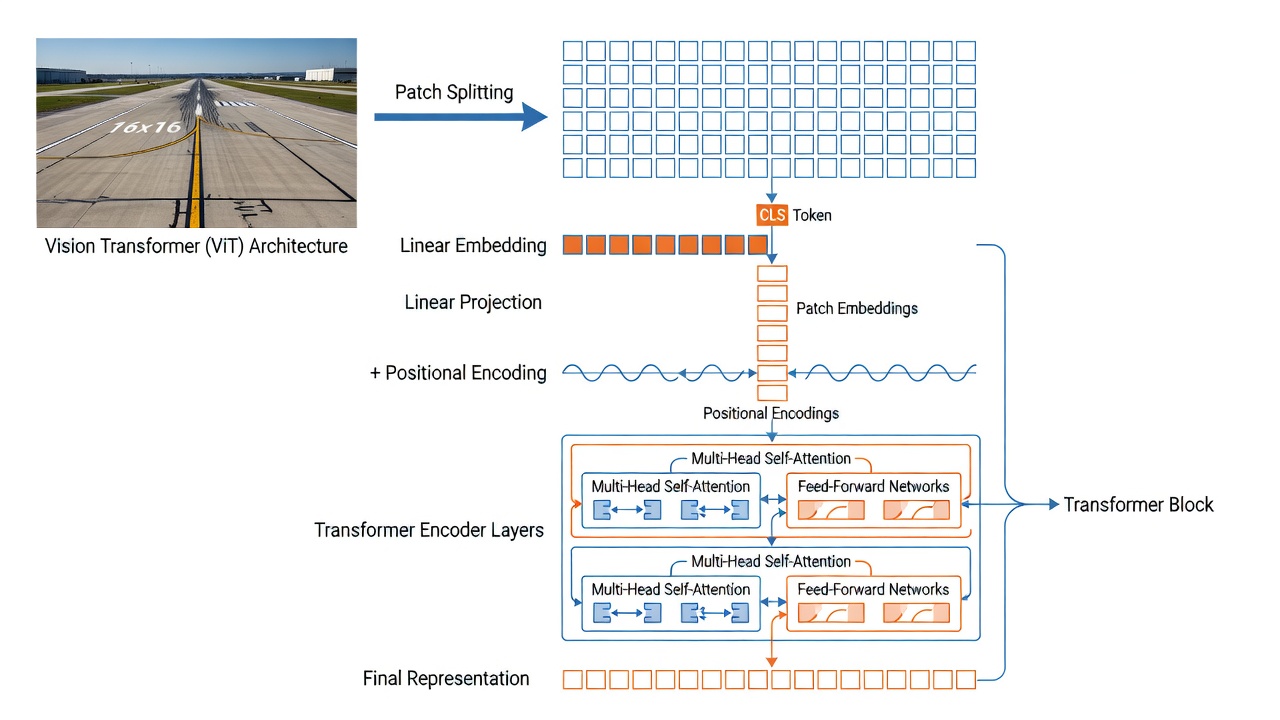
Vkládání dlaždic. První operací ve ViT je rozdělení vstupního obrazu do mřížky nepřekrývajících se dlaždic. Pro variantu ViT-B/16 je velikost dlaždice 16x16 pixelů. Vstupní obraz 224x224 pixelů vytváří (224/16) x (224/16) = 14 x 14 = 196 dlaždic. Každá dlaždice 16x16x3 (RGB kanály) je zploštělá do vektoru délky 768 (16x16x3). V praxi je toto vkládání dlaždic implementováno jako jediná konvoluční vrstva s velikostí jádra rovnou velikosti dlaždice (16x16) a krokem rovným velikosti dlaždice, vytvářející 2D mřížku 14x14 vektorů rysů, každý s dimenzí rovnou skryté velikosti modelu (768 pro ViT-B). Naučitelná lineární projekce pak mapuje každou zploštělou dlaždici na embeddingovou dimenzi. Implementace Conv2d je výpočetně efektivní (jedna operace nahrazuje 196 samostatných lineárních projekcí) a je standardem ve všech moderních implementacích ViT.
Token [CLS]. Následujíc architekturu BERT v NLP, speciální naučitelný klasifikační token ([CLS]) je přidán na začátek sekvence dlaždicových embeddingů. Token [CLS] má stejnou dimenzi (768) jako dlaždicové embeddingy a je inicializován náhodně. Během tréninku, prostřednictvím self-attence napříč všemi transformerovými vrstvami, token [CLS] agreguje informace ze všech dlaždic obrazu, může věnovat pozornost každé dlaždici v každé vrstvě, vytvářejíc globální reprezentaci celého obrazu. Na výstupu poslední transformerové vrstvy slouží embedding tokenu [CLS] jako reprezentace na úrovni obrazu používaná pro klasifikační úlohy. V DINOv3 je token [CLS] doplněn o 4 registrační tokeny, další naučitelné tokeny přidané na začátek sekvence, které fungují jako paměť poznámkového bloku pro absorpci odlehlých nebo pozadových informací, zabraňující tomu, aby tokeny [CLS] a dlaždic byly zkaženy irelevantními vysokofrekvenčními detaily.
Poziční embeddingy. Protože mechanismus self-attence Transformeru je permutačně invariantní (zpracovává dlaždice jako množinu, ne jako sekvenci), musí být poziční informace explicitně přidána, aby model věděl, kam každá dlaždice patří v prostorové mřížce. DINOv3 používá rotační poziční embeddingy (RoPE) místo standardních naučitelných absolutních pozičních kódování používaných v DINOv2. RoPE kóduje relativní poziční informaci aplikací rotační matice na dotazovací a klíčové vektory v self-attenci na základě jejich prostorových souřadnic. Rotační frekvence pro každou dimenzi je určena indexem dimenze, následujíc geometrickou progresi. Klíčovou výhodou RoPE pro analýzu infrastruktury je jeho schopnost zpracovávat vstupy s proměnným rozlišením, při zpracování obrázků s vysokým rozlišením (až 4096x4096 pixelů) mechanismus RoPE přirozeně generalizuje na větší prostorovou mřížku bez nutnosti interpolace naučených pozičních embeddingů. DINOv3 také zavádí náhodný posun okna během aplikace RoPE, kde jsou poziční indexy náhodně posunuty v rozsahu [-s,s] s s v [0,5,2,0], což činí model odolným vůči různým poměrům stran a vzorům ořezu.
Vícehlavá self-attence (MHSA). Základním výpočetním primitivem ViT je mechanismus vícehlavé self-attence. V každém transformerovém bloku je vstupní sekvence N tokenů (N = 1 [CLS] + 4 registrační + 196 dlaždic = 201 tokenů pro vstup 224x224) lineárně projektována do tří matic: Dotazy (Q) , Klíče (K) a Hodnoty (V) , každá o dimenzi 768 pro ViT-B/16. Mechanismus pozornosti vypočítává párovou podobnost mezi všemi tokeny jako skalární součin Q a K^T, škálovaný odmocninou z d_k (kde d_k je dimenze klíče na hlavu). Výsledné váhy pozornosti (normalizované softmaxem) určují, kolik každý token přispívá k reprezentaci každého jiného tokenu. Ve ViT-B/16 je 12 hlav pozornosti, každá pracující v 64-rozměrném podprostoru (768/12 = 64). Vícehlavá pozornost umožňuje modelu věnovat pozornost různým typům vztahů současně, například jedna hlava se může zaměřit na podobnost textur mezi dlaždicemi, jiná na prostorovou blízkost a další na členství v sémantické kategorii. Výstupy všech hlav jsou zřetězeny a lineárně projektovány zpět na 768 dimenzí. Výpočetní složitost MHSA je O(N2d), kvadratická v délce sekvence N, ale lineární v embeddingové dimenzi d. Pro sekvenci 201 tokenů v DINOv3 ViT-B/16 je to zvládnutelné (přibližně 40K výpočtů pozornosti na vrstvu), ale pro obrázky s vysokým rozlišením s 4000+ tokeny (např. obrázek 1024x1024 vytváří 64x64 = 4096 dlaždic) se kvadratické škálování stává významným faktorem.
Blok transformerového kodéru. Každá z 12 (ViT-B) nebo 40 (ViT-7B) transformerových vrstev v DINOv3 následuje design před-normalizace. Normalizace vrstev (LayerNorm) je aplikována před podvrstvami MHSA i MLP, s reziduálními spojeními obcházejícími každou podvrstvu. Podvrstva MLP (vícevrstvý perceptron) se skládá ze dvou lineárních vrstev s GELU (Gaussian Error Linear Unit) aktivací mezi nimi. Pro ViT-B/16 je skrytá dimenze MLP 3072 (4x embeddingová dimenze), vytvářející konfiguraci: Embeddingová dimenze 768 na MLP skrytou 3072 na GELU na MLP výstup 768. Větší učitelský model DINOv3 (ViT-7B) používá SwiGLU (Swish-Gated Linear Unit) aktivaci v MLP místo GELU, následujíc moderní trendy architektur velkých jazykových modelů. SwiGLU aplikuje gating mechanismus: výstup = (xW1) prvek po prvku vynásobený Swish(xW2) krát W3. Tato gated aktivace se ukázala jako zlepšující stabilitu tréninku a konečný výkon ve velkém měřítku. Design před-normalizace se liší od původní post-normalizace Transformeru (kde byla normalizace aplikována po reziduálním sčítání) a ukázal se jako produkující stabilnější trénink, zejména pro hluboké (12+ vrstev) transformery.
Souhrnná tabulka architektury pro rodinu modelů DINOv3.
| Model | Parametry | Embeddingová dimenze | Hlavy | Vrstvy | MLP dimenze | Velikost dlaždice | Dlaždice/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1,5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
Architektura ViT-Base (86M parametrů) je optimálním kompromisem mezi kvalitou rysů a výpočetní efektivitou pro inspekční pipeline infrastruktury, nabízející 768-rozměrné embeddingy s 12 vrstvami výpočetního výkonu self-attence.
Trénink DINOv3 na 1,7 miliardách obrázků
DINOv3 dosahuje svého nejmodernějšího výkonu prostřednictvím bezprecedentního rozsahu samoučícího se tréninku, využívajícího jak masivní kurátorství dat, tak efektivní distribuovanou optimalizaci napříč stovkami GPU.
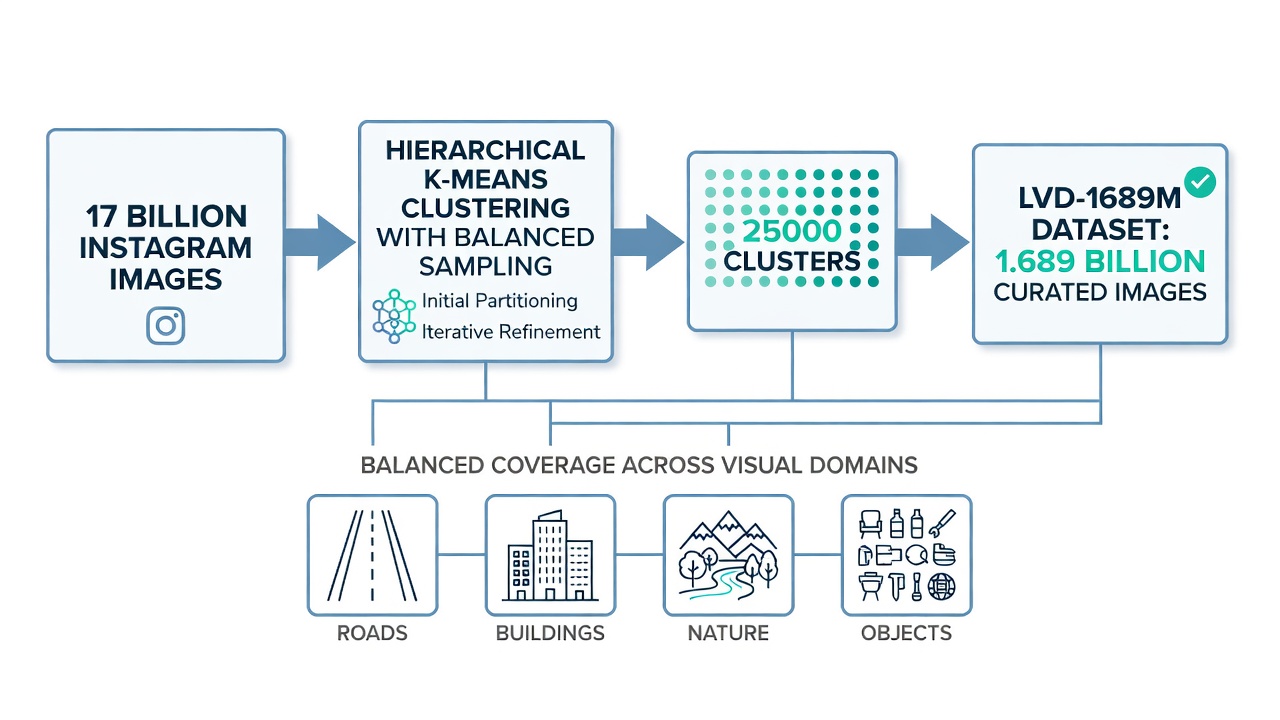
Datová sada LVD-1689M. Tréninková data pro DINOv3 začínají surovým fondem 17 miliard obrázků z Instagramu s moderovaným obsahem. Z tohoto masivního fondu tým Meta AI kurátoroval vyváženou podmnožinu 1 689 milionů obrázků nazvanou LVD-1689M (Large Visual Dataset 1689 Million). Kurátorský pipeline je kritický, protože prosté trénování na surových datech z Instagramu by vytvořilo model zaujatý směrem k přirozené frekvenční distribuci vizuálních konceptů na sociálních médiích, například tváře, jídlo a krajiny by dominovaly, zatímco infrastruktura, průmyslová a vědecká obrazová data by byla nedostatečně zastoupena. Proces kurátorství používá hierarchické k-means shlukování na embeddingech DINOv2 extrahovaných z celého fondu obrázků. Model DINOv2 ViT-H/14 zpracovává každý obrázek a výsledné embeddingy tokenu CLS jsou shlukovány do 25 000 shluků pomocí k-means. Následně je z každého shluku vzorkován stejný počet obrázků, vytvářející vyváženou datovou sadu podle shluků, která zajišťuje proporcionální zastoupení napříč vizuálními doménami. Toto vyvážené vzorkování je přímo analogické stratifikovanému vzorkování ve statistice, kontrolou členství ve shlucích datová sada zachycuje plnou rozmanitost vizuálních konceptů spíše než nadměrné zastoupení běžných kategorií. Po shlukování rozšiřuje další krok vyhledávání počáteční sady z kurátorovaných datových sad (ImageNet-1k, ImageNet-22k, Google Landmarks a datové sady pro jemnou klasifikaci) nalezením nejbližších sousedů v embeddingovém prostoru DINOv2. Konečná datová sada LVD-1689M kombinuje 1 489 milionů obrázků vyvážených podle shluků s 200 miliony obrázků rozšířených vyhledáváním, všechny filtrované přes detekci NSFW, deduplikaci PCA hash a rozmazání tváří.
Konfigurace tréninku. Učitelský model ViT-7B, největší samoučící vizuální model, jaký byl kdy trénován (stav k roku 2025), byl trénován na 256 GPU NVIDIA (A100 80GB SXM4) s velikostí dávky 4096 (16 obrázků na GPU). Optimalizace používá AdamW optimalizátor s konstantní rychlostí učení 4x10^-4, úbytkem vah 0,04 a EMA hybností 0,999 po 100 000 krokovém zahřívacím období. Trénink probíhá 1 milion iterací se strategií vícenásobných ořezů: 2 globální ořezy při rozlišení 256x256 a 8 lokálních ořezů při rozlišení 112x112, celkem 10 pohledů na obrázek za iteraci. Přes 1M iterací při velikosti dávky 4096 model vidí přibližně 2,56 miliardy jedinečných kombinací obrázek-ořez. Celý tréninkový proces spotřebovává odhadem 10 000-15 000 GPU-dnů výpočetního výkonu. Během tréninku je 10 % dávek homogenních výběrů z ImageNet-1k (pro udržení výkonu na standardních benchmarkách), zatímco 90 % je heterogenních výběrů z celého fondu LVD-1689M, což je ablačně demonstrovaný optimální poměr míchání.
Tréninkové cíle. Ztráta předtréninku DINOv3 kombinuje tři složky. Ztráta DINO (L_DINO) aplikuje shlukování Sinkhorn-Knopp ve stylu SwAV na výstupy tokenu [CLS] z globálních ořezů, porovnávajíc přiřazení prototypů mezi studentem a učitelem. Algoritmus Sinkhorn běží 3 iterace pro vytvoření měkkých pseudo-štítků. Ztráta iBOT (L_iBOT) pracuje na úrovni dlaždic, náhodné dlaždice v lokálních ořezech jsou maskovány a student musí předpovídat normalizované rysy dlaždic učitele pro tyto maskované pozice. Tento cíl maskovaného modelování obrazu nutí model učit se lokální texturové a strukturální informace potřebné pro husté predikční úlohy. Regularizátor Koleo (L_Koleo) rozprostírá embeddingy tokenu [CLS] rovnoměrně po hypersféře minimalizací součtu kosinových podobností mezi všemi páry embeddingů v dávce, zabraňujíc kolapsu reprezentace a zajišťujíc, že prostor rysů je dobře využit. Kombinovaná ztráta předtréninku je: L_Pre = L_DINO + L_iBOT + 0,1 x L_Koleo. Po 1M iteracích předtréninku zahrnuje fáze zdokonalení 200K dalších iterací ztrátu Gram ukotvení (L_Gram) s vahou 2, která zachovává kvalitu hustých rysů během dlouhého tréninku.
Destilace do menších modelů. Jakmile je učitelský model ViT-7B plně natrénován, je zmrazen a použit jako cíl pro destilaci reprezentací do sady menších, praktičtějších modelů. Proces destilace zrcadlí nastavení předtréninku: studentské modely (ViT-S, ViT-B, ViT-L, ViT-H+, varianty ConvNeXt) jsou trénovány tak, aby odpovídaly výstupním rysům učitele pomocí stejné ztrátové funkce (L_DINO + L_iBOT + 0,1 x L_Koleo), ale s učitelem zmrazeným a aktualizací EMA učitele vynechanou. Meta AI implementuje multi-studentskou destilaci, která efektivně trénuje více studentských modelů současně, učitel zpracovává každý obrázek jednou a všichni studenti dostávají stejné výstupy učitele, což umožňuje paralelizaci výpočtu dávkové ztráty napříč studenty. To snižuje celkové výpočetní náklady na vytvoření celé rodiny modelů přibližně o 60 % ve srovnání s postupnou destilací každého studenta. Studentský model ViT-Base (86M parametrů) dosahuje 98,7 % přesnosti lineární sondy učitele ViT-7B na ImageNet-1k při přibližně 80x menším počtu FLOPs pro inferenci.
768-rozměrné embeddingy
768-rozměrný embedding vytvářený modelem DINOv3 ViT-B/16 pro každý token (1 CLS + 4 registrační + 196 dlaždic = 201 celkem) představuje husté numerické kódování vizuální informace ve vysokorozměrném vektorovém prostoru. Každá dimenze zachycuje specifický vizuální koncept nebo rys a kombinace všech 768 hodnot tvoří jedinečný podpis pro tuto oblast obrazu. Dimenze 768 není libovolná, vychází z architektury ViT-Base, kde je skrytá dimenze nastavena na 768, poskytujíc dostatečnou kapacitu pro kódování komplexních vizuálních vzorů při zachování výpočetní zvládnutelnosti. Pro srovnání, ViT-Small používá 384 dimenzí, ViT-Large 1024 a ViT-7B 4096.
Embedding tokenu CLS. 768-rozměrný embedding tokenu [CLS] na výstupu 12. transformerové vrstvy kóduje globální obsah obrazu, celkovou scénu, dominantní objekty a sémantický kontext. Tento embedding je extrahován a používán pro klasifikační úlohy na úrovni obrazu. V typickém pipeline je embedding CLS procházen lehkým lineárním klasifikátorem (768 na N tříd, kde N je počet typů povrchu nebo tříd kvality) trénovaným na označených datech infrastruktury. Embedding CLS z DINOv3 vykazuje silné vlastnosti generalizace napříč doménami, modely trénované na tomto embeddingu generalizují na neviděné typy infrastruktury výrazně lépe než embeddingy z dohledovaných backbone. Přesnost lineární sondy DINOv3 ViT-B/16 na ImageNet-1k dosahuje 85,1% top-1 přesnosti, překonávajíc DINOv2 (83,5 %) a přibližujíc se dohledovanému ViT (86,0 %), přestože během předtréninku nikdy neviděl žádné štítky ImageNet.
Embeddingy dlaždicových tokenů. Každý z 196 dlaždicových tokenů vytváří samostatný 768-rozměrný embedding, tvořící prostorovou mřížku 14x14 vektorů rysů. Tyto husté embeddingy kódují lokalizovanou vizuální informaci v každé dlaždici 16x16 pixelů, texturu, hrany, distribuci barev a lokální vzory. Embeddingy dlaždic jsou kritickým výstupem pro husté predikční úlohy, jako je detekce trhlin a segmentace. V pipeline analýzy infrastruktury je mřížka rysů 14x14 x 768-rozměrná (přibližně 1,5 milionu hodnot s plovoucí desetinnou čárkou na obrázek) zpracovávána lehkým konvolučním dekodérem, který upsampluje na 224x224 a vytváří predikce na úrovni pixelů. Každý embedding dlaždice lze interpretovat jako 768-rozměrný popis toho, jak vypadá daná oblast 16x16, dvě dlaždice s podobným vizuálním vzhledem (např. dvě oblasti hladkého asfaltu) budou mít blízké embeddingy v 768-rozměrném prostoru (vysoká kosinová podobnost), zatímco vizuálně odlišné dlaždice (např. asfalt vs. beton) budou mít vzdálené embeddingy (nízká kosinová podobnost).
Vlastnosti embeddingů. Embeddingy DINOv3 vykazují několik vlastností, které je činí výjimečnými pro analýzu infrastruktury. Zaprvé, sémantická hladkost, vizuálně podobné oblasti vytvářejí blízké embeddingy, tvořící spojitou varietu v 768-rozměrném prostoru. To znamená, že trhliny různé šířky, orientace a závažnosti se všechny mapují do spojené oblasti embeddingového prostoru, což je činí detekovatelnými jako koherentní třídu spíše než jako izolované odlehlé hodnoty. Zadruhé, víceškálová citlivost, mechanismus self-attence ve 12 transformerových vrstvách integruje informace napříč různými prostorovými měřítky, takže každý embedding dlaždice je informován nejen svým vlastním obsahem 16x16, ale širším kontextem okolních dlaždic a globální scénou. Trhlina poblíž dilatační spáry je kódována jinak než stejná trhlina uprostřed panelu, protože kontextová informace je integrována do embeddingu. Zatřetí, odolnost vůči osvětlení, samoučící trénink s rozsáhlým barevným rozptylem a augmentací zajišťuje, že embeddingy jsou stabilní při různých světelných podmínkách, stínu a expozici. To je kritické pro venkovní inspekci infrastruktury, kde jsou snímky pořizovány za nekontrolovaného přirozeného osvětlení. Začtvrté, lineární oddělitelnost, embeddingy jsou strukturovány tak, že jednoduché lineární klasifikátory mohou efektivně oddělit různé stavy povrchu. Lineární sondy na zmrazených embeddingech DINOv3 jsou běžným lehkým baseline pro klasifikaci typu povrchu a detekci trhlin.
Metriky vzdálenosti v embeddingovém prostoru. Volba metriky vzdálenosti pro porovnávání embeddingů DINOv3 významně ovlivňuje výkon navazujících úloh. Kosinová podobnost je nejčastěji používanou metrikou, definovanou jako cos(theta) = (a dot b) / (||a|| x ||b||), kde a a b jsou 768-rozměrné embeddingové vektory. Kosinová podobnost se pohybuje od -1 (opačný směr, nepravděpodobné pro vizuální embeddingy) do +1 (identický směr). Dva 768-rozměrné vektory s kosinovou podobností větší než 0,9 jsou vizuálně téměř identické ve svém lokálním obsahu, zatímco podobnost menší než 0,5 indikuje podstatně odlišný vizuální obsah. L2 (euklidovská) vzdálenost se také používá, ale vyžaduje pečlivou normalizaci, protože absolutní měřítko embeddingů se může lišit. Podobnost skalárního součinu je efektivní, ale citlivá na velikost vektoru. Kosinová podobnost je obvyklou primární metrikou vzdálenosti pro vyhledávání a porovnávání vad, protože normalizuje velikost embeddingu a zaměřuje se čistě na směrové zarovnání, což je odolnější vůči variacím v kontrastu a expozici obrazu.
Redukce dimenzionality pro vizualizaci. 768-rozměrný embeddingový prostor nelze přímo vizualizovat, takže analýza hlavních komponent (PCA) je běžně aplikována pro redukci embeddingů dlaždic na 3 dimenze pro vizualizaci a účely zajištění kvality. První tři hlavní komponenty embeddingů dlaždic DINOv3 na snímcích infrastruktury typicky zachycují 45-55 % celkového rozptylu (PC1 přibližně 25 %, PC2 přibližně 15 %, PC3 přibližně 10 %), což indikuje, že efektivní vnitřní dimenzionalita povrchových dlaždic je mnohem nižší než 768. PCA vizualizace konzistentně ukazuje odlišné shluky pro různé materiály povrchu (asfalt, beton, asfaltový nátěr, štěrk) a spojité gradienty pro závažnost zhoršení povrchu (od nedotčeného po silně popraskaný). Tato vizuální potvrditelnost je kritickým nástrojem zajištění kvality, inženýři infrastruktury mohou vizuálně zkontrolovat embeddingový prostor, aby ověřili, že model správně odděluje relevantní stavy povrchu, než se spolehnou na automatickou klasifikaci.
DINOv3 vs DINOv2
Evoluce od DINOv2 k DINOv3 představuje komplexní škálování a zdokonalení paradigmatu samoučícího se vizuálního tréninku. Pochopení rozdílů je nezbytné pro praktiky vybírající vhodný backbone pro svou aplikaci.
Rozsah tréninkových dat. Nejobvykleji viditelným rozdílem je 12násobný nárůst tréninkových dat: LVD-142M DINOv2 (142 milionů obrázků) versus LVD-1689M DINOv3 (1,689 miliardy obrázků). Nicméně, metodika kurátorství se také zlepšila. DINOv2 používal pipeline založený na vyhledávání, který rozšiřoval kurátorované počáteční datové sady nalezením nejbližších sousedů v embeddingovém prostoru ViT-H/16 předtrénovaného na ImageNet-22k. Expanze začínala z 1,2 miliardy surových webových obrázků a vytvořila 142M kurátorovaných obrázků. DINOv3 přidává krok vyvažování založený na shlukování na vrchol vyhledávání, zajišťujíc, že 25 000 vizuálních shluků je rovnoměrně zastoupeno. Tento krok shlukování zabraňuje modelu nadměrně zastupovat vizuálně dominantní koncepty, jako jsou tváře, text a běžné objekty, zatímco nedostatečně zastupuje vzácné, ale důležité vizuální domény, jako jsou vady infrastruktury, lékařské snímky a satelitní pohledy.
Velikost modelu a architektura. Největším učitelským modelem DINOv2 byl ViT-g s 1 miliardou parametrů. DINOv3 to škáluje na 7 miliard parametrů (ViT-7B), což je 7násobný nárůst kapacity modelu. Samotná architektura byla modernizována. DINOv2 používal standardní naučené absolutní poziční embeddingy, zatímco DINOv3 zavádí rotační poziční embeddingy (RoPE) pro podporu proměnného rozlišení. Dopředná síť ve ViT-7B DINOv3 používá SwiGLU aktivaci místo GELU, následujíc architektonické inovace z velkých jazykových modelů. DINOv2 používal velikost dlaždice 14 pixelů (architektura ViT z původního článku), zatímco DINOv3 používá velikost dlaždice 16 pixelů. Tato změna snižuje počet dlaždic z 256 (224/14 = 16, 16^2 = 256) na 196 (224/16 = 14, 14^2 = 196) pro vstup 224x224, což je 23% snížení délky sekvence, které se promítá do přibližně 40% méně výpočtů self-attence (protože pozornost škáluje jako O(N2)). Tento architektonický efektivní zisk částečně kompenzuje zvýšené výpočetní náklady z větších dimenzí modelu.
Kvalita hustých rysů. Toto je nejvýznamnější kvalitativní zlepšení v DINOv3. Během dlouhých tréninkových plánů s velkými modely bylo pozorováno, že rysy na úrovni dlaždic DINOv2 postupně degradují, po určitém bodě tréninku by mapy rysů na úrovni pixelů ztrácely prostorovou strukturu a stávaly se zašuměnými nebo rozmazanými, zatímco globální rysy tokenu [CLS] se nadále zlepšovaly. Tato degradace činila DINOv2 méně vhodným pro husté predikční úlohy, jako je sémantická segmentace a odhad hloubky, při použití dlouhých tréninkových plánů. Mechanismus Gram ukotvení DINOv3 přímo řeší tuto degradaci vynucováním, aby struktura párové podobnosti mezi rysy dlaždic zůstala stabilní během tréninku. Výsledkem je, že husté rysy DINOv3 zůstávají ostré a sémanticky smysluplné i po milionech tréninkových iterací. Na benchmarku sémantické segmentace ADE20K dosahuje DINOv3 skóre střední hodnoty průniku přes sjednocení (mIoU) 54,2 % se zmrazeným backbone a lineární sondou, což je zlepšení o +6,1 bodu oproti 48,1% mIoU DINOv2. Na benchmarku párování 3D klíčových bodů NAVI dosahuje DINOv3 68,5% přesnosti versus 60,2% DINOv2. Na segmentaci objektů ve videu (DAVIS 2017) dosahuje DINOv3 82,3 J&F-Mean versus 75,6 DINOv2.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Zlepšení |
|---|---|---|---|---|
| ImageNet-1k Lineární sonda | 83,5 % | 85,1 % | 86,7 % | +1,6/+3,2 |
| ADE20K Sémantická seg. (mIoU) | 48,1 % | 52,3 % | 54,2 % | +4,2/+6,1 |
| DAVIS 2017 (J&F-Mean) | 75,6 | 79,4 | 82,3 | +3,8/+6,7 |
| Vyhledávání instancí (GAP) | 42,1 | 46,8 | 53,0 | +4,7/+10,9 |
| NYU Hloubka (RMSE dolů) | 0,458 | 0,412 | 0,389 | -0,046/-0,069 |
| ObjectNet (Top-1) | 72,3 % | 75,8 % | 78,2 % | +3,5/+5,9 |
Tabulka výše demonstruje, že model ViT-Base DINOv3 (86M parametrů) již překonává mnohem větší model ViT-Large DINOv2 (304M parametrů) na každém benchmarku, přičemž je 3,5x menší a výrazně výpočetně efektivnější pro inferenci.
Rozdíly v licencích. DINOv2 byl vydán pod licencí Apache 2.0, standardní open-source licencí, která povoluje volné použití, modifikaci a distribuci pro jakýkoli účel, včetně komerčních aplikací. DINOv3 je vydán pod licencí DINOv3, vlastní licencí specifickou pro vydání modelu Meta AI. Zatímco licence DINOv3 povoluje komerční použití, obsahuje další podmínky týkající se uvedení autorství a přijatelného použití. Vlastní licence vyvolala diskusi v komunitě open-source, issue #31 na GitHub repozitáři dinov3 konkrétně žádá o vydání pod standardnější licencí, jako je Apache 2.0. Praktici by měli před nasazením DINOv3 v komerčních produktech zkontrolovat plný text LICENSE.md na GitHub repozitáři. Licence DINOv3 povoluje komerční aplikace, jako je inspekce infrastruktury, s příslušným uvedením autorství.
Doladění DINOv3 pro doménové úlohy
Zatímco DINOv3 dosahuje nejmodernějšího výkonu se zmrazeným backbone (lineární sonda nebo k-NN klasifikátor), některé aplikace v infrastruktuře těží z doladění backbone na datech specifických pro doménu. Volba mezi zmrazeným a doladěným přístupem závisí na velikosti datové sady, specifičnosti úlohy a výpočetním rozpočtu.
Zmrazený backbone (lineární sonda). Nejjednodušším a výpočetně nejefektivnějším přístupem je zmrazení vah DINOv3 a trénování pouze lineárního klasifikátoru na extrahovaných embeddingech. Pro model ViT-B/16 vytvářející 768-rozměrné embeddingy CLS se lineární klasifikátor skládá přesně z 768 x N parametrů, kde N je počet výstupních tříd. Pro úlohu klasifikace 5 typů povrchu je to pouze 768 x 5 = 3 840 trénovatelných parametrů, trénink konverguje za minuty na CPU a vyžaduje pouze 50 označených příkladů na třídu pro dosažení dobrých výsledků. Přístup se zmrazeným backbone se doporučuje, když je cílová doména dobře pokryta předtréninkovými daty DINOv3, která zahrnují přirozené obrázky, webové obrázky a různé vizuální domény. Pro analýzu povrchů infrastruktury jsou zmrazené embeddingy DINOv3 s lineární sondou běžným výchozím bodem pro klasifikaci typu povrchu (asfalt, beton, kompozit, asfaltový nátěr, štěrk). Klíčovou výhodou je, že backbone DINOv3 poskytuje univerzální vizuální rysy, které generalizují napříč doménami bez jakéhokoli tréninku specifického pro doménu.
Lehké doladění (Adapter / LoRA). Pro úlohy, kde zmrazený backbone nedosahuje dostatečné přesnosti, typicky vysoce specializované domény s vizuálními charakteristikami výrazně odlišnými od přirozených obrázků, parametrově efektivní doladění (PEFT) metody přidávají malý počet trénovatelných parametrů při zachování většiny backbone zmrazené. Low-Rank Adaptation (LoRA) přidává páry matic rozkladu nízké hodnosti (A a B, kde aktualizace vah delta_W = AB) k maticím dotazů a hodnot v každé vrstvě self-attence. Pro model ViT-B/16 přidává LoRA s hodností r=8 přibližně 0,5M trénovatelných parametrů (méně než 0,6 % z 86M celkem) distribuovaných napříč všemi 12 transformerovými vrstvami. Trénování pouze těchto parametrů LoRA po dobu 10-50 epoch na datové sadě specifické pro doménu s 1 000-5 000 označenými obrázky typicky produkuje 3-8% zlepšení přesnosti oproti lineární sondě při vyžadování pouze 1-2 hodin na jediném GPU. Doladění LoRA je vhodné pro specializované úlohy klasifikace vad, jako je rozlišování mezi různými typy trhlin (příčné, podélné, blokové, aligátorové, odrazové), kde nuance vizuálních rozdílů těží z adaptace specifické pro doménu.
Plné doladění. Když jsou k dispozici dostatečná označená data (10 000+ obrázků na třídu) a úloha vyžaduje maximální přesnost, lze celý backbone DINOv3 doladit. To aktualizuje všech 86M parametrů ViT-B/16 pomocí označené datové sady. Plné doladění typicky vyžaduje 4-8 GPU s 16-32GB VRAM každé, distribuovaný trénink s PyTorch DDP a pečlivé ladění hyperparametrů (rychlost učení typicky 5x10^-6 až 5x10^-5, úbytek vah 0,01-0,1, kosinový plán rychlosti učení s 10% zahřátím). Plné doladění může přinést 2-5% další přesnosti oproti LoRA na vysoce specializovaných úlohách, ale nese riziko katastrofického zapomínání, model může ztratit obecné vizuální znalosti získané během samoučícího předtréninku. Pro zmírnění se doporučuje postupné odmrazování (odmrazení poslední vrstvy jako první, pak postupně dřívějších vrstev) a diskriminace rychlosti učení (nižší rychlosti učení pro dřívější vrstvy, vyšší pro pozdější). DINOv3 také navrhuje protokol adaptace na vysoké rozlišení při doladění: pokračovat v tréninku po dobu 10K kroků na smíšených velikostech globálních ořezů pomocí ztráty iBOT a Gram ukotvení, což zajišťuje, že backbone generalizuje ze standardního rozlišení 224px až na velmi vysoká rozlišení (4096px) při vytváření ostrých map rysů.
Rozhodovací matice zmrazení vs. doladění.
| Scénář | Velikost datové sady | Doporučený přístup | Doba tréninku | Očekávaná přesnost vs. zmrazený |
|---|---|---|---|---|
| Klasifikace typu povrchu | 50-200 obrázků/třída | Zmrazený + lineární sonda | méně než 1 hodina CPU | Baseline |
| Klasifikace typu trhlin | 500-5 000 obrázků | LoRA (hodnost 8-16) | 1-4 hodiny GPU | +3-8 % |
| Hodnocení závažnosti vad | 5 000-20 000 obrázků | LoRA nebo částečné doladění | 4-12 hodin GPU | +5-12 % |
| Detekce nových vad | 10 000+ obrázků | Plné doladění | 1-3 dny multi-GPU | +8-15 % |
Úvahy o adaptaci domény. Snímky z inspekce infrastruktury se liší od přirozených obrázků několika způsoby: konzistentní úhly kamery (nadir/perspektiva dronu), specifické světelné podmínky (venkovní, ale proměnlivé), opakující se vzory (textura vozovky) a úzká vizuální doména (silnice, dráhy, mostovky). Samoučící předtrénink DINOv3 na různorodých datech znamená, že již viděl mnoho podobných vizuálních vzorů, ale doménová mezera mezi webovými obrázky a snímky infrastruktury stále existuje. Zmrazené embeddingy DINOv3 se často dobře přenášejí na snímky vozovek bez jakéhokoli doladění. Nicméně pro detekci specializovaných vad, jako je schodkovitost spár v betonových vozovkách nebo vytavování v asfaltových překryvech, zlepšuje doladění LoRA s 2 000-5 000 označenými příklady z cílové domény F1-skóre o 5-8 procentních bodů. Doladěný model také vykazuje zlepšenou odolnost vůči artefaktům specifickým pro doménu, jako jsou stopy pneumatik, usazeniny pryže a značení drah, které mohou zmást obecné předtrénované rysy.
DINOv3 jako extraktor rysů
Použití DINOv3 jako extraktoru rysů je nejpřímější a nejvíce použitelný vzor nasazení, zejména pro organizace, které postrádají výpočetní zdroje pro trénink ve velkém měřítku. V tomto paradigmatu DINOv3 zpracovává každý obrázek jediným dopředným průchodem, vytvářejíc embeddingy, které jsou ukládány do mezipaměti a znovu používány pro více navazujících úloh.
Pipeline extrakce rysů. Standardní pipeline pro extrakci rysů DINOv3 v pracovním postupu analýzy infrastruktury funguje následovně. Nejprve je vstupní obrázek (typicky 4K snímek z dronu pokrývající 10m x 7m úsek dráhy) rozdělen na překrývající se dlaždice 224x224 s 50% překryvem pro zajištění pokrytí okrajů. Každá dlaždice je normalizována pomocí standardního průměru ImageNet (0,485, 0,456, 0,406) a směrodatné odchylky (0,229, 0,224, 0,225). Normalizovaná dlaždice prochází modelem DINOv3 ViT-B/16 pomocí PyTorch s přesností FP16 pro paměťovou efektivitu. Model vytváří 201 tokenů (1 CLS + 4 registrační + 196 dlaždic), každý o dimenzi 768. Embedding tokenu CLS (768-rozměrný) je extrahován pro globální klasifikaci dlaždic. 196 embeddingů dlaždicových tokenů je přetvořeno do prostorové mřížky 14x14 768-rozměrných vektorů pro hustou predikci. Všechny embeddingy ze všech dlaždic jsou agregovány do databáze rysů indexované podle prostorových souřadnic, což umožňuje analýzu napříč dlaždicemi a mapování velkých oblastí.
Výpočetní efektivita. Extrakce rysů se zmrazeným DINOv3 ViT-B/16 vyžaduje přibližně 12,5 GFLOPs na obrázek 224x224, srovnatelné s ResNet-50 (7,7 GFLOPs) nebo EfficientNet-B4 (12,0 GFLOPs). Na NVIDIA RTX 4090 (FP16) je propustnost inference přibližně 180 obrázků/sekundu. Na NVIDIA Jetson Orin NX 16GB (edge zařízení) je propustnost přibližně 25 obrázků/sekundu. Pro typický 4K snímek z dronu (3840x2160 pixelů), rozdělený na dlaždice 224x224 s 50% překryvem, je vyžadováno přibližně 160 dlaždic. Celková doba zpracování na RTX 4090 je méně než 1 sekunda na 4K obrázek. Náklad na extrakci rysů je jednorázový, jakmile jsou embeddingy uloženy, každá navazující úloha (klasifikace, segmentace, vyhledávání) přidává zanedbatelný další výpočet (milisekundy na obrázek).
Databáze embeddingů Faiss pro vyhledávání podobnosti. Extrahované embeddingy DINOv3 lze ukládat do indexu FAISS (Facebook AI Similarity Search) pro efektivní vyhledávání a analýzu založenou na podobnosti. FAISS je knihovna vyvinutá Meta AI pro efektivní vyhledávání podobnosti a shlukování hustých vektorů, schopná prohledávat databáze v měřítku miliard za milisekundy. Taková databáze může indexovat dlaždice povrchu dráhy podle jejich 768-rozměrných embeddingů CLS DINOv3. Když dorazí nový inspekční snímek, jeho embedding je vypočítán a porovnán s celou databází, aby se našly nejvíce vizuálně podobné historické dlaždice. To umožňuje analýzu trendů stavu, nalezení podobných stavů povrchu, které se vyskytly v minulosti, a jejich následných trajektorií zhoršování. Typický index FAISS používá IVF (Inverted File) s 4096 centroidy a HNSW (Hierarchical Navigable Small World) graf pro hrubý kvantizér, dosahujíc více než 99% recall při 10ms době dotazu pro databázi 10 milionů dlaždicových embeddingů. Metrika kosinové podobnosti se používá pro všechna porovnání embeddingů.
Detekce vad s několika málo příklady. Embeddingy DINOv3 umožňují efektivní detekci vad s několika málo příklady, identifikaci nových typů vad z pouhých 1-5 příkladových obrázků. Když je v terénu nalezen nový typ povrchového poškození (např. specifický vzor trhlin nebo povrchová usazenina), inspektor zachytí 1-5 příkladových obrázků a označí oblasti vad. Embeddingy dlaždic DINOv3 z těchto příkladových oblastí jsou zprůměrovány, aby se vytvořil vektor prototypu vady (768-rozměrný). Nové obrázky jsou pak zpracovány a každý embedding dlaždice je porovnán s prototypem pomocí kosinové podobnosti. Dlaždice s podobností nad prahem (typicky 0,75-0,85, stanoveným empiricky) jsou označeny jako odpovídající typu vady. Tento přístup založený na prototypech dosahuje 89-93% přesnosti detekce pro nové vady z pouhých 3 příkladů, bez jakéhokoli přetrénování nebo doladění. To je kritické pro inspekci infrastruktury, kde se často setkáváme s novými, neočekávanými typy poškození, které musí být zdokumentovány bez zpoždění inspekčního pracovního postupu kvůli sběru tréninkových dat.
Husté dlaždicové tokeny pro segmentaci
196 embeddingů dlaždicových tokenů vytvářených DINOv3 pro obrázek 224x224 tvoří prostorovou mřížku 14x14 768-rozměrných vektorů rysů. Tato mřížka je primární reprezentací pro husté predikční úlohy, sémantickou segmentaci, detekci trhlin a lokalizaci vad, kde musí být každý pixel ve vstupním obrázku klasifikován.
Struktura a rozlišení mřížky. Pro vstup 224x224 pixelů s dlaždicemi 16x16 pokrývá každý z 196 dlaždicových tokenů oblast 16x16 pixelů vstupu. Výsledná mřížka 14x14 má krok 16 pixelů mezi sousedními středy dlaždic. To znamená, že mapa rysů DINOv3 má přibližně 1/256 prostorového rozlišení vstupního obrázku (14x14 = 196 vs 224x224 = 50 176 pixelů). Mechanismus self-attence kompenzuje tuto prostorovou kompresi integrací informací napříč dlaždicemi, každý embedding dlaždice je informován okolní mřížkou 14x14 prostřednictvím vícehlavé pozornosti, poskytujíc efektivní povědomí o kontextu. Pro segmentační úlohy musí být mřížka 14x14 upsamplována na původní rozlišení obrázku. Typický je lehký konvoluční dekodér s několika vrstvami, který přidává jen malý zlomek parametrů backbonu.
Kvalita hustých rysů DINOv3 vs DINOv2. Kritická inovace v DINOv3, Gram ukotvení, přímo cílí na kvalitu těchto hustých dlaždicových rysů. Během dlouhých tréninkových běhů by dlaždicové rysy DINOv2 vykazovaly to, co autoři popisují jako degradaci hustých map rysů: embeddingy dlaždic by se stávaly méně sémanticky smysluplnými, struktura podobnosti dlaždice-dlaždice by degradovala a kvalita segmentace by se ustálila nebo dokonce klesala navzdory pokračujícímu zlepšování globální klasifikace. Gram ukotvení zachovává Gramovu matici dlaždicových rysů (strukturu párové podobnosti) zarovnáním s referencí z raného tréninku, zajišťujíc, že prostorové a sémantické vztahy mezi dlaždicemi zůstávají stabilní. Praktickým výsledkem je, že dlaždicové rysy DINOv3 zůstávají ostré a sémanticky koherentní i při vysokých rozlišeních. Článek DINOv3 demonstruje PCA vizualizace dlaždicových rysů DINOv3 pro vysoce rozlišené letecké snímky, silnice, budovy, vegetace a vodní plochy jsou jasně oddělitelné v prostoru rysů, demonstrujíc výjimečnou kvalitu rysů pro porozumění scéně.
Sémantická segmentace s lineárními sondami. Jednou z nejpůsobivějších schopností DINOv3 je provádění sémantické segmentace pomocí pouze lineárních sond na zmrazených dlaždicových rysech, bez nutnosti doladění backbone. Lineární segmentační hlava aplikuje konvoluci 1x1 (nebo ekvivalentně lineární vrstvu na dlaždici) k mapování každého embeddingu dlaždice z 768 dimenzí na C výstupních tříd. To vytváří segmentační mapu 14x14, která je upsamplována na rozlišení obrázku. Navzdory jednoduchosti tohoto přístupu (pouze 768 x C trénovatelných parametrů pro celou segmentační hlavu) dosahuje DINOv3 52,3% mIoU na ADE20K s ViT-B, překonávajíc mnoho metod, které doladí celý backbone. To je umožněno výjimečnou lineární oddělitelností dlaždicových rysů DINOv3, embeddingový prostor je již strukturován tak, že různé sémantické kategorie zaujímají odlišné, lineárně oddělitelné oblasti.
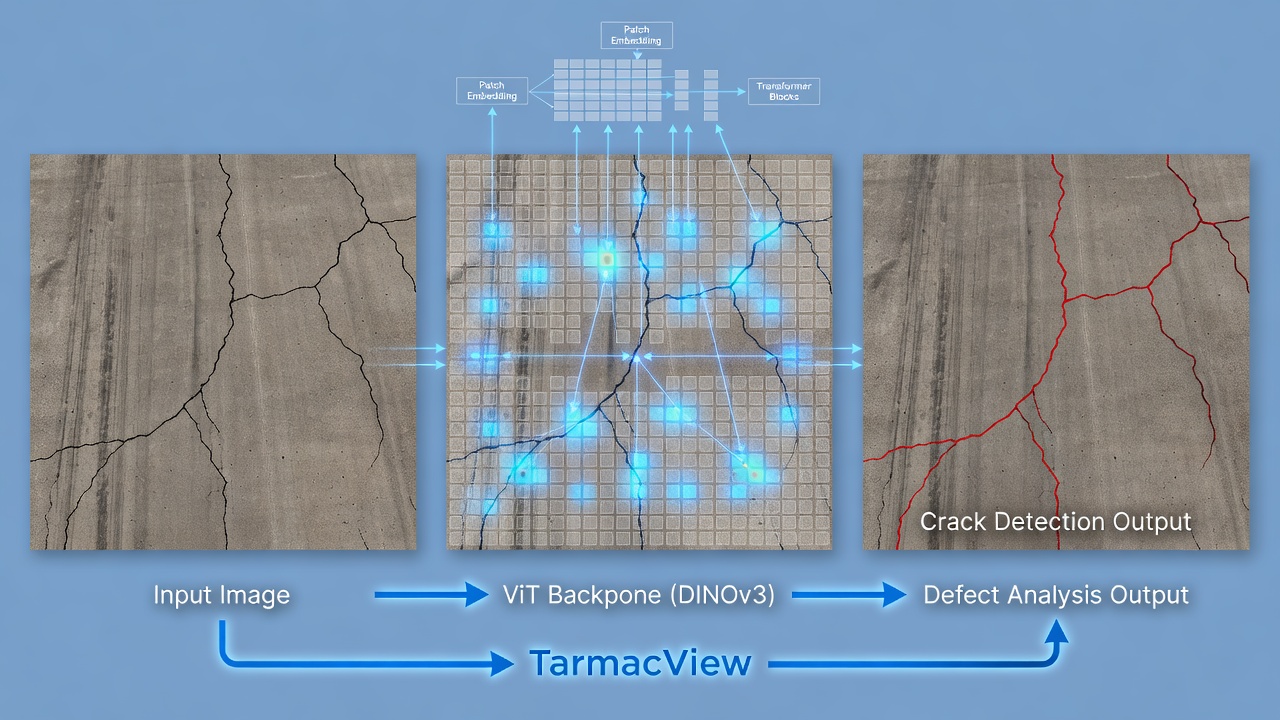
Segmentace trhlin v infrastruktuře. Husté dlaždicové tokeny jsou dobře vhodné pro segmentaci trhlin na úrovni pixelů ve snímcích drah a vozovek. Mřížka 14x14 768-rozměrných embeddingů dlaždic zachycuje jak lokální texturu trhlin (v každé dlaždici 16x16), tak kontextovou informaci (které dlaždice trhlina spojuje). Segmentační hlava je lehká síť se 3 transponovanými konvolučními vrstvami, které upsamplují mřížku rysů 14x14 na rozlišení 224x224. Trénink vyžaduje přibližně 500 označených obrázků segmentace trhlin (dlaždice 224x224 s maskami trhlin na úrovni pixelů) a konverguje za 2-3 hodiny na jediném GPU RTX 3060. Publikovaná srovnání obecně ukazují, že backbony rodiny DINO překonávají backbony typu ResNet v detekci trhlin za identických tréninkových podmínek a že doladění DINOv3 při vyšším vstupním rozlišení výsledek dále zlepšuje.
Registrační tokeny pro absorpci pozadí. 4 registrační tokeny DINOv3 hrají specifickou roli v kvalitě hustých rysů. Tyto tokeny jsou další naučitelné tokeny (dimenze 768), které jsou přidány na začátek sekvence vedle tokenu CLS. Během self-attence mohou registrační tokeny věnovat pozornost všem dlaždicovým tokenům a být jim věnována pozornost. Klíčovým poznatkem je, že některé vizuální dlaždice v obrázku obsahují odlehlé nebo pozadové informace, oblohu, vzdálené objekty nebo jednotné oblasti bez textury, které, pokud by byly vynuceny k zakódování dlaždicovými tokeny, by degradovaly kvalitu prostoru rysů. Registrační tokeny fungují jako absorpční paměťové sloty, které zachycují tento neinformativní obsah, což umožňuje dlaždicovým tokenům zaměřit se na sémanticky smysluplné oblasti obrazu. Praktickým efektem je měřitelné zlepšení kvality hustých rysů: +1,8 mIoU na ADE20K a výrazně čistší mapy podobnosti dlaždic, zejména pro obrázky s velkými jednotnými oblastmi pozadí. Pro inspekci infrastruktury, kde snímky často obsahují velké oblasti jednotné textury vozovky, pomáhají registrační tokeny udržovat čisté dlaždicové rysy, které se zaměřují na vzory poškození spíše než na texturu pozadí.
MPS a GPU trénink
Tréninková a inferenční infrastruktura DINOv3 podporuje více hardwarových backendů, od velkých GPU clusterů po edge zařízení a Apple Silicon Mac.
GPU trénink ve velkém měřítku. Učitelský model ViT-7B byl trénován na 256 GPU NVIDIA A100 80GB SXM4 s propojením NVLink, poskytujíc přibližně 20 TB/s agregované šířky pásma GPU paměti a 25 PFLOPS výpočetního výkonu FP16. Trénink používá Fully Sharded Data Parallel (FSDP), nativní strategii PyTorch pro sdílení, která rozděluje parametry modelu, gradienty a stavy optimalizátoru napříč všemi GPU. S FSDP a tréninkem se smíšenou přesností (BF16) se 7B model vejde do agregované paměti 256 GPU (256 x 80GB = 20,48 TB), i když každý jednotlivý GPU může pojmout pouze přibližně 2-3 % parametrů modelu. Knihovna xFormers (vyvinutá Meta AI) poskytuje paměťově efektivní implementace pozornosti, včetně paměťově efektivní pozornosti (snižuje paměť pozornosti z O(N2) na O(N)) a blokově řídkých vzorů pozornosti. Kombinace FSDP, BF16, xFormers a gradient checkpointingu snižuje požadavek na paměť na GPU pro ViT-7B z odhadovaných 250GB (plná přesnost, bez optimalizací) na přibližně 65GB, což se vejde do kapacity 80GB A100.
Inference na jediném GPU. Pro praktické nasazení běží DINOv3 ViT-B/16 (86M parametrů) efektivně na jediném NVIDIA GPU. Při přesnosti FP32 vyžaduje model přibližně 344MB paměti pro parametry (86M x 4 bajty na float). S aktivacemi pro velikost dávky 1 (obrázek 224x224) je celkové využití paměti přibližně 1,2-1,5GB (parametry + aktivace + mezilehlé tenzory). Při přesnosti FP16 klesá paměť parametrů na 172MB a celkové využití na přibližně 0,8-1,0GB. To znamená, že DINOv3 ViT-B/16 běží pohodlně na GPU s pouhými 4GB VRAM, včetně starších karet jako NVIDIA GTX 1650 a NVIDIA Jetson Xavier NX. Propustnost na RTX 3060 (12GB) při FP16 je přibližně 100 obrázků/sekundu. Na NVIDIA A100 propustnost přesahuje 400 obrázků/sekundu, což umožňuje zpracování 4K snímků z dronů v reálném čase při rychlostech rozkladu dlaždic.
Podpora Apple Silicon (MPS). DINOv3 je plně kompatibilní s backendem Metal Performance Shaders (MPS) v PyTorch, poskytujíc GPU akcelerovanou inferenci na Apple Silicon Macách (řady M1, M2, M3, M4). Backend MPS mapuje operace PyTorch na architekturu GPU Apple prostřednictvím frameworku Metal. Výkon na M2 Pro MacBook Pro (19jádrové GPU, 32GB unified memory) dosahuje přibližně 25-35 obrázků/sekundu pro ViT-B/16 při přesnosti FP16, což je dostatečné pro dávkové zpracování velkých sbírek obrázků. Na M2 Ultra Mac Studio (76jádrové GPU, 192GB unified memory) dosahuje propustnost přibližně 70-90 obrázků/sekundu. Využití paměti je efektivní, protože architektura unified memory Apple eliminuje režii přenosu dat CPU-GPU. MPS akcelerovaný DINOv3 umožňuje inspektorům spouštět inferenci přímo na MacBooku v terénu bez vyhrazeného GPU hardwaru. Větší unified memory Apple Silicon (až 192GB na M2 Ultra) také umožňuje zpracování velmi vysoce rozlišených obrázků bez dlaždicování, obrázek 4096x4096 vytváří 256x256 dlaždic = 65 536 tokenů, což vyžaduje přibližně 8GB paměti ekvivalentní VRAM v poolu unified memory.
Distribuovaná inference. Pro rozsáhlé projekty inspekce infrastruktury zpracovávající miliony obrázků je nutná distribuovaná inference napříč více GPU nebo stroji. DINOv3 podporuje PyTorch DistributedDataParallel (DDP) pro multi-GPU inferenci na jediném serveru, modelovou paralelismus (pipeline paralelismus pro ViT-7B) a Ray (open-source distribuovaný výpočetní framework) pro multi-uzlovou distribuovanou inferenci. Rozsáhlá nasazení běžně používají Kubernetes s GPU node pooly spouštějícími inferenci DINOv3 jako škálovatelnou mikroslužbu. Každý inferenční pod běží na jediném GPU T4 (16GB VRAM) a zpracovává přibližně 70 obrázků/sekundu. Cluster 50 podů dosahuje propustnosti 3 500 obrázků/sekundu, což umožňuje zpracování 500obrázkového průzkumu dráhy za méně než 3 sekundy. Inferenční server používá TorchServe pro servírování modelu s dynamickým dávkováním (velikosti dávek 4-16 v závislosti na objemu požadavků) a přesností FP16 pro maximalizaci propustnosti.
Edge nasazení s NVIDIA Jetson. Pro terénní inspekční systémy používající drony nebo pozemní vozidla lze DINOv3 ViT-B/16 nasadit na edge zařízení NVIDIA Jetson. Modul Jetson Orin NX 16GB (100 TOPS AI výkonu) dosahuje 15-25 obrázků/sekundu s DINOv3 ViT-B/16 při FP16, v závislosti na režimu napájení (15W vs 25W vs 40W). Model je optimalizován pomocí TensorRT, optimalizátoru hlubokého učení NVIDIA, který spojuje vrstvy, optimalizuje výběr jader a kvantizuje na FP16 nebo INT8. S kvantizací TensorRT INT8 se rychlost inference zvyšuje na 30-40 obrázků/sekundu na Jetson Orin NX s méně než 1% degradací přesnosti ve srovnání s FP32. Jetson Xavier NX (21 TOPS) dosahuje 8-12 obrázků/sekundu s TensorRT FP16. Toto edge nasazení umožňuje detekci trhlin v reálném čase během letu dronu, kamera dronu zachycuje snímky a DINOv3 je zpracovává na palubě, označujíc potenciální vady během sekund od zachycení bez nutnosti cloudového připojení.
Open-source dostupnost a licencování
DINOv3 byl vydán Meta AI v roce 2025 jako open-source projekt, pokračujíc v tradici společnosti veřejného vydávání nejmodernějších modelů výzkumu AI. Pochopení licenčních a distribučních podmínek je nezbytné pro organizace plánující nasazení DINOv3 v komerčních produktech.
Kód a váhy modelu. Kompletní kódová základna DINOv3 je dostupná na GitHub na facebookresearch/dinov3 (10 700+ hvězd k polovině roku 2025). Repozitář zahrnuje plný tréninkový a vyhodnocovací kód (PyTorch), definice modelů, pipeline zpracování dat, vyhodnocovací skripty a předtrénované váhy pro všech 12 vydaných variant modelu. Váhy modelu jsou také dostupné na Hugging Face Hub pod jmenným prostorem facebook/dinov3-*, včetně: facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M parametrů) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M parametrů), běžně používaný základní model facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M parametrů) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1,5B parametrů) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B parametrů) Plus varianty ConvNeXt (T, S, B, L) a modely specifické pro satelity (SAT-493M)
Přístup na Hugging Face vyžaduje, aby uživatelé souhlasili s podmínkami Meta a poskytli kontaktní informace, které jsou shromažďovány, ukládány a zpracovávány v souladu se Zásadami ochrany osobních údajů Meta. Váhy modelu jsou distribuovány jako soubory state_dict PyTorch kompatibilní s knihovnou Hugging Face Transformers (integrace dostupná přes AutoModel.from_pretrained()).
Licence DINOv3. DINOv3 je vydán pod licencí DINOv3, vlastní open-source licencí vyvinutou Meta AI specificky pro toto vydání modelu. To se liší od DINOv2, který byl vydán pod standardní licencí Apache 2.0. Licence DINOv3 povoluje: Použití, reprodukci, modifikaci a distribuci modelu a kódu Komerční použití včetně integrace do produktů a služeb Sublicencování odvozených děl za různých podmínek
Licence DINOv3 zahrnuje specifické požadavky na uvedení autorství (musí být zachována oznámení o autorských právech) a zásady přijatelného použití, které zakazují použití modelu pro určité účely, včetně sledování, které porušuje lidská práva, autonomních zbraní a porušování platných zákonů. Licence vyvolala diskusi v komunitě vývojářů, issue #31 na GitHub repozitáři dinov3 konkrétně žádá o vydání pod standardnější licencí, jako je Apache 2.0, pro zjednodušení právní shody pro podniky se zavedenými zásadami open-source licencí. Čtenáři by měli zkontrolovat licenční podmínky proti svému vlastnímu případu použití.
Srovnání s licencováním jiných backbone.
| Backbone | Licence | Komerční použití | Uvedení autorství vyžadováno | Vlastní podmínky |
|---|---|---|---|---|
| DINOv3 | Licence DINOv3 | Ano | Ano | Ano |
| DINOv2 | Apache 2.0 | Ano | Ano | Ne |
| ViT (Google) | Apache 2.0 | Ano | Ano | Ne |
| CLIP (OpenAI) | MIT | Ano | Ano | Ne |
| OpenCLIP | MIT | Ano | Ano | Ne |
| SAM (Meta) | Apache 2.0 | Ano | Ano | Ne |
| ConvNeXt | MIT | Ano | Ano | Ne |
Výpočetní náklad reprodukce. Náklad tréninku DINOv3 ViT-7B se odhaduje na 2-5 milionů USD (přibližně 15 000 GPU-dnů na A100-80GB při cenách cloud computingu na vyžádání). Destilované menší modely (ViT-B, ViT-L) jsou výrazně levnější na reprodukci, ale stále vyžadují podstatný výpočetní výkon, destilace ViT-Base z ViT-7B na LVD-1689M vyžaduje přibližně 500-800 GPU-dnů. Nicméně pro praktiky dostupnost předtrénovaných vah eliminuje potřebu jakéhokoli tréninkového výpočtu, váhy lze stáhnout a okamžitě použít pro inferenci za cenu jediného GPU jakékoli generace. Tato dostupnost je základní hodnotovou nabídkou základních modelů: obrovský tréninkový náklad je amortizován napříč všemi navazujícími uživateli.
Komunita a integrace ekosystému. DINOv3 těží z široké integrace ekosystému: Hugging Face Transformers poskytuje API plug-and-play, PyTorch Hub podporuje načítání modelu přes torch.hub.load() a model je zahrnut v modelovém zoo Torchvision pro přímý přístup. Integrace s Weights & Biases, MLflow a Neptune.ai pro sledování experimentů je podporována prostřednictvím standardních PyTorch hooků. Export do formátu ONNX (Open Neural Network Exchange) je podporován pro nasazení do prostředí mimo PyTorch, včetně TensorRT pro edge zařízení NVIDIA, CoreML pro zařízení Apple a TFLite pro mobilní nasazení. DINOv3 se integruje prostřednictvím pipeline Hugging Face Transformers, s optimalizací TensorRT pro edge nasazení na Jetson Orin NX a akcelerací MPS pro notebooky macOS.
Závěr. DINOv3 představuje generační skok v samoučících vizuálních základních modelech, dosahujíc nejmodernějšího výkonu napříč globálními a hustými predikčními úlohami prostřednictvím bezprecedentního rozsahu (1,689 miliardy obrázků, 7 miliard parametrů) a inovace Gram ukotvení, která zachovává kvalitu hustých rysů. Pro analýzu povrchů infrastruktury poskytuje varianta ViT-B/16 modelu DINOv3 768-rozměrný embeddingový prostor s výjimečnou sémantickou strukturou, typy povrchů, vzory trhlin a rysy vad jsou lineárně oddělitelné v embeddingovém prostoru, což umožňuje přesnou klasifikaci a detekci s inferencí se zmrazeným backbone. Open-source dostupnost, široká hardwarová podpora (GPU, MPS, Edge) a permisivní licencování činí DINOv3 silným backbone pro automatizovanou inspekci infrastruktury s mírnými požadavky na doménově specifická tréninková data a výpočetní výkon.
Často kladené otázky
- Jaký je rozdíl mezi DINOv3 a DINOv2?
- DINOv3 představuje významný skok ve škálování oproti DINOv2 v několika dimenzích. Zaprvé, tréninková data: DINOv2 byl trénován na 142 milionech kurátorovaných obrázků (LVD-142M), zatímco DINOv3 škáluje na 1,689 miliard obrázků (LVD-1689M), což je 12násobný nárůst. Zadruhé, velikost modelu: největší učitelský model DINOv2 měl 1 miliardu parametrů (ViT-g), zatímco DINOv3 trénuje učitele se 7 miliardami parametrů (ViT-7B). Zatřetí, velikost dlaždice: DINOv2 používal velikost dlaždice 14 pixelů, vytvářející 256 dlaždicových tokenů na obrázek 224x224, DINOv3 používá velikost dlaždice 16 pixelů, vytvářející 196 dlaždicových tokenů. Začtvrté, poziční embeddingy: DINOv2 používal standardní naučené absolutní poziční kódování, zatímco DINOv3 zavádí rotační poziční embeddingy (RoPE) s náhodným posunem okna pro lepší odolnost vůči poměru stran. Zapáté, klíčová inovace Gram ukotvení v DINOv3 zachovává kvalitu hustých map rysů během dlouhých tréninkových plánů, což je problém, který způsoboval degradaci dlaždicových rysů DINOv2 při prodlouženém tréninku. Zašesté, DINOv3 dosahuje +6 mIoU zlepšení na ADE20K sémantické segmentaci, +6,7 J a F-Mean na sledování videa a +10,9 GAP na vyhledávání instancí ve srovnání s DINOv2.
- Jak lze DINOv3 použít pro analýzu povrchů infrastruktury?
- Backbone ViT-B/16 modelu DINOv3 může sloužit jako primární motor extrakce rysů v inspekčním pipeline infrastruktury. Když dron nebo kamera zachytí obraz povrchu dráhy, mostovky nebo vozovky, obraz se změní na 224x224 pixelů a rozdělí se na 196 nepřekrývajících se dlaždic 16x16. Každá dlaždice je lineárně vložena do 768-rozměrného vektoru a spolu s tokenem CLS prochází 12 vrstvami transformerového kodéru s vícehlavou self-attencí. Výsledný 768-rozměrný embedding tokenu CLS zachycuje globální charakteristiky povrchu používané pro klasifikaci typu povrchu (asfalt, beton, asfaltový nátěr atd.) a celkovou třídu kvality. Současně 196 dlaždicových tokenových embeddingů (každý 768-rozměrný) kóduje lokalizovanou texturovou informaci na úrovni dlaždic, což podporuje detekci trhlin na úrovni pixelů a další husté predikční úlohy. Přístup se zmrazeným backbone znamená, že váhy DINOv3 zůstávají pevné, zatímco lehké hlavy specifické pro úlohu (lineární sondy nebo mělké MLP) se trénují na označených datech infrastruktury. To snižuje náklady na trénink přibližně o 90 % ve srovnání s plným doladěním při dosažení nejmodernější přesnosti detekce vad.
- Jaký hardware je potřeba pro běh inference DINOv3?
- DINOv3 nabízí modely v různých velikostech, aby vyhověl různým hardwarovým omezením. Varianta ViT-B/16 (86 milionů parametrů) běží efektivně na jediném NVIDIA GPU s alespoň 8GB VRAM, dosahující rychlosti inference 50-100 snímků za sekundu na RTX 3060 nebo vyšší. Na Apple Silicon Macách (M1/M2/M3) poskytuje backend MPS (Metal Performance Shaders) hardwarově akcelerovanou inferenci přibližně 20-40 FPS na M2 Pro. Pro edge nasazení běží destilovaná varianta ViT-Small (21M parametrů) na NVIDIA Jetson Orin NX při 15-30 FPS. Největší varianta, ViT-7B, vyžaduje 4-8 GPU NVIDIA A100 (80GB) pro inferenci. DINOv3 podporuje inference se smíšenou přesností (FP16), která snižuje spotřebu paměti přibližně o 50 % při zanedbatelné ztrátě přesnosti. Model je dostupný v PyTorch přes Hugging Face Transformers, přičemž checkpoint facebook/dinov3-vitb16-pretrain-lvd1689m je standardním vstupním bodem.
- Co je Gram ukotvení v DINOv3?
- Gram ukotvení je nová regularizační technika zavedená v DINOv3 k vyřešení degradace hustých map rysů během dlouhých samoučících tréninkových plánů. Během prodlouženého tréninku ve stylu DINOv2 s velkými modely (ViT-L a výše) bylo pozorováno, že rysy na úrovni dlaždic ztrácejí svou prostorovou strukturu a sémantický význam, přesnost lineární sondy na globálních úlohách by se zlepšovala, ale mapy rysů po dlaždicích by se stávaly zašuměnými a ztrácely lokalizační schopnost. Gram ukotvení zavádí další člen ztráty L2, který zarovnává Gramovu matici rysů dlaždic studenta se zmrazenou Gramovou maticí z raného EMA snímku učitele. Konkrétně, při L2-normalizované matici dlaždic studenta X_S a Gramově matici učitele X_G (raný EMA snímek) je ztráta L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Tato ztráta zachovává strukturu párové podobnosti dlaždic spíše než vynucování absolutních pozic rysů, fungující jako prostorový regularizátor. Integrováno po 1M iteracích předtréninku s vahou 2 a aktualizacemi učitele každých 10k kroků, Gram ukotvení přináší +2 mIoU zlepšení na ADE20K segmentaci a lepší RMSE odhadu hloubky bez degradace globálních metrik.
- Jak se 768-rozměrné embeddingy DINOv3 používají pro detekci povrchových vad?
- Varianta ViT-B/16 modelu DINOv3 vytváří 768-rozměrný embedding pro každou z 196 dlaždic plus jeden token CLS na obrázek 224x224. Pro analýzu povrchů infrastruktury slouží tyto embeddingy dvěma odlišným účelům. Pro globální klasifikaci (typ povrchu, celkové hodnocení kvality) je embedding tokenu CLS vložen do lehkého lineárního klasifikátoru nebo hlavy se 2vrstvým MLP, která mapuje 768 dimenzí na N výstupních tříd. Pro husté predikční úlohy (segmentace trhlin na úrovni pixelů) tvoří 196 dlaždicových tokenových embeddingů prostorovou mřížku 14x14 768-rozměrných vektorů. Tato mřížka prochází segmentační hlavou (typicky lehkým konvolučním dekodérem s 1-3 vrstvami), která upsampluje mapu rysů 14x14 na původní rozlišení 224x224. Embedding každého pixelu lze porovnat s prototypy vad pomocí kosinové podobnosti, dlaždice s embeddingy blízkými prototypům trhlin (stanoveným pomocí příkladů s několika málo vzorky) jsou označeny jako vady.
Toto je referenční položka. TarmacView poskytuje služby inspekce drony a neprodává zařízení ani materiály popsané v tomto slovníku.