Co je adaptace domény pro modely inspekce přes různé povrchy?
Adaptace domény pro modely inspekce přes různé povrchy: Kompletní technický průvodce
Definice a problém doménového posunu
Adaptace domény je podkategorií transfer learningu, která řeší fundamentální výzvu v deployování modelů strojového učení: statistický nesoulad mezi tréninkovými daty a daty nasazení. Když model trénovaný na zdrojové doméně, datové sadě s známými charakteristikami a typicky abundatními označenými příklady, je deployován na cílové doméně s jinými statistickými vlastnostmi, performance degraduje. Adaptace domény poskytuje metody, aby překlenula tuto mezeru, umožňující modelům generalizovat přes domény bez sbírání a označování velkých nových datových sadů pro každé prostředí nasazení.
Formálně, doména je definována jako pár sestávající z featur prostoru (X) a distribuce pravděpodobnosti (P(X)) nad tím prostorem: (D = {X, P(X)}). Úkol je pár sestávající z prostoru popisků (Y) a prediktivní funkce (f: X \to Y). Zdrojová doména (D_S) je doména, na které model je původně trénován s abundatními označenými daty. Cílová doména (D_T) je nová doména, kde model musí fungovat, často s omezenými nebo žádnými popisky. Cílem adaptace domény je naučit se funkci (f_T: X_T \to Y_T) pro cílovou doménu, využívající znalosti ze zdrojové domény, navzdory nesouladu (P_S(X) \neq P_T(X)).
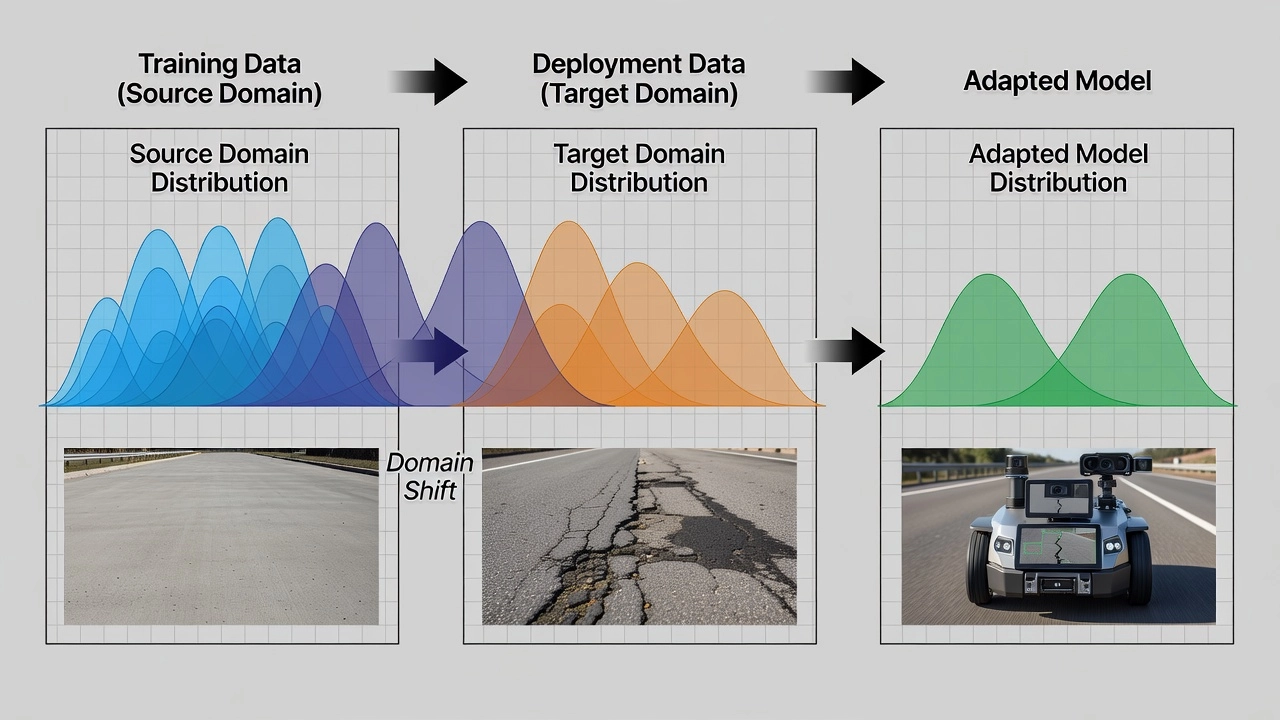
Doménový posun (také nazývaný distribuční posun nebo posun datové sady) je fenomén, kde distribuce dat se liší mezi prostředím tréninku a nasazení. Když doménový posun nastane, performance modelu degraduje, protože naučené mapování z vstupů na výstupy již neodpovídá cílovým podmínkám. Doménový posun se manifestuje v třech hlavních formách. Kovariátový posun nastává, když distribuce vstupních featur se mění, zatímco kondicionální distribuce popisků daných vstupů zůstává stejná: formálně, (P_S(X) \neq P_T(X)) ale (P_S(Y|X) = P_T(Y|X)). To je nejčastější forma v computer vision, vizuální vzhled trhliny na asfaltu se liší od trhliny na betonu, ale mapování z vizuálních featur na popisek “trhlina” zůstává konzistentní. Posun popisků (nebo apriorní posun) nastává, když distribuce třídových popisků se mění: (P_S(Y) \neq P_T(Y)) ale (P_S(X|Y) = P_T(X|Y)). To se stává, když hustota trhlin se liší mezi místem tréninku a nasazení. Posun konceptu nastává, když relace mezi vstupy a výstupy se mění: (P_S(Y|X) \neq P_T(Y|X)), například, když vizuální vzor, který indikuje utěsněná trhlina na silnicích, indikuje strukturní defekt na dráhách.
Pro computer vision v inspekci infrastruktury, doménový posun vzniká z více složených faktorů. Rozdíly ve vizuálním vzhledu zahrnují texturu vozovky (hrubý asfalt vs hladký beton), barevné profily (tmavošedý asfalt vs světlošedý beton) a vzory stárnutí (oxidovaná povrch vs čerstvě vyasfaltovaná). Podmínky sbírání jako osvětlení (direktní sluneční světlo pod úhlem 60° vs difuzní světlo pod mračným nebem), kamerové rozlišení a spektrální senzitivita senzoru, a úhel sbírání obrazu (nadir z UAV vs oblik z vozidla) všechny přispívají signifikantní distribuční posuny. Environmentální faktory včetně mokré vs suché povrchy, okénové okluze od struktur a sezónní úlomky (listy, sněh, stojící voda) dále složí problém. Rozdíly v materiálu povrchu mezi asfaltem a betonem, nebo mezi starými a čerstvě vyasfaltovanými povrchami, reprezentují jeden z nejvýzvnějších doménových posunů pro modely inspekce vozovky.
Výzkum dokumentoval závažnost doménového posunu v detekci trhlin na vozovce kvantitativně. DDACRN rámec reportoval, že bez adaptace domény, střední Intersection over Union pro detekci trhlin (mIoU) klesá z 0,72 na zdrojových testovacích datech na 0,31 na cross-dataset cílových datech, 57% redukci performance. DACrack demonstroval, že mitigace doménového posunu přes víceúrovňové zarovnání příznaků obnovuje přibližně 20 procentních bodů v F1-score na cross-dataset transferech. Tyto empirické výsledky podtrhují, proč adaptace domény není pouze akademické zlepšení, ale operacionální nezbytnost pro každý inspekční systém deployovaný přes více letiště, silnice nebo mostové sítě.
Doménový posun v obrazování infrastruktury
Obrazy inspekce infrastruktury jsou podrobeny více interagujícím zdrojům doménového posunu, které se složí. Rozumění každého zdroje je esenciální pro designování efektivních adaptacních strategií.
Posun materiálu povrchu je nejvýraznější doménový posun v inspekci infrastruktury. Asfaltové a betonové vozovky mají fundamentálně jiné vizuální charakteristiky. Asfalt je tmavošedý až černý v barvě, má hrubou a neregulární texturu povrchu, a trhliny typicky vypadají jako světlé lineární featurky proti tmavému pozadí. Beton je světlošedý až bílý, má hladší a uniformnější povrch, a trhliny vypadají jako tmavé linie. Tyto rozdíly znamenají, že konvoluční neuronová síť trénovaná na jeden typ povrchu naučí filtry a reprezentace featur specifické pro vizuální statistiky té povrchy. Když je aplikována na jiný typ povrchu, tyto filtry produkují aktivace featur, které klasifikátorové vrstvy nemohou interpretovat korektně. Data z DDACRN zobrazují, že cross-surface mIoU klesá z 0,72 na 0,31 bez adaptace při transferu z asfalt-trenovaných na beton-testované modely.
Variace morfologie trhlin introdukuje další vrstvu doménového posunu. Různé typy distressu vozovky mají distinktní vizuální signatury. Longitudinální trhliny běží paralelně s centrální linií vozovky a vypadají jako dlouhé, kontinuální lineární featurky. Transversální trhliny běží perpendicularně k centrální linii. Aligátorové (únavové) trhliny formují interkonektované sítě malých polygonů připomínajících aligátorí kůži. Vlasové trhliny měří méně než 1 mm v širokosti a mohou být těžko viditelné, zatímco široké trhliny přesahují 5 mm a jsou lehce identifikovatelné. Sealované trhliny naplněné sealantním materiálem mají jiný vizuální vzhled než nesealované trhliny. Model trénovaný převážně na longitudinálních trhlinách může selhat v detekci alligator trhlin v cílové doméně, kde ten typ distressu je více prevalentní.
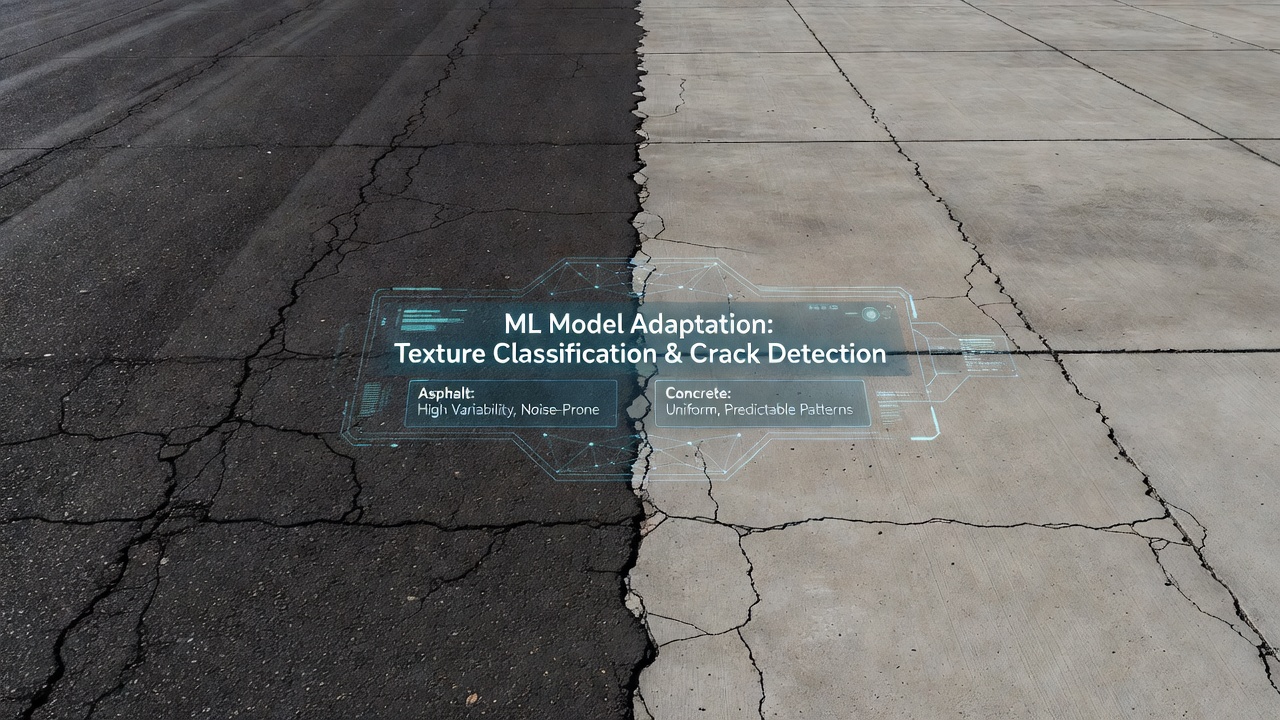
Posun způsobený světelnými podmínkami signifikantně ovlivňuje performance modelu. Modely trénované na dobře osvětlených denních obrazech pod direktním slunečním světlem selhají na obrazech s nízkým světlem nebo v sumraku, obrazech s ostrými okénami od struktur nebo stromů, a obrazech pod podmračnými podmínkami, kde difuzní světlo redukuje kontrast. Úhel incidentního světla relativně k normále povrchu mění vzhled okrajů trhlin, sluneční světlo pod nízkým úhlem zdůrazňuje texturu povrchu tím, že castí okény uvnitř trhlin, zatímco sluneční světlo pod vysokým úhlem nad hlavou minimalizuje viditelnost trhlin. Okluze okénů od mostových superstruktur, letištních terminálových budov nebo blizkých struktur produkuje lokalizované tmavé regiony, kde featurky trhlin jsou supresovány. Studie dokumentovaly 5–12% poklesy přesnosti pro modely detekce trhlin, když světelné podmínky se posouvají z tréninkové distribuce.
Posun kamery a senzoru vzniká z rozdílů v obrazovacím hardware. Různé kamery produkují jiné rozlišení obrazů (12 MP smartphone vs 50 MP DSLR vs specializovaná industriální kamera), jiné barevné profily a krivky spektrální senzitivity senzoru, jiné charakteristiky distorze objektivu a jiné šumové vzory. Pro UAV-based inspekci, výška letu determinuje Ground Sampling Distance (GSD), fyzickou distanci na zemi reprezentovanou každým pixelem. UAV letící na 30 m produkuje přibližně 0,5–1 cm/pixel GSD, zatímco jeden na 100 m produkuje 2–5 cm/pixel. Rozdíly v GSD znamenají, že stejná trhlina je reprezentován jiným počtem pixelů a jiným prostorovým frekvenčním obsahem v zdrojové vs cílové doméně. Dolaďování s recomputací normalizace dávky (BN) statistik je často dostatečný pro střední posuny kamery, zatímco závažné posuny vyžadují adversariální doménový zarovnání na více úrovních featur.
Sezónní a environmentální posun introdukuje temporální doménovou variaci. Model trénovaný na letních obrazech musí fungovat v zimních podmínkách, kde povrchy mohou být mokré, sněhem pokryté nebo částečně zakryté padlými listy. Povrchy vozovek podstupují stárnutí a oxidaci přes čas, měnící jejich barvu a texturu. FAA a ICAO Global Reporting Format (GRF) explicitně uznává environmentální podmínku jako variabil, která ovlivňuje posouzení stavu dráhy: suchá, mokrá, kluzká mokrá a kontaminovaná povrchy každá reprezentuje distinktní vizuální doménu vyžadující jinou interpretaci inspekce.
| Zdroj doménového posunu | Typický vliv na performance | Primární strategie mitigace |
|---|---|---|
| Materiál povrchu (asfalt vs beton) | 30–45% mIoU pokles | Adversariální DA + víceúrovňové zarovnání příznaků |
| Světelné podmínky (slunečno vs podmračno) | 5–12% pokles přesnosti | BN adaptace + fotometrická augmentace |
| Rozlišení kamery / senzor | 3–8% pokles přesnosti | Dolaďování + recomputace BN statistik |
| Sezónní / environmentální | 8–20% pokles přesnosti | Generativní doménový překlad (CycleGAN) |
| Geografický / regionální | 10–25% pokles přesnosti | UDA z více zdrojů + postupné doménové přemostění |
Dolaďování pro adaptaci domény
Dolaďování je nejjednodušší a nejvíce používaná strategie adaptace domény. Zahrnuje vzít neuronovou síť předtrénovanou na zdrojové doméně a kontinuovat tréninkový proces na cílových datech, aktualizující váhy modelu, aby zarovnaly jeho reprezentace s cílovou distribucí. Dolaďování překlenuje mezeru mezi transfer learningem (kde úkol se mění) a adaptací domény (kde úkol zůstává stejný, ale distribuce dat se mění).
Teoretický základ dolaďování spočívá na observaci, že neuronové sítě naučí hierarchické reprezentace featur. Ranné vrstvy zachycují nízkoúrovňové featurky jako okraje, textury a barevné bloby, které jsou převážně doménově-agnostické. Střední vrstvy kombinují je do středněúrovňových vzorů jako okraje trhlin, zrno povrchu a okraje spár. Pozdní vrstvy naučí úkolově-specifické featurky optimalizované pro klasifikaci nebo segmentaci objektivu. Když doména se posouvá, nízkoúrovňové statistiky (barevné distribuce, frekvencie textur, charakteristiky kontrastu) se mění, a pozdní vrstvy, které jsou fině nastaveny na zdrojové distribuce featur, ztrácí své zarovnání.
Plné dolaďování aktualizuje všechny parametry modelu na cílových datech. To je vhodné, když abundatní označená cílová data jsou dostupná (stovky až tisíce obrazů) a výpočetní zdroje umožňují plné aktualizace gradientu. Rychlost učení je typicky snížena faktorem 10 relativně k počátečnímu předtréninku, aby se zabránilo katastrofickému zapomínání, fenoménu, kde model přepisuje užitečnou zdrojovou znalost. Předčasné zastavení založené na cílové validační ztrátě je esenciální, aby se vyvážilo zachování zdrojové znalosti s cílovou adaptací.
Ladění poslední vrstvy (klasifikátorový) zamrazí všechny vrstvy extrakce featur a trénuje pouze finální klasifikaci nebo segmentaci hlavu. Tento přístup předpokládá, že extraktor featur naučený na zdrojové doméně produkuje reprezentace, které jsou dostatečně generální, a pouze mapování z featur na popisky potřebuje přizpůsobení. Ladění poslední vrstvy je efektivní, když velmi omezená cílová data jsou dostupná (desítky obrazů) a doménový posun je primárně v prostoru popisků, ne v featur prostoru. Vyžaduje minimální výpočet a je rezistentní ke katastrofickému zapomínání.
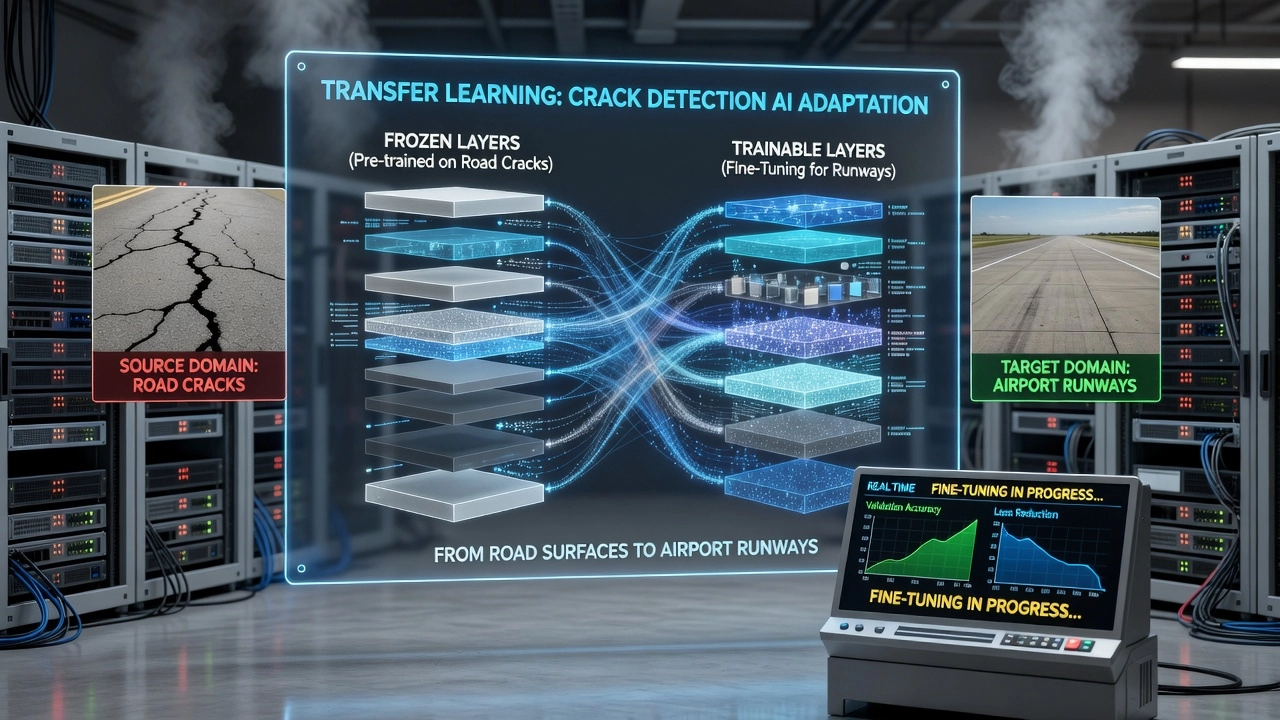
Postupné odmrazování poskytuje střední cestu. Tréninkový proces začíná se všemi vrstvami zamraženými kromě finálního klasifikátoru, který je trénován několik epoch. Potom, nejvyšší vrstvy extrakce featur jsou odamraženy a trénovány spolu s klasifikátorem. Tento proces se opakuje, postupně odamražující vrstvy od vrchu do dnu, dokud všechny vrstvy nejsou dolaďování nebo stagnace výkonu není dosažena. Postupné odmrazování je vhodný pro střední množství cílových dat (stovky obrazů) a doménové posuny, které ovlivňují více úrovní hierarchie featur.
Adaptérové moduly introdukují malé úzké vrstvy s signifikantně méně parametry než plná síť. Tyto adaptéry jsou insertovány mezi vrstvy zamraženého předtrénovaného backbone a jsou jediné parametry aktualizované během dolaďování. Dolaďování založené na adaptérech je vysoce parametr-efektivní, typicky 1–5% z celkového počtu parametrů, a umožňuje rychlé přepínání mezi více cílovými doménami tím, že ukládá a načítá různé váhy adaptéru. Pro inspekční sítě infrastruktury s milióny parametrů, adaptér moduly umožňují nasazení přes desítky letiště bez ukládání separátních kopií plných vah pro každé.
Normalizace dávky (BN) adaptace je remarkabilně lehká přesto efektivní technika. BN vrstvy vypočítají běžící střední a varianční statistiky během tréninku, aby normalizovaly intermediární featur mapy. Když doména se posouvá, tyto statistiky již ne reprezentují cílovou distribuci přesně. BN adaptace jednoduše recomputuje BN statistiky tím, že prochází cílové doménové data přes síť s zamraženými váhami, aktualizující běžící střední a varianci bez jakýchkoli aktualizací gradientu. To samo může signifikantně redukovat doménový posun, když primární rozdíl je v nízkoúrovňových statistikách obrazu jako jasnost, kontrast a barevná distribuce. Studie na detekci trhlin zobrazují, že BN adaptace obnovuje 3–8% poklesů přesnosti způsobených středními posuny osvětlení a kamery, vyžadující pouze jeden dopředný průchod neoznačených cílových dat.
| Strategie dolaďování | Potřebná cílová data | Aktualizované parametry | Riziko katastrofického zapomínání | Nejlepší použití |
|---|---|---|---|---|
| Recomputace BN statistik | Žádná (neoznačená) | 0 (pouze BN statistiky) | Žádné | Posuny osvětlení / kamery |
| Ladění poslední vrstvy | 10–50 označených | < 1% | Velmi nízké | Distribuce featur zachována |
| Adaptérové moduly | 50–200 označených | 1–5% | Nízké | Multidoménové nasazení |
| Postupné odmrazování | 100–500 označených | Postupný, 10–100% | Střední | Střední doménový posun |
| Plné dolaďování | 500+ označených | 100% | Vysoké | Abundatní cílová data, velký posun |
Řízená adaptace domény
Řízená adaptace domény (SDA) operuje pod předpokladem, že malé množství označených dat je dostupno v cílové doméně spolu s abundatními označenými zdrojovými daty. To je nejjednodušší nastavení: model má direktní přístup k referenční informaci o cílové doméně, umožňující explicitní optimalizaci pro cílovou performance.
Standardní SDA přístup má dva komponenty. První, model je předtrénován na zdrojové doméně s jejími abundatními popisky, to ustanovuje generální znalost o úkolu inspekce, naučí se rozpoznávat okraje trhlin, okraje spár, textury povrchu a geometrie defektů. Druhý, model je dolaďován na označených cílových datech s substanciálně sníženou rychlostí učení. Během dolaďování, ztrátová funkce typicky kombinuje zdrojové a cílové ztráty, aby zabránila modelu zapomenout užitečnou zdrojovou znalost. Kombinovaná ztráta je vyjádřena jako:
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
kde (\mathcal{L}_S) je zdrojová ztráta vypočítaná na zdrojových datech, (\mathcal{L}_T) je cílová ztráta vypočítaná na označených cílových datech, a (\lambda) kontroluje relativní přispěvek každé domény. Během tréninku, zdrojové a cílové dávky jsou alternativně nebo společně procházeny přes síť.
Klíčové techniky pro řízenou adaptaci domény zahrnují vážené ztrátová funkce, které dávají vyšší důležitost cílovým doménovým vzorkům během dolaďování, společný trénink, kde zdrojová a cílová označená data jsou míchány v každé tréninkové dávce, a doménový adversariální trénink, kde doménový klasifikátor je přidán i v řízeném nastavení, aby povzbudil extraktor featur naučit se doménově-invariantní reprezentace. Postupné učení (curriculum learning) strategie začínají se zdrojově-dominovaným tréninkem a postupně posouvají balans k cílovým datům, jak trénink pokračuje.
Přenos parametrů, kde váhy zdrojově-trénovaného modelu slouží jako inicializace, je dominantní strategie v SDA. Úspěch tohoto přístupu závisí na stupni příbuznosti mezi zdrojovou a cílovou doménou. Když domény jsou těsně příbuzné (např., různé sekce stejné letištní vozovky), velmi málo označených cílových příkladů je dostatečno, až 20–50 obrazů může obnovit většinu performance ztracené doménovým posunem. Když domény jsou více distancované (např., silnice na dráhu), 200–500 označených cílových příkladů je typicky potřebno pro robustní adaptaci.
SDA efektivní vůči popiskům techniky cílí minimalizovat množství potřebných cílových popisků. Aktivní učení identifikuje nejinformativnější cílové vzorky pro označení: model je trénován na zdrojových datech, aplikován na neoznačená cílová data, a vzorky, kde je nejvíce neistý, jsou vybrány pro lidské označení. Tento přístup může redukovat požadavky na označení o 50–70% ve srovnání s náhodným vzorkováním. Samotrénování (nebo pseudo-popisky) aplikuje zdrojově-trénovaný model na neoznačená cílová data, generuje provizorní popisky pro vysoce-konfidenční predikce, a retrénuje model používající tyto pseudo-popisky jako dodatečnou supervizi. Samotrénování je zvlášť efektivní, když je kombinován s prahováním jistoty a datovou augmentací.
Kdy použít SDA: když je proveditelné získat malý označený soubor z každého cílového nasazení místa. Pro inspekci letištní dráhy to znamená, že trénovaný inspektor může označit 50–200 obrazů na letiště, jednorázový náklad 1–4 hodin na místo. To je daleko ekonomičnější než alternativa sbírání a označování tisíců obrazů na letiště, která by vyžadovala více dní na místo. FAA AC 150/5380-6C doporučuje regulární PCI průzkumy, které již zahrnují inspektorů posouzení povrchů vozovky, ti stejní inspektoři mohou poskytnout několik set označených obrazů potřebných pro SDA jako část svého standardního inspekčního pracovního postupu.
Neřízená adaptace domény
Neřízená adaptace domény (UDA) je nejvýzvnější a nejaktivněji výzkumná nastavení adaptace domény. Předpokládá, že označená data existují pouze v zdrojové doméně, zatímco cílová doména je kompletně neoznačená. UDA je dominantní scénář pro inspekci infrastruktury, protože označení cílových doménových dat je nákladné, časově náročné nebo nepraktické přes mnoho nasazení míst. Model trénovaný na obrazech vozovky z jednoho letiště musí adaptovat se na jiné povrchy, osvětlení a vzory defektů jiného letiště bez vyžadování, aby každé letiště produkovalo označenou datovou sadu.
UDA metody padají do tří hlavních kategorií: adversariální metody, metody založené na diskrepanci a rekonstrukční metody. Všechny sdílí jádrový cíl zarovnat zdrojové a cílové distribuce featur tak, aby klasifikátor trénovaný na zdrojových featurách generalizoval na cílové featurky.
Adversariální adaptace domény
Adversariální adaptace domény čerpá inspiraci z Generative Adversarial Networks (GANs). Jádrová idea je trénovat doménový diskriminátor (binární klasifikátor, který predikuje, zda reprezentace featur pochází ze zdrojové nebo cílové domény) spolu s extraktorem featur v minimaxové igře. Extraktor featur snaží se produkovat featurky, které jsou nerozlišitelné mezi zdrojovou a cílovou, zatímco diskriminátor snaží se korektně identifikovat původ každé featurky.
Kanonická architektura je Domain-Adversarial Neural Network (DANN), představený Yaroslavem Ganinem a Victorem Lempitskym v 2015. DANN sestává z tří komponentů: extraktor featur (G_f) mapující vstupy do featur prostoru (f = G_f(x, \theta_f)), prediktor popisků (G_y) mapující featurky na úkolové popisky (\hat{y} = G_y(f, \theta_y)), a doménový klasifikátor (G_d) mapující featurky na doménové popisky (\hat{d} = G_d(f, \theta_d)). Kritická inovace je Gradient Reversal Layer (GRL) umístěný mezi extraktorem featur a doménovým klasifikátorem. Během dopředné propagace, GRL funguje jako identitová transformace. Během backpropagace, násobí gradient (-\lambda), kde (\lambda) je hyperparametr kontrolující sílu adaptace. Toto obracení způsobuje, že extraktor featur naučí featurky, které maximalizují doménovou klasifikační ztrátu, efektivně naučí se oklamat doménový klasifikátor.
DANN ztrátová funkce kombinuje úkolovou ztrátu na zdrojových popiscích minus doménovou klasifikační ztrátu na obou zdrojových a cílových featurách:
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
Jak trénink pokračuje, extraktor featur naučí reprezentace, které jsou obě diskriminativní pro úkol (protože prediktor popisků je trénován na zdrojových popiscích) a doménově-invariantní (protože doménový klasifikátor nemůže rozlišit doménový původ). Plánování GRL typicky začíná s (\lambda = 0) a postupně zvyšuje na maximalní hodnotu přes prvních několik epoch, umožňující síti stabilizovat svou úkolovou performance, než tlak doménové konfuze je aplikován.
Nedávné pokroky v adversariální adaptaci domény zahrnují Contrastive Adversarial Training (CAT), který využívá označené zdrojové vzorky, aby zesílil separaci featur při zachování doménového zarovnání, Collaborative and Adversarial Networks (CAN), který vykonává víceúrovňové doménové zarovnání na různých úrovních hierarchie featur, a Adversarial Style Discrepancy Minimization, který používá přenos stylu jako adversariální objektiv. Pro detekci trhlin na vozovce, adversariální metody demonstrovaly nejsilnější cross-dataset generalizaci, obnovující 15–25 procentních bodů performance ztracené doménovým posunem.
Metody založené na diskrepanci
Metody založené na diskrepanci berou jiný přístup: místo adversariálního tréninku, explicitně minimalizují statistickou míru distance mezi zdrojovými a cílovými distribucami featur. Výhoda je stabilita tréninku, žádné adversariální dynamiky vyžadující pažlivé ladění hyperparametrů, za cenu potenciálně slabšího zarovnání.
Maximum Mean Discrepancy (MMD) je nejvíce používaná diskrepanční míra pro adaptaci domény. MMD je statistický test založený na jádru měřící distanci mezi dvěma distribucami v Reproducing Kernel Hilbert Space (RKHS). Dané zdrojové featurky (\mathbf{f}^S) a cílové featurky (\mathbf{f}^T), squared MMD je:
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
kde (\phi) je mapa příznaků do RKHS. V praxi, MMD je vypočítán používající jádrovou funkci (k(x,y) = \langle \phi(x), \phi(y) \rangle), typicky Gaussovo RBF jádro, často s více šířkami pásma, aby zachytil různé úrovně podobnosti distribuce.
Deep Adaptation Networks (DAN), představené Long et al. v 2015, přidávají MMD ztrátu na více úkolově-specifických vrstvách hluboké CNN. Celková ztráta se stává (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), kde (L) je množina vrstev, na kterých doménový zarovnání je aplikován. DAN demonstroval, že zarovnávání vyšších úrovní reprezentací featur (ne pouze finální vrstvy) signifikantně zlepšuje kvalitu adaptace.
CORrelation ALignment (CORAL), představený Sun a Saenko v 2016, bere jednodušší přístup minimalizováním rozdílu mezi zdrojovými a cílovými kovariančními maticami featur:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
kde (C_S) a (C_T) jsou kovarianční matice featur zdroje a cíle, (d) je dimenze featur, a (|\cdot|_F) je Frobeniusova norma. Deep CORAL rozšiřuje to na hluboké sítě přidáním CORAL ztráty do ztrátové funkce sítě. CORAL je výpočetně efektivní a funguje dobře, když doménový posun je primárně ve varianci featur, ne v střední.
Joint Adaptation Networks (JAN) rozšiřují DAN zarovnáváním společných distribucí více vrstev místo léčení každé vrstvy nezávisle. JAN používá Joint MMD (JMMD), definovaný na tensor produktu aktivací z více vrstev. To zachycuje mezivrstevní závislosti, které individuální MMD ztráty missují.
Nedávné pokroky pro inspekci infrastruktury zahrnují rámec Wang et al. (2025) pro segmentaci koróze, který kombinuje tři komplementární diskrepanční moduly: Geometric Structure Preservation (GSP) zachovávající lokální topologické relace přes domény používající regularizaci založenou na grafu, SVD-based Local Discrepancy (SLD) používající rozklad singulárních hodnot, aby zarovnal lokální featur podprostory na fině-zrnité úrovni, a Global Consistency Alignment (GCA) používající MMD, aby sladil globální distribuční posuny. Tento kombinovaný přístup, podporovaný lehkým EffSegNet segmentacním backbone, dosáhl silné cross-doménové generalizace z laboratorních obrazů koróze na polní podmínky na zámkách, damách a transportní infrastruktuře.
Porovnání UDA Metod
| Metoda | Kategorie | Mechanismus zarovnání | Stabilita Tréninku | Performance Infrastruktura |
|---|---|---|---|---|
| DANN | Adversariální | Gradient reversal + doménový klasifikátor | Střední (vyžaduje ladění (\lambda)) | Silná (obnovuje 15–25 ppt mIoU) |
| DAN | Diskrepance | MMD na výstupech více vrstev | Vysoká | Dobrá (obnovuje 10–20 ppt mIoU) |
| Deep CORAL | Diskrepance | Kovarianční zarovnání (2. řádové statistiky) | Vysoká | Střední (obnovuje 8–15 ppt mIoU) |
| JAN | Diskrepance | Joint MMD na párech vrstev | Vysoká | Dobrá (obnovuje 12–18 ppt mIoU) |
| CycleGAN+Det | Generativní | Překlad obraz na obraz + úkolový model | Nízká (GAN tréninková obtížnost) | Silná, když překlad obrazu uspěje |
| CAT | Adversariální | Kontrastivní + adversariální | Střední | Silná (nejmodernější na několika benchmarkech) |
Učení doménově-invariantních featur
Doménově-invariantní featurky jsou reprezentace featur produkované neuronovou sítí, které mají stejnou statistickou distribuci bez ohledu na to, z které domény vstup pochází. Pokud (f(x)) je reprezentace featur extrahovaná sítí, doménová invariance znamená (P(f(X_S)) \approx P(f(X_T))). Cílem je naučit se mapování (f) tak, že distance (d(P(f(X_S)), P(f(X_T)))) je minimalizována při zachování úkolově-specifické diskriminativní síly.
Čtyři hlavní přístupy k učení doménově-invariantních featur každý řeší kompromis invariance-diskriminability jinak. Adversariální učení (DANN, GAN-based) tlačí extraktor featur produkovat featurky, které doménový diskriminátor nemůže rozlišit. To je nejagresivnější mechanismus invariance, ale rizikuje odstranění úkolově-relevantní informace, pokud textura trhliny koreluje s typem povrchu. Statistické přizpůsobení momentů (MMD, CORAL) zarovnává momenty distribuce, první řád (střední) a druhý řád (kovariance), mezi zdrojovými a cílovými featurkami. To zachovává více úkolově-relevantní informace než plné adversariální zarovnání, ale může ne zachytit vyšší-řádové rozdíly distribuce. Optimalní transport (OT-based metody) najde minimal-cost mapování mezi zdrojovými a cílovými distribucami, poskytující geometrickou interpretaci doménového zarovnání. Přenos stylu a generativní metody (CycleGAN, StarGAN) transformují obrazy z jedné domény, aby vizuálně připomínaly jinou, před tím, než je procházeny přes úkolovou síť. To operuje na pixel úrovni místo featur úrovni a má výhodu produkování interpretovatelných transformovaných obrazů.
Kompromis invariance-diskriminability je fundamentální napětí v učení doménově-invariantních featur. Maximalizace doménové invariance může odstranit úkolově-relevantní informaci, která koreluje s doménou. Například, pokud okraje trhlin na asfaltu mají vyšší kontrast než na betonu, detektor featur, který závisí na síle kontrastu okraje, bude senzitivní na přítomnost trhliny i na typ vozovky. Tlačení kompletní invariance k typu vozovky může supresovat featurky kontrastu okraje potřebné pro detekci trhlin. Pokročilé metody řeší to přes víceúrovňové zarovnání, zarovnávající pouze vyšší úrovně semantických featur při zachování nízkoúrovňových textur (vodítek), a kondicionální zarovnání, který zarovnává distribuce kondicionované na úkolový popisek, zachovávající třídově-diskriminativní informaci.
Doménová invariance založená na pozornosti využívá mechanismy pozornosti, aby soustředila na doménově-agnostické semantické regiony. Model detekce trhlin s prostorovým modulem pozornosti naučí se věnovat pozornost strukturám trhlin bez ohledu na texturu pozadí vozovky. Samotné mapy pozornosti se stávají více doménově-invariantní než surové featur mapy, protože zdůrazňují úkolově-relevantní prostorové lokace při supresování doménově-specifického pozadí. Křížová pozornost mezi zdrojovými a cílovými featurkami dále zesíli to tím, že explicitně matchuje attendované regiony přes domény.
Doménová adaptace založená na samoučení metody používají pomocné úkoly jako predikci rotace, řešení skládačky nebo kontrastivní instance diskriminaci, aby naučily featurky, které jsou robustní na doménovou variaci bez vyžadování jakýchkoli doménových popisků. Řešením těchto auxiliárních úkolů, model naučí se zachycovat strukturní a geometrické vlastnosti vstupu, které jsou sdílené přes domény. Featurky předtrénované samoučením často vykazují silnější doménovou invarianci než čistě řízené featurky, protože pomocné úkoly nezávisí na doménově-specifických distribucích popisků.
Adaptace ze silnice na dráhu
Přechod z inspekce silniční vozovky na inspekci letištní dráhy reprezentuje jeden z nejvýzvnějších problémů adaptace domény v managementu infrastrukturních aktiv. Silnice a dráhy jsou fundamentálně jiné inženýrské struktury designované pro jiné zatížení, rychlosti a bezpečnostní požadavky, produkující dramaticky jiné vizuální vzhledy a charakteristiky defektů.
| Faktor | Silniční vozovka | Letištní dráha |
|---|---|---|
| Návrhový standard | Variuje podle jurisdikce | ICAO Annex 14 / FAA standardy |
| Zatížení na os | ~10 ton (vozidla) | 50–400 ton (letadla) |
| Primární materiál povrchu | Asfalt (HMA) | Vysocefestný PCC beton (běžný) nebo těžký asfalt |
| Markování | Žluté/bílé pásové markování (více barev) | Pouze bílé markování, složné vzory (práh, touchdown zóna, cílový bod, centrální linie) |
| Primární typy defektů | Trhliny, díry, vyjeté koleje, vzlínání | Trhliny, FOD, gumové depozity, vydrolování, degradace frikce, eroze tryskem, poškození palivem |
| Přístup k inspekci | Veřejná silnice, lehký neomezený přístup | Omezený neveřejný prostor letiště, vyžaduje letištní průkaz, vozidlový doprovod, radio komunikaci |
| Dominantní metoda sbírání | Zemní vozidla, smartphony, manuální | UAV na 30–100m výšce, specializovaná inspekční vozidla |
| Kontaminanty povrchu | Voda, sněh, úlomky, olej | Voda, guma (kritická, touchdown zóny), odmrazovací tekutiny, letecké palivo, hydraulická tekutina |
| Bezpečnostně-kritický parametr frikce | Skid rezistence pro brzdení | Koeficient brzdení pro přistání letadel (ICAO GRF kategorie) |
| Regulativní rámec | FHWA, státní DOT standardy | ICAO Annex 14, Doc 9137, FAA ACs |
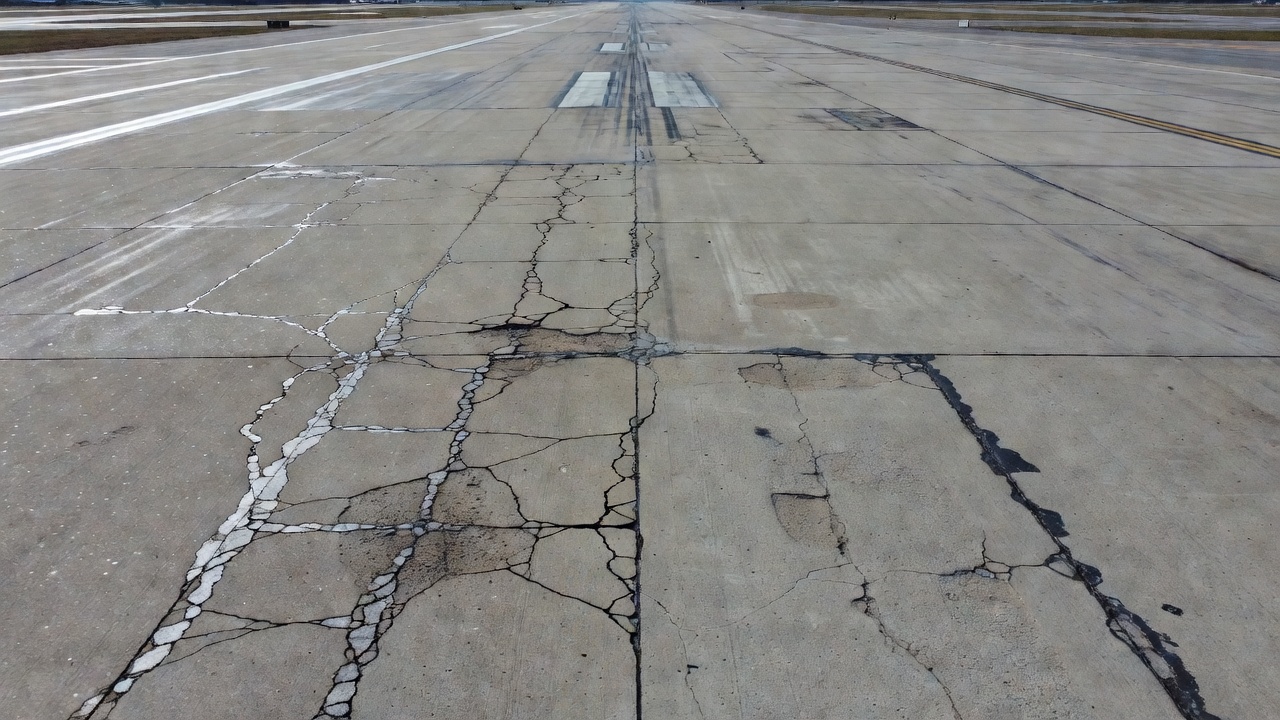
Interference gumových depozitů je jediný nejvýzvnější problém adaptace. Letadlové pneumatiky depozitují gumu na dráhách během přistání, zvlášť v touchdown zóně, akumulující se jako tmavé, kontinuální plochy na povrchu vozovky. Tyto gumové depozity mohou vizuálně imitovat nebo zakrývat trhliny. Silničně-trénovaný model detekce trhlin, který nikdy nezažil gumové depozity, může selhat v detekci trhlin pod gumovými plochami nebo falešně klasifikovat okraje gumových ploch jako trhliny. Adaptace ze silnice na dráhu musí proto inkorporovat modelování gumových depozitů, buď přes syntetickou augmentaci tréninkových dat nebo přes metody adaptace domény, které naučí se rozlišit gumu od trhlin.
Rozdíly v skále a rozlišení jsou další signifikantní bariéra adaptace. Obrazy silniční inspekce jsou typicky sbírány z úrovně země na distancích 1–5 metrů, dávající velmi vysoké rozlišení, kde individuální okraje trhlin zabírají desítky pixelů. Inspekce dráhy používající UAV na 30–100m výšce produkuje obrazy s hrubším rozlišením, trhlina, která zabírá 50 pixelů v silničním obrazu, může zabírat pouze 5–10 pixelů v obrazu dráhy sbíraném z výšky. Receptivní pole extraktoru featur a škálově závislé filtry musí adaptovat se na tento rozdíl v prostorové frekvenčním obsahem. Víceměřítkové pyramidy featur a škálově invariantní trénink jsou esenciální komponenty adaptace.
Nesoulad definice defektů vyžaduje pažlivé mapování mezi taxonomií distressu silnice a dráhy. FHWA LTPP Distress Identification Manual definuje defekty silniční vozovky v kategoriích, které částečně překrývají se s defekty letištní vozovky definovanými ASTM D5340 a ICAO Doc 9137 Part 9. Některé typy defektů jsou unikální pro letiště: gumové depozity, eroze tryskem, poškození palivem a degradace frikce nemají silniční ekvivalenty. Silničně-trénované modely proto potřebují nové výstupové třídy přidány během adaptace, nebo hierarchický klasifikaci přístup, který nejprve detektuje generické defekty a potom klasifikuje je do doménově-specifických kategorií.
Regulativní soulad ukládá dodatečnou vrstvu požadavku na adaptaci. Silniční inspekční modely produkují výstupy, které informují prioritizaci údržby od DOT agentur. Modely inspekce dráhy musí produkovat výstupy, které mapují na ICAO- a FAA-mandated reportovací formáty: Global Reporting Format (GRF) kondicionální kategorie, Pavement Condition Index (PCI) per ASTM D5340, a Pavement Classification Number (PCN) hodnocení. Proces adaptace musí proto také adaptovat výstupovou reprezentaci modelu, aby zarovnal s regulativními reportovacími standardy.
Postupné doménové přemostění, trénink na intermediárních datových sadách, které postupně překlenují mezeru mezi silnicí a dráhou, se prokázal efektivní. Typický postup přemostění používá tři fáze: první, trénovat na silničních datových sadách (CQU-BPDD, RDD2020, Crack500), druhý, adaptovat na generální datové sady vozovky, které zahrnují oba asfaltové a betonové povrchy, třetí, adaptovat na dráhově-specifické datové sady s gumovými depozity a letištními markováními. Každá fáze redukuje distribuční mezeru, kterou následující fáze musí překlenout, umožňující stabilnější a efektivnější adaptaci než direktní transfer ze silnice na dráhu.
Adaptace přes klimatické podmínky
Klimatické podmínky introdukují doménovou variaci, která je temporální (měnící se přes čas na jednom místě) a geografická (variující přes místa simultánně). Model deployovaný přes více letiště musí zvládnout obě dimenze.
Adaptace mokré vs suché povrchy je kritická, protože kategorie stavu povrchu dráhy podle ICAO Global Reporting Format explicitně rozlišují suchou, mokrou, kluzkou mokrou a kontaminovanou povrchy. Mokré povrchy mění viditelnost trhlin na několik způsobů. Voda naplňující trhliny redukuje kontrast mezi trhlinou a okolní vozovkou, suché trhliny vypadají jako vysoce-kontrastné tmavé nebo světlé lineární featurky, ale vodou naplněné trhliny vypadají jako nízko-kontrastné featurky, které mohou být téměř neviditelné pro model trénovaný na suchých povrchách. Vodní film na povrchu vozovky vytváří spekulární reflexe, které introdukují světlé regiony a falešné okraje, matoucí detektory trhlin. Mokrá vozovka také vypadá tmavější celkově, posouvající histogram obrazu a měnící statistiky každé vrstvy v síti.
Adaptace chladného klimatu řeší účinky mrazu a tání, které mění vzhled vozovky. Zamražené povrchy mají jiné reflexní vlastnosti než nezamražené. Ledové plochy na vozovce vypadají jako hladké, vysoce-reflexivní regiony, které sdílí vizuální charakteristiky s defekty povrchu vozovky. Sněhová pokryvka částečně nebo kompletně zakryvá defekty povrchu. Přechod mezi cykly zamražení a rozmražení produkuje unikální vzory distressu: D-praskání, odprýskávání způsobené mrazem a mrazový zdvih, které modely trénované na teploklimatických datech nemohou rozpoznat.
Datová augmentace pro klimatickou adaptaci synteticky generuje cílové doménové variace ze zdrojových doménových obrazů. Přidání simulovaných dešťových stríček, modelů reflexe mokré povrchy, masek sněhové pokryvky a overlaye okénů může rozšiřit pokrytí zdrojové domény, aby zahrnula klimatické podmínky nepresentní v původních tréninkových datech. RandAugment politiky s specifickými fotometrickými transformami cílícími jasnost, kontrast a posun barevné temperatury jsou zvlášť efektivní pro klimatickou adaptaci. Studie zobrazují, že augmentace-only přístupy obnovují 50–70% performance ztracené posunům osvětlení a počasí, činící je nákladově-efektivním komplementem ke složenějším adversariálním nebo metodám založeným na diskrepanci.
Doménový překlad založený na CycleGAN poskytuje alternativu tím, že naučí se translatovat obrazy mezi klimatickými podmínkami. CycleGAN trénovaný na párových nebo nepárových obrazech ze suchých a mokrých dráh naučí se mapovat ze suché domény na mokrou doménu při zachování lokací a geometrií trhlin. Modely detekce trhlin trénované na této augmentované date naučí featurky, které jsou invariantní na přítomnost nebo nepřítomnost vody na povrchu. Nevýhoda je složenost tréninku GANů a riziko halucinování nebo odstranění featur trhlin během translace.
Adaptace přes typy kamer
Systémy inspekce infrastruktury používají různé obrazovací platformy, každá s jinými optickými charakteristikami, které introdukují doménový posun. Adaptace přes typy kamer je esenciální pro každý systém deployovaný přes více letiště, kde existující obrazy mohou pocházet z jiných zdrojů.
Rozlišení a Ground Sampling Distance (GSD) variují široce. Inspekce z úrovně země s 50 MP DSLR produkuje GSD 0,1–0,5 mm/pixel. UAV inspekce na 30 m výšce produkuje 0,5–1 cm/pixel. UAV inspekce na 100 m výšce produkuje 2–5 cm/pixel. Satelitní obrazy mohou mít 30–50 cm/pixel rozlišení. Trhlina, která je 3 mm široká, zabírá 6–30 pixelů na úrovni země, 0,3–0,6 pixelů na 30 m UAV výšce a je subpixelový na 100 m. Modely trénované na vysoce-rozlišných zemních obrazech nemohou direktně detektovat featurky na hrubších rozlišeních. Trénink na více rozlišeních, trénink na obrazech na více rozlišných skálách, je primární strategie. Extraktor featur naučí škálově invariantní reprezentace přes pyramidové sdružování, dilatované konvoluce nebo resolution-adaptivní normalizaci.
Rozdíly v spektrální senzitivitě senzoru mezi kamerami ovlivňují barevnou reprezentaci. Různé CMOS a CCD senzory mají jiné krivky kvantové efektivity přes viditelný spektr, což znamená, že stejná povrch vypadá s lehce jinými RGB hodnotami z jiných kamer. Barevná kalibrace používající barevná kontrolní tabulka během sbírání dat redukuje tento posun, ale je zřídka praktická pro velko-měřítkové inspekční programy. Přizpůsobení histogramu a barevný přenos mezi zdrojovými a cílovými obrazy jsou preprocessing alternativy. Sofistikovanější přístupy zahrnují senzor-invariantní učení featur, které explicitně odstraní senzor-specifické barevné informace z reprezentací featur přes augmentaci barevného jitteru během tréninku.
Distorze objektivu variuje přes kombinace kamery a objektivu. Širokoúhlové objektivy používané pro efektivní pokrytí dráhy introdukují sudovou distorzi, která mění geometrii trhlin, přímé trhliny mohou vypadat zakřivené blízko okrajů obrazu. Pro detekční úkoly, tato distorze ovlivňuje prostorový relaci mezi featurkami obrazu. Korekce distorze jako preprocessing krok normalizuje všechny obrazy do společné rektifikované geometrie před tím, než jsou podávány modelu. Alternativně, trénink na obrazech s syntetickou augmentací distorze činí model robustní na variující úrovně distorze.
Rolling shutter efekty z UAV platform introdukují geometrickou distorzi během letu, zvlášť při vysoké rychlosti nebo ve větrných podmínkách. Sekvenciální expozice řádků v rolling shutter CMOS senzoru znamená, že pohyb kamery během expozice produkuje skošené nebo deformované geometrie trhlin. Tato temporální distorze je nepřítomná v global shutter kamerách a v zemním statickém sbírání. Adaptace vyžaduje buď preprocessing k korekci rolling shutter artefaktů nebo trénink na datech, která zahrnuje syntetickou degradaci rolling shutter.
| Variace Kamery | Strategie Adaptace | Složenost Implementace | Typická Obnova |
|---|---|---|---|
| Rozlišení / GSD | Trénink na více rozlišeních + pyramidové sdružování | Střední | 5–10% obnova přesnosti |
| Barevná odpověď senzoru | Augmentace barevného jitteru + přizpůsobení histogramu | Nízká | 3–7% obnova přesnosti |
| Distorze objektivu | Preprocessing korekce distorze | Nízká | 2–5% obnova přesnosti |
| Rolling shutter | Syntetická augmentace rolling shutter | Střední | 3–6% obnova přesnosti |
| Kompresní artefakty | Augmentace JPEG komprese | Nízká | 1–3% obnova přesnosti |
Matematické základy a klíčové formulace
Rozumění adaptace domény vyžaduje familiaritu s několika jádrovými matematickými formulacemi. Empirical Risk Minimization (ERM) rámec poskytuje výchozí bod. Daná zdrojová doména s označenými vzorky ({(x_i^S, y_i^S)}_{i=1}^{n_S}), standardní model minimalizuje empirické riziko:
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
kde (\ell) je úkolově-specifická ztrátová funkce (cross-entropie pro klasifikaci, Dice ztráta pro segmentaci). Adaptace domény cílí minimalizovat cílové riziko:
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
Výzva je, že (R_T) nemůže být direktně minimalizován, když cílové popisky nejsou dostupny. Metody adaptace domény omezují cílové riziko sumou zdrojového rizika a divergence míry mezi zdrojovými a cílovými distribucami.
H-divergence poskytuje teoretickou mez pro adaptaci domény (Ben-David et al., 2010). Pro hypotézovou třídu (\mathcal{H}), H-divergence mezi zdrojovou a cílovou distribucí je:
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
V praxi, H-divergence je estimována trénováním klasifikátoru, aby diskriminoval mezi zdrojovými a cílovými doménovými vzorky, přesně to, co doménový klasifikátor v DANN dělá. Teoretický výsledek garantuje, že model trénovaný na zdrojových datech bude generalizovat na cílovou doménu, pokud H-divergence mezi doménami je malá. To poskytuje formální justifikaci pro adversariální adaptaci domény.
MMD v funkcionální formě používá charakteristické jádro (k), aby zobrazil distribuce pravděpodobnosti v RKHS:
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
S Gaussian kernelem (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)), squared MMD může být vypočítán direktně ze vzorkových středních:
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
CORAL ztráta zarovnává druhé-řádové statistiky:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
kde (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) a (C_T) je definován analogicky pro cílové featurky. Frobeniusova norma (|\cdot|_F) je součet po prvcích kvadrátů.
Tyto matematické základy translatují se direktně do praktické implementace. Ztráta adaptace domény pro Deep CORAL síť je:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Pro DANN síť:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{domain}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
kde (\mathbf{D} = {0, 1}) indikuje zdrojovou (0) nebo cílovou (1) doménu, a negativní znak reflektuje gradient reversal.
| Metoda | Objektivní Funkce | Klíčové Hyperparametry |
|---|---|---|
| ERM (bez adaptace) | (\mathcal{L} = \mathcal{L}_{task}(D_S, Y_S)) | Rychlost učení, váhový rozpad |
| DANN | (\mathcal{L} = \mathcal{L}{task} - \lambda \mathcal{L}{domain}) | (\lambda) (síla adaptace), plán GRL |
| DAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) na vrstvu, šířka jádra (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{task} + \lambda |C_S - C_T|_F^2) | (\lambda) (váha zarovnání) |
| JAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l JMMD_l) | Páry vrstev, šířky jádra |
| Dolaďování | (\mathcal{L} = \mathcal{L}_{task}(D_T, Y_T)) redukovaný LR | plán zmrazení, LR redukční faktor |
Evaluacní protokoly pro adaptaci domény
Evaluace metod adaptace domény vyžaduje standardizované cross-dataset benchmarky, které měří performance na cílových doménách neviděných během tréninku. Pro inspekci infrastruktury, několik benchmark protokolů bylo ustanoveno.
Cross-dataset evaluace je standardní protokol. Model je trénován na zdrojové datové sadě (např., CQU-BPDD, která obsahuje obrazy trhlin na bituminózní vozovce) a evaluován na cílové datové sadě (např., RDD2020, která obsahuje obrazy silničních trhlin z více zemí). Performance na cílové datové sadě před adaptací slouží jako baseline pouze se zdrojovými daty. Performance po adaptaci (s přístupem k neoznačeným cílovým datům pro UDA nebo omezeným označeným cílovým datům pro SDA) je měřena proti tomuto baseline. Zisk z adaptace, rozdíl mezi adaptovanou a neadaptovanou performance, kvantifikuje efektivitu metody adaptace.
Běžné benchmarky pro detekci trhlin na vozovce zahrnují: CQU-BPDD (Bituminous Pavement Crack Dataset) obsahující 60 088 obrazů trhlin na asfaltové vozovce z Číny, RDD2020 obsahující 26 336 obrazů silničních trhlin z Indie, Japona a České republiky, Crack500 obsahující 500 vysoce-rozlišných obrazů trhlin na silničních povrchách, DeepCrack obsahující 537 obrazů trhlin na stěnách budov, a SDNET2018 obsahující 56 000 obrazů betonových mostových decků, stěn a vozovek. Cross-dataset evaluace přes tyto datové sady, zvlášť z CQU-BPDD na RDD2020, reprezentující cross-country a cross-climate transfer, je nejpřísnější benchmark.
Metriky pro posouzení adaptace domény zahrnují mIoU v cílové doméně (mean Intersection over Union pro segmentační úkoly), F1-score v cílové doméně (pro detekční úkoly), zachování zdrojové domény (performance na zdrojové doméně po adaptaci, aby se měřilo katastrofické zapomínání), zisk z adaptace (zlepšení v procentních bodech nad baseline pouze se zdrojovými daty) a efektivita popisků (kolik cílových označených dat je potřebno, aby se dosáhla daná úroveň performance pro řízené metody).
Statistická signifikance testování je esenciální, protože výsledky adaptace domény mohou být zašuměné. Více runů s jinými náhodnými semeny (typicky 5–10) se používají, aby se vypočítala střední a standardní deviaci metrik performance. Wilcoxon signed-rank test nebo paired t-test se používá, aby se určilo, zda rozdíly performance mezi metodami adaptace jsou statisticky signifikantní na konvencionálních prahách ((p < 0,05)).
Pro inspekci infrastruktury, dodatečné metriky specifické pro nasazení jsou relevantní: míra falešně pozitivních na operacionálních prahách závažnosti (detektor trhlin, který generuje 100 falešných alarmů na inspekci dráhy, je operacionálně bezcenný bez ohledu na jeho mIoU), čas inference na jednotku plochy (adaptace by neměla signifikantně zvýšit čas procesování) a paměťová náročnost (metody s adaptéry by měly přidat minimální režii ukládání na dodatečné letiště).
Klíčové standardy a reference
Praxe adaptace domény pro inspekci infrastruktury čerpá na standardy a výzkum z více disciplín.
Základy strojového učení: Ganin et al., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), kanonický DANN článek zavádějící gradient reversal. Long et al., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), introdukující MMD-based víceúrovňové doménové zarovnání. Sun and Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), zavádějící zarovnání založené na kovarianci. Ben-David et al., “A theory of learning from different domains” (Machine Learning, 2010), teoretický rámec pro generalizační meze adaptace domény.
Adaptace domény pro inspekci infrastruktury: Liu et al., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), primární reference pro adaptaci domény detekce trhlin s architekturou se dvěma větvemi se sdílenými vahami. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), víceúrovňové zarovnání příznaků pro cross-dataset detekci trhlin. Wang, Nguyen, Eick et al., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), třímodulový diskrepanční rámec pro korozi infrastruktury.
ICAO a FAA standardy: ICAO Annex 14, Aerodromes, Volume I (8th Edition, 2018 s amendementy), primární mezinárodní standard pro certifikaci aerodromů, vytvářející kontext doménového posunu přes letiště. ICAO Doc 9137, Part 9, Airport Services Manual, Airport Maintenance Practices, směrnice údržby vozovky. ICAO Global Reporting Format (GRF) for Runway Surface Conditions (efektivní November 2021), definující domény stavu povrchu (suchá, mokrá, kontaminovaná). FAA AC 150/5380-6C, Guidelines and Procedures for Maintenance of Airport Pavements. ASTM D5340, Standard Test Method for Airport Pavement Condition Index Surveys, kvantitativní rámec pro posouzení stavu vozovky, který doménově-adaptované modely musí podporovat.
Datové sady vozovky: CQU-BPDD (Chongqing University, 60 088 obrazů trhlin na asfaltové vozovce). RDD2020 (8 300+ silničních obrazů z Indie, Japona, České republiky). Crack500 (500 vysoce-rozlišných obrazů trhlin na vozovce). SDNET2018 (56 000 obrazů mostových decků, stěn a vozovek z Utah State University). Tyto datové sady poskytují standardizované benchmarky pro evaluaci adaptace domény v inspekci vozovky.
Často kladené otázky
- Co je adaptace domény v strojovém učení?
- Adaptace domény je podoblast transfer learningu, která řeší problém doménového posunu, kde model trénovaný na zdrojové datové sadě funguje špatně, když je deployován na cílové datové sadě s různými statistickými vlastnostmi. Cílem je naučit se doménově-invariantní reprezentace featur, aby model generalizoval přes domény bez potřeby kompletního retréninku na označených cílových datech. Adaptace domény se kategorizuje na řízenou (omezená označená cílová data dostupná), neřízenou (žádná označená cílová data) a semi-řízenou (některá označená plus neoznačená cílová data) varianty.
- Jak doménový posun ovlivňuje modely detekce trhlin na vozovce?
- Doménový posun v detekci trhlin na vozovce způsobuje poklesy performance o 30–45% v mean Intersection over Union (mIoU) při přechodu z jedné datové sady na druhou. Zdroje posunu zahrnují rozdíly v materiálu povrchu (asfalt vs beton), variaci morfologie trhlin (longitudinální vs aligátorové trhliny), změny v podmínkách obrazování (úhel světla, rozlišení, kamerový senzor) a geografické faktory (různé typy agregátů a vzory stárnutí). Například model trénovaný na datové sadě CQU-BPDD dosahuje 0,72 mIoU na zdrojových testovacích datech, ale klesá na 0,31, když je testován na cílových datech RDD2020 bez adaptace.
- Jaký je rozdíl mezi transfer learningem a adaptací domény?
- Transfer learning přizpůsobuje model předtrénovaný na jednom úkolu, aby vykonával jiný úkol, například dolaďování modelu ImageNet klasifikace pro detekci trhlin. Adaptace domény řeší stejný úkol přes různé distribuce dat, například přizpůsobení detektoru trhlin na asfaltu, aby detektoval trhliny na betonových povrchách. V transfer learningu se zdrojový a cílový úkol mohou lišit, v adaptaci domény je úkol identický, ale vstupní distribuce se liší.
- Co jsou doménově-invariantní featurky?
- Doménově-invariantní featurky jsou reprezentace extrahované neuronovou sítí, které mají stejnou statistickou distribuci bez ohledu na to, z které domény vstup pochází. Pokud síť pro detekci trhlin naučí featurky, které vypadají stejně, ať vstup je obraz asfaltové silnice nebo betonové dráhy, ty featurky jsou doménově-invariantní. Jsou naučeny přes adversariální trénink (doménový diskriminátor nemůže říct, z které domény featurky pocházejí), statistické přizpůsobení momentů (MMD, CORAL) nebo techniky optimalního transportu. Základní výzvou je kompromis invariance-diskriminability: přílišné tlačení featur k doménové invarianci může odstranit úkolově-relevantní informaci, jako texturu trhliny, která koreluje s typem povrchu.
- Jak funguje neřízená adaptace domény?
- Neřízená adaptace domény (UDA) používá označená zdrojová data a neoznačená cílová data, aby trénovala model, který generalizuje na cílovou doménu. Tři hlavní přístupy jsou: (1) adversariální metody jako DANN, kde doménový diskriminátor snaží se identifikovat, z které domény featurky pocházejí, zatímco extraktor featur snaží se ho oklamat, (2) metody založené na diskrepanci jako DeepCORAL a DAN, které minimalizují statistické míry distance (MMD, kovarianční rozdíl) mezi zdrojovými a cílovými distribucami featur, a (3) rekonstrukční metody, které používají autoenkodery nebo GANy, aby naučily sdílené reprezentace.
- Jaké výzvy existují při adaptaci z silnice na letištní dráhu?
- Adaptace z silnice na dráhu čelí fundamentálním rozdílům v materiálu povrchu (asfalt vs vysocefestný PCC beton), charakteristikám zatížení (10-tonové osi vozidel vs 50–400 tonové zatížení letadel), typům defektů (gumové depozity, eroze tryskem, poškození palivem na dráhách), přístupu k inspekci (veřejné silnice vs omezený neveřejný prostor letiště), metodám sbírání obrazů (zemní vozidla vs UAV na 30–100m výšce) a regulativnímu souladu (ICAO Annex 14 standardy). Interference gumových depozitů je zvlášť výzvná, gumové depozity akumulují se jako tmavé plochy na dráhách, které mohou imitovat nebo zakrývat trhliny, stav, který silniční modely nikdy nezažili.
- Co je Domain-Adversarial Neural Network (DANN)?
- Domain-Adversarial Neural Network (DANN), představený Ganinem a Lempitskym v 2015, je kanonická architektura pro adversariální adaptaci domény. Sestává z tří komponentů: extraktoru featur, který mapuje vstupy do sdíleného featur prostoru, prediktora popisků, který vykonává úkol (např. klasifikaci trhlin), a doménového klasifikátoru, který predikuje, z které domény vstup pochází. Gradient Reversal Layer (GRL) sedí mezi extraktorem featur a doménovým klasifikátorem, během backpropagation obrací znak gradientu, což způsobuje, že extraktor featur naučí featurky, které maximalizují doménovou konfuzi. Celková ztráta kombinuje úkolovou ztrátu na zdrojových popiscích minus doménovou klasifikační ztrátu, váženou hyperparametrem lambda.
- Které strategie adaptace domény pasují pro různé množství cílových dat?
- Strategie sleduje množství dostupných cílových dat. Plné dolaďování pasuje pro střední množství označených cílových dat, ladění poslední vrstvy nebo ladění pomocí adaptérů pasuje pro velmi omezená označená data, a neřízená adaptace používající normalizace dávky statistiky a zarovnání příznaků se používá, když žádné cílové popisky neexistují. Postupné odmrazování a augmentace přizpůsobená cílovým podmínkám obrazování pomáhají adaptovanému modelu zachovat to, co se naučil ze zdrojové domény.
- Co je Maximum Mean Discrepancy (MMD)?
- Maximum Mean Discrepancy (MMD) je statistický test založený na jádru používaný k měření distance mezi dvěma distribucami pravděpodobnosti v Reproducing Kernel Hilbert Space (RKHS). V adaptaci domény se MMD používá jako ztrátová funkce k minimalizaci rozdílu distribuce mezi zdrojovými a cílovými reprezentacami featur. MMD formula vypočítá normu rozdílu mezi středními embeddingy zdrojových a cílových featur v RKHS. Deep Adaptation Networks (DAN) a Joint Adaptation Networks (JAN) inkorporují MMD ztrátu na více vrstvách sítě, aby dosáhly víceúrovňového doménového zarovnání.
- Které ICAO standardy se týkají adaptace domény pro inspekci dráhy?
- ICAO Annex 14 ustanovuje standardy pro design a operace aerodromů, které vytváří přirozený požadavek na adaptaci domény: různé letiště mají různé materiály vozovky, klimaty a historie údržby, takže inspekční modely musí adaptovat se mezi letišti. Global Reporting Format (GRF) definuje kategorie stavu povrchu dráhy (suchá, mokrá, kluzká mokrá, kontaminovaná), které reprezentují distinktní vizuální domény. ICAO Doc 9137 Part 9 a FAA AC 150/5380-6C poskytují směrnice údržby. Při deployování AI-based inspekce přes letiště je adaptace domény esenciální, protože model trénovaný na datech z jednoho letiště bude čelit jinému osvětlení, stáří vozovky a morfologiím defektů na jiném.
Toto je referenční položka. TarmacView poskytuje služby inspekce drony a neprodává zařízení ani materiály popsané v tomto slovníku.