Was ist Risssegmentierung?
Risssegmentierung ist eine Aufgabe der Computer Vision, die jedes Pixel eines Bildes als Riss oder Nicht-Riss kennzeichnet. Das Ergebnis ist eine Maske mit derselben Größe wie das Bild. Risspixel erhalten den Wert 1, alle anderen Pixel den Wert 0.
Unterschied zu Klassifizierung und Detektion
Die Klassifizierung liefert ein Label für das ganze Bild. Die Detektion zeichnet Rahmen. Ein Rahmen um einen dünnen, gewundenen Riss besteht größtenteils aus Hintergrund und sagt nichts über die Breite oder Verzweigungen des Risses aus. Eine Maske behält die Form des Risses.
Was die Maske liefert
Wenn die Größe eines Pixels auf der Oberfläche bekannt ist, liefert die Maske Messwerte:
- Fläche: die Anzahl der Risspixel multipliziert mit der Fläche eines Pixels.
- Länge: die Länge der Ein-Pixel-Mittellinie jedes Risses, die durch Ausdünnen der Maske gefunden wird.
- Breite: der Abstand von der Mittellinie bis zum Rissrand, verdoppelt.
Eine gröbere Pixelgröße bedeutet, dass haarfeine Risse unter ein Pixel fallen und verloren gehen. Die Pixelgröße auf der Oberfläche hängt von der Kamera und vom Abstand zur Fahrbahn ab.
Modelle und Daten
Die meisten Rissmodelle sind Encoder-Decoder-Netze. U-Net ist der übliche Ausgangspunkt. Es hat einen Pfad, der den Kontext erfasst, und einen Pfad, der die Position wiederherstellt. Es lernt aus wenigen Bildern (U-Net-Veröffentlichung ).
Öffentliche Trainingsdatensätze sind klein und zeigen überwiegend Straßen oder Campus-Fahrbahnen. DeepCrack hat 537 annotierte Bilder von Asphalt und Beton. CrackForest hat 118 annotierte Straßenbilder, und CRACK500 hat 500 Fahrbahnbilder, die mit Mobiltelefonen aufgenommen wurden. CrackSeg9k kombiniert mehrere solcher Datensätze. Ein Modell, das mit ihnen trainiert wurde, hat keine gerillte Piste gesehen. Deshalb muss es auf Flugplatzbildern geprüft werden, bevor seinen Ergebnissen vertraut wird.
Was sie auf einem Flugplatz leistet und was nicht
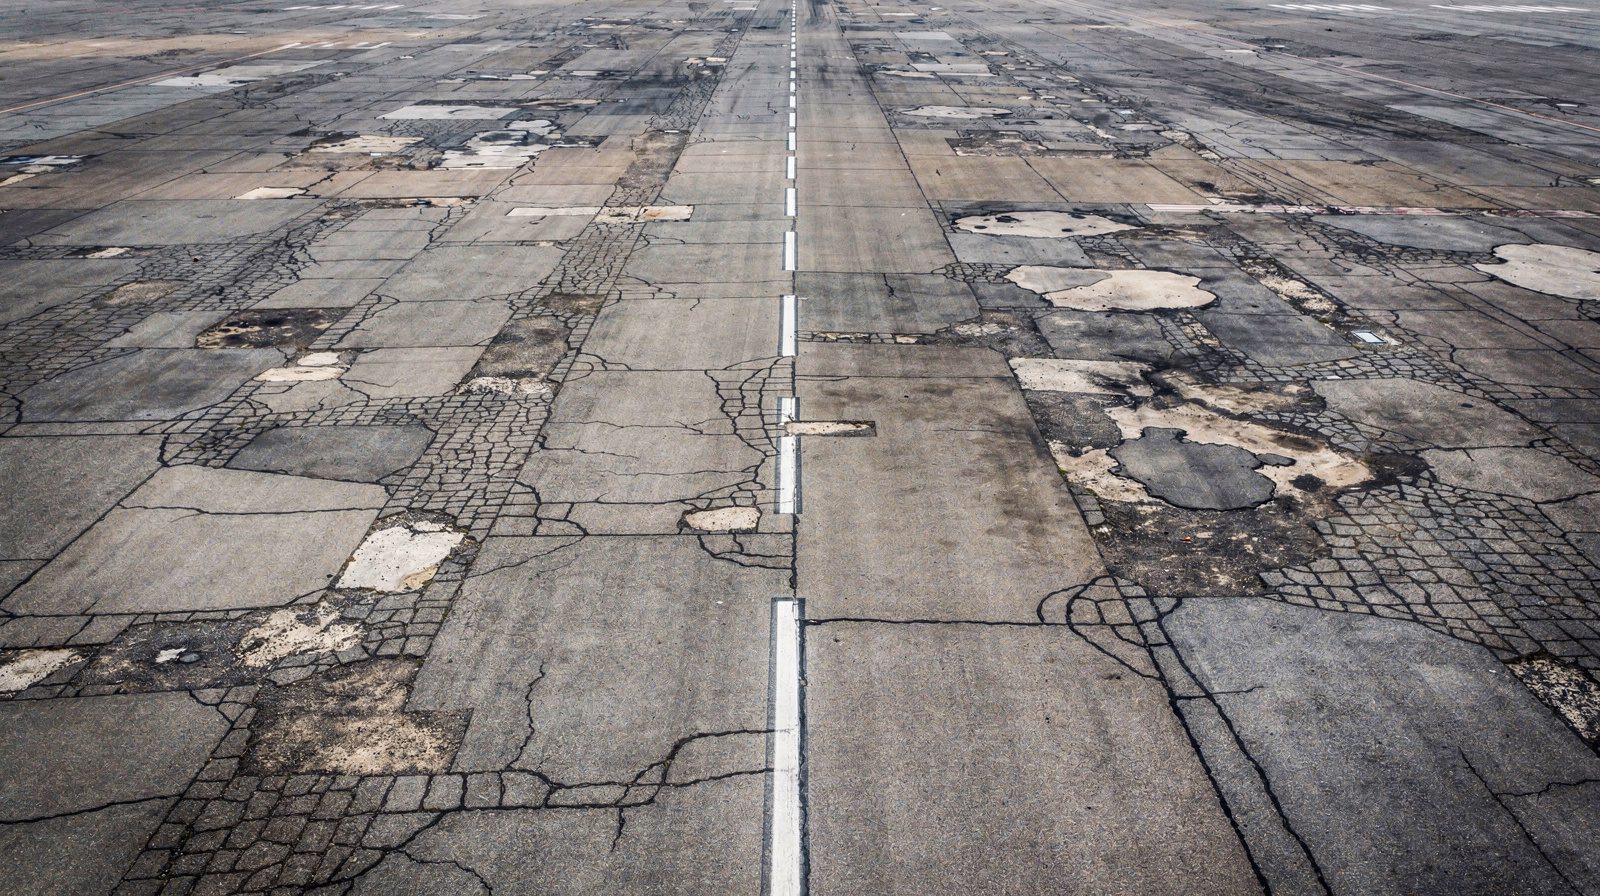
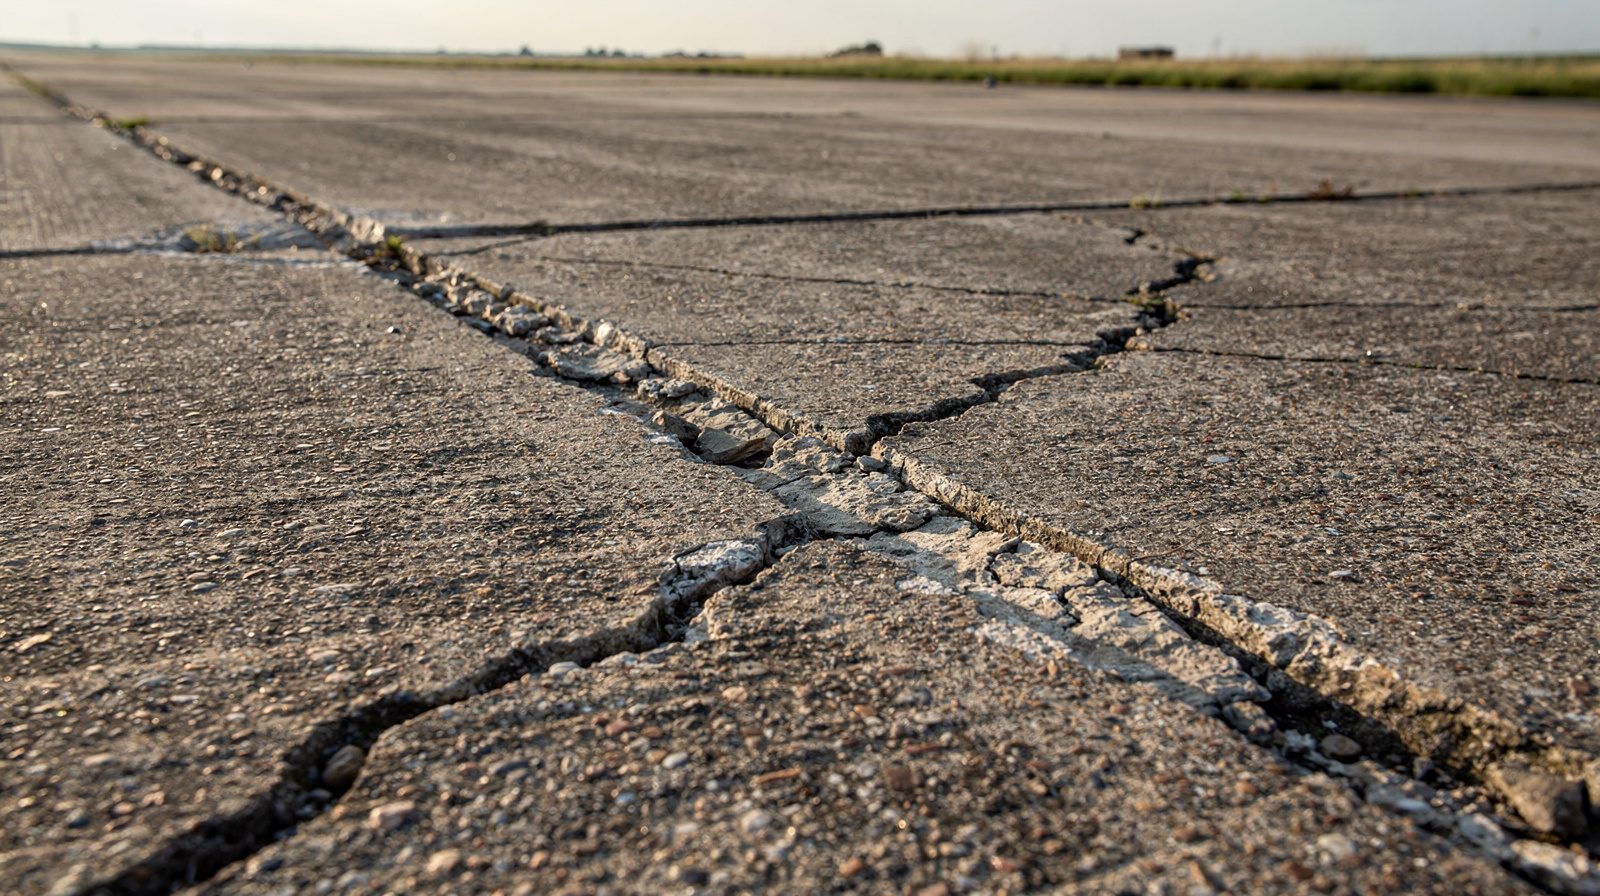
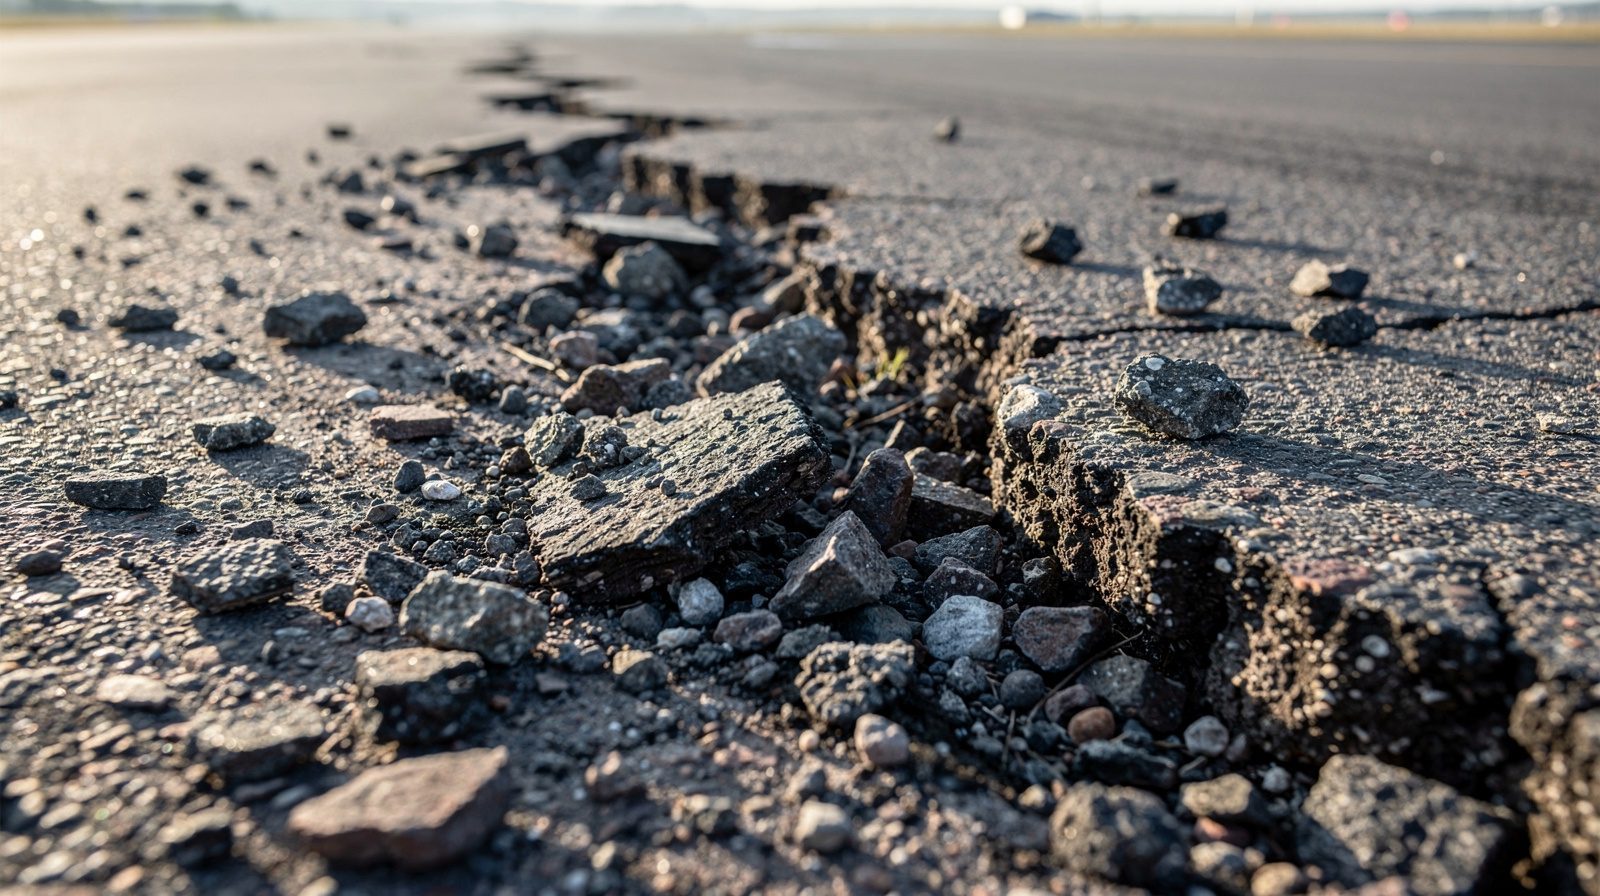
Die EASA-Anleitung nennt drei Anzeichen für Fahrbahnschäden, auf die bei einer Inspektion zu achten ist. Das sind Risse und Abplatzungen bei Beton, der Zustand der Fugenabdichtung und Risse im Asphalt. Die Anleitung weist außerdem darauf hin, dass gerissene und abgeplatzte Fahrbahnen Teile lösen können, die zu Fremdkörpern (Foreign Object Debris, FOD) werden.
Eine Maske ist ein Messeingang, keine Bewertung. Bei der PAVER-Methode hängt der Schweregrad eines Längs- oder Querrisses im Asphalt vom Abplatzen und vom Zustand der Füllung ab. Bei einem nicht gefüllten Riss erhöht eine mittlere Breite über 6 mm den Schweregrad außerdem auf mittel. Die Länge wird je Schweregrad in laufenden Fuß oder in Metern erfasst.
Zwei Besonderheiten von Flugplätzen erfordern eine eigene Behandlung:
- Rillen: Gesägte Rillen verlaufen quer, sind 6 mm breit, 6 mm tief und liegen auf einer Piste 38 mm auseinander. Ein Modell muss diese regelmäßigen Linien von Rissen unterscheiden können.
- Fugen: Betonplatten haben Fugen in festen Abständen, je nach Plattendicke zwischen 3,8 m und 6,1 m. Fugen sind konstruktive Elemente und keine Risse, auch wenn der Zustand der Fugenabdichtung kontrolliert wird.
Häufig gestellte Fragen
- Wie unterscheidet sich die Risssegmentierung von der Rissdetektion?
- Die Segmentierung markiert die genauen Pixel jedes Risses. Die Detektion zeichnet einen Rahmen um einen Riss, und die Klassifizierung sagt nur, ob ein Bild einen Riss enthält. Die Maske ermöglicht es der Software, Länge und Breite eines Risses zu messen, weil ein Rahmen um einen dünnen Riss größtenteils aus Hintergrund besteht.
- Gibt eine Rissmaske den Schweregrad eines Risses an?
- Nein. Eine Maske liefert Lage, Länge und Breite eines Risses. Bei der PAVER-Methode für Asphaltflugplätze hängt der Schweregrad eines Längs- oder Querrisses auch vom Abplatzen und vom Zustand der Rissfüllung ab. Ein nicht gefüllter Riss mit einer mittleren Breite über 6 mm ist mindestens mittelschwer. Ein schmaler Riss ist hochschwer, wenn er stark abgeplatzt ist.
- Welche Datensätze werden zum Trainieren von Risssegmentierungsmodellen verwendet?
- Gängige öffentliche Datensätze sind DeepCrack (537 Bilder von Asphalt und Beton), CrackForest (118 annotierte Straßenbilder aus Peking) und CRACK500 (500 Fahrbahnbilder, mit Mobiltelefonen aufgenommen). CrackSeg9k kombiniert mehrere bestehende Datensätze. Dabei handelt es sich überwiegend um Straßen- und Campusbilder, nicht um Pisten.
Referenzen
- unet
- U-Net: Convolutional Networks for Biomedical Image Segmentation Ronneberger, Fischer and Brox, arXiv 1505.04597
- deepcrack
- DeepCrack: Learning Hierarchical Convolutional Features for Crack Detection (Neurocomputing, 2019) Liu et al., via secondary summaries (hyper.ai, cris.fbk.eu)
- crackseg9k
- CrackSeg9k: A Collection and Benchmark for Crack Segmentation Datasets and Frameworks arXiv 2208.13054
- cfd-crack500
- CrackForest and CRACK500 dataset descriptions (survey summaries found by web search) arXiv 2507.06513 and other surveys
- paver-asphalt
- PAVER Distress Identification Manual for Asphalt Surfaced Airfields (June 2009) US Army ERDC-CERL
- easa-ear-adr
- Easy Access Rules for Aerodromes (Regulation (EU) No 139/2014) EASA
- faa-ac-150-5370-10h
- AC 150/5370-10H, Standard Specifications for Construction of Airports FAA
- faa-ac-150-5320-6g
- AC 150/5320-6G, Airport Pavement Design and Evaluation FAA
Dies ist ein Referenzeintrag. TarmacView bietet Drohneninspektionsdienste an und verkauft nicht die in diesem Glossar beschriebene Ausrüstung oder Materialien.