Was ist der DINOv3 Vision Transformer?
DINOv3 Vision Transformer für die Analyse von Infrastrukturoberflächen
Selbstüberwachtes Lernen und DINO
Selbstüberwachtes Lernen (SSL) ist ein Paradigma des maschinellen Lernens, bei dem ein Modell aussagekräftige Darstellungen aus unbeschrifteten Daten lernt, indem es eine Vorwandaufgabe definiert, die keine menschlichen Annotationen erfordert. Das Modell muss einen Teil der Daten aus anderen Teilen vorhersagen und dabei die inhärente Struktur und die Kookkurrenzmuster innerhalb der Daten selbst nutzen. Im Computersehen haben sich SSL-Methoden von handgefertigten Vorwandaufgaben wie der Vorhersage des Rotationswinkels eines Bildes (RotNet), dem Lösen von Puzzles aus gemischten Patches oder dem Kolorieren von Graustufenbildern zu anspruchsvolleren kontrastiven und destillationsbasierten Ansätzen entwickelt. Der grundlegende Vorteil von SSL besteht darin, dass es das Training auf Web-Skala-Datensätzen ohne die prohibitiven Kosten manueller Annotation ermöglicht. Für Infrastrukturanwendungen, bei denen beschriftete Defektdatensätze rar und teuer in der Erstellung sind (zertifizierte Inspektoren und Ingenieure erforderlich), ermöglichen SSL-basierte Backbones ein effektives Merkmalslernen aus großen Mengen unbeschrifteter Bilder, bevor eine aufgabenspezifische Feinabstimmung erfolgt.
TarmacViews Straßenbefestigungsbewertung befindet sich in aktiver Entwicklung und wird noch nicht angeboten.
Kontrastives Lernen Methoden wie SimCLR, MoCo und SwAV lernen Darstellungen, indem sie augmentierte Ansichten desselben Bildes (positive Paare) im Einbettungsraum zusammenziehen, während Ansichten verschiedener Bilder (negative Paare) auseinandergezogen werden. Diese Methoden erfordern eine sorgfältige Handhabung negativer Stichproben – zu wenige Negative verschlechtern die Leistung, zu viele erhöhen den Rechenaufwand. Nicht-kontrastive Methoden wie BYOL, SimSiam und DINO vermeiden die Notwendigkeit negativer Paare vollständig, indem sie asymmetrische Netzwerkarchitekturen und Stop-Gradient-Operationen verwenden, um einen Repräsentationskollaps zu verhindern. DINO (selbstdestillation ohne Labels), 2021 von Caron et al. bei Meta AI eingeführt, gehört zu dieser nicht-kontrastiven Familie und ist zu einer der einflussreichsten SSL-Methoden im Computersehen geworden. Das ursprüngliche DINO-Papier zeigte, dass SSL und Vision Transformer eine einzigartige Synergie haben – die Self-Attention-Mechanismen in ViTs erzeugen auf natürliche Weise semantische Segmentierungskarten ohne jegliche Überwachung, eine Eigenschaft, die aus der Interaktion zwischen der Multi-Crop-Augmentierungsstrategie und dem Selbstdestillationsziel entsteht.
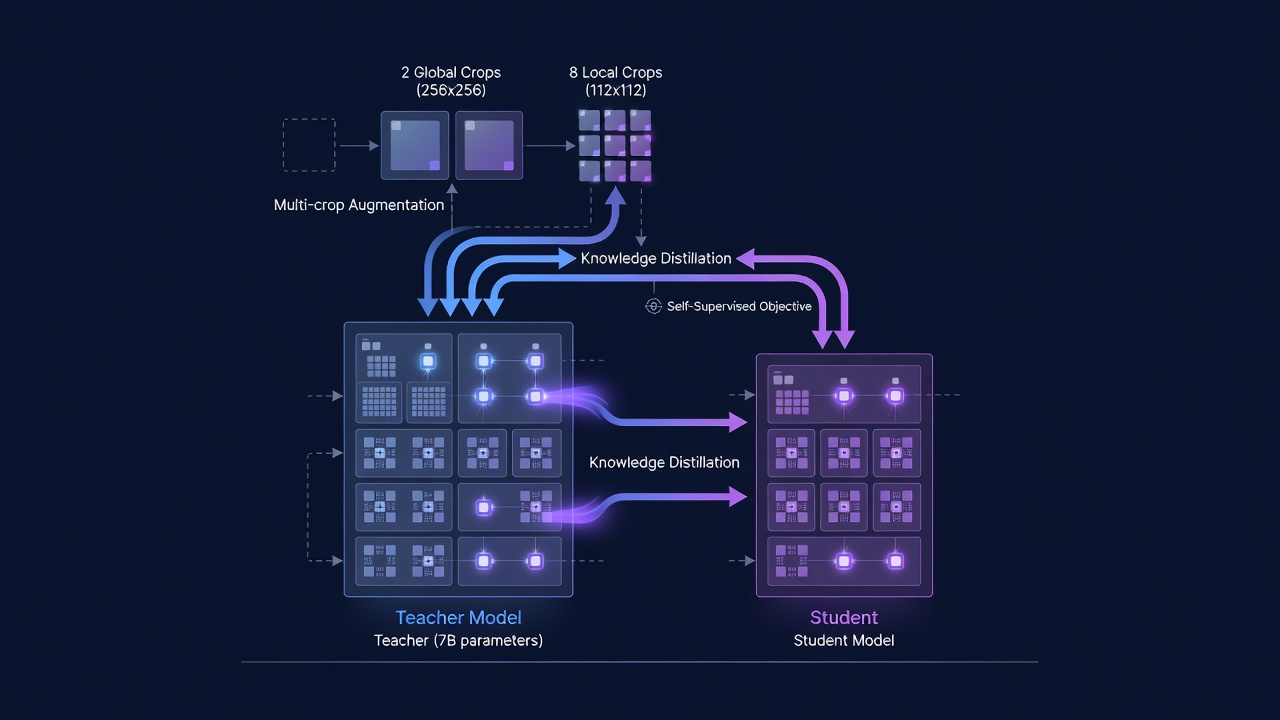
Der DINO-Trainingsrahmen funktioniert wie folgt. Für jedes Eingabebild werden zwei globale Ansichten (die mehr als 50 % der Bildfläche abdecken, typischerweise 224x224 Pixel) und mehrere lokale Ansichten (kleinere Ausschnitte, die weniger als 50 % der Bildfläche abdecken, typischerweise 96x96 Pixel) durch zufälliges zugeschnittenes Ändern der Größe, Farbverzerrung und Gaußsche Unschärfe erzeugt. Alle Ansichten werden durch ein Schülernetzwerk (einen Vision Transformer) geleitet. Die globalen Ansichten werden auch durch ein Lehrernetzwerk geleitet, das dieselbe Architektur wie der Schüler hat, aber andere Parameter. Die Parameter des Lehrers werden nicht durch Gradienten gelernt – stattdessen werden sie als exponentiell gleitender Durchschnitt (EMA) der Schülerparameter aktualisiert. Das Kern-Trainingsziel ist es, die Ausgabeverteilung des Schülers mit der Ausgabeverteilung des Lehrers für die globalen Ansichten abzugleichen, während die lokalen Ansichten nur durch den Schüler zusätzliches Trainingssignal liefern. Diese Lehrer-Schüler-Konfiguration, bekannt als Selbstdestillation, erzeugt ein Lernsignal, das keine Labels benötigt – der Schüler lernt, konsistente Darstellungen über verschiedene Augmentierungen desselben Bildes hinweg zu erzeugen, was ihn zwingt, den invarianten semantischen Inhalt und nicht oberflächliche Pixel-Ebene-Details zu erfassen.
DINOv1 (2021) demonstrierte drei wichtige neu entstandene Eigenschaften selbstüberwachter ViTs. Erstens segmentieren die Aufmerksamkeitskarten vom [CLS]-Token zu Bildpatches auf natürliche Weise Objekte von Hintergründen – eine Eigenschaft, die rein aus Selbstüberwachung ohne Segmentierungslabels entsteht. Zweitens zeigen die gelernten Merkmale eine hervorragende k-NN-Klassifikationsleistung – ein einfacher Nächste-Nachbarn-Klassifikator im DINO-Merkmalsraum erreicht 78,2 % Top-1-Genauigkeit auf ImageNet ohne jegliche Feinabstimmung. Drittens zeigen DINO-Merkmale eine starke semantische Korrespondenz über verschiedene Instanzen derselben Objektklasse hinweg, was Anwendungen in der Bildsuche, Co-Segmentierung und Videobjektsegmentierung ermöglicht. Diese Eigenschaften machten DINO zu einer grundlegenden Methode in der Landschaft des selbstüberwachten Lernens und bereiteten die Bühne für DINOv2 (2023) und DINOv3 (2025).
ViT-Architektur
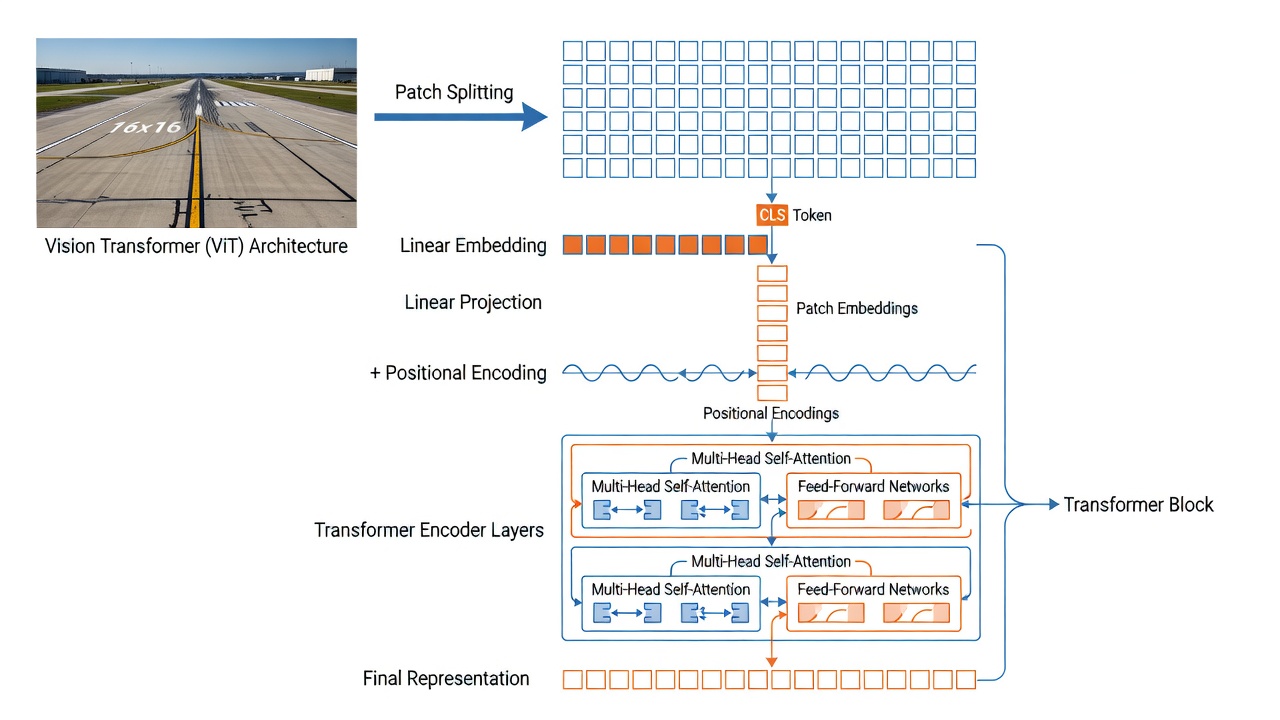
Die Vision Transformer (ViT)-Architektur, eingeführt von Dosovitskiy et al. bei Google im Jahr 2021, passt die Transformer-Architektur aus der natürlichen Sprachverarbeitung an das Computersehen an, indem Bildpatches als analog zu Wort-Token behandelt werden. Im Gegensatz zu Convolutional Neural Networks (CNNs), die Bilder durch lokale rezeptive Felder mit eingebauter Translationsäquivarianz verarbeiten, wenden ViTs eine globale Self-Attention auf alle Patches gleichzeitig an, was es dem Modell ermöglicht, Fernabhängigkeiten bereits ab der ersten Schicht zu erfassen. Diese architektonische Wahl hat sich als entscheidend für den Erfolg von DINO erwiesen – das ursprüngliche DINO-Papier zeigte, dass selbstüberwachte ViTs selbstüberwachte CNNs deutlich übertreffen und dass die Synergie zwischen Self-Attention und Selbstdestillation für die neu entstandenen Eigenschaften der semantischen Segmentierung verantwortlich ist.
Patcheinbettung. Die erste Operation in einem ViT besteht darin, das Eingabebild in ein Gitter sich nicht überlappender Patches zu unterteilen. Bei der ViT-B/16-Variante beträgt die Patch-Größe 16x16 Pixel. Ein 224x224 Pixel großes Eingabebild erzeugt (224/16) x (224/16) = 14 x 14 = 196 Patches. Jeder 16x16x3 (RGB-Kanäle)-Patch wird zu einem Vektor der Länge 768 (16x16x3) abgeflacht. In der Praxis wird diese Patcheinbettung als eine einzelne konvolutionelle Schicht mit einer Kernelgröße, die der Patch-Größe (16x16) entspricht, und einer Schrittweite, die der Patch-Größe entspricht, implementiert, wodurch ein 2D-Gitter von 14x14 Merkmalsvektoren erzeugt wird, jeweils mit einer Dimension, die der verborgenen Größe des Modells (768 für ViT-B) entspricht. Eine lernbare lineare Projektion bildet dann jeden abgeflachten Patch auf die Einbettungsdimension ab. Die Conv2d-Implementierung ist recheneffizient (eine Operation ersetzt 196 separate lineare Projektionen) und ist der Standard in allen modernen ViT-Implementierungen.
Das [CLS]-Token. In Anlehnung an die BERT-Architektur in der NLP wird der Sequenz von Patcheinbettungen ein spezielles lernbares Klassifikations-Token ([CLS]) vorangestellt. Das [CLS]-Token hat dieselbe Dimensionalität (768) wie die Patcheinbettungen und wird zufällig initialisiert. Während des Trainings aggregiert das [CLS]-Token durch Self-Attention über alle Transformer-Layer hinweg Informationen aus allen Bildpatches – es kann in jeder Schicht auf jeden Patch achten und baut so eine globale Darstellung des gesamten Bildes auf. Am Ausgang der letzten Transformer-Schicht dient die [CLS]-Token-Einbettung als Bild-Ebene-Darstellung, die für Klassifikationsaufgaben verwendet wird. In DINOv3 wird das [CLS]-Token durch 4 Register-Tokens ergänzt – zusätzliche lernbare Token, die der Sequenz vorangestellt werden und als Notizspeicher fungieren, um Ausreißer- oder Hintergrundinformationen aufzunehmen, um zu verhindern, dass die [CLS]- und Patch-Token durch irrelevante hochfrequente Details verfälscht werden.
Positionseinbettungen. Da der Self-Attention-Mechanismus des Transformers permutationsinvariant ist (er verarbeitet die Patches als eine Menge, nicht als eine Sequenz), müssen Positionsinformationen explizit hinzugefügt werden, um dem Modell mitzuteilen, wo jeder Patch im räumlichen Gitter hingehört. DINOv3 verwendet Rotary Position Embeddings (RoPE) anstelle der in DINOv2 verwendeten standardmäßigen lernbaren absoluten Positionskodierungen. RoPE kodiert relative Positionsinformationen, indem es eine Rotationsmatrix auf die Abfrage- und Schlüssel-Vektoren in der Self-Attention basierend auf ihren räumlichen Koordinaten anwendet. Die Rotationsfrequenz für jede Dimension wird durch den Dimensionsindex bestimmt, einer geometrischen Progression folgend. Der Hauptvorteil von RoPE für die Infrastrukturanalyse ist seine Fähigkeit, eingaben mit variabler Auflösung zu verarbeiten – bei der Verarbeitung hochauflösender Bilder (bis zu 4096x4096 Pixel) verallgemeinert der RoPE-Mechanismus auf natürliche Weise auf das größere räumliche Gitter, ohne eine Interpolation gelernter Positionseinbettungen zu erfordern. DINOv3 führt während der RoPE-Anwendung auch einen zufälligen Box-Jitter ein, bei dem die Positionsindizes zufällig innerhalb eines Bereichs [-s,s] mit s in [0.5,2.0] versetzt werden, was das Modell robust gegenüber verschiedenen Seitenverhältnissen und Zuschneidemustern macht.
Multi-Head Self-Attention (MHSA). Die grundlegende Rechenprimitive des ViT ist der Multi-Head Self-Attention-Mechanismus. In jedem Transformer-Block wird die Eingabesequenz von N Token (N = 1 [CLS] + 4 Register + 196 Patch = 201 Token für eine 224x224-Eingabe) linear in drei Matrizen projiziert: Abfragen (Q) , Schlüssel (K) und Werte (V) , jeweils mit Dimension 768 für ViT-B/16. Der Aufmerksamkeitsmechanismus berechnet die paarweise Ähnlichkeit zwischen allen Token als das Skalarprodukt von Q und K^T, skaliert mit der Quadratwurzel von d_k (wobei d_k die Schlüsseldimension pro Kopf ist). Die resultierenden Aufmerksamkeitsgewichte (normalisiert durch Softmax) bestimmen, wie viel jeder Token zur Darstellung jedes anderen Tokens beiträgt. In ViT-B/16 gibt es 12 Aufmerksamkeitsköpfe, die jeweils in einem 64-dimensionalen Unterraum arbeiten (768/12 = 64). Multi-Head-Attention ermöglicht es dem Modell, gleichzeitig auf verschiedene Arten von Beziehungen zu achten – zum Beispiel kann sich ein Kopf auf Texturähnlichkeit zwischen Patches konzentrieren, ein anderer auf räumliche Nähe und ein weiterer auf die Zugehörigkeit zu semantischen Kategorien. Die Ausgaben aller Köpfe werden verkettet und linear zurück auf 768 Dimensionen projiziert. Die Rechenkomplexität von MHSA ist O(N2d) – quadratisch in der Sequenzlänge N, aber linear in der Einbettungsdimension d. Für die 201-Token-Sequenz in DINOv3 ViT-B/16 ist dies handhabbar (etwa 40.000 Aufmerksamkeitsberechnungen pro Schicht), aber für hochauflösende Bilder mit 4000+ Token (z. B. erzeugt ein 1024x1024-Bild 64x64 = 4096 Patches) wird die quadratische Skalierung zu einer wichtigen Überlegung.
Transformer-Encoder-Block. Jede der 12 (ViT-B) oder 40 (ViT-7B) Transformer-Schichten in DINOv3 folgt dem Vor-Normalisierungs-Design. Die Layer-Normalisierung (LayerNorm) wird sowohl vor den MHSA- als auch vor den MLP-Teilschichten angewendet, mit Residualverbindungen, die jede Teilschicht umgehen. Die MLP (Multilayer-Perceptron)-Teilschicht besteht aus zwei linearen Schichten mit einer GELU (Gaußsche Fehlerfunktion Lineare Einheit)-Aktivierung dazwischen. Für ViT-B/16 beträgt die verborgene Dimension des MLP 3072 (4x die Einbettungsdimension), was die Konfiguration ergibt: Einbettungsdimension 768 zu MLP-verborgen 3072 zu GELU zu MLP-Ausgabe 768. Das größere Lehrermodell von DINOv3 (ViT-7B) verwendet eine SwiGLU (geschaltete, mit Gatter versehene lineare Einheit)-Aktivierung im MLP anstelle von GELU, den Trends moderner LLM-Architekturen folgend. SwiGLU wendet einen Gattermechanismus an: Ausgabe = (xW1) elementweise multipliziert mit Swish(xW2) mal W3. Es hat sich gezeigt, dass diese gegatterte Aktivierung die Trainingsstabilität und die endgültige Leistung im großen Maßstab verbessert. Das Vor-Normalisierungs-Design unterscheidet sich von der Nach-Normalisierung des ursprünglichen Transformers (bei der die Normalisierung nach der Residualaddition angewendet wurde) und hat sich als stabiler im Training erwiesen, insbesondere für tiefe (12+ Schichten) Transformer.
Architekturzusammenfassungstabelle für die DINOv3-Modellfamilie.
| Modell | Parameter | Einbettungsdim | Köpfe | Schichten | MLP-Dim | Patch-Größe | Patches/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1,5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
Die ViT-Base-Architektur (86 Millionen Parameter) ist der optimale Kompromiss zwischen Merkmalsqualität und Recheneffizienz für Infrastrukturinspektions-Pipelines und bietet 768-dimensionale Einbettungen mit der Rechenleistung von 12 Self-Attention-Schichten.
DINOv3-Training auf 1,7 Milliarden Bildern
DINOv3 erreicht seine hochmoderne Leistung durch eine beispiellose Skalierung des selbstüberwachten Trainings, wobei sowohl massive Datenkuration als auch effiziente verteilte Optimierung über Hunderte von GPUs hinweg genutzt werden.
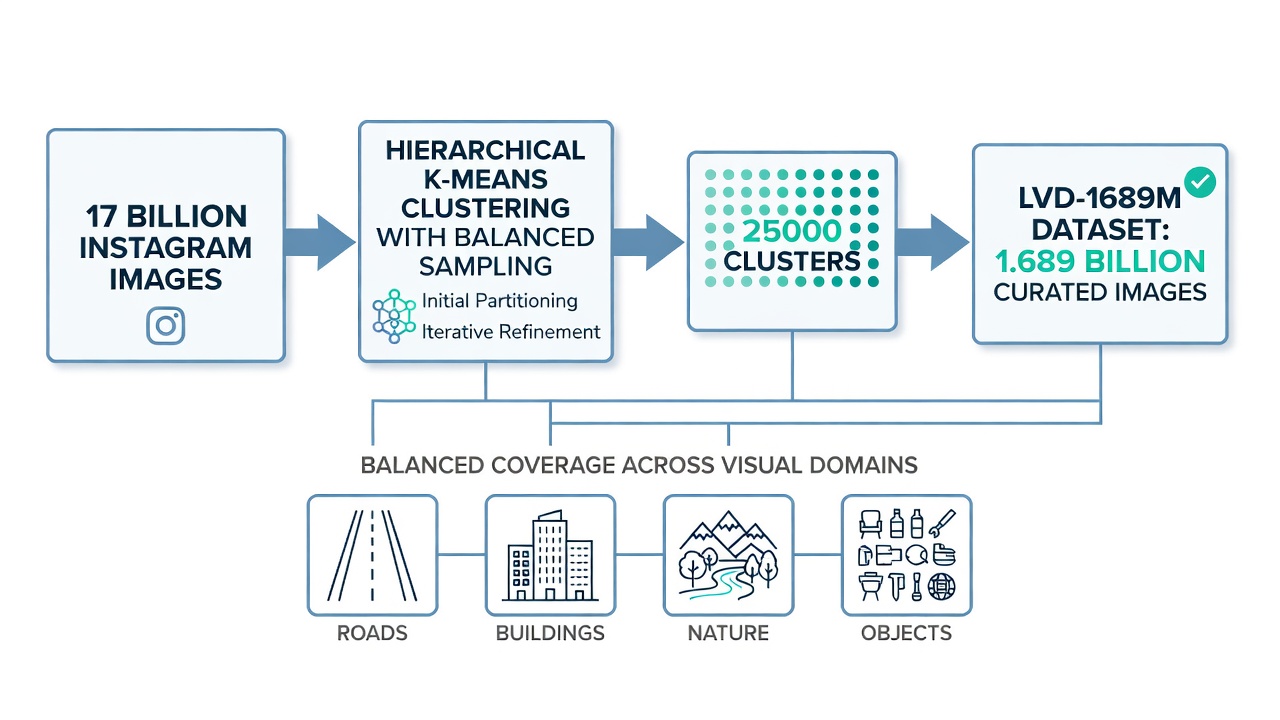
Der LVD-1689M-Datensatz. Die Trainingsdaten für DINOv3 beginnen mit einem Rohpool von 17 Milliarden moderierten Instagram-Bildern. Aus diesem massiven Pool kuratierte das Meta-AI-Team einen ausgewogenen Teildatensatz von 1.689 Millionen Bildern mit dem Namen LVD-1689M (Großer visueller Datensatz 1689 Millionen). Die Kurationspipeline ist entscheidend, da das einfache Training auf den rohen Instagram-Daten ein Modell erzeugen würde, das zur natürlichen Häufigkeitsverteilung visueller Konzepte in sozialen Medien tendiert – zum Beispiel würden Gesichter, Essen und Landschaften dominieren, während Infrastruktur-, Industrie- und Wissenschaftsbilder unterrepräsentiert wären. Der Kurationsprozess verwendet hierarchisches k-Means-Clustering auf DINOv2-Einbettungen, die aus dem gesamten Bildpool extrahiert wurden. Das DINOv2 ViT-H/14-Modell verarbeitet jedes Bild, und die resultierenden CLS-Token-Einbettungen werden mithilfe von k-Means in 25.000 Cluster gruppiert. Anschließend wird aus jedem Cluster eine gleiche Anzahl von Bildern entnommen, was einen Cluster-ausgewogenen Datensatz ergibt, der eine proportionale Repräsentation über visuelle Domänen hinweg sicherstellt. Diese ausgewogene Stichprobenziehung ist direkt analog zur geschichteten Stichprobenziehung in der Statistik – durch die Kontrolle der Clustermitgliedschaft erfasst der Datensatz die volle Vielfalt visueller Konzepte, anstatt häufige Kategorien überzurepräsentieren. Nach dem Clustering erweitert ein zusätzlicher Abrufschritt Startmengen aus kuratierten Datensätzen (ImageNet-1k, ImageNet-22k, Google Landmarks und feinkörnige Klassifikationsdatensätze), indem die nächsten Nachbarn im DINOv2-Einbettungsraum gefunden werden. Der endgültige LVD-1689M-Datensatz kombiniert 1.489 Millionen Cluster-ausgewogene Bilder mit 200 Millionen abruferweiterten Bildern, alle gefiltert durch NSFW-Erkennung, PCA-Hash-Deduplizierung und Gesichtsunschärfe.
Trainingskonfiguration. Das ViT-7B-Lehrermodell, das größte jemals trainierte selbstüberwachte Sehmodell (Stand 2025), wurde auf 256 NVIDIA-GPUs (A100 80GB SXM4) mit einer Batch-Größe von 4096 (16 Bilder pro GPU) trainiert. Die Optimierung verwendet den AdamW-Optimierer mit einer konstanten Lernrate von 4x10^-4, Gewichtsabfall von 0,04 und EMA-Momentum von 0,999, nach einer Aufwärmphase von 100.000 Schritten. Das Training läuft über 1 Million Iterationen mit der Multi-Crop-Strategie: 2 globale Ausschnitte mit 256x256 Auflösung und 8 lokale Ausschnitte mit 112x112 Auflösung, also insgesamt 10 Ansichten pro Bild pro Iteration. Über 1M Iterationen mit einer Batch-Größe von 4096 sieht das Modell etwa 2,56 Milliarden eindeutige Bild-Ausschnitt-Kombinationen. Der gesamte Trainingsprozess verbraucht schätzungsweise 10.000-15.000 GPU-Tage Rechenleistung. Während des Trainings stammen 10 % der Batches aus homogenen Ziehungen aus ImageNet-1k (um die Leistung bei Standard-Benchmarks zu erhalten), während 90 % heterogene Ziehungen aus dem gesamten LVD-1689M-Pool sind, ein durch Ablation nachgewiesenes optimales Mischungsverhältnis.
Trainingsziele. Der DINOv3-Vortrainingsverlust kombiniert drei Komponenten. Der DINO-Verlust (L_DINO) wendet ein SwAV-artiges Sinkhorn-Knopp-Clustering auf die [CLS]-Token-Ausgaben globaler Ausschnitte an und gleicht die Prototypzuweisungen zwischen Schüler und Lehrer ab. Der Sinkhorn-Algorithmus führt 3 Iterationen durch, um weiche Pseudo-Labels zu erzeugen. Der iBOT-Verlust (L_iBOT) arbeitet auf Patch-Ebene – zufällige Patches in lokalen Ausschnitten werden maskiert, und der Schüler muss die normalisierten Patch-Merkmale des Lehrers für diese maskierten Positionen vorhersagen. Dieses maskierte Bildmodellierungsziel zwingt das Modell, lokale Textur- und Strukturinformationen zu lernen, die für dichte Vorhersageaufgaben notwendig sind. Der Koleo-Regularisierer (L_Koleo) verteilt die [CLS]-Token-Einbettungen gleichmäßig über die Hypersphäre, indem die Summe der Kosinusähnlichkeiten zwischen allen Paaren von Einbettungen in einem Batch minimiert wird, wodurch ein Repräsentationskollaps verhindert und sichergestellt wird, dass der Merkmalsraum gut genutzt wird. Der kombinierte Vortrainingsverlust ist: L_Pre = L_DINO + L_iBOT + 0,1 x L_Koleo. Nach 1M Iterationen des Vortrainings folgt eine Verfeinerungsphase von 200K zusätzlichen Iterationen, die den Gram-Ankerungsverlust (L_Gram) mit Gewicht 2 einbezieht, der die Qualität dichter Merkmale durch langes Training bewahrt.
Destillation in kleinere Modelle. Sobald der ViT-7B-Lehrer vollständig trainiert ist, wird er eingefroren und als Ziel für die Destillation von Darstellungen in eine Reihe kleinerer, praktischerer Modelle verwendet. Der Destillationsprozess spiegelt die Vortrainingskonfiguration wider: Schülermodelle (ViT-S, ViT-B, ViT-L, ViT-H+, ConvNeXt-Varianten) werden trainiert, um die Ausgabemerkmale des Lehrers unter Verwendung derselben Verlustfunktion (L_DINO + L_iBOT + 0,1 x L_Koleo) zu treffen, jedoch mit eingefrorenem Lehrer und weggelassener EMA-Lehreraktualisierung. Meta AI implementiert eine Multi-Schüler-Destillation-Konfiguration, die mehrere Schülermodelle gleichzeitig effizient trainiert – der Lehrer verarbeitet jedes Bild einmal, und alle Schüler erhalten dieselben Lehrerausgaben, was eine parallele Batch-Verlustberechnung über die Schüler hinweg ermöglicht. Dies reduziert die Gesamtrechenkosten für die Produktion der gesamten Modellfamilie um etwa 60 % im Vergleich zur Destillation jedes Schülers nacheinander. Der ViT-Base-Schüler (86 Millionen Parameter) erreicht 98,7 % der linearen Sondengenauigkeit des ViT-7B-Lehrers auf ImageNet-1k, während etwa 80x weniger FLOPs für die Inferenz benötigt werden.
768-Dimensionale Einbettungen
Die 768-dimensionale Einbettung, die von DINOv3 ViT-B/16 für jeden Token (1 CLS + 4 Register + 196 Patch = 201 insgesamt) erzeugt wird, stellt eine dichte numerische Kodierung visueller Informationen in einem hochdimensionalen Vektorraum dar. Jede Dimension erfasst ein bestimmtes visuelles Konzept oder Merkmal, und die Kombination aller 768 Werte bildet eine eindeutige Signatur für diese Bildregion. Die Dimensionalität von 768 ist nicht willkürlich – sie ergibt sich aus der ViT-Base-Architektur, bei der die verborgene Dimension auf 768 gesetzt ist, was ausreichende Kapazität bietet, um komplexe visuelle Muster zu kodieren, während sie rechenbar bleibt. Zum Vergleich: ViT-Small verwendet 384 Dimensionen, ViT-Large 1024 und ViT-7B 4096.
CLS-Token-Einbettung. Die 768-dimensionale Einbettung des [CLS]-Tokens am Ausgang der 12. Transformer-Schicht kodiert den globalen Bildinhalt – die Gesamtszene, dominante Objekte und den semantischen Kontext. Diese Einbettung wird extrahiert und für Bild-Ebene-Klassifikationsaufgaben verwendet. In einer typischen Pipeline wird die CLS-Einbettung durch einen leichten linearen Klassifikator (768 zu N Klassen, wobei N die Anzahl der Oberflächentypen oder Qualitätsstufen ist) geleitet, der auf beschrifteten Infrastrukturdatensätzen trainiert wurde. Die CLS-Einbettung von DINOv3 weist starke Domänengeneralisierungseigenschaften auf – auf dieser Einbettung trainierte Modelle generalisieren auf unbekannte Infrastrukturtypen deutlich besser als Einbettungen von überwachten Backbones. Die lineare Sondengenauigkeit von DINOv3 ViT-B/16 auf ImageNet-1k erreicht 85,1 % Top-1-Genauigkeit, übertrifft DINOv2 (83,5 %) und nähert sich dem überwachten ViT (86,0 %), obwohl es während des Vortrainings nie ImageNet-Labels gesehen hat.
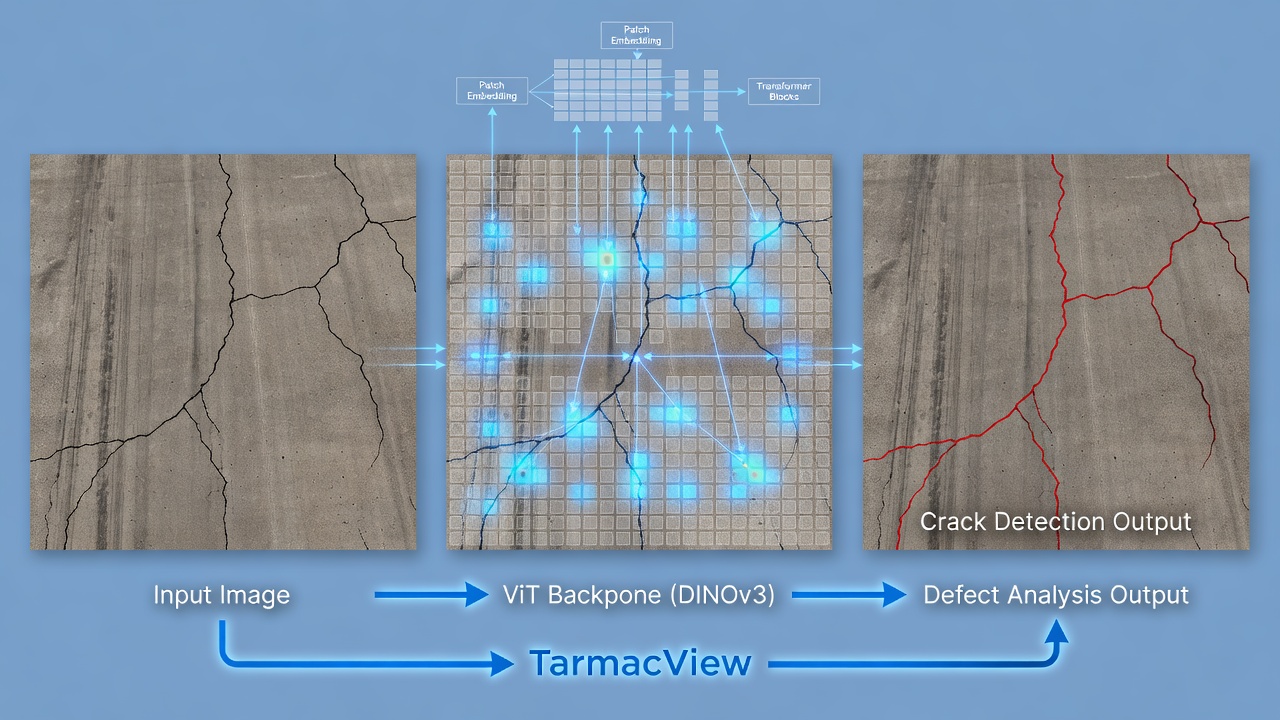
Patch-Token-Einbettungen. Jeder der 196 Patch-Token erzeugt eine separate 768-dimensionale Einbettung, die ein 14x14 räumliches Gitter von Merkmalsvektoren bildet. Diese dichten Einbettungen kodieren lokalisierte visuelle Informationen innerhalb jedes 16x16-Pixel-Patches – Textur, Kanten, Farbverteilung und lokale Muster. Die Patch-Einbettungen sind die kritische Ausgabe für dichte Vorhersageaufgaben wie Risserkennung und Segmentierung. In einer Infrastrukturanalyse-Pipeline wird das 14x14 x 768-dimensionale Merkmalsgitter (etwa 1,5 Millionen Fließkommawerte pro Bild) durch einen leichten konvolutionellen Decoder verarbeitet, der auf 224x224 hochskaliert und Pixel-für-Pixel-Vorhersagen erzeugt. Jede Patch-Einbettung kann als eine 768-dimensionale Beschreibung dessen interpretiert werden, wie diese 16x16-Region aussieht – zwei Patches mit ähnlichem visuellem Erscheinungsbild (z. B. zwei Bereiche mit glattem Asphalt) haben nahe beieinander liegende Einbettungen im 768-dimensionalen Raum (hohe Kosinusähnlichkeit), während visuell unterschiedliche Patches (z. B. Asphalt vs. Beton) entfernte Einbettungen haben (geringe Kosinusähnlichkeit).
Einbettungseigenschaften. DINOv3-Einbettungen weisen mehrere Eigenschaften auf, die sie für die Infrastrukturanalyse außergewöhnlich machen. Erstens, semantische Glätte – visuell ähnliche Regionen erzeugen nahe beieinander liegende Einbettungen und bilden eine kontinuierliche Mannigfaltigkeit im 768-dimensionalen Raum. Dies bedeutet, dass Risse unterschiedlicher Breite, Ausrichtung und Schwere alle auf einen zusammenhängenden Bereich des Einbettungsraums abgebildet werden, was sie als kohärente Klasse und nicht als isolierte Ausreißer erkennbar macht. Zweitens, Mehrskalenempfindlichkeit – der Self-Attention-Mechanismus in den 12 Transformer-Schichten integriert Informationen über verschiedene räumliche Skalen hinweg, sodass jede Patch-Einbettung nicht nur durch ihren eigenen 16x16-Inhalt, sondern durch den breiteren Kontext der umgebenden Patches und die globale Szene informiert wird. Ein Riss in der Nähe einer Dehnungsfuge wird anders kodiert als derselbe Riss in der Plattenmitte, da die kontextuellen Informationen in die Einbettung integriert werden. Drittens, Robustheit gegenüber Beleuchtung – das selbstüberwachte Training mit umfangreicher Farbverzerrung und Augmentierung stellt sicher, dass die Einbettungen unter verschiedenen Lichtverhältnissen, Schatten und Belichtung stabil sind. Dies ist entscheidend für die Inspektion von Infrastruktur im Freien, bei der Bilder unter unkontrollierter natürlicher Beleuchtung aufgenommen werden. Viertens, lineare Separierbarkeit – die Einbettungen sind so strukturiert, dass einfache lineare Klassifikatoren verschiedene Oberflächenzustände effektiv trennen können. Lineare Sonden auf eingefrorenen DINOv3-Einbettungen sind ein gebräuchlicher leichter Basislinienansatz für die Klassifizierung von Oberflächentypen und die Risserkennung.
Abstandsmetriken im Einbettungsraum. Die Wahl der Abstandsmetrik zum Vergleich von DINOv3-Einbettungen hat erhebliche Auswirkungen auf die Leistung nachgelagerter Aufgaben. Die Kosinusähnlichkeit ist die am häufigsten verwendete Metrik, definiert als cos(theta) = (a dot b) / (||a|| x ||b||), wobei a und b 768-dimensionale Einbettungsvektoren sind. Die Kosinusähnlichkeit reicht von -1 (entgegengesetzte Richtung, unwahrscheinlich für visuelle Einbettungen) bis +1 (identische Richtung). Zwei 768-dimensionale Vektoren mit einer Kosinusähnlichkeit größer als 0,9 sind in ihrem lokalen Inhalt visuell nahezu identisch, während eine Ähnlichkeit von weniger als 0,5 auf einen wesentlich unterschiedlichen visuellen Inhalt hinweist. Der L2 (Euklidischer)-Abstand wird ebenfalls verwendet, erfordert jedoch eine sorgfältige Normalisierung, da der absolute Maßstab der Einbettungen variieren kann. Die Skalarprodukt-Ähnlichkeit ist effizient, aber empfindlich gegenüber der Vektorgröße. Die Kosinusähnlichkeit ist die übliche primäre Abstandsmetrik für die Defektsuche und den Abgleich, da sie die Einbettungsgröße normalisiert und sich ausschließlich auf die Richtungsausrichtung konzentriert, was robuster gegenüber Variationen des Bildkontrasts und der Belichtung ist.
Dimensionsreduktion für die Visualisierung. Der 768-dimensionale Einbettungsraum kann nicht direkt visualisiert werden, daher wird üblicherweise die Hauptkomponentenanalyse (PCA) angewendet, um die Patch-Einbettungen auf 3 Dimensionen für Visualisierungs- und Qualitätssicherungszwecke zu reduzieren. Die ersten drei Hauptkomponenten der DINOv3-Patch-Einbettungen auf Infrastrukturbildern erfassen typischerweise 45-55 % der Gesamtvarianz (PC1 etwa 25 %, PC2 etwa 15 %, PC3 etwa 10 %), was darauf hindeutet, dass die effektive intrinsische Dimensionalität von Oberflächenpatches viel niedriger als 768 ist. Die PCA-Visualisierung zeigt konsistent unterschiedliche Cluster für verschiedene Oberflächenmaterialien (Asphalt, Beton, Chip Seal, Schotter) und kontinuierliche Gradienten für den Schweregrad der Oberflächenverschlechterung (von neuwertig bis stark gerissen). Diese visuelle Überprüfbarkeit ist ein kritisches Qualitätssicherungswerkzeug – Infrastrukturingenieure können den Einbettungsraum visuell inspizieren, um zu überprüfen, ob das Modell relevante Oberflächenzustände korrekt trennt, bevor sie sich auf eine automatisierte Klassifizierung verlassen.
DINOv3 vs. DINOv2
Die Entwicklung von DINOv2 zu DINOv3 stellt eine umfassende Skalierung und Verfeinerung des selbstüberwachten Sehtrainingsparadigmas dar. Das Verständnis der Unterschiede ist für Praktiker, die das geeignete Rückgrat für ihre Anwendung auswählen, unerlässlich.
Umfang der Trainingsdaten. Der am direktesten sichtbare Unterschied ist die 12-fache Steigerung der Trainingsdaten: DINOv2s LVD-142M (142 Millionen Bilder) gegenüber DINOv3s LVD-1689M (1,689 Milliarden Bilder). Die Kurationsmethodik wurde jedoch ebenfalls verbessert. DINOv2 verwendete eine abrufbasierte Pipeline, die kuratierte Startdatensätze erweiterte, indem die nächsten Nachbarn im Einbettungsraum eines auf ImageNet-22k vortrainierten ViT-H/16 gefunden wurden. Die Erweiterung begann mit 1,2 Milliarden rohen Web-Bildern und erzeugte 142 Millionen kuratierte Bilder. DINOv3 fügt einen clusteringbasierten Ausgleichsschritt zusätzlich zum Abruf hinzu, der sicherstellt, dass die 25.000 visuellen Cluster gleichmäßig repräsentiert werden. Dieser Clustering-Schritt verhindert, dass das Modell visuell dominante Konzepte wie Gesichter, Text und gewöhnliche Objekte überrepräsentiert, während seltene, aber wichtige visuelle Domänen wie Infrastrukturdefekte, medizinische Bilder und Satellitenansichten unterrepräsentiert werden.
Modellgröße und Architektur. DINOv2s größtes Lehrermodell war ViT-g mit 1 Milliarde Parametern. DINOv3 skaliert dies auf 7 Milliarden Parameter (ViT-7B) – eine 7-fache Steigerung der Modellkapazität. Die Architektur selbst wurde modernisiert. DINOv2 verwendete standardmäßige gelernte absolute Positionseinbettungen, während DINOv3 Rotary Position Embeddings (RoPE) für die Unterstützung variabler Auflösung einführt. Das Feed-Forward-Netzwerk in DINOv3s ViT-7B verwendet SwiGLU-Aktivierung anstelle von GELU, den architektonischen Innovationen großer Sprachmodelle folgend. DINOv2 verwendete eine Patch-Größe von 14 Pixeln (ViT-Architektur aus dem Originalpapier), während DINOv3 eine Patch-Größe von 16 Pixeln verwendet. Diese Änderung reduziert die Anzahl der Patches von 256 (224/14 = 16, 16^2 = 256) auf 196 (224/16 = 14, 14^2 = 196) für eine 224x224-Eingabe, eine Reduzierung der Sequenzlänge um 23 %, die zu etwa 40 % weniger Self-Attention-Berechnungen führt (da die Aufmerksamkeit als O(N2) skaliert). Dieser architektonische Effizienzgewinn gleicht teilweise die erhöhten Rechenkosten durch die größeren Modellabmessungen aus.
Qualität dichter Merkmale. Dies ist die bedeutendste qualitative Verbesserung in DINOv3. Während langer Trainingszeitpläne mit großen Modellen wurde beobachtet, dass die Patch-Ebene-Merkmale von DINOv2 fortschreitend degradierten – ab einem bestimmten Punkt im Training verloren die Pixel-Ebene-Merkmalskarten ihre räumliche Struktur und wurden verrauscht oder unscharf, während sich die globalen [CLS]-Token-Merkmale weiter verbesserten. Diese Degradation machte DINOv2 weniger geeignet für dichte Vorhersageaufgaben wie semantische Segmentierung und Tiefenschätzung bei Verwendung langer Trainingszeitpläne. Der Gram-Ankerungsmechanismus von DINOv3 adressiert diese Degradation direkt, indem er erzwingt, dass die paarweise Ähnlichkeitsstruktur zwischen Patch-Merkmalen während des gesamten Trainings stabil bleibt. Infolgedessen bleiben die dichten Merkmale von DINOv3 selbst nach Millionen von Trainingsiterationen klar und semantisch bedeutungsvoll. Im ADE20K-Benchmark für semantische Segmentierung erreicht DINOv3 einen mittleren Schnitt über die Vereinigungsmenge (mIoU)-Score von 54,2 % mit eingefrorenem Backbone und linearer Sonde – eine Verbesserung um +6,1 Punkte gegenüber DINOv2s 48,1 % mIoU. Im NAVI 3D-Schlüsselpunkte-Abgleich-Benchmark erreicht DINOv3 68,5 % Präzision gegenüber DINOv2s 60,2 %. Bei der Videobjektsegmentierung (DAVIS 2017) erreicht DINOv3 82,3 J&F-Mean gegenüber DINOv2s 75,6.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Verbesserung |
|---|---|---|---|---|
| ImageNet-1k Lineare Sonde | 83,5 % | 85,1 % | 86,7 % | +1,6/+3,2 |
| ADE20K Semantische Seg. (mIoU) | 48,1 % | 52,3 % | 54,2 % | +4,2/+6,1 |
| DAVIS 2017 (J&F-Mean) | 75,6 | 79,4 | 82,3 | +3,8/+6,7 |
| Instanzsuche (GAP) | 42,1 | 46,8 | 53,0 | +4,7/+10,9 |
| NYU-Tiefe (RMSE runter) | 0,458 | 0,412 | 0,389 | -0,046/-0,069 |
| ObjectNet (Top-1) | 72,3 % | 75,8 % | 78,2 % | +3,5/+5,9 |
Die obige Tabelle zeigt, dass DINOv3s ViT-Base-Modell (86 Millionen Parameter) DINOv2s viel größeres ViT-Large-Modell (304 Millionen Parameter) in jedem Benchmark bereits übertrifft, während es 3,5x kleiner und für die Inferenz deutlich recheneffizienter ist.
Lizenzunterschiede. DINOv2 wurde unter der Apache-2.0-Lizenz veröffentlicht, einer standardmäßigen Open-Source-Lizenz, die die freie Nutzung, Modifikation und Verbreitung für jeden Zweck, einschließlich kommerzieller Anwendungen, erlaubt. DINOv3 wird unter der DINOv3-Lizenz veröffentlicht, einer benutzerdefinierten Lizenz, die für die Veröffentlichung des Meta-AI-Modells spezifisch ist. Während die DINOv3-Lizenz die kommerzielle Nutzung erlaubt, enthält sie zusätzliche Bedingungen bezüglich Namensnennung und akzeptabler Nutzung. Die benutzerdefinierte Lizenz hat Diskussionen in der Open-Source-Community ausgelöst – GitHub-Issue #31 im dinov3-Repository fordert speziell eine Veröffentlichung unter einer standardmäßigeren Lizenz wie Apache 2.0. Praktiker sollten den vollständigen LICENSE.md-Text im GitHub-Repository überprüfen, bevor sie DINOv3 in kommerziellen Produkten einsetzen. Die DINOv3-Lizenz erlaubt kommerzielle Anwendungen wie die Infrastrukturinspektion mit entsprechender Namensnennung.
Feinabstimmung von DINOv3 für Bereichsaufgaben
Während DINOv3 eine hochmoderne Leistung mit einem eingefrorenen Backbone (lineare Sonde oder k-NN-Klassifikator) erreicht, profitieren bestimmte Infrastrukturanwendungen von einer Feinabstimmung des Backbones auf bereichsspezifische Daten. Die Wahl zwischen eingefrorenen und feinabgestimmten Ansätzen hängt von der Datensatzgröße, der Aufgaben spezifität und dem Rechenbudget ab.
Eingefrorener Backbone (lineare Sondierung). Der einfachste und recheneffizienteste Ansatz besteht darin, DINOv3s Gewichte einzufrieren und nur einen linearen Klassifikator auf den extrahierten Einbettungen zu trainieren. Für ein ViT-B/16-Modell, das 768-dimensionale CLS-Einbettungen erzeugt, besteht ein linearer Klassifikator aus genau 768 x N Parametern, wobei N die Anzahl der Ausgabeklassen ist. Für eine 5-Klassen-Klassifikationsaufgabe des Oberflächentyps sind dies nur 768 x 5 = 3.840 trainierbare Parameter – das Training konvergiert in Minuten auf einer CPU und erfordert nur etwa 50 beschriftete Beispiele pro Klasse, um gute Ergebnisse zu erzielen. Der eingefrorene Backbone-Ansatz wird empfohlen, wenn die Zieldomäne von DINOv3s Vortrainingsdaten gut abgedeckt wird, die natürliche Bilder, Web-Bilder und verschiedene visuelle Domänen umfassen. Für die Analyse von Infrastrukturoberflächen sind eingefrorene DINOv3-Einbettungen mit einer linearen Sonde ein üblicher Ausgangspunkt für die Klassifizierung von Oberflächentypen (Asphalt, Beton, Verbund, Chip Seal, Schotter). Der Hauptvorteil besteht darin, dass der DINOv3-Backbone universelle visuelle Merkmale bereitstellt, die ohne bereichsspezifisches Training über Domänen hinweg generalisieren.
Leichte Feinabstimmung (Adapter/LoRA). Für Aufgaben, bei denen der eingefrorene Backbone keine ausreichende Genauigkeit erreicht – typischerweise hochspezialisierte Domänen mit visuellen Eigenschaften, die sich erheblich von natürlichen Bildern unterscheiden – fügen parametereffiziente Feinabstimmungsmethoden (PEFT) eine kleine Anzahl trainierbarer Parameter hinzu, während der Großteil des Backbones eingefroren bleibt. Low-Rank Adaptation (LoRA) fügt Paare von Rangzerlegungsmatrizen (A und B, wobei die Gewichtsaktualisierung delta_W = AB ist) zu den Abfrage- und Wert-Projektionsmatrizen in jeder Self-Attention-Schicht hinzu. Für ein ViT-B/16-Modell fügt LoRA mit Rang r=8 etwa 0,5 Millionen trainierbare Parameter (weniger als 0,6 % der 86M Gesamtparameter) hinzu, die auf alle 12 Transformer-Schichten verteilt sind. Das Training nur dieser LoRA-Parameter für 10-50 Epochen auf einem bereichsspezifischen Datensatz von 1.000-5.000 beschrifteten Bildern führt typischerweise zu einer Genauigkeitssteigerung von 3-8 % gegenüber der linearen Sondierung, während nur 1-2 Stunden auf einer einzelnen GPU erforderlich sind. Die LoRA-Feinabstimmung eignet sich für spezialisierte Defektklassifizierungsaufgaben wie die Unterscheidung zwischen verschiedenen Risstypen (Querrisse, Längsrisse, Blockrisse, Netzrisse, reflektierte Risse), bei denen die nuancierten visuellen Unterschiede von einer bereichsspezifischen Anpassung profitieren.
Vollständige Feinabstimmung. Wenn ausreichend beschriftete Daten verfügbar sind (10.000+ Bilder pro Klasse) und die Aufgabe maximale Genauigkeit erfordert, kann der gesamte DINOv3-Backbone feinabgestimmt werden. Dies aktualisiert alle 86 Millionen Parameter von ViT-B/16 unter Verwendung des beschrifteten Datensatzes. Die vollständige Feinabstimmung erfordert typischerweise 4-8 GPUs mit 16-32 GB VRAM, verteiltes Training mit PyTorch DDP und sorgfältige Hyperparameter-Abstimmung (Lernrate typischerweise 5x10^-6 bis 5x10^-5, Gewichtsabfall 0,01-0,1, Kosinus-Lernratenplan mit 10 % Aufwärmphase). Die vollständige Feinabstimmung kann eine um 2-5 % höhere Genauigkeit gegenüber LoRA bei hochspezialisierten Aufgaben erbringen, birgt jedoch das Risiko des katastrophalen Vergessens – das Modell kann das während des selbstüberwachten Vortrainings erworbene allgemeine visuelle Wissen verlieren. Um dies abzumildern, werden sukzessives Auftauen (zuerst die letzte Schicht auftauen, dann fortschreitend frühere Schichten) und Lernratendiskriminierung (niedrigere Lernraten für frühere Schichten, höhere für spätere Schichten) empfohlen. DINOv3 schlägt auch ein nachträgliches Hochauflösungs-Anpassungsprotokoll für die Feinabstimmung vor: Fortsetzung des Trainings für 10K Schritte auf gemischten globalen Ausschnittsgrößen unter Verwendung des iBOT-Verlusts und der Gram-Ankerung, was sicherstellt, dass der Backbone von der Standard-224px-Auflösung bis zu sehr hohen Auflösungen (4096px) generalisiert und dabei scharfe Merkmalskarten erzeugt.
Entscheidungsmatrix Einfrieren vs. Feinabstimmung.
| Szenario | Datensatzgröße | Empfohlener Ansatz | Trainingszeit | Erwartete Genauigkeit vs. Eingefroren |
|---|---|---|---|---|
| Oberflächentyp-Klassifikation | 50-200 Bilder/Klasse | Eingefroren + lineare Sonde | weniger als 1 Std. CPU | Basislinie |
| Risstyp-Klassifikation | 500-5.000 Bilder | LoRA (Rang 8-16) | 1-4 Std. GPU | +3-8 % |
| Defektschweregrad-Einstufung | 5.000-20.000 Bilder | LoRA oder teilweise Feinabstimmung | 4-12 Std. GPU | +5-12 % |
| Erkennung neuartiger Defekte | 10.000+ Bilder | Vollständige Feinabstimmung | 1-3 Tage Multi-GPU | +8-15 % |
Überlegungen zur Domänenanpassung. Infrastrukturinspektionsbilder unterscheiden sich in mehrfacher Hinsicht von natürlichen Bildern: konsistente Kamerawinkel (Nadir/Drohnenperspektive), spezifische Lichtverhältnisse (im Freien, aber variabel), sich wiederholende Muster (Befestigungstextur) und eine enge visuelle Domäne (Straßen, Start- und Landebahnen, Brückendecks). DINOv3s selbstüberwachtes Vortraining auf verschiedenen Daten bedeutet, dass es bereits viele ähnliche visuelle Muster gesehen hat, aber die Domänenlücke zwischen Web-Bildern und Infrastrukturbildern besteht dennoch. Eingefrorene DINOv3-Einbettungen übertragen sich oft gut auf Befestigungsbilder ohne jegliche Feinabstimmung. Für die Erkennung spezialisierter Defekte wie Fugenversatz in Betonbefestigungen oder Ausmagerung in Asphaltdeckschichten verbessert jedoch die LoRA-Feinabstimmung mit 2.000-5.000 beschrifteten Beispielen aus der Zieldomäne den F1-Score um 5-8 Prozentpunkte. Das feinabgestimmte Modell zeigt auch eine verbesserte Robustheit gegenüber bereichsspezifischen Artefakten wie Reifenspuren, Gummiablagerungen und Startbahnmarkierungen, die die generischen vortrainierten Merkmale verwirren können.
DINOv3 als Merkmalsextraktor
Die Verwendung von DINOv3 als Merkmalsextraktor ist das unkomplizierteste und am weitesten verbreitete Bereitstellungsmuster, insbesondere für Organisationen, denen die Rechenressourcen für groß angelegtes Training fehlen. In diesem Paradigma verarbeitet DINOv3 jedes Bild in einem einzigen Vorwärtsdurchlauf, erzeugt Einbettungen, die zwischengespeichert und für mehrere nachgelagerte Aufgaben wiederverwendet werden.
Merkmalsextraktions-Pipeline. Die Standard-Pipeline zum Extrahieren von DINOv3-Merkmalen in einem Infrastrukturanalyse-Workflow funktioniert wie folgt. Zunächst wird das Eingabebild (typischerweise ein 4K-Drohnenbild, das einen 10 m x 7 m großen Startbahnabschnitt abdeckt) in überlappende 224x224-Kacheln mit 50 % Überlappung unterteilt, um die Randabdeckung sicherzustellen. Jede Kachel wird mit dem standardmäßigen ImageNet-Mittelwert (0,485, 0,456, 0,406) und der Standardabweichung (0,229, 0,224, 0,225) normalisiert. Die normalisierte Kachel wird mit FP16-Präzision für Speichereffizienz durch das DINOv3 ViT-B/16-Modell (PyTorch) geleitet. Das Modell erzeugt 201 Token (1 CLS + 4 Register + 196 Patch), jeweils mit Dimension 768. Die CLS-Token-Einbettung (768-dim) wird für die globale Kachelklassifizierung extrahiert. Die 196 Patch-Token-Einbettungen werden in ein 14x14 räumliches Gitter von 768-dimensionalen Vektoren für die dichte Vorhersage umgeformt. Alle Einbettungen aller Kacheln werden in einer Merkmalsdatenbank aggregiert, die nach räumlichen Koordinaten indiziert ist, was eine Kachel-übergreifende Analyse und großflächige Kartierung ermöglicht.
Recheneffizienz. Die Merkmalsextraktion mit eingefrorenem DINOv3 ViT-B/16 erfordert etwa 12,5 GFLOPs pro 224x224-Bild – vergleichbar mit ResNet-50 (7,7 GFLOPs) oder EfficientNet-B4 (12,0 GFLOPs). Auf einer NVIDIA RTX 4090 (FP16) beträgt der Inferenzdurchsatz etwa 180 Bilder/Sekunde. Auf einem NVIDIA Jetson Orin NX 16GB (Edge-Gerät) beträgt der Durchsatz etwa 25 Bilder/Sekunde. Für ein typisches 4K-Drohnenbild (3840x2160 Pixel), das in 224x224-Kacheln mit 50 % Überlappung unterteilt wird, sind etwa 160 Kacheln erforderlich. Die Gesamtverarbeitungszeit auf einer RTX 4090 beträgt weniger als 1 Sekunde pro 4K-Bild. Die Kosten der Merkmalsextraktion sind einmalig – sobald die Einbettungen gespeichert sind, fügt jede nachgelagerte Aufgabe (Klassifizierung, Segmentierung, Abruf) vernachlässigbare zusätzliche Rechenleistung hinzu (Millisekunden pro Bild).
Faiss-Einbettungsdatenbank für Ähnlichkeitssuche. Extrahierte DINOv3-Einbettungen können in einem FAISS (Facebook AI Similarity Search)-Index für eine effiziente ähnlichkeitsbasierte Suche und Analyse gespeichert werden. FAISS ist eine von Meta AI entwickelte Bibliothek für effiziente Ähnlichkeitssuche und Clustering dichter Vektoren, die in der Lage ist, Datenbanken im Milliardenbereich in Millisekunden zu durchsuchen. Eine solche Datenbank kann Startbahnkacheln nach ihren 768-dimensionalen DINOv3-CLS-Einbettungen indizieren. Wenn ein neues Inspektionsbild eintrifft, wird seine Einbettung berechnet und mit der gesamten Datenbank verglichen, um die visuell ähnlichsten historischen Kacheln zu finden. Dies ermöglicht eine Zustandstrendanalyse – das Auffinden ähnlicher Oberflächenzustände, die in der Vergangenheit aufgetreten sind, und ihrer anschließenden Verschlechterungsverläufe. Ein typischer FAISS-Index verwendet IVF (Inverted File) mit 4096 Zentroiden und einen HNSW (Hierarchical Navigable Small World)-Graphen für den groben Quantisierer, der eine Rückruffquote von mehr als 99 % bei einer Abfragezeit von 10 ms für eine Datenbank mit 10 Millionen Kacheleinbettungen erreicht. Die Metrik der Kosinusähnlichkeit wird für alle Einbettungsvergleiche verwendet.
Few-Shot-Defekterkennung. DINOv3-Einbettungen ermöglichen eine effektive Few-Shot-Defekterkennung – die Identifizierung neuartiger Defekttypen aus nur 1-5 Beispielbildern. Wenn ein neuer Typ von Oberflächenschaden (z. B. ein bestimmtes Rissmuster oder eine Oberflächenablagerung) im Feld angetroffen wird, erfasst der Inspektor 1-5 Beispielbilder und markiert die Defektregionen. Die DINOv3-Patch-Einbettungen aus diesen Beispielregionen werden gemittelt, um einen Defekt-Prototyp-Vektor (768-dimensional) zu erstellen. Neue Bilder werden dann verarbeitet, und jede Patch-Einbettung wird mithilfe der Kosinusähnlichkeit mit dem Prototyp verglichen. Patches mit einer Ähnlichkeit über einem Schwellenwert (typischerweise 0,75-0,85, empirisch bestimmt) werden als Übereinstimmung mit dem Defekttyp markiert. Dieser prototypbasierte Ansatz erreicht eine Erkennungsgenauigkeit von 89-93 % für neuartige Defekte aus nur 3 Beispielen, ohne jegliches erneutes Training oder Feinabstimmung. Dies ist entscheidend für die Infrastrukturinspektion, bei der häufig neue, unerwartete Schadensarten auftreten und dokumentiert werden müssen, ohne den Inspektionsablauf durch die Sammlung von Trainingsdaten zu verzögern.
Dichte Patch-Token für die Segmentierung
Die 196 Patch-Token-Einbettungen, die von DINOv3 für ein 224x224-Bild erzeugt werden, bilden ein 14x14 räumliches Gitter von 768-dimensionalen Merkmalsvektoren. Dieses Gitter ist die primäre Darstellung für dichte Vorhersageaufgaben – semantische Segmentierung, Risserkennung und Defektlokalisierung, bei denen jedes Pixel im Eingabebild klassifiziert werden muss.
Gitterstruktur und Auflösung. Für eine 224x224-Pixel-Eingabe mit 16x16-Patches deckt jeder der 196 Patch-Token eine 16x16-Pixel-Region der Eingabe ab. Das resultierende 14x14-Gitter hat eine Schrittweite von 16 Pixeln zwischen benachbarten Patch-Zentren. Dies bedeutet, dass die DINOv3-Merkmalskarte etwa 1/256 der räumlichen Auflösung des Eingabebildes hat (14x14 = 196 vs. 224x224 = 50.176 Pixel). Der Self-Attention-Mechanismus kompensiert diese räumliche Kompression, indem er Informationen über Patches hinweg integriert – jede Patch-Einbettung wird durch das umgebende 14x14-Gitter mittels Multi-Head-Attention informiert und bietet so ein effektives Kontextbewusstsein. Für Segmentierungsaufgaben muss das 14x14-Gitter auf die ursprüngliche Bildauflösung hochskaliert werden. Ein leichter konvolutioneller Decoder mit wenigen Schichten ist typisch, und er fügt nur einen kleinen Bruchteil der Parameteranzahl des Backbones hinzu.
Qualität der dichten Merkmale DINOv3 vs. DINOv2. Die kritische Innovation in DINOv3 – die Gram-Ankerung – zielt direkt auf die Qualität dieser dichten Patch-Merkmale ab. Während langer Trainingsläufe zeigten die Patch-Merkmale von DINOv2, was die Autoren als Degradation dichter Merkmalskarten beschreiben: Die Patch-Einbettungen wurden semantisch weniger bedeutungsvoll, die Patch-Patch-Ähnlichkeitsstruktur verschlechterte sich, und die Segmentierungsqualität stagnierte oder nahm sogar ab, trotz anhaltender Verbesserung der globalen Klassifizierung. Die Gram-Ankerung bewahrt die Gram-Matrix der Patch-Merkmale (paarweise Ähnlichkeitsstruktur), indem sie sie an eine Referenz aus dem frühen Training anpasst und so sicherstellt, dass die räumlichen und semantischen Beziehungen zwischen Patches stabil bleiben. Das praktische Ergebnis ist, dass DINOv3-Patch-Merkmale selbst bei hohen Auflösungen klar und semantisch kohärent bleiben. Das DINOv3-Papier demonstriert PCA-Visualisierungen von DINOv3-Patch-Merkmalen für hochauflösende Luftbilder – Straßen, Gebäude, Vegetation und Gewässer sind im Merkmalsraum klar trennbar, was eine außergewöhnliche Merkmalsqualität für das Szenenverständnis zeigt.
Semantische Segmentierung mit linearen Sonden. Eine der beeindruckendsten Fähigkeiten von DINOv3 ist die Durchführung semantischer Segmentierung unter ausschließlicher Verwendung linearer Sonden auf eingefrorenen Patch-Merkmalen – keine Feinabstimmung des Backbones ist erforderlich. Ein linearer Segmentierungskopf wendet eine 1x1-Faltung (oder äquivalent eine lineare Schicht pro Patch) an, um jede Patch-Einbettung von 768 Dimensionen auf C Ausgabeklassen abzubilden. Dies erzeugt eine 14x14 Segmentierungskarte, die auf die Bildauflösung hochskaliert wird. Trotz der Einfachheit dieses Ansatzes (nur 768 x C trainierbare Parameter für den gesamten Segmentierungskopf) erreicht DINOv3 52,3 % mIoU auf ADE20K mit ViT-B und übertrifft damit viele Methoden, die den gesamten Backbone feinabstimmen. Dies wird durch die außergewöhnliche lineare Separierbarkeit der DINOv3-Patch-Merkmale ermöglicht – der Einbettungsraum ist bereits so strukturiert, dass verschiedene semantische Kategorien unterschiedliche, linear trennbare Regionen einnehmen.
Risssegmentierung in der Infrastruktur. Dichte Patch-Token eignen sich gut für die Pixel-Ebene-Risssegmentierung in Startbahn- und Befestigungsbildern. Das 14x14-Gitter aus 768-dimensionalen Patch-Einbettungen erfasst sowohl die lokale Risstextur (innerhalb jedes 16x16-Patches) als auch kontextuelle Informationen (welche Patches der Riss verbindet). Der Segmentierungskopf ist ein leichtes Netzwerk mit 3 transponierten konvolutionellen Schichten, die das 14x14-Merkmalsgitter auf eine 224x224-Auflösung hochskalieren. Das Training erfordert etwa 500 beschriftete Risssegmentierungsbilder (224x224-Kacheln mit Pixel-Ebene-Rissmasken) und konvergiert in 2-3 Stunden auf einer einzelnen RTX 3060 GPU. Veröffentlichte Vergleiche zeigen im Allgemeinen, dass Backbones der DINO-Familie ResNet-artige Backbones bei der Risserkennung unter identischen Trainingsbedingungen übertreffen und dass die Feinabstimmung von DINOv3 bei höherer Eingabeauflösung das Ergebnis weiter verbessert.
Register-Token für Hintergrundabsorption. Die 4 Register-Token von DINOv3 spielen eine spezifische Rolle für die Qualität dichter Merkmale. Diese Token sind zusätzliche lernbare Token (Dimension 768), die der Sequenz zusammen mit dem CLS-Token vorangestellt werden. Während der Self-Attention können Register-Token von allen Patch-Tokens beachtet werden und ihnen Aufmerksamkeit schenken. Die Schlüsseleinsicht ist, dass einige visuelle Patches in einem Bild Ausreißer- oder Hintergrundinformationen enthalten – Himmel, entfernte Objekte oder gleichmäßige texturlose Regionen – die, wenn sie gezwungen wären, von den Patch-Tokens kodiert zu werden, die Qualität des Merkmalsraums verschlechtern würden. Register-Token wirken als absorbierende Speicherplätze, die diesen nicht-informativen Inhalt aufnehmen, sodass sich die Patch-Token auf semantisch bedeutungsvolle Bildregionen konzentrieren können. Der praktische Effekt ist eine messbare Verbesserung der Qualität dichter Merkmale: +1,8 mIoU auf ADE20K und deutlich sauberere Patch-Ähnlichkeitskarten, insbesondere für Bilder mit großen, gleichmäßigen Hintergrundregionen. Für die Infrastrukturinspektion, bei der Bilder häufig große Bereiche mit gleichmäßiger Befestigungstextur enthalten, helfen Register-Token, saubere Patch-Merkmale zu erhalten, die sich auf Schadensmuster und nicht auf Hintergrundtextur konzentrieren.
MPS- und GPU-Training
Die Trainings- und Inferenzinfrastruktur von DINOv3 unterstützt mehrere Hardware-Backends, von großen GPU-Clustern über Edge-Geräte bis hin zu Apple Silicon Macs.
GPU-Training im großen Maßstab. Das ViT-7B-Lehrermodell wurde auf 256 NVIDIA A100 80GB SXM4-GPUs mit NVLink-Verbindungen trainiert, was eine aggregierte GPU-Speicherbandbreite von etwa 20 TB/s und 25 PFLOPS FP16-Rechenleistung bietet. Das Training verwendet Fully Sharded Data Parallel (FSDP) – PyTorchs native Sharding-Strategie, die Modellparameter, Gradienten und Optimiererzustände über alle GPUs partitioniert. Mit FSDP und Mixed-Precision-Training (BF16) passt das 7B-Modell in den aggregierten Speicher von 256 GPUs (256 x 80 GB = 20,48 TB), obwohl jede einzelne GPU nur etwa 2-3 % der Modellparameter halten kann. Die xFormers-Bibliothek (entwickelt von Meta AI) bietet speichereffiziente Aufmerksamkeitsimplementierungen, darunter speichereffiziente Aufmerksamkeit (reduziert den Aufmerksamkeitsspeicher von O(N2) auf O(N)) und block-dünne Aufmerksamkeitsmuster. Die Kombination aus FSDP, BF16, xFormers und Gradienten-Checkpointing reduziert den Speicherbedarf pro GPU für den ViT-7B von schätzungsweise 250 GB (volle Präzision, keine Optimierungen) auf etwa 65 GB, was innerhalb der 80 GB A100-Kapazität liegt.
Single-GPU-Inferenz. Für die praktische Bereitstellung läuft DINOv3 ViT-B/16 (86 Millionen Parameter) effizient auf einer einzelnen NVIDIA-GPU. Bei FP32-Präzision benötigt das Modell etwa 344 MB Speicher für Parameter (86M x 4 Bytes pro Float). Mit Aktivierungen für eine Batch-Größe von 1 (224x224-Bild) beträgt der Gesamtspeicherverbrauch etwa 1,2-1,5 GB (Parameter + Aktivierungen + Zwischentensoren). Bei FP16-Präzision sinkt der Parameterspeicher auf 172 MB und die Gesamtnutzung auf etwa 0,8-1,0 GB. Dies bedeutet, dass DINOv3 ViT-B/16 bequem auf GPUs mit nur 4 GB VRAM läuft, einschließlich älterer Karten wie der NVIDIA GTX 1650 und dem NVIDIA Jetson Xavier NX. Der Durchsatz auf einer RTX 3060 (12 GB) bei FP16 beträgt etwa 100 Bilder/Sekunde. Auf einer NVIDIA A100 übersteigt der Durchsatz 400 Bilder/Sekunde, was eine Echtzeitverarbeitung von 4K-Drohnenbildern bei Kachelzerlegungsgeschwindigkeiten ermöglicht.
Apple Silicon (MPS)-Unterstützung. DINOv3 ist vollständig kompatibel mit dem Metal Performance Shaders (MPS)-Backend von Apple in PyTorch und bietet GPU-beschleunigte Inferenz auf Apple Silicon Macs (M1, M2, M3, M4 Serie). Das MPS-Backend bildet PyTorch-Operationen über das Metal-Framework auf Apples GPU-Architektur ab. Die Leistung auf einem M2 Pro MacBook Pro (19-Kern-GPU, 32 GB Unified Memory) erreicht etwa 25-35 Bilder/Sekunde für ViT-B/16 bei FP16-Präzision – ausreichend für die Stapelverarbeitung großer Bildsammlungen. Auf einem M2 Ultra Mac Studio (76-Kern-GPU, 192 GB Unified Memory) erreicht der Durchsatz etwa 70-90 Bilder/Sekunde. Die Speichernutzung ist effizient, da Apples Unified-Memory-Architektur den CPU-GPU-Datentransfer-Overhead eliminiert. MPS-beschleunigtes DINOv3 ermöglicht es Inspektoren, die Inferenz direkt auf einem MacBook im Feld ohne dedizierte GPU-Hardware durchzuführen. Der größere Unified Memory von Apple Silicon (bis zu 192 GB beim M2 Ultra) ermöglicht auch die Verarbeitung sehr hochauflösender Bilder ohne Kachelung – ein 4096x4096-Bild erzeugt 256x256 Patches = 65.536 Token, was etwa 8 GB VRAM-äquivalenten Speicher im Unified-Memory-Pool erfordert.
Verteilte Inferenz. Für groß angelegte Infrastrukturinspektionsprojekte, die Millionen von Bildern verarbeiten, ist verteilte Inferenz über mehrere GPUs oder Maschinen hinweg erforderlich. DINOv3 unterstützt PyTorch DistributedDataParallel (DDP) für Multi-GPU-Inferenz auf einem einzelnen Server, Modellparallelität (Pipeline-Parallelität für ViT-7B) und Ray (ein Open-Source-Framework für verteiltes Rechnen) für Multi-Node-verteilte Inferenz. Große Bereitstellungen verwenden üblicherweise Kubernetes mit GPU-Node-Pools, die DINOv3-Inferenz als skalierbaren Microservice ausführen. Jeder Inferenz-Pod läuft auf einer einzelnen T4-GPU (16 GB VRAM) und verarbeitet etwa 70 Bilder/Sekunde. Ein Cluster von 50 Pods erreicht einen Durchsatz von 3.500 Bildern/Sekunde, was die Verarbeitung einer 500-Bild-Startbahnvermessung in weniger als 3 Sekunden ermöglicht. Der Inferenzserver verwendet TorchServe für die Modellbereitstellung mit dynamischem Batching (Batch-Größen von 4-16, abhängig vom Anfragevolumen) und FP16-Präzision, um den Durchsatz zu maximieren.
Edge-Bereitstellung mit NVIDIA Jetson. Für feldbereitgestellte Inspektionssysteme, die Drohnen oder Bodenfahrzeuge verwenden, kann DINOv3 ViT-B/16 auf NVIDIA Jetson-Edge-Geräten bereitgestellt werden. Das Jetson Orin NX 16GB-Modul (100 TOPS KI-Leistung) erreicht 15-25 Bilder/Sekunde mit DINOv3 ViT-B/16 bei FP16, abhängig vom Leistungsmodus (15 W vs. 25 W vs. 40 W). Das Modell wird mithilfe von TensorRT optimiert – NVIDIAs Deep-Learning-Inferenzoptimierer, der Schichten fusioniert, die Kernel-Auswahl optimiert und auf FP16 oder INT8 quantisiert. Mit TensorRT INT8-Quantisierung steigt die Inferenzgeschwindigkeit auf 30-40 Bilder/Sekunde auf Jetson Orin NX mit einer Genauigkeitsverschlechterung von weniger als 1 % gegenüber FP32. Das Jetson Xavier NX (21 TOPS) erreicht 8-12 Bilder/Sekunde mit TensorRT FP16. Diese Edge-Bereitstellung ermöglicht eine Echtzeit-Risserkennung während des Drohnenflugs – die Drohnenkamera nimmt Bilder auf, und DINOv3 verarbeitet sie an Bord und markiert potenzielle Defekte innerhalb von Sekunden nach der Aufnahme, ohne dass eine Cloud-Verbindung erforderlich ist.
Open-Source-Verfügbarkeit und Lizenzierung
DINOv3 wurde von Meta AI im Jahr 2025 als Open-Source-Projekt veröffentlicht, was die Tradition des Unternehmens fortsetzt, hochmoderne KI-Forschungsmodelle öffentlich zugänglich zu machen. Das Verständnis der Lizenz- und Vertriebsbedingungen ist für Organisationen, die den Einsatz von DINOv3 in kommerziellen Produkten planen, unerlässlich.
Code und Modellgewichte. Die vollständige DINOv3-Codebasis ist auf GitHub unter facebookresearch/dinov3 verfügbar (Stand Mitte 2025 über 10.700 Sterne). Das Repository enthält den vollständigen Trainings- und Evaluierungscode (PyTorch), Modelldefinitionen, Datenverarbeitungs-Pipelines, Evaluierungsskripte und vortrainierte Gewichte für alle 12 veröffentlichten Modellvarianten. Die Modellgewichte sind auch im Hugging Face Hub unter dem facebook/dinov3-*-Namespace verfügbar, einschließlich: facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M Parameter) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M Parameter) das häufig verwendete Basismodell facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M Parameter) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1,5B Parameter) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B Parameter) Plus ConvNeXt-Varianten (T, S, B, L) und satellitenspezifische Modelle (SAT-493M)
Der Zugang zu Hugging Face erfordert, dass Benutzer den Bedingungen von Meta zustimmen und Kontaktinformationen angeben, die gemäß der Datenschutzrichtlinie von Meta erfasst, gespeichert und verarbeitet werden. Die Modellgewichte werden als PyTorch state_dict-Dateien verteilt, die mit der Hugging Face Transformers-Bibliothek kompatibel sind (Integration verfügbar über AutoModel.from_pretrained()).
Die DINOv3-Lizenz. DINOv3 wird unter der DINOv3-Lizenz veröffentlicht, einer benutzerdefinierten Open-Source-Lizenz, die von Meta AI speziell für diese Modellveröffentlichung entwickelt wurde. Dies unterscheidet sich von DINOv2, das unter der standardmäßigen Apache-2.0-Lizenz veröffentlicht wurde. Die DINOv3-Lizenz erlaubt: Nutzung, Vervielfältigung, Modifikation und Verbreitung des Modells und Codes Kommerzielle Nutzung, einschließlich Integration in Produkte und Dienstleistungen Unterlizenzierung abgeleiteter Werke unter anderen Bedingungen
Die DINOv3-Lizenz enthält spezifische Anforderungen an die Namensnennung (Urheberrechtshinweise müssen beibehalten werden) und eine Richtlinie zur akzeptablen Nutzung, die die Verwendung des Modells für bestimmte Zwecke verbietet, darunter Überwachung, die Menschenrechte verletzt, autonome Waffen und Verstöße gegen geltendes Recht. Die Lizenz hat Diskussionen in der Entwickler-Community ausgelöst – GitHub-Issue #31 im dinov3-Repository fordert speziell eine Veröffentlichung unter einer standardmäßigeren Lizenz wie Apache 2.0, um die rechtliche Compliance für Unternehmen mit etablierten Open-Source-Lizenzrichtlinien zu vereinfachen. Leser sollten die Lizenzbedingungen im Hinblick auf ihren eigenen Anwendungsfall prüfen.
Vergleich mit anderer Backbone-Lizenzierung.
| Backbone | Lizenz | Kommerzielle Nutzung | Namensnennung erforderlich | Benutzerdefinierte Bedingungen |
|---|---|---|---|---|
| DINOv3 | DINOv3-Lizenz | Ja | Ja | Ja |
| DINOv2 | Apache 2.0 | Ja | Ja | Nein |
| ViT (Google) | Apache 2.0 | Ja | Ja | Nein |
| CLIP (OpenAI) | MIT | Ja | Ja | Nein |
| OpenCLIP | MIT | Ja | Ja | Nein |
| SAM (Meta) | Apache 2.0 | Ja | Ja | Nein |
| ConvNeXt | MIT | Ja | Ja | Nein |
Rechenkosten der Reproduktion. Die Trainingskosten für DINOv3 ViT-7B werden auf 2-5 Millionen USD geschätzt (etwa 15.000 GPU-Tage auf A100-80GB zu On-Demand-Cloud-Preisen). Die destillierten kleineren Modelle (ViT-B, ViT-L) sind deutlich günstiger zu reproduzieren, erfordern aber dennoch erhebliche Rechenleistung – die ViT-Base-Destillation aus ViT-7B auf LVD-1689M erfordert etwa 500-800 GPU-Tage. Für Praktiker entfällt jedoch durch die Verfügbarkeit vortrainierter Gewichte die Notwendigkeit jeglicher Trainingsrechenleistung – die Gewichte können heruntergeladen und sofort für die Inferenz verwendet werden, lediglich zu den Kosten einer einzelnen GPU beliebiger Generation. Diese Zugänglichkeit ist das grundlegende Wertversprechen von Foundation-Modellen: Die enormen Trainingskosten werden auf alle nachgelagerten Benutzer amortisiert.
Community- und Ökosystem-Integration. DINOv3 profitiert von einer breiten Ökosystem-Integration: Hugging Face Transformers bietet eine Plug-and-Play-API, PyTorch Hub unterstützt das Laden von Modellen über torch.hub.load(), und das Modell ist im Torchvision-Modellzoo für den direkten Zugriff enthalten. Die Integration mit Weights & Biases, MLflow und Neptune.ai für die Experimentverfolgung wird durch Standard-PyTorch-Hooks unterstützt. Der Export in das ONNX (Open Neural Network Exchange)-Format wird für die Bereitstellung in Nicht-PyTorc-Umgebungen unterstützt, einschließlich TensorRT für NVIDIA-Edge-Geräte, CoreML für Apple-Geräte und TFLite für mobile Bereitstellungen. DINOv3 integriert sich über die Hugging Face Transformers-Pipeline, mit TensorRT-Optimierung für die Edge-Bereitstellung auf Jetson Orin NX und MPS-Beschleunigung für macOS-Laptops.
Schlussfolgerung. DINOv3 stellt einen Generationensprung bei selbstüberwachten Seh-Foundation-Modellen dar und erreicht eine hochmoderne Leistung bei globalen und dichten Vorhersageaufgaben durch beispiellose Skalierung (1,689 Milliarden Bilder, 7 Milliarden Parameter) und die Gram-Ankerungsinnovation, die die Qualität dichter Merkmale bewahrt. Für die Analyse von Infrastrukturoberflächen bietet DINOv3s ViT-B/16-Variante einen 768-dimensionalen Einbettungsraum mit außergewöhnlicher semantischer Struktur – Oberflächentypen, Rissmuster und Defektmerkmale sind im Einbettungsraum linear trennbar, was eine genaue Klassifizierung und Erkennung mit eingefrorenem Backbone-Inferenz ermöglicht. Die Open-Source-Verfügbarkeit, die breite Hardware-Unterstützung (GPU, MPS, Edge) und die großzügige Lizenzierung machen DINOv3 zu einem starken Backbone für die automatisierte Infrastrukturinspektion mit bescheidenen Anforderungen an bereichsspezifische Trainingsdaten und Rechenleistung.
Häufig gestellte Fragen
- Was ist der Unterschied zwischen DINOv3 und DINOv2?
- DINOv3 stellt einen signifikanten Skalierungssprung gegenüber DINOv2 in mehreren Dimensionen dar. Erstens, Trainingsdaten: DINOv2 wurde auf 142 Millionen kuratierten Bildern (LVD-142M) trainiert, während DINOv3 auf 1,689 Milliarden Bilder (LVD-1689M) skaliert, eine 12-fache Steigerung. Zweitens, Modellgröße: DINOv2s größtes Lehrermodell hatte 1 Milliarde Parameter (ViT-g), während DINOv3 einen 7-Milliarden-Parameter-Lehrer (ViT-7B) trainiert. Drittens, Patch-Größe: DINOv2 verwendete eine 14-Pixel-Patch-Größe und erzeugte 256 Patch-Token pro 224x224-Bild, DINOv3 verwendet eine 16-Pixel-Patch-Größe und erzeugt 196 Patch-Token. Viertens, Positionseinbettungen: DINOv2 verwendete standardmäßig gelernte Positionskodierungen, während DINOv3 Rotary Position Embeddings (RoPE) mit zufälligem Box-Jitter für eine bessere Aspektverhältnis-Resilienz einführt. Fünftens, die Schlüsselinnovation der Gram-Ankerung in DINOv3 bewahrt die Qualität der dichten Merkmalskarte während langer Trainingszeitpläne, ein Problem, das dazu führte, dass DINOv2s Patch-Merkmale bei verlängertem Training degradierten. Sechstens erreicht DINOv3 eine +6 mIoU-Verbesserung bei der ADE20K-Segmentierung, +6,7 J und F-Mean beim Video-Tracking und +10,9 GAP bei der Instanzsuche im Vergleich zu DINOv2.
- Wie kann DINOv3 für die Analyse von Infrastrukturoberflächen verwendet werden?
- DINOv3s ViT-B/16-Backbone kann als primäre Merkmalsextraktions-Engine in einer Infrastrukturinspektions-Pipeline dienen. Wenn eine Drohne oder Kamera ein Bild einer Startbahnoberfläche, eines Brückendecks oder einer Straßenbefestigung aufnimmt, wird das Bild auf 224x224 Pixel skaliert und in 196 sich nicht überlappende 16x16-Patches unterteilt. Jeder Patch wird linear in einen 768-dimensionalen Vektor eingebettet, und zusammen mit dem CLS-Token durchlaufen diese 12 Transformer-Encoder-Layer mit Multi-Head-Self-Attention. Die resultierende 768-dimensionale CLS-Token-Einbettung erfasst globale Oberflächeneigenschaften, die zur Klassifizierung des Oberflächentyps (Asphalt, Beton, Chip Seal usw.) und der Gesamtqualitätsstufe verwendet werden. Gleichzeitig kodieren die 196 Patch-Token-Einbettungen (jeweils 768-dimensional) lokalisierte Texturinformationen auf Patch-Ebene, die die Pixel-level-Risserkennung und andere dichte Vorhersageaufgaben unterstützen. Der eingefrorene Backbone-Ansatz bedeutet, dass DINOv3s Gewichte fixiert bleiben, während leichte aufgabenspezifische Köpfe (lineare Sonden oder flache MLPs) auf beschrifteten Infrastrukturdatensätzen trainiert werden. Dies reduziert die Trainingskosten im Vergleich zur vollständigen Feinabstimmung um etwa 90 % und erreicht gleichzeitig eine hochmoderne Defekterkennungsgenauigkeit.
- Welche Hardware wird benötigt, um DINOv3-Inferenz auszuführen?
- DINOv3 bietet Modelle in verschiedenen Größen, um unterschiedlichen Hardware-Beschränkungen gerecht zu werden. Die ViT-B/16-Variante (86 Millionen Parameter) läuft effizient auf einer einzelnen NVIDIA-GPU mit mindestens 8 GB VRAM und erreicht Inferenzgeschwindigkeiten von 50-100 Bildern pro Sekunde auf einer RTX 3060 oder höher. Auf Apple Silicon Macs (M1/M2/M3) bietet das MPS-Backend (Metal Performance Shaders) hardwarebeschleunigte Inferenz mit etwa 20-40 FPS auf einem M2 Pro. Für Edge-Bereitstellungen läuft die destillierte ViT-Small-Variante (21M Parameter) auf NVIDIA Jetson Orin NX mit 15-30 FPS. Die größte Variante, ViT-7B, benötigt 4-8 NVIDIA A100 (80GB) GPUs für die Inferenz. DINOv3 unterstützt Mixed-Precision (FP16) Inferenz, die den Speicherverbrauch bei vernachlässigbarem Genauigkeitsverlust um etwa 50 % reduziert. Das Modell ist in PyTorch über Hugging Face Transformers verfügbar, wobei der Checkpoint facebook/dinov3-vitb16-pretrain-lvd1689m der standardmäßige Einstiegspunkt ist.
- Was ist Gram-Ankerung in DINOv3?
- Gram-Ankerung ist eine neuartige Regularisierungstechnik, die in DINOv3 eingeführt wurde, um die Degradation dichter Merkmalskarten während langer selbstüberwachter Trainingszeitpläne zu lösen. Während des erweiterten DINOv2-artigen Trainings mit großen Modellen (ViT-L und darüber) wurde beobachtet, dass Patch-Ebene-Merkmale ihre räumliche Struktur und semantische Bedeutung verloren – die lineare Sondengenauigkeit bei globalen Aufgaben verbesserte sich, aber die Patch-weisen Merkmalskarten wurden verrauscht und verloren ihre Lokalisierungsfähigkeit. Die Gram-Ankerung führt einen zusätzlichen L2-Verlustterm ein, der die Gram-Matrix der Schüler-Patch-Merkmale mit einer eingefrorenen Gram-Matrix aus einem frühen EMA-Schnappschuss des Lehrers ausrichtet. Konkret, gegeben die L2-normalisierte Schüler-Patch-Matrix X_S und eine Gram-Lehrermatrix X_G (ein früher EMA-Schnappschuss), ist der Verlust L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Dieser Verlust bewahrt die paarweise Patch-Ähnlichkeitsstruktur, anstatt absolute Merkmalspositionen zu erzwingen, und wirkt als räumlicher Regularisierer. Integriert nach 1M Vor-Trainingsiterationen mit Gewicht 2 und Lehreraktualisierungen alle 10k Schritte, ergibt die Gram-Ankerung eine +2 mIoU-Verbesserung bei der ADE20K-Segmentierung und einen besseren Tiefenschätzungs-RMSE ohne Verschlechterung der globalen Metriken.
- Wie werden DINOv3s 768-dimensionale Einbettungen für die Oberflächendefekterkennung verwendet?
- DINOv3s ViT-B/16-Variante erzeugt eine 768-dimensionale Einbettung für jeden der 196 Patches plus einen CLS-Token pro 224x224-Bild. Für die Analyse von Infrastrukturoberflächen dienen diese Einbettungen zwei unterschiedlichen Zwecken. Für die globale Klassifizierung (Oberflächentyp, Gesamtqualitätsbewertung) wird die CLS-Token-Einbettung in einen leichten linearen Klassifikator oder einen 2-Lagen-MLP-Kopf eingespeist, der 768 Dimensionen auf N Ausgabeklassen abbildet. Für dichte Vorhersageaufgaben (Pixel-level-Risssegmentierung) bilden die 196 Patch-Token-Einbettungen ein 14x14 räumliches Gitter von 768-dimensionalen Vektoren. Dieses Gitter wird durch einen Segmentierungskopf (typischerweise ein leichter konvolutioneller Decoder mit 1-3 Lagen) geleitet, der die 14x14-Merkmalskarte auf die ursprüngliche 224x224-Auflösung hochskaliert. Die Einbettung jedes Pixels kann mithilfe von Kosinusähnlichkeit mit Defekt-Prototypen verglichen werden – Patches mit Einbettungen, die Defekt-Prototypen (die durch wenige Beispiele etabliert wurden) nahe kommen, werden als Defekte markiert.
Dies ist ein Referenzeintrag. TarmacView bietet Drohneninspektionsdienste an und verkauft nicht die in diesem Glossar beschriebene Ausrüstung oder Materialien.