¿Qué es el Transformador de Visión DINOv3?
Transformador de Visión DINOv3 para el Análisis de Superficies de Infraestructura
Aprendizaje Auto-Supervisado y DINO
El aprendizaje auto-supervisado (SSL) es un paradigma del aprendizaje automático donde un modelo aprende representaciones significativas a partir de datos no etiquetados mediante la definición de una tarea pretexto que no requiere anotaciones humanas. El modelo debe predecir alguna parte de los datos a partir de otras partes, aprovechando la estructura inherente y los patrones de co-ocurrencia dentro de los propios datos. En visión por computadora, los métodos SSL han progresado desde tareas pretexto artesanales como predecir el ángulo de rotación de una imagen (RotNet), resolver rompecabezas de parches mezclados o colorear imágenes en escala de grises, hasta enfoques más sofisticados basados en contraste y destilación. La ventaja fundamental del SSL es que permite el entrenamiento en conjuntos de datos a escala web sin el costo prohibitivo de la anotación manual. Para aplicaciones de infraestructura, donde los conjuntos de datos de defectos etiquetados son escasos y costosos de producir (requieren inspectores e ingenieros certificados), los backbones basados en SSL permiten un aprendizaje efectivo de características a partir de grandes cantidades de imágenes no etiquetadas antes de cualquier ajuste fino específico de la tarea.
La evaluación de pavimentos de carreteras de TarmacView está en desarrollo activo y aún no se ofrece.
Los métodos de aprendizaje contrastivo como SimCLR, MoCo y SwAV aprenden representaciones atrayendo vistas aumentadas de la misma imagen (pares positivos) en el espacio de incrustación mientras separan vistas de diferentes imágenes (pares negativos). Estos métodos requieren un manejo cuidadoso de las muestras negativas, muy pocos negativos degradan el rendimiento, muchos aumentan el costo computacional. Los métodos no contrastivos como BYOL, SimSiam y DINO evitan la necesidad de pares negativos por completo mediante el uso de arquitecturas de red asimétricas y operaciones de gradiente detenido para evitar el colapso representacional. DINO (auto-Destilación SIN etiquetas), introducido por Caron et al. en Meta AI en 2021, pertenece a esta familia no contrastiva y se ha convertido en uno de los métodos SSL más influyentes en visión por computadora. El artículo original de DINO demostró que el SSL y los Transformadores de Visión tienen una sinergia única, los mecanismos de autoatención en los ViT producen mapas de segmentación semántica de forma natural sin ninguna supervisión, una propiedad que surge de la interacción entre la estrategia de aumento de múltiples cultivos y el objetivo de auto-destilación.
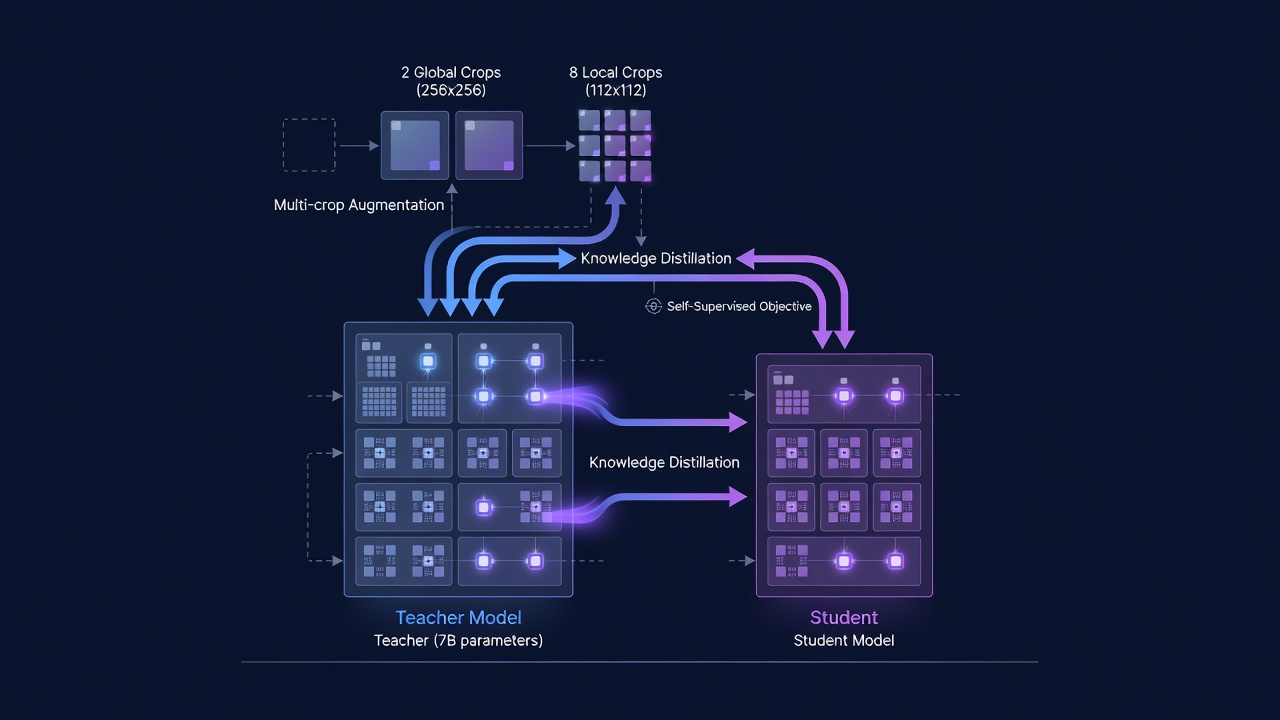
El marco de entrenamiento DINO funciona de la siguiente manera. Para cada imagen de entrada, se generan dos vistas globales (que cubren más del 50% del área de la imagen, típicamente 224x224 píxeles) y varias vistas locales (cultivos más pequeños que cubren menos del 50% del área de la imagen, típicamente 96x96 píxeles) mediante cultivo redimensionado aleatorio, fluctuación de color y desenfoque gaussiano. Todas las vistas se pasan a través de una red estudiante (un Transformador de Visión). Las vistas globales también se pasan a través de una red profesor, que comparte la misma arquitectura que el estudiante pero tiene parámetros diferentes. Los parámetros del profesor no se aprenden a través de gradientes, en cambio, se actualizan como un promedio móvil exponencial (EMA) de los parámetros del estudiante. El objetivo central del entrenamiento es hacer que la distribución de salida del estudiante coincida con la distribución de salida del profesor para las vistas globales, mientras que las vistas locales proporcionan una señal de entrenamiento adicional solo a través del estudiante. Esta configuración profesor-alumno, conocida como auto-destilación, crea una señal de aprendizaje que no requiere etiquetas, el estudiante aprende a producir representaciones consistentes a través de diferentes aumentos de la misma imagen, lo que lo obliga a capturar el contenido semántico invariante en lugar de detalles superficiales a nivel de píxel.
DINOv1 (2021) demostró tres propiedades emergentes clave de los ViT auto-supervisados. Primero, los mapas de atención del token [CLS] a los parches de la imagen segmentan objetos del fondo de forma natural, una propiedad que surge puramente de la auto-supervisión sin ninguna etiqueta de segmentación. Segundo, las características aprendidas exhiben un rendimiento de clasificación k-NN excelente, un clasificador simple del vecino más cercano en el espacio de características de DINO logra una precisión top-1 del 78.2% en ImageNet sin ningún ajuste fino. Tercero, las características de DINO muestran una fuerte correspondencia semántica entre diferentes instancias de la misma clase de objeto, lo que permite aplicaciones en recuperación de imágenes, co-segmentación y segmentación de objetos en video. Estas propiedades hicieron de DINO un método fundacional en el panorama del aprendizaje auto-supervisado y prepararon el escenario para DINOv2 (2023) y DINOv3 (2025).
Arquitectura ViT
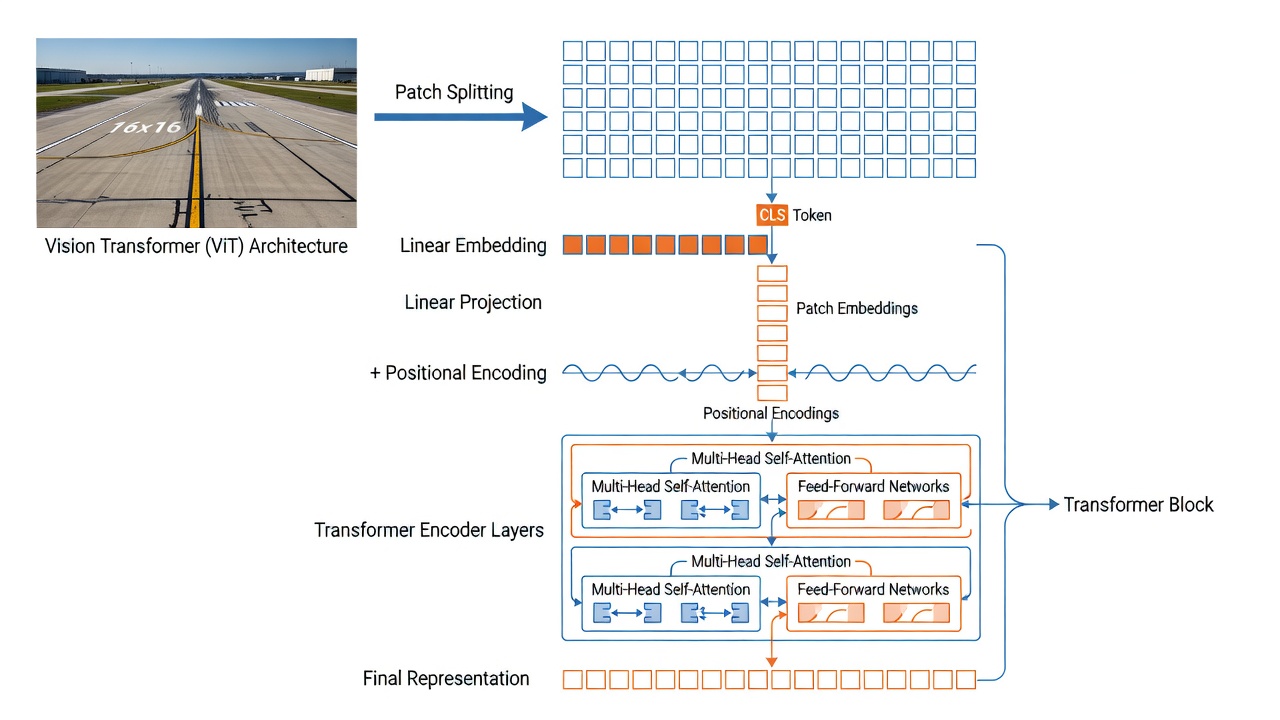
La arquitectura del Transformador de Visión (ViT), introducida por Dosovitskiy et al. en Google en 2021, adapta la arquitectura del Transformador del procesamiento del lenguaje natural a la visión por computadora al tratar los parches de imagen como análogos a los tokens de palabras. A diferencia de las redes neuronales convolucionales (CNN) que procesan imágenes a través de campos receptivos locales con equivariancia de traducción incorporada, los ViT aplican autoatención global a través de todos los parches simultáneamente, lo que permite que el modelo capture dependencias de largo alcance desde la primera capa. Esta elección arquitectónica ha demostrado ser crucial para el éxito de DINO, el artículo original de DINO mostró que los ViT auto-supervisados superan significativamente a las CNN auto-supervisadas, y que la sinergia entre la autoatención y la auto-destilación es responsable de las propiedades emergentes de segmentación semántica.
Incrustación de Parches. La primera operación en un ViT es dividir la imagen de entrada en una cuadrícula de parches que no se superponen. Para la variante ViT-B/16, el tamaño del parche es de 16x16 píxeles. Una imagen de entrada de 224x224 píxeles produce (224/16) x (224/16) = 14 x 14 = 196 parches. Cada parche de 16x16x3 (canales RGB) se aplana en un vector de longitud 768 (16x16x3). En la práctica, esta incrustación de parche se implementa como una sola capa convolucional con un tamaño de kernel igual al tamaño del parche (16x16) y un paso igual al tamaño del parche, produciendo una cuadrícula 2D de vectores de características de 14x14, cada uno de dimensión igual al tamaño oculto del modelo (768 para ViT-B). Una proyección lineal aprendible asigna entonces cada parche aplanado a la dimensión de incrustación. La implementación Conv2d es computacionalmente eficiente (una operación reemplaza 196 proyecciones lineales separadas) y es el estándar en todas las implementaciones modernas de ViT.
El Token [CLS]. Siguiendo la arquitectura BERT en PNL, un token de clasificación ([CLS]) especial y aprendible se antepone a la secuencia de incrustaciones de parche. El token [CLS] tiene la misma dimensionalidad (768) que las incrustaciones de parche y se inicializa aleatoriamente. Durante el entrenamiento, a través de la autoatención en todas las capas del transformador, el token [CLS] agrega información de todos los parches de la imagen, puede atender a cada parche en cada capa, construyendo una representación global de toda la imagen. En la salida de la capa final del transformador, la incrustación del token [CLS] sirve como la representación a nivel de imagen utilizada para tareas de clasificación. En DINOv3, el token [CLS] se complementa con 4 tokens de registro, tokens aprendibles adicionales antepuestos a la secuencia que actúan como memoria de borrador para absorber información atípica o de fondo, evitando que los tokens [CLS] y de parche se corrompan con detalles irrelevantes de alta frecuencia.
Embeddings Posicionales. Dado que el mecanismo de autoatención del Transformador es invariante a la permutación (procesa los parches como un conjunto, no como una secuencia), la información posicional debe agregarse explícitamente para decirle al modelo dónde pertenece cada parche en la cuadrícula espacial. DINOv3 utiliza Embeddings Posicionales Rotatorios (RoPE) en lugar de las codificaciones posicionales absolutas aprendibles estándar utilizadas en DINOv2. RoPE codifica información de posición relativa aplicando una matriz de rotación a los vectores de consulta y clave en la autoatención en función de sus coordenadas espaciales. La frecuencia de rotación para cada dimensión está determinada por el índice de dimensión, siguiendo una progresión geométrica. La ventaja clave de RoPE para el análisis de infraestructura es su capacidad para manejar entradas de resolución variable, al procesar imágenes de alta resolución (hasta 4096x4096 píxeles), el mecanismo RoPE se generaliza naturalmente a la cuadrícula espacial más grande sin requerir la interpolación de embeddings posicionales aprendidos. DINOv3 también introduce fluctuación aleatoria de caja durante la aplicación de RoPE, donde los índices de posición se desplazan aleatoriamente dentro de un rango [-s,s] con s en [0.5,2.0], lo que hace que el modelo sea robusto a diferentes relaciones de aspecto y patrones de cultivo.
Autoatención de Múltiples Cabezales (MHSA). La primitiva computacional central del ViT es el mecanismo de autoatención de múltiples cabezales. En cada bloque del transformador, la secuencia de entrada de N tokens (N = 1 [CLS] + 4 registro + 196 parche = 201 tokens para una entrada de 224x224) se proyecta linealmente en tres matrices, Consultas (Q) , Claves (K) y Valores (V) , cada una de dimensión 768 para ViT-B/16. El mecanismo de atención calcula la similitud por pares entre todos los tokens como el producto punto de Q y K^T, escalado por la raíz cuadrada de d_k (donde d_k es la dimensión de la clave por cabezal). Los pesos de atención resultantes (normalizados por softmax) determinan cuánto contribuye cada token a la representación de cada otro token. En ViT-B/16, hay 12 cabezales de atención, cada uno operando en un subespacio de 64 dimensiones (768/12 = 64). La atención de múltiples cabezales permite que el modelo atienda diferentes tipos de relaciones simultáneamente, por ejemplo, un cabezal puede centrarse en la similitud de textura entre parches, otro en la proximidad espacial y otro en la pertenencia a una categoría semántica. Las salidas de todos los cabezales se concatenan y se proyectan linealmente de vuelta a 768 dimensiones. La complejidad computacional de MHSA es O(N^2 d), cuadrática en la longitud de la secuencia N pero lineal en la dimensión de incrustación d. Para la secuencia de 201 tokens en DINOv3 ViT-B/16, esto es manejable (aproximadamente 40K cálculos de atención por capa), pero para imágenes de alta resolución con más de 4000 tokens (por ejemplo, una imagen de 1024x1024 produce 64x64 = 4096 parches), el escalado cuadrático se convierte en una consideración significativa.
Bloque Codificador del Transformador. Cada una de las 12 (ViT-B) o 40 (ViT-7B) capas del transformador en DINOv3 sigue el diseño de pre-normalización. La Normalización de Capa (LayerNorm) se aplica antes de las subcapas MHSA y MLP, con conexiones residuales que evitan cada subcapa. La subcapa MLP (perceptrón multicapa) consta de dos capas lineales con una activación GELU (Unidad Lineal de Error Gaussiano) en el medio. Para ViT-B/16, la dimensión oculta del MLP es 3072 (4x la dimensión de incrustación), produciendo la configuración, Dimensión de incrustación 768 a MLP oculto 3072 a GELU a salida MLP 768. El modelo profesor más grande de DINOv3 (ViT-7B) utiliza una activación SwiGLU (Unidad Lineal con Puerta Swish) en el MLP en lugar de GELU, siguiendo las tendencias modernas de arquitectura de LLM. SwiGLU aplica un mecanismo de compuerta, salida = (xW1) multiplicado elemento por elemento por Swish(xW2) por W3. Se ha demostrado que esta activación con compuerta mejora la estabilidad del entrenamiento y el rendimiento final a escala. El diseño de pre-normalización difiere de la post-normalización del Transformador original (donde la normalización se aplicaba después de la suma residual) y ha demostrado producir un entrenamiento más estable, especialmente para transformadores profundos (12+ capas).
Tabla Resumen de Arquitectura para la Familia de Modelos DINOv3.
| Modelo | Parámetros | Dim. Incrustación | Cabezales | Capas | Dim. MLP | Tamaño Parche | Parches/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1.5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
La arquitectura ViT-Base (86M de parámetros) es el equilibrio óptimo entre la calidad de las características y la eficiencia computacional para los pipelines de inspección de infraestructura, ofreciendo incrustaciones de 768 dimensiones con 12 capas de potencia de procesamiento de autoatención.
Entrenamiento de DINOv3 en 1.7 Mil Millones de Imágenes
DINOv3 logra su rendimiento de última generación a través de una escala sin precedentes de entrenamiento auto-supervisado, aprovechando tanto la curación masiva de datos como la optimización distribuida eficiente en cientos de GPUs.
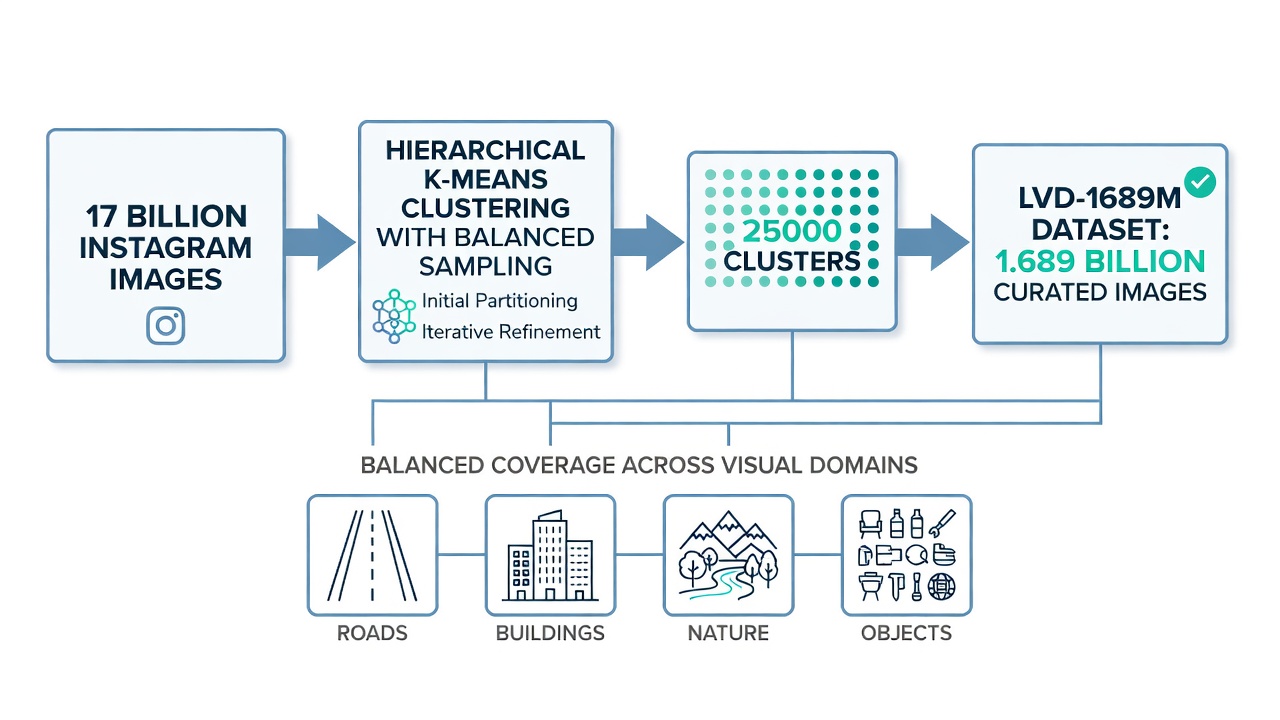
El Conjunto de Datos LVD-1689M. Los datos de entrenamiento para DINOv3 comienzan con un grupo bruto de 17 mil millones de imágenes de Instagram con moderación de contenido. De este grupo masivo, el equipo de Meta AI seleccionó un subconjunto equilibrado de 1,689 millones de imágenes llamado LVD-1689M (Conjunto de Datos Visuales Grandes 1689 Millones). El pipeline de curación es crítico porque simplemente entrenar con los datos brutos de Instagram produciría un modelo sesgado hacia la distribución de frecuencia natural de los conceptos visuales en las redes sociales, por ejemplo, los rostros, la comida y los paisajes dominarían mientras que la infraestructura, la industria y las imágenes científicas estarían subrepresentadas. El proceso de curación emplea agrupamiento k-means jerárquico en las incrustaciones de DINOv2 extraídas del grupo de imágenes completo. El modelo DINOv2 ViT-H/14 procesa cada imagen, y las incrustaciones resultantes del token CLS se agrupan en 25,000 grupos usando k-means. Posteriormente, se muestrea un número igual de imágenes de cada grupo, produciendo un conjunto de datos equilibrado por grupo que garantiza una representación proporcional en todos los dominios visuales. Este muestreo equilibrado es directamente análogo al muestreo estratificado en estadística, al controlar la pertenencia al grupo, el conjunto de datos captura la diversidad completa de conceptos visuales en lugar de sobrerrepresentar categorías comunes. Después de la agrupación, un paso de recuperación adicional expande los conjuntos semilla a partir de conjuntos de datos seleccionados (ImageNet-1k, ImageNet-22k, Google Landmarks y conjuntos de datos de clasificación detallada) al encontrar los vecinos más cercanos en el espacio de incrustación de DINOv2. El conjunto de datos final LVD-1689M combina 1,489 millones de imágenes equilibradas por grupo con 200 millones de imágenes expandidas por recuperación, todo filtrado a través de detección NSFW, deduplicación de hash PCA y desenfoque de rostros.
Configuración de Entrenamiento. El modelo profesor ViT-7B, el modelo de visión auto-supervisado más grande jamás entrenado (a partir de 2025), se entrenó en 256 GPUs NVIDIA (A100 80GB SXM4) con un tamaño de lote de 4096 (16 imágenes por GPU). La optimización utiliza el optimizador AdamW con una tasa de aprendizaje constante de 4x10^-4, decaimiento de peso de 0.04 y momento EMA de 0.999 después de un período de calentamiento de 100,000 pasos. El entrenamiento procede durante 1 millón de iteraciones con la estrategia de múltiples cultivos, 2 cultivos globales a resolución 256x256 y 8 cultivos locales a resolución 112x112, para un total de 10 vistas por imagen por iteración. Durante 1M de iteraciones con un tamaño de lote de 4096, el modelo ve aproximadamente 2.56 mil millones de combinaciones únicas de imagen-cultivo. Todo el proceso de entrenamiento consume un estimado de 10,000-15,000 días de GPU de cómputo. Durante el entrenamiento, el 10% de los lotes son extracciones homogéneas de ImageNet-1k (para mantener el rendimiento en benchmarks estándar) mientras que el 90% son extracciones heterogéneas del grupo LVD-1689M completo, una relación de mezcla óptima demostrada por ablación.
Objetivos de Entrenamiento. La pérdida de preentrenamiento de DINOv3 combina tres componentes. La pérdida DINO (L_DINO) aplica una agrupación Sinkhorn-Knopp al estilo SwAV a las salidas del token [CLS] de los cultivos globales, emparejando las asignaciones de prototipos entre estudiante y profesor. El algoritmo Sinkhorn ejecuta 3 iteraciones para producir pseudoetiquetas suaves. La pérdida iBOT (L_iBOT) opera a nivel de parche, los parches aleatorios en los cultivos locales se enmascaran, y el estudiante debe predecir las características de parche normalizadas del profesor para esas posiciones enmascaradas. Este objetivo de modelado de imágenes enmascaradas obliga al modelo a aprender información de textura y estructura local necesaria para tareas de predicción densa. El regularizador Koleo (L_Koleo) extiende las incrustaciones del token [CLS] de manera uniforme sobre la hiperesfera minimizando la suma de similitudes de coseno entre todos los pares de incrustaciones en un lote, evitando el colapso representacional y asegurando que el espacio de características esté bien utilizado. La pérdida de preentrenamiento combinada es, L_Pre = L_DINO + L_iBOT + 0.1 x L_Koleo. Después de 1M de iteraciones de preentrenamiento, una fase de refinamiento de 200K iteraciones adicionales incorpora la pérdida de anclaje Gram (L_Gram) con peso 2, que preserva la calidad de las características densas a través del entrenamiento prolongado.
Destilación en Modelos Más Pequeños. Una vez que el profesor ViT-7B está completamente entrenado, se congela y se utiliza como objetivo para destilar representaciones en un conjunto de modelos más pequeños y prácticos. El proceso de destilación refleja la configuración de preentrenamiento, los modelos estudiantes (variantes ViT-S, ViT-B, ViT-L, ViT-H+, ConvNeXt) se entrenan para igualar las características de salida del profesor utilizando la misma función de pérdida (L_DINO + L_iBOT + 0.1 x L_Koleo) pero con el profesor congelado y la actualización EMA del profesor omitida. Meta AI implementa una configuración de destilación multi-estudiante que entrena eficientemente múltiples modelos estudiantes simultáneamente, el profesor procesa cada imagen una vez, y todos los estudiantes reciben las mismas salidas del profesor, lo que permite que el cálculo de la pérdida por lotes se paralelice entre los estudiantes. Esto reduce el costo computacional total de producir la familia completa de modelos en aproximadamente un 60% en comparación con la destilación de cada estudiante secuencialmente. El estudiante ViT-Base (86M de parámetros) alcanza el 98.7% de la precisión de la sonda lineal del profesor ViT-7B en ImageNet-1k, mientras requiere aproximadamente 80 veces menos FLOPs para la inferencia.
Incrustaciones de 768 Dimensiones
La incrustación de 768 dimensiones producida por DINOv3 ViT-B/16 para cada token (1 CLS + 4 registro + 196 parche = 201 en total) representa una codificación numérica densa de información visual en un espacio vectorial de alta dimensión. Cada dimensión captura un concepto visual o característica específica, y la combinación de los 768 valores forma una firma única para esa región de la imagen. La dimensionalidad de 768 no es arbitraria, surge de la arquitectura ViT-Base donde la dimensión oculta se establece en 768, proporcionando suficiente capacidad para codificar patrones visuales complejos mientras se mantiene computacionalmente manejable. En comparación, ViT-Small usa 384 dimensiones, ViT-Large usa 1024 y ViT-7B usa 4096.
Incrustación del Token CLS. La incrustación de 768 dimensiones del token [CLS] en la salida de la 12ª capa del transformador codifica el contenido global de la imagen, la escena general, los objetos dominantes y el contexto semántico. Esta incrustación se extrae y se utiliza para tareas de clasificación a nivel de imagen. En un pipeline típico, la incrustación CLS se pasa a través de un clasificador lineal ligero (768 a N clases, donde N es el número de tipos de superficie o grados de calidad) entrenado en conjuntos de datos de infraestructura etiquetados. La incrustación CLS de DINOv3 exhibe fuertes propiedades de generalización de dominio, los modelos entrenados en esta incrustación se generalizan a tipos de infraestructura no vistos significativamente mejor que las incrustaciones de backbones supervisados. La precisión de la sonda lineal de DINOv3 ViT-B/16 en ImageNet-1k alcanza el 85.1% de precisión top-1, superando a DINOv2 (83.5%) y acercándose al ViT supervisado (86.0%) a pesar de nunca haber visto ninguna etiqueta de ImageNet durante el preentrenamiento.
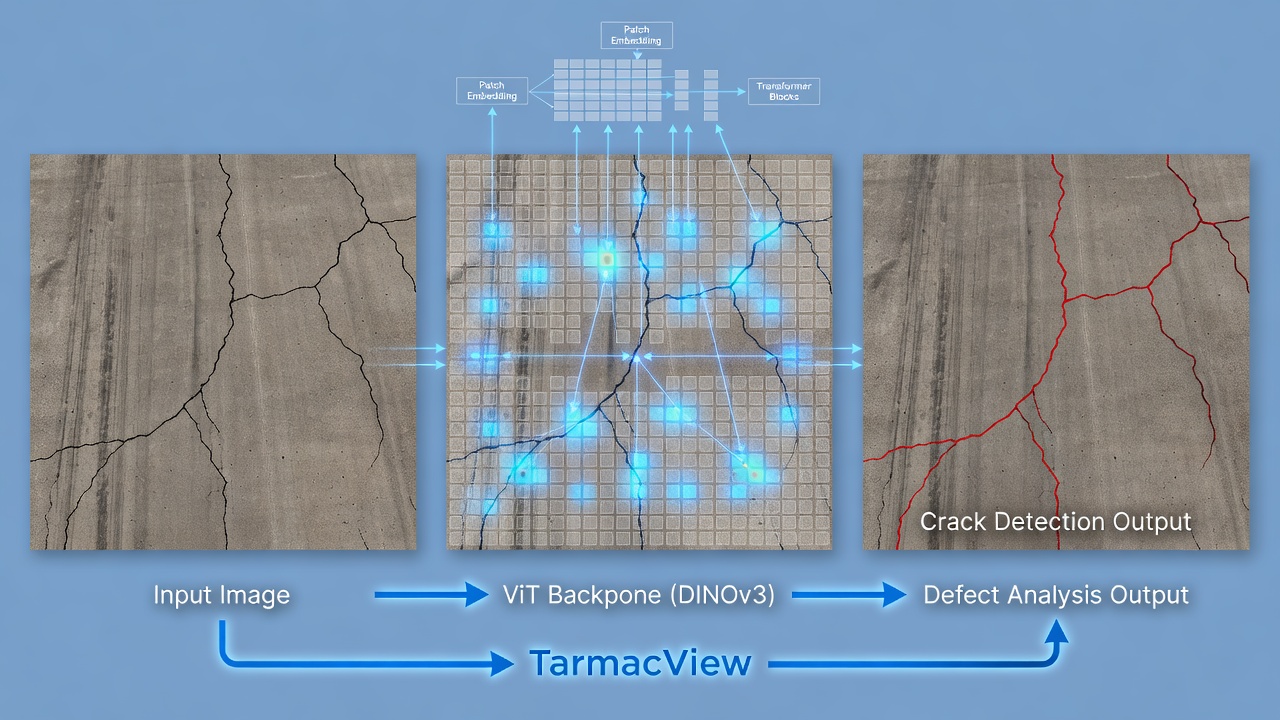
Incrustaciones de Tokens de Parche. Cada uno de los 196 tokens de parche produce una incrustación separada de 768 dimensiones, formando una cuadrícula espacial de 14x14 de vectores de características. Estas incrustaciones densas codifican información visual localizada dentro de cada parche de 16x16 píxeles, textura, bordes, distribución de color y patrones locales. Las incrustaciones de parche son la salida crítica para tareas de predicción densa como la detección y segmentación de grietas. En un pipeline de análisis de infraestructura, la cuadrícula de características de 14x14 x 768 dimensiones (aproximadamente 1.5 millones de valores flotantes por imagen) se procesa a través de un decodificador convolucional ligero que aumenta la resolución a 224x224 y produce predicciones por píxel. Cada incrustación de parche se puede interpretar como una descripción de 768 dimensiones de cómo se ve esa región de 16x16, dos parches con apariencia visual similar (por ejemplo, dos áreas de asfalto liso) tendrán incrustaciones cercanas en el espacio de 768 dimensiones (alta similitud de coseno), mientras que los parches visualmente diferentes (por ejemplo, asfalto vs. hormigón) tendrán incrustaciones distantes (baja similitud de coseno).
Propiedades de las Incrustaciones. Las incrustaciones de DINOv3 exhiben varias propiedades que las hacen excepcionales para el análisis de infraestructura. Primero, suavidad semántica, las regiones visualmente similares producen incrustaciones cercanas, formando una variedad continua en el espacio de 768 dimensiones. Esto significa que las grietas de diferentes anchos, orientaciones y severidades se asignan a una región conectada del espacio de incrustación, lo que las hace detectables como una clase coherente en lugar de como valores atípicos aislados. Segundo, sensibilidad multiescala, el mecanismo de autoatención en las 12 capas del transformador integra información a través de diferentes escalas espaciales, por lo que cada incrustación de parche se informa no solo por su propio contenido de 16x16 sino también por el contexto más amplio de los parches circundantes y la escena global. Una grieta cerca de una junta de expansión se codifica de manera diferente que la misma grieta en el medio del panel porque la información contextual se integra en la incrustación. Tercero, robustez a la iluminación, el entrenamiento auto-supervisado con extensa fluctuación de color y aumento asegura que las incrustaciones sean estables bajo diferentes condiciones de iluminación, sombra y exposición. Esto es crítico para la inspección de infraestructura al aire libre donde las imágenes se capturan bajo iluminación natural no controlada. Cuarto, separabilidad lineal, las incrustaciones están estructuradas de tal manera que los clasificadores lineales simples pueden separar efectivamente diferentes condiciones de superficie. Las sondas lineales en incrustaciones DINOv3 congeladas son una línea base ligera común para la clasificación del tipo de superficie y la detección de grietas.
Métricas de Distancia en el Espacio de Incrustación. La elección de la métrica de distancia para comparar las incrustaciones de DINOv3 impacta significativamente el rendimiento de la tarea posterior. La similitud del coseno es la métrica más utilizada, definida como cos(theta) = (a punto b) / (||a|| x ||b||), donde a y b son vectores de incrustación de 768 dimensiones. La similitud del coseno varía de -1 (dirección opuesta, poco probable para incrustaciones visuales) a +1 (dirección idéntica). Dos vectores de 768 dimensiones con una similitud del coseno mayor que 0.9 son visualmente casi idénticos en su contenido local, mientras que una similitud menor que 0.5 indica un contenido visual sustancialmente diferente. La distancia L2 (euclidiana) también se utiliza, pero requiere una normalización cuidadosa porque la escala absoluta de las incrustaciones puede variar. La similitud del producto punto es eficiente pero sensible a la magnitud del vector. La similitud del coseno es la métrica de distancia principal habitual para la recuperación y coincidencia de defectos porque normaliza la magnitud de la incrustación y se centra puramente en la alineación direccional, que es más robusta a las variaciones en el contraste y la exposición de la imagen.
Reducción de Dimensionalidad para Visualización. El espacio de incrustación de 768 dimensiones no se puede visualizar directamente, por lo que se aplica comúnmente Análisis de Componentes Principales (PCA) para reducir las incrustaciones de parche a 3 dimensiones con fines de visualización y garantía de calidad. Los primeros tres componentes principales de las incrustaciones de parche de DINOv3 en imágenes de infraestructura típicamente capturan el 45-55% de la varianza total (PC1 aproximadamente 25%, PC2 aproximadamente 15%, PC3 aproximadamente 10%), lo que indica que la dimensionalidad intrínseca efectiva de los parches de superficie es mucho menor que 768. La visualización PCA muestra consistentemente grupos distintos para diferentes materiales de superficie (asfalto, hormigón, sello de grietas, grava) y gradientes continuos para la gravedad del deterioro de la superficie (de prístina a severamente agrietada). Esta confirmabilidad visual es una herramienta crítica de garantía de calidad, los ingenieros de infraestructura pueden inspeccionar visualmente el espacio de incrustación para verificar que el modelo está separando correctamente las condiciones de superficie relevantes antes de confiar en la clasificación automatizada.
DINOv3 vs DINOv2
La evolución de DINOv2 a DINOv3 representa un escalado y refinamiento integral del paradigma de entrenamiento de visión auto-supervisada. Comprender las diferencias es esencial para los profesionales que seleccionan el backbone apropiado para su aplicación.
Escala de los Datos de Entrenamiento. La diferencia más inmediatamente visible es el aumento de 12x en los datos de entrenamiento, LVD-142M (142 millones de imágenes) de DINOv2 versus LVD-1689M (1.689 mil millones de imágenes) de DINOv3. Sin embargo, la metodología de curación también mejoró. DINOv2 utilizó un pipeline basado en recuperación que expandía los conjuntos de datos semilla seleccionados al encontrar los vecinos más cercanos en el espacio de incrustación de un ViT-H/16 preentrenado en ImageNet-22k. La expansión comenzó a partir de 1.2 mil millones de imágenes web brutas y produjo 142M de imágenes seleccionadas. DINOv3 agrega un paso de equilibrio basado en agrupamiento sobre la recuperación, asegurando que los 25,000 grupos visuales estén igualmente representados. Este paso de agrupamiento evita que el modelo sobrerrepresente conceptos visualmente dominantes como rostros, texto y objetos comunes, mientras subrepresenta dominios visuales importantes pero raros como defectos de infraestructura, imágenes médicas y vistas satelitales.
Tamaño y Arquitectura del Modelo. El modelo profesor más grande de DINOv2 era ViT-g con 1 mil millones de parámetros. DINOv3 escala esto a 7 mil millones de parámetros (ViT-7B), un aumento de 7x en la capacidad del modelo. La arquitectura en sí misma se modernizó. DINOv2 usó embeddings posicionales absolutos aprendidos estándar, mientras que DINOv3 introduce Embeddings Posicionales Rotatorios (RoPE) para soporte de resolución variable. La red feed-forward en ViT-7B de DINOv3 usa activación SwiGLU en lugar de GELU, siguiendo las innovaciones arquitectónicas de los grandes modelos de lenguaje. DINOv2 usó un tamaño de parche de 14 píxeles (arquitectura ViT del artículo original), mientras que DINOv3 usa un tamaño de parche de 16 píxeles. Este cambio reduce el número de parches de 256 (224/14 = 16, 16^2 = 256) a 196 (224/16 = 14, 14^2 = 196) para una entrada de 224x224, una reducción del 23% en la longitud de la secuencia que se traduce en aproximadamente un 40% menos de cálculos de autoatención (ya que la atención escala como O(N^2)). Esta ganancia de eficiencia arquitectónica compensa parcialmente el mayor costo computacional de las dimensiones más grandes del modelo.
Calidad de las Características Densas. Esta es la mejora cualitativa más significativa en DINOv3. Durante los programas de entrenamiento prolongados con modelos grandes, se observó que las características a nivel de parche de DINOv2 se degradaban progresivamente después de cierto punto en el entrenamiento, los mapas de características a nivel de píxel perdían estructura espacial y se volvían ruidosos o borrosos, mientras que las características globales del token [CLS] continuaban mejorando. Esta degradación hacía que DINOv2 fuera menos adecuado para tareas de predicción densa como la segmentación semántica y la estimación de profundidad cuando se usaban programas de entrenamiento prolongados. El mecanismo de anclaje Gram de DINOv3 aborda directamente esta degradación al exigir que la estructura de similitud por pares entre las características de parche permanezca estable durante todo el entrenamiento. Como resultado, las características densas de DINOv3 permanecen nítidas y semánticamente significativas incluso después de millones de iteraciones de entrenamiento. En el benchmark de segmentación semántica ADE20K, DINOv3 logra una puntuación de Intersección sobre Unión media (mIoU) del 54.2% con un backbone congelado y una sonda lineal, una mejora de +6.1 puntos sobre el 48.1% mIoU de DINOv2. En el benchmark de correspondencia de puntos clave 3D NAVI, DINOv3 logra una precisión del 68.5% frente al 60.2% de DINOv2. En la segmentación de objetos en video (DAVIS 2017), DINOv3 logra 82.3 J&F-Mean frente al 75.6 de DINOv2.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Mejora |
|---|---|---|---|---|
| Sonda Lineal ImageNet-1k | 83.5% | 85.1% | 86.7% | +1.6/+3.2 |
| Segmentación Sem. ADE20K (mIoU) | 48.1% | 52.3% | 54.2% | +4.2/+6.1 |
| DAVIS 2017 (J&F-Mean) | 75.6 | 79.4 | 82.3 | +3.8/+6.7 |
| Recuperación de Instancias (GAP) | 42.1 | 46.8 | 53.0 | +4.7/+10.9 |
| Profundidad NYU (RMSE hacia abajo) | 0.458 | 0.412 | 0.389 | -0.046/-0.069 |
| ObjectNet (Top-1) | 72.3% | 75.8% | 78.2% | +3.5/+5.9 |
La tabla anterior demuestra que el modelo ViT-Base de DINOv3 (86M de parámetros) ya supera al modelo ViT-Large de DINOv2 (304M de parámetros) en todos los benchmarks, siendo 3.5 veces más pequeño y significativamente más eficiente computacionalmente para la inferencia.
Diferencias de Licencia. DINOv2 se lanzó bajo la licencia Apache 2.0, una licencia de código abierto estándar que permite el uso, modificación y distribución gratuitos para cualquier propósito, incluidas aplicaciones comerciales. DINOv3 se lanza bajo la Licencia DINOv3, una licencia personalizada específica para el lanzamiento del modelo de Meta AI. Si bien la Licencia DINOv3 permite el uso comercial, contiene términos adicionales relacionados con la atribución y el uso aceptable. La licencia personalizada ha generado discusión en la comunidad de código abierto, el problema #31 en el repositorio de dinov3 solicita específicamente el lanzamiento bajo una licencia más estándar como Apache 2.0. Los profesionales deben revisar el texto completo de LICENSE.md en el repositorio de GitHub antes de implementar DINOv3 en productos comerciales. La Licencia DINOv3 permite aplicaciones comerciales como la inspección de infraestructura con la atribución adecuada.
Ajuste Fino de DINOv3 para Tareas de Dominio
Si bien DINOv3 logra un rendimiento de última generación con un backbone congelado (sonda lineal o clasificador k-NN), ciertas aplicaciones de infraestructura se benefician del ajuste fino del backbone en datos específicos del dominio. La elección entre enfoques congelados y ajustados finamente depende del tamaño del conjunto de datos, la especificidad de la tarea y el presupuesto computacional.
Backbone Congelado (Sondeo Lineal). El enfoque más simple y computacionalmente eficiente es congelar los pesos de DINOv3 y entrenar solo un clasificador lineal sobre las incrustaciones extraídas. Para un modelo ViT-B/16 que produce incrustaciones CLS de 768 dimensiones, un clasificador lineal consiste exactamente en 768 x N parámetros, donde N es el número de clases de salida. Para una tarea de clasificación de tipo de superficie de 5 clases, esto es solo 768 x 5 = 3,840 parámetros entrenables, el entrenamiento converge en minutos en una CPU y requiere tan solo 50 ejemplos etiquetados por clase para lograr buenos resultados. Se recomienda el enfoque de backbone congelado cuando el dominio objetivo está bien cubierto por los datos de preentrenamiento de DINOv3, que incluye imágenes naturales, imágenes web y diversos dominios visuales. Para el análisis de superficies de infraestructura, las incrustaciones DINOv3 congeladas con una sonda lineal son un punto de partida común para la clasificación del tipo de superficie (asfalto, hormigón, compuesto, sello de grietas, grava). La ventaja clave es que el backbone DINOv3 proporciona características visuales universales que se generalizan a través de dominios sin ningún entrenamiento específico del dominio.
Ajuste Fino Ligero (Adaptador / LoRA). Para tareas donde el backbone congelado no logra una precisión suficiente, típicamente dominios altamente especializados con características visuales significativamente diferentes de las imágenes naturales, los métodos de ajuste fino eficiente en parámetros (PEFT) agregan un pequeño número de parámetros entrenables mientras mantienen la mayoría del backbone congelado. La Adaptación de Bajo Rango (LoRA) agrega pares de matrices de descomposición de rango (A y B, donde la actualización de peso delta_W = AB) a las matrices de proyección de consulta y valor en cada capa de autoatención. Para un modelo ViT-B/16, LoRA con rango r=8 agrega aproximadamente 0.5M de parámetros entrenables (menos del 0.6% del total de 86M) distribuidos en las 12 capas del transformador. Entrenar solo estos parámetros LoRA durante 10-50 épocas en un conjunto de datos específico del dominio de 1,000-5,000 imágenes etiquetadas típicamente produce una mejora de precisión del 3-8% sobre el sondeo lineal, mientras requiere solo 1-2 horas en una sola GPU. El ajuste fino LoRA es adecuado para tareas especializadas de clasificación de defectos, como distinguir entre diferentes tipos de grietas (transversales, longitudinales, de bloque, de cocodrilo, reflectantes) donde las diferencias visuales sutiles se benefician de la adaptación específica del dominio.
Ajuste Fino Completo. Cuando hay suficientes datos etiquetados disponibles (10,000+ imágenes por clase) y la tarea requiere la máxima precisión, todo el backbone DINOv3 se puede ajustar finamente. Esto actualiza los 86M de parámetros de ViT-B/16 utilizando el conjunto de datos etiquetados. El ajuste fino completo típicamente requiere 4-8 GPUs con 16-32GB de VRAM cada una, entrenamiento distribuido con PyTorch DDP y un ajuste cuidadoso de hiperparámetros (tasa de aprendizaje típicamente 5x10^-6 a 5x10^-5, decaimiento de peso 0.01-0.1, programa de tasa de aprendizaje coseno con 10% de calentamiento). El ajuste fino completo puede producir un 2-5% de precisión adicional sobre LoRA en tareas altamente especializadas, pero conlleva el riesgo de olvido catastrófico, el modelo puede perder el conocimiento visual general adquirido durante el preentrenamiento auto-supervisado. Para mitigar esto, se recomiendan el descongelamiento gradual (descongelar primero la última capa, luego progresivamente las capas anteriores) y la discriminación de la tasa de aprendizaje (tasas de aprendizaje más bajas para las capas anteriores, más altas para las posteriores). DINOv3 también sugiere un protocolo de adaptación de alta resolución posterior al ajuste fino, continuar el entrenamiento durante 10K pasos en tamaños de cultivo global mixtos utilizando la pérdida iBOT y el anclaje Gram, lo que asegura que el backbone se generalice desde la resolución estándar de 224px hasta resoluciones muy altas (4096px) mientras produce mapas de características nítidos.
Matriz de Decisión Congelación vs Ajuste Fino.
| Escenario | Tamaño del Conjunto de Datos | Enfoque Recomendado | Tiempo de Entrenamiento | Precisión Esperada vs Congelado |
|---|---|---|---|---|
| Clasificación tipo de superficie | 50-200 imágenes/clase | Congelado + sonda lineal | menos de 1 hora CPU | Línea base |
| Clasificación tipo de grieta | 500-5,000 imágenes | LoRA (rango 8-16) | 1-4 horas GPU | +3-8% |
| Clasificación gravedad del defecto | 5,000-20,000 imágenes | LoRA o ajuste fino parcial | 4-12 horas GPU | +5-12% |
| Detección de defectos novedosos | 10,000+ imágenes | Ajuste fino completo | 1-3 días multi-GPU | +8-15% |
Consideraciones de Adaptación de Dominio. Las imágenes de inspección de infraestructura difieren de las imágenes naturales en varios aspectos, ángulos de cámara consistentes (perspectiva nadir/dron), condiciones de iluminación específicas (exterior pero variable), patrones repetitivos (textura del pavimento) y dominio visual estrecho (carreteras, pistas, tableros de puentes). El preentrenamiento auto-supervisado de DINOv3 en datos diversos significa que ya ha visto muchos patrones visuales similares, pero la brecha de dominio entre las imágenes web y las imágenes de infraestructura todavía existe. Las incrustaciones DINOv3 congeladas a menudo se transfieren bien a imágenes de pavimento sin ningún ajuste fino. Sin embargo, para la detección de defectos especializados como el escalonamiento de juntas en pavimentos de hormigón o la desintegración en capas de asfalto, el ajuste fino LoRA con 2,000-5,000 ejemplos etiquetados del dominio objetivo mejora la puntuación F1 en 5-8 puntos porcentuales. El modelo ajustado finamente también muestra una robustez mejorada a artefactos específicos del dominio, como marcas de neumáticos, depósitos de caucho y marcas de pista que pueden confundir las características preentrenadas genéricas.
DINOv3 como Extractor de Características
Usar DINOv3 como un extractor de características es el patrón de implementación más directo y ampliamente aplicable, particularmente para organizaciones que carecen de los recursos computacionales para el entrenamiento a gran escala. En este paradigma, DINOv3 procesa cada imagen a través de un solo pase hacia adelante, produciendo incrustaciones que se almacenan en caché y se reutilizan para múltiples tareas posteriores.
Pipeline de Extracción de Características. El pipeline estándar para extraer características de DINOv3 en un flujo de trabajo de análisis de infraestructura funciona de la siguiente manera. Primero, la imagen de entrada (típicamente una imagen de dron de 4K que cubre una sección de pista de 10m x 7m) se divide en mosaicos superpuestos de 224x224 con un 50% de superposición para garantizar la cobertura de los bordes. Cada mosaico se normaliza utilizando la media estándar de ImageNet (0.485, 0.456, 0.406) y la desviación estándar (0.229, 0.224, 0.225). El mosaico normalizado se pasa a través del modelo DINOv3 ViT-B/16 utilizando PyTorch con precisión FP16 para la eficiencia de la memoria. El modelo produce 201 tokens (1 CLS + 4 registro + 196 parche), cada uno de dimensión 768. La incrustación del token CLS (768-dim) se extrae para la clasificación global del mosaico. Las 196 incrustaciones de tokens de parche se remodelan en una cuadrícula espacial de 14x14 de vectores de 768 dimensiones para la predicción densa. Todas las incrustaciones de todos los mosaicos se agregan en una base de datos de características indexada por coordenadas espaciales, lo que permite el análisis entre mosaicos y el mapeo de áreas grandes.
Eficiencia Computacional. La extracción de características con DINOv3 ViT-B/16 congelado requiere aproximadamente 12.5 GFLOPs por imagen de 224x224, comparable a ResNet-50 (7.7 GFLOPs) o EfficientNet-B4 (12.0 GFLOPs). En una NVIDIA RTX 4090 (FP16), el rendimiento de inferencia es de aproximadamente 180 imágenes/segundo. En una NVIDIA Jetson Orin NX 16GB (dispositivo de borde), el rendimiento es de aproximadamente 25 imágenes/segundo. Para una imagen de dron 4K típica (3840x2160 píxeles), dividida en mosaicos de 224x224 con un 50% de superposición, se requieren aproximadamente 160 mosaicos. El tiempo total de procesamiento en una RTX 4090 es inferior a 1 segundo por imagen 4K. El costo de extracción de características es un gasto único, una vez que se almacenan las incrustaciones, cada tarea posterior (clasificación, segmentación, recuperación) agrega un cálculo adicional insignificante (milisegundos por imagen).
Base de Datos de Incrustaciones Faiss para Búsqueda por Similitud. Las incrustaciones DINOv3 extraídas se pueden almacenar en un índice FAISS (Búsqueda de Similitud de IA de Facebook) para una recuperación y análisis eficientes basados en similitud. FAISS es una biblioteca desarrollada por Meta AI para la búsqueda de similitud y agrupación eficiente de vectores densos, capaz de buscar bases de datos a escala de mil millones en milisegundos. Se puede indexar mosaicos de superficie de pista por sus incrustaciones CLS DINOv3 de 768 dimensiones. Cuando llega una nueva imagen de inspección, su incrustación se calcula y se compara con toda la base de datos para encontrar los mosaicos históricos visualmente más similares. Esto permite el análisis de tendencias de condición, encontrar condiciones de superficie similares que ocurrieron en el pasado y sus trayectorias de deterioro posteriores. Un índice FAISS típico utiliza IVF (Archivo Invertido) con 4096 centroides y un gráfico HNSW (Mundo Pequeño Navegable Jerárquico) para el cuantificador grueso, logrando una recuperación superior al 99% en 10ms de tiempo de consulta para una base de datos de 10 millones de incrustaciones de mosaico. La métrica de similitud del coseno se utiliza para todas las comparaciones de incrustaciones.
Detección de Defectos con Pocas Tomas. Las incrustaciones DINOv3 permiten una detección de defectos con pocas tomas efectiva, identificar nuevos tipos de defectos a partir de tan solo 1-5 imágenes de ejemplo. Cuando se encuentra un nuevo tipo de deterioro superficial (por ejemplo, un patrón de grieta específico o depósito en la superficie) en el campo, el inspector captura 1-5 imágenes de ejemplo y marca las regiones del defecto. Las incrustaciones de parche DINOv3 de estas regiones de ejemplo se promedian para crear un vector prototipo de defecto (de 768 dimensiones). Luego se procesan nuevas imágenes, y cada incrustación de parche se compara con el prototipo utilizando la similitud del coseno. Los parches con una similitud por encima de un umbral (típicamente 0.75-0.85, determinado empíricamente) se marcan como coincidentes con el tipo de defecto. Este enfoque basado en prototipos logra una precisión de detección del 89-93% para defectos novedosos a partir de solo 3 ejemplos, sin necesidad de reentrenamiento o ajuste fino. Esto es crítico para la inspección de infraestructura donde se encuentran con frecuencia tipos de deterioro nuevos e inesperados y deben documentarse sin retrasar el flujo de trabajo de inspección para recopilar datos de entrenamiento.
Tokens de Parche Densos para Segmentación
Las 196 incrustaciones de tokens de parche producidas por DINOv3 para una imagen de 224x224 forman una cuadrícula espacial de 14x14 de vectores de características de 768 dimensiones. Esta cuadrícula es la representación principal para tareas de predicción densa, segmentación semántica, detección de grietas y localización de defectos donde cada píxel en la imagen de entrada debe clasificarse.
Estructura y Resolución de la Cuadrícula. Para una entrada de 224x224 píxeles con parches de 16x16, cada uno de los 196 tokens de parche cubre una región de 16x16 píxeles de la entrada. La cuadrícula de 14x14 resultante tiene un paso de 16 píxeles entre los centros de parche adyacentes. Esto significa que el mapa de características de DINOv3 tiene aproximadamente 1/256 de la resolución espacial de la imagen de entrada (14x14 = 196 vs 224x224 = 50,176 píxeles). El mecanismo de autoatención compensa esta compresión espacial integrando información a través de los parches, cada incrustación de parche se informa por la cuadrícula de 14x14 circundante a través de la atención de múltiples cabezales, proporcionando una conciencia de contexto efectiva. Para tareas de segmentación, la cuadrícula de 14x14 debe aumentarse a la resolución de la imagen original. Un decodificador convolucional ligero con pocas capas es típico, y agrega solo una pequeña fracción del número de parámetros del backbone.
Calidad de Características Densas de DINOv3 vs DINOv2. La innovación crítica en DINOv3, el anclaje Gram, se dirige directamente a la calidad de estas características de parche densas. Durante ejecuciones de entrenamiento prolongadas, las características de parche de DINOv2 exhibirían lo que los autores describen como degradación de los mapas de características densas, las incrustaciones de parche se volverían menos significativas semánticamente, la estructura de similitud parche-parche se degradaría y la calidad de la segmentación se estancaría o incluso disminuiría a pesar de la mejora continua en la clasificación global. El anclaje Gram preserva la matriz Gram de las características de parche (estructura de similitud por pares) alineándola con una referencia del entrenamiento temprano, asegurando que las relaciones espaciales y semánticas entre los parches permanezcan estables. El resultado práctico es que las características de parche de DINOv3 permanecen nítidas y semánticamente coherentes incluso a altas resoluciones. El artículo de DINOv3 demuestra visualizaciones PCA de las características de parche de DINOv3 para imágenes aéreas de alta resolución, carreteras, edificios, vegetación y cuerpos de agua son claramente separables en el espacio de características, lo que demuestra una calidad de características excepcional para la comprensión de escenas.
Segmentación Semántica con Sondas Lineales. Una de las capacidades más impresionantes de DINOv3 es realizar la segmentación semántica utilizando solo sondas lineales en características de parche congeladas, no se requiere ajuste fino del backbone. Un cabezal de segmentación lineal aplica una convolución 1x1 (o equivalentemente, una capa lineal por parche) para mapear cada incrustación de parche de 768 dimensiones a C clases de salida. Esto produce un mapa de segmentación de 14x14, que se aumenta a la resolución de la imagen. A pesar de la simplicidad de este enfoque (solo 768 x C parámetros entrenables para todo el cabezal de segmentación), DINOv3 logra un 52.3% de mIoU en ADE20K con ViT-B, superando a muchos métodos que ajustan finamente todo el backbone. Esto es posible gracias a la excepcional separabilidad lineal de las características de parche de DINOv3, el espacio de incrustación ya está estructurado de tal manera que diferentes categorías semánticas ocupan regiones distintas y linealmente separables.
Segmentación de Grietas en Infraestructura. Los tokens de parche densos son muy adecuados para la segmentación de grietas a nivel de píxel en imágenes de pistas y pavimentos. La cuadrícula de 14x14 de incrustaciones de parche de 768 dimensiones captura tanto la textura local de la grieta (dentro de cada parche de 16x16) como la información contextual (a qué parches se conecta la grieta). El cabezal de segmentación es una red ligera con 3 capas convolucionales transpuestas que aumentan la resolución de la cuadrícula de características de 14x14 a 224x224. El entrenamiento requiere aproximadamente 500 imágenes de segmentación de grietas etiquetadas (mosaicos de 224x224 con máscaras de grietas a nivel de píxel) y converge en 2-3 horas en una sola GPU RTX 3060. Las comparaciones publicadas generalmente encuentran que los backbones de la familia DINO superan a los backbones tipo ResNet en la detección de grietas en condiciones de entrenamiento idénticas, y que el ajuste fino de DINOv3 con una resolución de entrada mayor mejora aún más el resultado.
Tokens de Registro para la Absorción de Fondo. Los 4 tokens de registro de DINOv3 juegan un papel específico en la calidad de las características densas. Estos tokens son tokens aprendibles adicionales (dimensión 768) que se anteponen a la secuencia junto con el token CLS. Durante la autoatención, los tokens de registro pueden atender y ser atendidos por todos los tokens de parche. La idea clave es que algunos parches visuales en una imagen contienen información atípica o de fondo, cielo, objetos distantes o regiones texturizadas uniformes que, si se vieran obligados a ser codificados por los tokens de parche, degradarían la calidad del espacio de características. Los tokens de registro actúan como ranuras de memoria absorbente que capturan este contenido no informativo, permitiendo que los tokens de parche se centren en regiones de imagen semánticamente significativas. El efecto práctico es una mejora medible en la calidad de las características densas, +1.8 mIoU en ADE20K y mapas de similitud de parche significativamente más limpios, especialmente para imágenes con grandes regiones de fondo uniforme. Para la inspección de infraestructura, donde las imágenes contienen con frecuencia grandes áreas de textura de pavimento uniforme, los tokens de registro ayudan a mantener características de parche limpias que se centran en patrones de deterioro en lugar de la textura de fondo.
Soporte MPS y GPU
La infraestructura de entrenamiento e inferencia de DINOv3 admite múltiples backends de hardware, desde grandes clústeres de GPU hasta dispositivos de borde y Macs con Apple Silicon.
Entrenamiento con GPU a Escala. El modelo profesor ViT-7B se entrenó en 256 GPUs NVIDIA A100 80GB SXM4 con interconexiones NVLink, proporcionando aproximadamente 20 TB/s de ancho de banda de memoria de GPU agregada y 25 PFLOPS de cómputo FP16. El entrenamiento utiliza FSDP (Datos Paralelos Completamente Fragmentados) , la estrategia de fragmentación nativa de PyTorch que divide los parámetros del modelo, los gradientes y los estados del optimizador en todas las GPUs. Con FSDP y entrenamiento de precisión mixta (BF16), el modelo de 7B cabe dentro de la memoria agregada de 256 GPUs (256 x 80GB = 20.48 TB) aunque cada GPU individual solo puede contener aproximadamente el 2-3% de los parámetros del modelo. La biblioteca xFormers (desarrollada por Meta AI) proporciona implementaciones de atención eficientes en memoria, incluyendo atención eficiente en memoria (reduce la memoria de atención de O(N^2) a O(N)) y patrones de atención dispersa por bloques. La combinación de FSDP, BF16, xFormers y el checkpointing de gradientes reduce el requisito de memoria por GPU para el ViT-7B de un estimado de 250GB (precisión completa, sin optimizaciones) a aproximadamente 65GB, dentro de la capacidad de 80GB de la A100.
Inferencia en una Sola GPU. Para la implementación práctica, DINOv3 ViT-B/16 (86M de parámetros) se ejecuta de manera eficiente en una sola GPU NVIDIA. Con precisión FP32, el modelo requiere aproximadamente 344MB de memoria para parámetros (86M x 4 bytes por flotante). Con activaciones para un tamaño de lote de 1 (imagen de 224x224), el uso total de memoria es de aproximadamente 1.2-1.5GB (parámetros + activaciones + tensores intermedios). Con precisión FP16, la memoria de parámetros se reduce a 172MB y el uso total a aproximadamente 0.8-1.0GB. Esto significa que DINOv3 ViT-B/16 se ejecuta cómodamente en GPUs con tan solo 4GB de VRAM, incluyendo tarjetas más antiguas como la NVIDIA GTX 1650 y la NVIDIA Jetson Xavier NX. El rendimiento en una RTX 3060 (12GB) a FP16 es de aproximadamente 100 imágenes/segundo. En una NVIDIA A100, el rendimiento supera las 400 imágenes/segundo, lo que permite el procesamiento en tiempo real de imágenes de dron 4K a velocidades de descomposición de mosaicos.
Soporte para Apple Silicon (MPS). DINOv3 es totalmente compatible con el backend MPS (Metal Performance Shaders) de Apple en PyTorch, proporcionando inferencia acelerada por GPU en Macs con Apple Silicon (series M1, M2, M3, M4). El backend MPS asigna las operaciones de PyTorch a la arquitectura de GPU de Apple a través del framework Metal. El rendimiento en un MacBook Pro M2 Pro (GPU de 19 núcleos, 32GB de memoria unificada) alcanza aproximadamente 25-35 imágenes/segundo para ViT-B/16 con precisión FP16, suficiente para el procesamiento por lotes de grandes colecciones de imágenes. En un Mac Studio M2 Ultra (GPU de 76 núcleos, 192GB de memoria unificada), el rendimiento alcanza aproximadamente 70-90 imágenes/segundo. El uso de memoria es eficiente porque la arquitectura de memoria unificada de Apple elimina la sobrecarga de transferencia de datos CPU-GPU. DINOv3 acelerado por MPS permite a los inspectores ejecutar la inferencia directamente en un MacBook en el campo sin hardware de GPU dedicado. La memoria unificada más grande de Apple Silicon (hasta 192GB en M2 Ultra) también permite el procesamiento de imágenes de muy alta resolución sin necesidad de dividirlas en mosaicos, una imagen de 4096x4096 produce 256x256 parches = 65,536 tokens, lo que requiere aproximadamente 8GB de memoria equivalente a VRAM en el grupo de memoria unificada.
Inferencia Distribuida. Para proyectos de inspección de infraestructura a gran escala que procesan millones de imágenes, es necesaria la inferencia distribuida en múltiples GPUs o máquinas. DINOv3 admite PyTorch DistributedDataParallel (DDP) para inferencia multi-GPU en un solo servidor, paralelismo de modelo (paralelismo de pipeline para ViT-7B) y Ray (un framework de computación distribuida de código abierto) para inferencia distribuida multi-nodo. Las implementaciones a gran escala comúnmente utilizan Kubernetes con grupos de nodos GPU que ejecutan la inferencia de DINOv3 como un microservicio escalable. Cada pod de inferencia se ejecuta en una sola GPU T4 (16GB VRAM) y procesa aproximadamente 70 imágenes/segundo. Un clúster de 50 pods logra un rendimiento de 3,500 imágenes/segundo, lo que permite procesar un estudio de pista de 500 imágenes en menos de 3 segundos. El servidor de inferencia utiliza TorchServe para el servicio del modelo con agrupación dinámica (tamaños de lote de 4-16 dependiendo del volumen de solicitudes) y precisión FP16 para maximizar el rendimiento.
Implementación en el Borde con NVIDIA Jetson. Para sistemas de inspección implementados en el campo que utilizan drones o vehículos terrestres, DINOv3 ViT-B/16 se puede implementar en dispositivos de borde NVIDIA Jetson. El módulo Jetson Orin NX 16GB (100 TOPS de rendimiento de IA) logra 15-25 imágenes/segundo con DINOv3 ViT-B/16 a FP16, dependiendo del modo de energía (15W vs 25W vs 40W). El modelo se optimiza utilizando TensorRT, el optimizador de inferencia de aprendizaje profundo de NVIDIA, que fusiona capas, optimiza la selección de kernels y cuantifica a FP16 o INT8. Con la cuantificación TensorRT INT8, la velocidad de inferencia aumenta a 30-40 imágenes/segundo en Jetson Orin NX con una degradación de precisión inferior al 1% en comparación con FP32. El Jetson Xavier NX (21 TOPS) logra 8-12 imágenes/segundo con TensorRT FP16. Esta implementación en el borde permite la detección de grietas en tiempo real durante el vuelo del dron, la cámara del dron captura imágenes, y DINOv3 las procesa a bordo, marcando posibles defectos en segundos después de la captura sin requerir una conexión a la nube.
Disponibilidad de Código Abierto y Licencias
DINOv3 fue lanzado por Meta AI en 2025 como un proyecto de código abierto, continuando la tradición de la compañía de publicar públicamente modelos de investigación de IA de última generación. Comprender los términos de licencia y distribución es esencial para las organizaciones que planean implementar DINOv3 en productos comerciales.
Código y Pesos del Modelo. La base de código completa de DINOv3 está disponible en GitHub en facebookresearch/dinov3 (más de 10,700 estrellas a mediados de 2025). El repositorio incluye el código completo de entrenamiento y evaluación (PyTorch), definiciones de modelos, pipelines de procesamiento de datos, scripts de evaluación y pesos preentrenados para las 12 variantes de modelo lanzadas. Los pesos del modelo también están disponibles en Hugging Face Hub bajo el espacio de nombres facebook/dinov3-*, incluyendo: facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M de parámetros) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M de parámetros) el modelo base comúnmente utilizado facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M de parámetros) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1.5B de parámetros) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B de parámetros) Además de variantes ConvNeXt (T, S, B, L) y modelos específicos para satélites (SAT-493M)
El acceso a Hugging Face requiere que los usuarios acepten los términos de Meta y proporcionen información de contacto, que se recopila, almacena y procesa de acuerdo con la Política de Privacidad de Meta. Los pesos del modelo se distribuyen como archivos state_dict de PyTorch compatibles con la biblioteca Hugging Face Transformers (integración disponible a través de AutoModel.from_pretrained()).
La Licencia DINOv3. DINOv3 se lanza bajo la Licencia DINOv3, una licencia de código abierto personalizada desarrollada por Meta AI específicamente para este lanzamiento de modelo. Esto difiere de DINOv2, que se lanzó bajo la licencia Apache 2.0 estándar. La Licencia DINOv3 permite: Uso, reproducción, modificación y distribución del modelo y código Uso comercial, incluyendo la integración en productos y servicios Sublicenciamiento de trabajos derivados bajo términos diferentes
La Licencia DINOv3 incluye requisitos de atribución específicos (debe conservar los avisos de derechos de autor) y una política de uso aceptable que prohíbe usar el modelo para ciertos fines, incluyendo la vigilancia que viola los derechos humanos, armas autónomas y la violación de las leyes aplicables. La licencia ha generado discusión en la comunidad de desarrolladores, el problema #31 en el repositorio de dinov3 solicita específicamente el lanzamiento bajo una licencia más estándar como Apache 2.0 para simplificar el cumplimiento legal para las empresas con políticas de licencia de código abierto establecidas. Los lectores deben revisar los términos de la licencia en relación con su propio caso de uso.
Comparación de Licencias con Otros Backbones.
| Backbone | Licencia | Uso Comercial | Atribución Requerida | Términos Personalizados |
|---|---|---|---|---|
| DINOv3 | Licencia DINOv3 | Sí | Sí | Sí |
| DINOv2 | Apache 2.0 | Sí | Sí | No |
| ViT (Google) | Apache 2.0 | Sí | Sí | No |
| CLIP (OpenAI) | MIT | Sí | Sí | No |
| OpenCLIP | MIT | Sí | Sí | No |
| SAM (Meta) | Apache 2.0 | Sí | Sí | No |
| ConvNeXt | MIT | Sí | Sí | No |
Costo Computacional de Reproducción. El costo de entrenamiento de DINOv3 ViT-7B se estima en $2-5 millones de USD (aproximadamente 15,000 días de GPU en A100-80GB a precios de nube bajo demanda). Los modelos más pequeños destilados (ViT-B, ViT-L) son significativamente más baratos de reproducir, pero aún requieren un cómputo sustancial, la destilación de ViT-Base desde ViT-7B en LVD-1689M requiere aproximadamente 500-800 días de GPU. Sin embargo, para los profesionales, la disponibilidad de pesos preentrenados elimina la necesidad de cualquier cómputo de entrenamiento, los pesos se pueden descargar y usar inmediatamente para la inferencia al costo de una sola GPU de cualquier generación. Esta accesibilidad es la propuesta de valor fundamental de los modelos fundacionales, el enorme costo de entrenamiento se amortiza entre todos los usuarios posteriores.
Integración con la Comunidad y el Ecosistema. DINOv3 se beneficia de una amplia integración en el ecosistema, Hugging Face Transformers proporciona una API de plug-and-play, PyTorch Hub admite la carga de modelos a través de torch.hub.load(), y el modelo está incluido en el zoológico de modelos de Torchvision para un acceso sencillo. La integración con Weights & Biases, MLflow y Neptune.ai para el seguimiento de experimentos se admite a través de hooks estándar de PyTorch. La exportación al formato ONNX (Open Neural Network Exchange) es compatible para la implementación en entornos que no son PyTorch, incluyendo TensorRT para dispositivos de borde NVIDIA, CoreML para dispositivos Apple y TFLite para implementación móvil. DINOv3 se integra a través del pipeline de Hugging Face Transformers, con optimización TensorRT para la implementación en el borde en Jetson Orin NX y aceleración MPS para laptops macOS.
Conclusión. DINOv3 representa un salto generacional en los modelos base de visión auto-supervisada, logrando un rendimiento de última generación en tareas de predicción global y densa a través de una escala sin precedentes (1.689 mil millones de imágenes, 7 mil millones de parámetros) y la innovación del anclaje Gram que preserva la calidad de las características densas. Para el análisis de superficies de infraestructura, la variante ViT-B/16 de DINOv3 proporciona un espacio de incrustación de 768 dimensiones con una estructura semántica excepcional, los tipos de superficie, los patrones de grietas y las características de los defectos son linealmente separables en el espacio de incrustación, lo que permite una clasificación y detección precisas con inferencia de backbone congelado. La disponibilidad de código abierto, el amplio soporte de hardware (GPU, MPS, Edge) y la licencia permisiva hacen de DINOv3 un backbone sólido para la inspección automatizada de infraestructura, con modestos requisitos de datos de entrenamiento específicos del dominio y computacionales.
Preguntas Frecuentes
- ¿Cuál es la diferencia entre DINOv3 y DINOv2?
- DINOv3 representa un salto de escalado significativo sobre DINOv2 en múltiples dimensiones. Primero, datos de entrenamiento: DINOv2 se entrenó en 142 millones de imágenes seleccionadas (LVD-142M), mientras que DINOv3 escala a 1.689 mil millones de imágenes (LVD-1689M), un aumento de 12x. Segundo, tamaño del modelo: el modelo profesor más grande de DINOv2 tenía 1 mil millones de parámetros (ViT-g), mientras que DINOv3 entrena un profesor de 7 mil millones de parámetros (ViT-7B). Tercero, tamaño del parche: DINOv2 usó un tamaño de parche de 14 píxeles, produciendo 256 tokens de parche por imagen de 224x224, DINOv3 usa un tamaño de parche de 16 píxeles, produciendo 196 tokens de parche. Cuarto, embeddings posicionales: DINOv2 usó codificaciones posicionales aprendidas estándar, mientras que DINOv3 introduce Embeddings Posicionales Rotatorios (RoPE) con fluctuación aleatoria de caja para una mejor resistencia a la relación de aspecto. Quinto, la innovación clave del anclaje Gram en DINOv3 preserva la calidad del mapa de características densas durante programas de entrenamiento prolongados, un problema que causaba que las características de parche de DINOv2 se degradaran con el entrenamiento extendido. Sexto, DINOv3 logra una mejora de +6 mIoU en la segmentación semántica ADE20K, +6.7 J y F-Mean en el seguimiento de video, y +10.9 GAP en la recuperación de instancias en comparación con DINOv2.
- ¿Cómo se puede usar DINOv3 para el análisis de superficies de infraestructura?
- El backbone ViT-B/16 de DINOv3 puede servir como el motor principal de extracción de características en un pipeline de inspección de infraestructura. Cuando un dron o cámara captura una imagen de la superficie de una pista, tablero de un puente o pavimento de una carretera, la imagen se redimensiona a 224x224 píxeles y se divide en 196 parches de 16x16 que no se superponen. Cada parche se incrusta linealmente en un vector de 768 dimensiones y, junto con el token CLS, estos pasan a través de 12 capas de codificador de transformador con autoatención de múltiples cabezales. La incrustación del token CLS de 768 dimensiones resultante captura las características globales de la superficie utilizadas para clasificar el tipo de superficie (asfalto, hormigón, sello de grietas, etc.) y el grado de calidad general. Simultáneamente, las 196 incrustaciones de tokens de parche (cada una de 768 dimensiones) codifican información de textura localizada a nivel de parche, lo que respalda la detección de grietas a nivel de píxel y otras tareas de predicción densa. El enfoque de backbone congelado significa que los pesos de DINOv3 permanecen fijos mientras que cabezales ligeros específicos de la tarea (sondas lineales o MLP poco profundos) se entrenan en conjuntos de datos de infraestructura etiquetados. Esto reduce los costos de entrenamiento en aproximadamente un 90% en comparación con el ajuste fino completo, al tiempo que logra una precisión de detección de defectos de última generación.
- ¿Qué hardware se requiere para ejecutar la inferencia de DINOv3?
- DINOv3 ofrece modelos en una gama de tamaños para adaptarse a diferentes restricciones de hardware. La variante ViT-B/16 (86 millones de parámetros) se ejecuta de manera eficiente en una sola GPU NVIDIA con al menos 8 GB de VRAM, logrando velocidades de inferencia de 50-100 fotogramas por segundo en una RTX 3060 o superior. En Macs con Apple Silicon (M1/M2/M3), el backend MPS (Metal Performance Shaders) proporciona inferencia acelerada por hardware a aproximadamente 20-40 FPS en un M2 Pro. Para implementaciones en el borde, la variante destilada ViT-Small (21M de parámetros) se ejecuta en NVIDIA Jetson Orin NX a 15-30 FPS. La variante más grande, ViT-7B, requiere 4-8 GPUs NVIDIA A100 (80GB) para la inferencia. DINOv3 admite inferencia de precisión mixta (FP16) que reduce el consumo de memoria en aproximadamente un 50% con una pérdida de precisión insignificante. El modelo está disponible en PyTorch a través de Hugging Face Transformers, siendo el punto de control facebook/dinov3-vitb16-pretrain-lvd1689m el punto de entrada estándar.
- ¿Qué es el anclaje Gram en DINOv3?
- El anclaje Gram es una técnica de regularización novedosa introducida en DINOv3 para resolver la degradación de los mapas de características densas durante programas de entrenamiento auto-supervisado prolongados. Durante el entrenamiento extendido al estilo DINOv2 con modelos grandes (ViT-L y superiores), se observó que las características a nivel de parche perdían su estructura espacial y significado semántico, la precisión de la sonda lineal en tareas globales mejoraba, pero los mapas de características de parche se volvían ruidosos y perdían la capacidad de localización. El anclaje Gram introduce un término de pérdida L2 adicional que alinea la matriz Gram de las características de parche del estudiante con una matriz Gram congelada de una instantánea EMA temprana del profesor. Específicamente, dada la matriz de parche del estudiante normalizada L2 X_S y una matriz Gram del profesor X_G (una instantánea EMA temprana), la pérdida es L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Esta pérdida preserva la estructura de similitud de pares de parches en lugar de imponer posiciones absolutas de características, actuando como un regularizador espacial. Integrado después de 1M de iteraciones de preentrenamiento con un peso de 2 y actualizaciones del profesor cada 10k pasos, el anclaje Gram produce una mejora de +2 mIoU en la segmentación ADE20K y un mejor RMSE de estimación de profundidad sin degradación de las métricas globales.
- ¿Cómo se utilizan las incrustaciones de 768 dimensiones de DINOv3 para la detección de defectos superficiales?
- La variante ViT-B/16 de DINOv3 produce una incrustación de 768 dimensiones para cada uno de los 196 parches más un token CLS por imagen de 224x224. Para el análisis de superficies de infraestructura, estas incrustaciones sirven para dos propósitos distintos. Para la clasificación global (tipo de superficie, calificación de calidad general), la incrustación del token CLS se introduce en un clasificador lineal ligero o un cabezal MLP de 2 capas que asigna 768 dimensiones a N clases de salida. Para tareas de predicción densa (segmentación de grietas a nivel de píxel), las 196 incrustaciones de tokens de parche forman una cuadrícula espacial de 14x14 de vectores de 768 dimensiones. Esta cuadrícula se pasa a través de un cabezal de segmentación (típicamente un decodificador convolucional ligero con 1-3 capas) que aumenta la resolución del mapa de características de 14x14 a la resolución original de 224x224. La incrustación de cada píxel se puede comparar con prototipos de defectos utilizando la similitud del coseno, los parches con incrustaciones cercanas a los prototipos de grietas (establecidos a través de ejemplos de pocas tomas) se marcan como defectos.
Esta es una entrada de referencia. TarmacView proporciona servicios de inspección con drones y no vende los equipos ni materiales descritos en este glosario.