¿Qué es la Adaptación de Dominio para Modelos de Inspección entre Superficies?
Guía Técnica Completa sobre Adaptación de Dominio para Modelos de Inspección entre Superficies
Definición y el Problema del Desplazamiento de Dominio
La adaptación de dominio es una subcategoría del aprendizaje por transferencia que aborda un desafío fundamental en la implementación de modelos de aprendizaje automático, el desajuste estadístico entre los datos de entrenamiento y los datos de implementación. Cuando un modelo entrenado en un dominio de origen, un conjunto de datos con características conocidas y, por lo general, abundantes ejemplos etiquetados, se implementa en un dominio objetivo con propiedades estadísticas diferentes, el rendimiento se degrada. La adaptación de dominio proporciona métodos para salvar esta brecha, lo que permite que los modelos generalicen entre dominios sin tener que recopilar y etiquetar grandes conjuntos de datos nuevos para cada entorno de implementación.
Formalmente, un dominio se define como un par que consiste en un espacio de características (X) y una distribución de probabilidad (P(X)) sobre ese espacio, (D = {X, P(X)}). Una tarea es un par que consiste en un espacio de etiquetas (Y) y una función predictiva (f: X \to Y). El dominio de origen (D_S) es el dominio en el que el modelo se entrena originalmente con abundantes datos etiquetados. El dominio objetivo (D_T) es el nuevo dominio donde el modelo debe funcionar, a menudo con etiquetas limitadas o nulas. El objetivo de la adaptación de dominio es aprender una función (f_T: X_T \to Y_T) para el dominio objetivo aprovechando el conocimiento del dominio de origen, a pesar del desajuste (P_S(X) \neq P_T(X)).
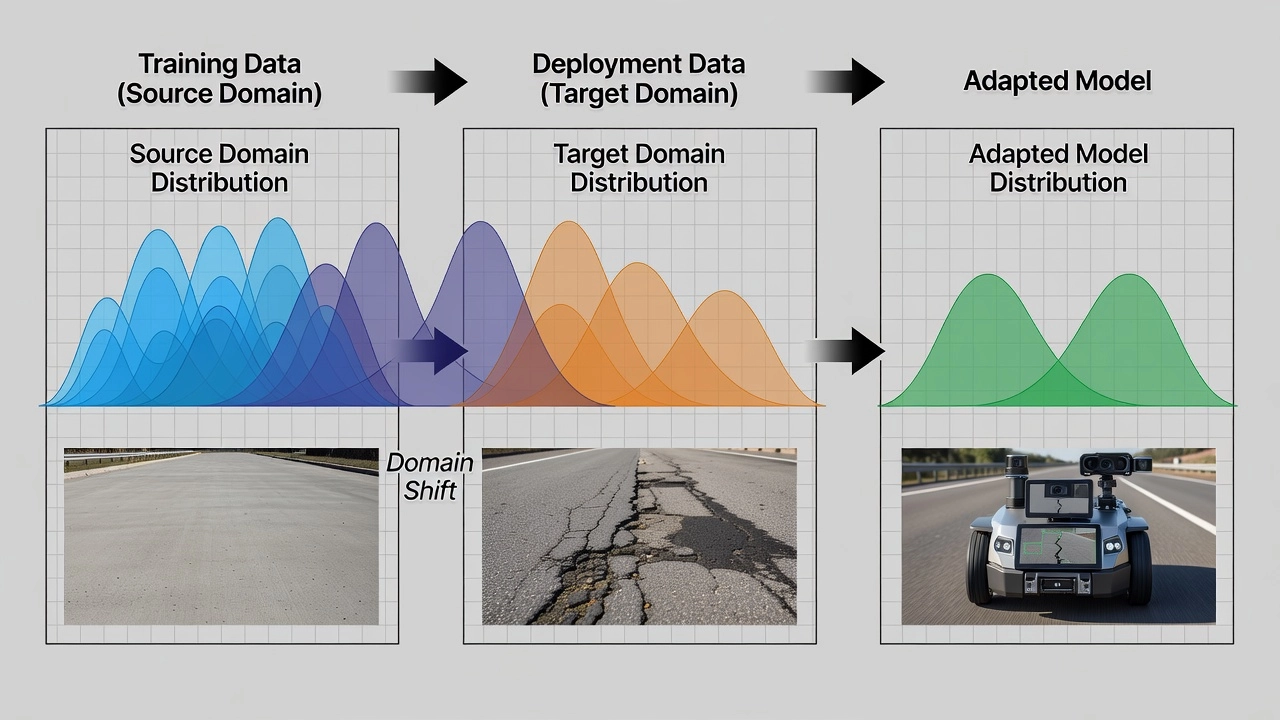
El desplazamiento de dominio (también llamado desplazamiento de distribución o desplazamiento de conjunto de datos) es el fenómeno en el que la distribución de datos difiere entre los entornos de entrenamiento e implementación. Cuando ocurre un desplazamiento de dominio, el rendimiento del modelo se degrada porque la asignación aprendida de entradas a salidas ya no coincide con las condiciones objetivo. El desplazamiento de dominio se manifiesta de tres formas principales. El desplazamiento de covariable ocurre cuando la distribución de las características de entrada cambia mientras que la distribución condicional de las etiquetas dadas las entradas permanece igual, formalmente, (P_S(X) \neq P_T(X)) pero (P_S(Y|X) = P_T(Y|X)). Esta es la forma más común en visión artificial, la apariencia visual de una grieta en el asfalto difiere de una grieta en el concreto, pero la asignación de las características visuales a la etiqueta “grietado” sigue siendo consistente. El desplazamiento de etiqueta (o desplazamiento previo) ocurre cuando la distribución de las etiquetas de clase cambia, (P_S(Y) \neq P_T(Y)) pero (P_S(X|Y) = P_T(X|Y)). Esto sucede cuando la densidad de grietas difiere entre los sitios de entrenamiento e implementación. El desplazamiento de concepto ocurre cuando la relación entre las entradas y las salidas cambia, (P_S(Y|X) \neq P_T(Y|X)), por ejemplo, cuando un patrón visual que indica una grieta sellada en carreteras indica un defecto estructural en las pistas.
Para la visión artificial en la inspección de infraestructuras, el desplazamiento de dominio surge de múltiples factores que se combinan. Las diferencias de apariencia visual incluyen la textura del pavimento (asfalto rugoso vs. concreto liso), los perfiles de color (asfalto gris oscuro vs. concreto gris claro) y los patrones de envejecimiento (superficie oxidada vs. recién pavimentada). Las condiciones de captura como la iluminación (luz solar directa con un ángulo de 60° vs. luz difusa nublada), la resolución de la cámara y la sensibilidad espectral del sensor, y el ángulo de captura de la imagen (nadir desde UAV vs. oblicuo desde un vehículo) contribuyen a cambios distribucionales significativos. Los factores ambientales incluyendo superficies mojadas vs. secas, la oclusión de sombras de estructuras y los desechos estacionales (hojas, nieve, agua estancada) agravan aún más el problema. Las diferencias en el material de la superficie entre asfalto y concreto, o entre superficies envejecidas y recién pavimentadas, representan uno de los desplazamientos de dominio más desafiantes para los modelos de inspección de pavimentos.
La investigación ha documentado cuantitativamente la gravedad del desplazamiento de dominio en la detección de grietas en pavimentos. El marco DDACRN informó que, sin adaptación de dominio, la Intersección sobre la Unión media (mIoU) de la detección de grietas cae de 0.72 en los datos de prueba de origen a 0.31 en los datos objetivo entre conjuntos de datos, una reducción del 57% en el rendimiento. DACrack demostró que la mitigación del desplazamiento de dominio mediante la alineación de características multinivel recupera aproximadamente 20 puntos porcentuales en la puntuación F1 en transferencias entre conjuntos de datos. Estos resultados empíricos subrayan por qué la adaptación de dominio no es simplemente un refinamiento académico sino una necesidad operativa para cualquier sistema de inspección implementado en múltiples aeropuertos, carreteras o redes de puentes.
Desplazamiento de Dominio en Imágenes de Infraestructura
Las imágenes de inspección de infraestructura están sujetas a múltiples fuentes de desplazamiento de dominio que interactúan y se combinan entre sí. Comprender cada fuente es esencial para diseñar estrategias de adaptación efectivas.
El desplazamiento del material de la superficie es el desplazamiento de dominio más prominente en la inspección de infraestructuras. Los pavimentos de asfalto y concreto tienen características visuales fundamentalmente diferentes. El asfalto es de color gris oscuro a negro, tiene una textura superficial gruesa e irregular, y las grietas suelen aparecer como características lineales brillantes sobre el fondo oscuro. El concreto es de color gris claro a blanco, tiene una superficie más lisa y uniforme, y las grietas aparecen como líneas oscuras. Estas diferencias significan que una red neuronal convolucional entrenada en un tipo de superficie aprende filtros y representaciones de características específicas de las estadísticas visuales de esa superficie. Cuando se aplica al otro tipo de superficie, estos filtros producen activaciones de características que las capas clasificadoras no pueden interpretar correctamente. Los datos de DDACRN muestran que la mIoU entre superficies cae de 0.72 a 0.31 sin adaptación al transferir modelos entrenados en asfalto a modelos probados en concreto.
La variación de la morfología de las grietas introduce otra capa de desplazamiento de dominio. Diferentes tipos de deterioro del pavimento tienen firmas visuales distintas. Las grietas longitudinales corren paralelas al eje de la carretera y aparecen como características lineales largas y continuas. Las grietas transversales corren perpendiculares al eje. Las grietas por fatiga (piel de cocodrilo) forman redes interconectadas de pequeños polígonos que se asemejan a la piel de cocodrilo. Las grietas capilares miden menos de 1 mm de ancho y pueden ser apenas visibles, mientras que las grietas anchas superan los 5 mm y son fácilmente identificables. Las grietas selladas rellenas con material sellador tienen una apariencia visual diferente a las grietas sin sellar. Un modelo entrenado predominantemente en grietas longitudinales puede no detectar grietas por fatiga en un dominio objetivo donde ese tipo de deterioro es más prevalente.
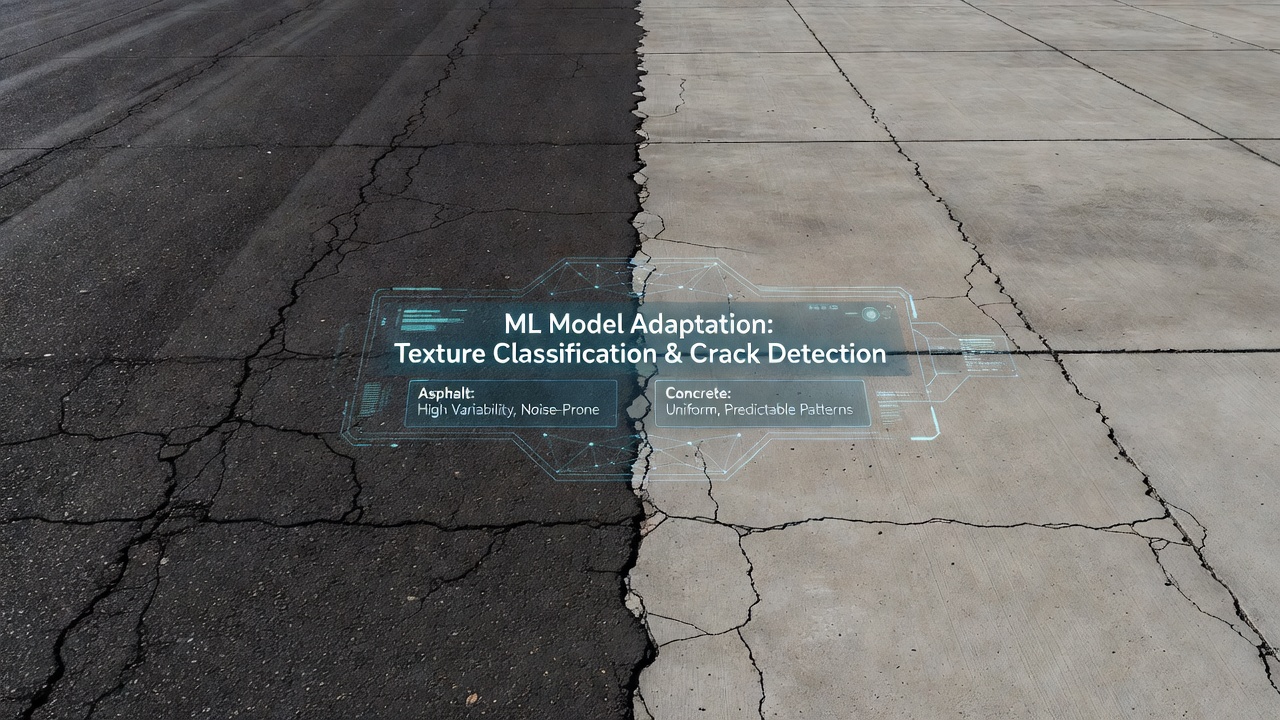
El desplazamiento de condiciones de iluminación afecta significativamente el rendimiento del modelo. Los modelos entrenados en imágenes diurnas bien iluminadas capturadas bajo luz solar directa fallan en imágenes con poca luz o al atardecer, imágenes con sombras intensas proyectadas por estructuras o árboles, e imágenes capturadas bajo condiciones nubladas donde la iluminación difusa reduce el contraste. El ángulo de la luz incidente con respecto a la normal de la superficie cambia la apariencia de los bordes de las grietas, la luz solar con un ángulo bajo enfatiza la textura de la superficie al proyectar sombras dentro de las grietas, mientras que la luz solar cenital con un ángulo alto minimiza la visibilidad de las grietas. La oclusión por sombras de superestructuras de puentes, terminales de aeropuertos o estructuras cercanas produce regiones oscuras localizadas donde las características de las grietas se suprimen. Los estudios han documentado caídas de precisión del 5–12% en los modelos de detección de grietas cuando las condiciones de iluminación se desvían de la distribución de entrenamiento.
El desplazamiento de cámara y sensor surge de las diferencias en el hardware de imagen. Diferentes cámaras producen diferentes resoluciones de imagen (12 MP de teléfono inteligente vs. 50 MP de DSLR vs. cámara industrial especializada), diferentes perfiles de color y curvas de sensibilidad espectral del sensor, diferentes características de distorsión de la lente y diferentes patrones de ruido. Para la inspección basada en UAV, la altitud de vuelo determina la Distancia de Muestreo en el Suelo (GSD), la distancia física en el suelo representada por cada píxel. Un UAV que vuela a 30 m produce aproximadamente 0.5–1 cm/píxel de GSD, mientras que uno a 100 m produce 2–5 cm/píxel. Las diferencias en GSD significan que la misma grieta está representada por diferentes números de píxeles y diferente contenido de frecuencia espacial en los dominios de origen y destino. El ajuste fino con el recálculo de las estadísticas de Normalización por Lotes (BN) suele ser suficiente para desplazamientos de cámara moderados, mientras que los desplazamientos severos requieren una alineación adversarial de dominio en múltiples niveles de características.
El desplazamiento estacional y ambiental introduce una variación de dominio temporal. Un modelo entrenado en imágenes de verano debe funcionar en condiciones invernales donde las superficies pueden estar mojadas, cubiertas de nieve o parcialmente ocultas por hojas caídas. Las superficies de pavimento sufren envejecimiento y oxidación con el tiempo, cambiando su color y textura. El Formato de Notificación Mundial (GRF) de la FAA y la OACI reconoce explícitamente la condición ambiental como una variable que afecta la evaluación de la superficie de la pista, las superficies secas, mojadas, mojadas resbaladizas y contaminadas representan cada una dominios visuales distintos que requieren una interpretación de inspección diferente.
| Fuente de Desplazamiento de Dominio | Impacto Típico en el Rendimiento | Estrategia de Mitigación Principal |
|---|---|---|
| Material de la superficie (asfalto vs. concreto) | Caída de mIoU del 30–45% | DA adversarial + alineación de características multinivel |
| Condición de iluminación (soleado vs. nublado) | Caída de precisión del 5–12% | Adaptación BN + aumento fotométrico |
| Resolución / sensor de cámara | Caída de precisión del 3–8% | Ajuste fino + recálculo de estadísticas BN |
| Estacional / ambiental | Caída de precisión del 8–20% | Traducción generativa de dominio (CycleGAN) |
| Geográfico / regional | Caída de precisión del 10–25% | UDA de múltiples fuentes + puente de dominio progresivo |
Ajuste Fino para la Adaptación de Dominio
El ajuste fino es la estrategia de adaptación de dominio más simple y más utilizada. Implica tomar una red neuronal preentrenada en el dominio de origen y continuar el proceso de entrenamiento en datos del dominio objetivo, actualizando los pesos del modelo para alinear sus representaciones con la distribución objetivo. El ajuste fino tiende un puente entre el aprendizaje por transferencia (donde la tarea cambia) y la adaptación de dominio (donde la tarea sigue siendo la misma pero la distribución de datos cambia).
El fundamento teórico del ajuste fino se basa en la observación de que las redes neuronales aprenden representaciones de características jerárquicas. Las capas tempranas capturan características de bajo nivel como bordes, texturas y manchas de color que son en gran medida independientes del dominio. Las capas intermedias combinan estas en patrones de nivel medio como bordes de grietas, grano de la superficie y límites de juntas. Las capas tardías aprenden características específicas de la tarea optimizadas para el objetivo de clasificación o segmentación. Cuando el dominio cambia, las estadísticas de bajo nivel (distribuciones de color, frecuencias de textura, características de contraste) cambian, y las capas posteriores que están finamente ajustadas a las distribuciones de características del dominio de origen pierden su alineación.
El ajuste fino completo actualiza todos los parámetros del modelo con datos objetivo. Esto es apropiado cuando hay abundantes datos objetivo etiquetados disponibles (cientos a miles de imágenes) y los recursos computacionales permiten actualizaciones de gradiente completas. La tasa de aprendizaje generalmente se reduce en un factor de 10 en relación con el preentrenamiento inicial para evitar el olvido catastrófico, el fenómeno en el que el modelo sobrescribe el conocimiento útil del dominio de origen. La detención temprana basada en la pérdida de validación objetivo es esencial para equilibrar la retención del conocimiento del origen con la adaptación al objetivo.
El ajuste de la última capa (clasificador) congela todas las capas de extracción de características y entrena solo el cabezal de clasificación o segmentación final. Este enfoque supone que el extractor de características aprendido en el dominio de origen produce representaciones que son suficientemente generales, y solo la asignación de características a etiquetas necesita ajuste. El ajuste de la última capa es efectivo cuando hay muy pocos datos objetivo disponibles (decenas de imágenes) y el desplazamiento de dominio está principalmente en el espacio de etiquetas en lugar del espacio de características. Requiere un cálculo mínimo y es resistente al olvido catastrófico.
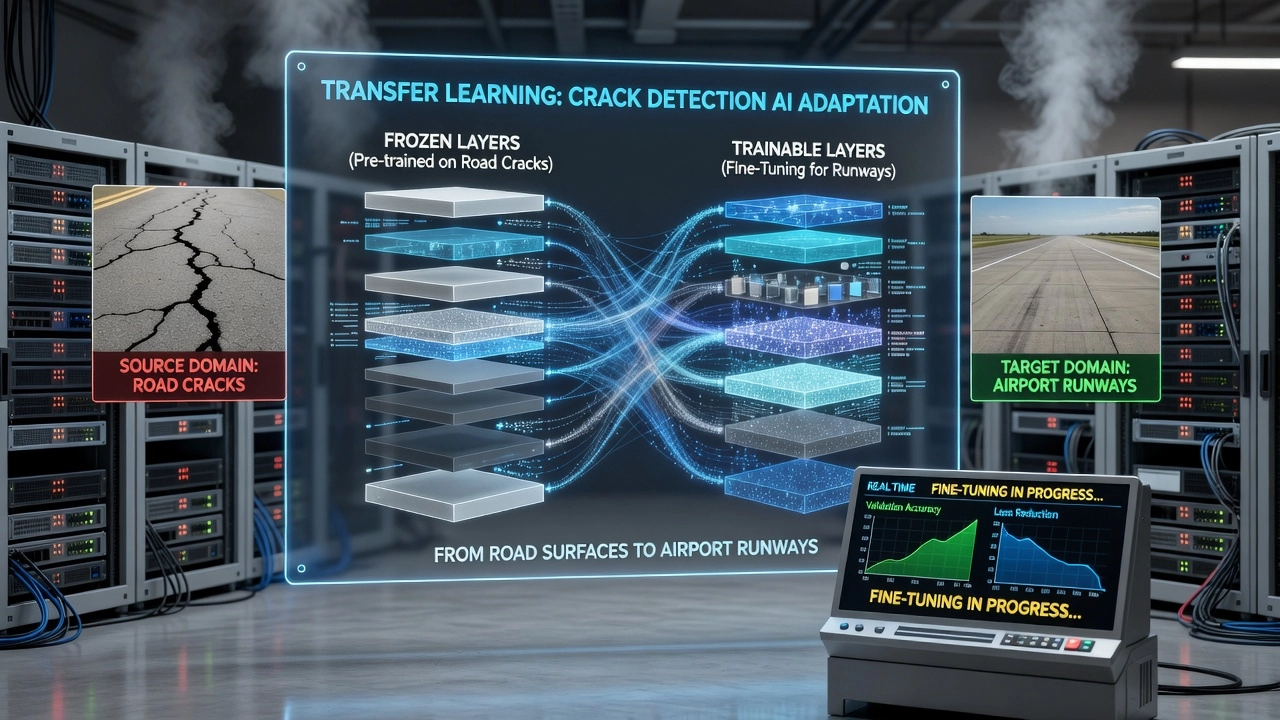
El descongelamiento progresivo proporciona un término medio. El proceso de entrenamiento comienza con todas las capas congeladas excepto el clasificador final, que se entrena durante varias épocas. Luego, las capas de extracción de características superiores se descongelan y se entrenan junto con el clasificador. Este proceso continúa, descongelando gradualmente las capas de arriba a abajo, hasta que todas las capas se están ajustando o se alcanza una meseta en el rendimiento. El descongelamiento progresivo es apropiado para cantidades moderadas de datos objetivo (cientos de imágenes) y desplazamientos de dominio que afectan múltiples niveles de la jerarquía de características.
Los módulos adaptadores introducen pequeñas capas de cuello de botella con significativamente menos parámetros que la red completa. Estos adaptadores se insertan entre las capas de un backbone preentrenado congelado y son los únicos parámetros actualizados durante el ajuste fino. El ajuste fino basado en adaptadores es altamente eficiente en parámetros, típicamente del 1–5% del número total de parámetros, y permite un cambio rápido entre múltiples dominios objetivo almacenando y cargando diferentes pesos de adaptador. Para las redes de inspección de infraestructura con millones de parámetros, los módulos adaptadores permiten la implementación en docenas de aeropuertos sin almacenar copias de peso completo separadas para cada uno.
La adaptación de Normalización por Lotes (BN) es una técnica notablemente liviana pero efectiva. Las capas BN calculan estadísticas de media y varianza en ejecución durante el entrenamiento para normalizar los mapas de características intermedias. Cuando el dominio cambia, estas estadísticas ya no representan con precisión la distribución objetivo. La adaptación BN simplemente recalcula las estadísticas BN pasando datos del dominio objetivo a través de la red con pesos congelados, actualizando la media y la varianza en ejecución sin ninguna actualización de gradiente. Esto por sí solo puede reducir significativamente el desplazamiento de dominio cuando la diferencia principal está en las estadísticas de imagen de bajo nivel como el brillo, el contraste y la distribución de color. Los estudios sobre detección de grietas muestran que la adaptación BN recupera del 3 al 8% de las caídas de precisión causadas por desplazamientos moderados de iluminación y cámara, requiriendo solo una sola pasada hacia adelante de datos objetivo no etiquetados.
| Estrategia de Ajuste Fino | Datos Objetivo Requeridos | Parámetros Actualizados | Riesgo de Olvido Catastrófico | Mejor Caso de Uso |
|---|---|---|---|---|
| Recálculo de estadísticas BN | Ninguno (no etiquetados) | 0 (solo estadísticas BN) | Ninguno | Desplazamientos de iluminación / cámara |
| Ajuste de la última capa | 10–50 etiquetados | < 1% | Muy bajo | Distribución de características preservada |
| Módulos adaptadores | 50–200 etiquetados | 1–5% | Bajo | Implementación en múltiples dominios |
| Descongelamiento progresivo | 100–500 etiquetados | Gradual, 10–100% | Moderado | Desplazamiento de dominio moderado |
| Ajuste fino completo | 500+ etiquetados | 100% | Alto | Abundantes datos objetivo, gran desplazamiento |
Adaptación de Dominio Supervisada
La adaptación de dominio supervisada (SDA) opera bajo el supuesto de que una pequeña cantidad de datos etiquetados está disponible en el dominio objetivo junto con abundantes datos de origen etiquetados. Esta es la configuración más directa, el modelo tiene acceso directo a información de verdad fundamental sobre el dominio objetivo, lo que permite una optimización explícita para el rendimiento objetivo.
El enfoque SDA estándar tiene dos componentes. Primero, el modelo se preentrena en el dominio de origen con sus etiquetas abundantes, esto establece un conocimiento general sobre la tarea de inspección, aprendiendo a reconocer bordes de grietas, límites de juntas, texturas de superficie y geometrías de defectos. Segundo, el modelo se ajusta finamente en los datos objetivo etiquetados utilizando una tasa de aprendizaje sustancialmente reducida. Durante el ajuste fino, la función de pérdida típicamente combina pérdidas de origen y objetivo para evitar que el modelo olvide el conocimiento útil del dominio de origen. La pérdida combinada se expresa como:
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
donde (\mathcal{L}_S) es la pérdida de origen calculada en los datos de origen, (\mathcal{L}_T) es la pérdida objetivo calculada en los datos objetivo etiquetados, y (\lambda) controla la contribución relativa de cada dominio. Durante el entrenamiento, los lotes de origen y objetivo se alimentan alternativamente o conjuntamente a través de la red.
Las técnicas clave para la adaptación de dominio supervisada incluyen funciones de pérdida ponderadas que dan mayor importancia a las muestras del dominio objetivo durante el ajuste fino, entrenamiento conjunto donde los datos etiquetados de origen y objetivo se mezclan en cada lote de entrenamiento, y entrenamiento adversarial de dominio donde se agrega un clasificador de dominio incluso en el entorno supervisado para alentar al extractor de características a aprender representaciones invariantes de dominio. Las estrategias de aprendizaje curricular comienzan con un entrenamiento dominado por el origen y cambian gradualmente el equilibrio hacia los datos objetivo a medida que avanza el entrenamiento.
La transferencia de parámetros, donde los pesos del modelo entrenado en el origen sirven como inicialización, es la estrategia dominante en SDA. El éxito de este enfoque depende del grado de relación entre los dominios de origen y destino. Cuando los dominios están estrechamente relacionados (por ejemplo, diferentes secciones del mismo pavimento de aeropuerto), muy pocos ejemplos objetivo etiquetados son suficientes, tan solo 20–50 imágenes pueden recuperar la mayor parte del rendimiento perdido debido al desplazamiento de dominio. Cuando los dominios son más distantes (por ejemplo, carretera a pista), se requieren típicamente de 200 a 500 ejemplos objetivo etiquetados para una adaptación robusta.
Las técnicas SDA eficientes en etiquetas tienen como objetivo minimizar la cantidad de etiquetas objetivo necesarias. El aprendizaje activo identifica las muestras objetivo más informativas para el etiquetado, el modelo se entrena con datos de origen, se aplica a datos objetivo no etiquetados, y las muestras en las que es más incierto se seleccionan para el etiquetado humano. Este enfoque puede reducir los requisitos de etiquetado en un 50–70% en comparación con el muestreo aleatorio. El autoentrenamiento (o pseudoetiquetado) aplica el modelo entrenado en el origen a datos objetivo no etiquetados, genera etiquetas provisionales para predicciones de alta confianza y vuelve a entrenar el modelo utilizando estas pseudoetiquetas como supervisión adicional. El autoentrenamiento es particularmente efectivo cuando se combina con un umbral de confianza y aumento de datos.
Cuándo usar SDA, cuando es factible obtener un pequeño conjunto etiquetado de cada sitio de implementación objetivo. Para la inspección de pistas de aeropuertos, esto significa que un inspector capacitado puede etiquetar de 50 a 200 imágenes por aeropuerto, un costo único de 1 a 4 horas por sitio. Esto es mucho más económico que la alternativa de recopilar y etiquetar miles de imágenes por aeropuerto, lo que requeriría varios días por sitio. La AC 150/5380-6C de la FAA recomienda estudios de PCI regulares que ya implican que los inspectores examinen las superficies de pavimento, estos mismos inspectores pueden proporcionar los pocos cientos de imágenes etiquetadas necesarias para SDA como parte de su flujo de trabajo de inspección estándar.
Adaptación de Dominio No Supervisada
La adaptación de dominio no supervisada (UDA) es la configuración de adaptación de dominio más desafiante y activamente investigada. Supone que los datos etiquetados existen solo en el dominio de origen, mientras que el dominio objetivo está completamente no etiquetado. La UDA es el escenario dominante para la inspección de infraestructuras porque etiquetar datos del dominio objetivo es costoso, requiere mucho tiempo o no es práctico en muchos sitios de implementación. Un modelo entrenado en las imágenes de pavimento de un aeropuerto debe adaptarse a las superficies, la iluminación y los patrones de defectos de un aeropuerto diferente sin requerir que cada aeropuerto produzca un conjunto de datos etiquetados.
Los métodos UDA se dividen en tres categorías principales, métodos adversariales, métodos basados en discrepancia y métodos basados en reconstrucción. Todos comparten el objetivo central de alinear las distribuciones de características de origen y destino para que un clasificador entrenado en características de origen generalice a las características objetivo.
Adaptación de Dominio Adversarial
La adaptación de dominio adversarial se inspira en las Redes Generativas Antagónicas (GAN). La idea central es entrenar un discriminador de dominio (un clasificador binario que predice si una representación de característica provino del dominio de origen o destino) junto con el extractor de características en un juego minimax. El extractor de características intenta producir características que sean indistinguibles entre origen y destino, mientras que el discriminador intenta identificar correctamente el origen de cada característica.
La arquitectura canónica es la Red Neuronal Adversarial de Dominio (DANN), presentada por Yaroslav Ganin y Victor Lempitsky en 2015. DANN consta de tres componentes, un extractor de características (G_f) que mapea las entradas a un espacio de características (f = G_f(x, \theta_f)), un predictor de etiquetas (G_y) que mapea las características a las etiquetas de tarea (\hat{y} = G_y(f, \theta_y)), y un clasificador de dominio (G_d) que mapea las características a las etiquetas de dominio (\hat{d} = G_d(f, \theta_d)). La innovación crítica es la Capa de Inversión de Gradiente (GRL) colocada entre el extractor de características y el clasificador de dominio. Durante la propagación hacia adelante, la GRL actúa como una transformación de identidad. Durante la retropropagación, multiplica el gradiente por (-\lambda), donde (\lambda) es un hiperparámetro que controla la fuerza de adaptación. Esta inversión hace que el extractor de características aprenda características que maximizan la pérdida de clasificación de dominio, aprendiendo efectivamente a engañar al clasificador de dominio.
La función de pérdida de DANN combina la pérdida de la tarea en las etiquetas de origen menos la pérdida de clasificación de dominio tanto en las características de origen como de destino:
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
A medida que avanza el entrenamiento, el extractor de características aprende representaciones que son tanto discriminatorias para la tarea (porque el predictor de etiquetas se entrena con etiquetas de origen) como invariantes de dominio (porque el clasificador de dominio no puede distinguir el origen del dominio). La programación de GRL generalmente comienza con (\lambda = 0) y aumenta gradualmente hasta un valor máximo durante las primeras épocas, lo que permite que la red estabilice su rendimiento en la tarea antes de que se aplique la presión de confusión de dominio.
Los avances recientes en la adaptación de dominio adversarial incluyen el Entrenamiento Adversarial Contrastivo (CAT), que aprovecha las muestras de origen etiquetadas para reforzar la separación de características mientras mantiene la alineación de dominio, las Redes Colaborativas y Adversariales (CAN), que realizan una alineación de dominio multinivel en diferentes niveles de jerarquía de características, y la Minimización de Discrepancia de Estilo Adversarial, que utiliza la transferencia de estilo como un objetivo adversarial. Para la detección de grietas en pavimentos, los métodos adversariales han demostrado la generalización más sólida entre conjuntos de datos, recuperando de 15 a 25 puntos porcentuales del rendimiento perdido debido al desplazamiento de dominio.
Métodos Basados en Discrepancia
Los métodos basados en discrepancia adoptan un enfoque diferente, en lugar del entrenamiento adversarial, minimizan explícitamente una medida de distancia estadística entre las distribuciones de características de origen y destino. La ventaja es la estabilidad del entrenamiento, sin dinámicas adversariales que requieran un ajuste cuidadoso de hiperparámetros, a costa de una alineación potencialmente más débil.
La Discrepancia Máxima Media (MMD) es la medida de discrepancia más utilizada para la adaptación de dominio. La MMD es una prueba estadística basada en kernels que mide la distancia entre dos distribuciones en un Espacio de Hilbert de Reproducción de Kernel (RKHS). Dadas las características de origen (\mathbf{f}^S) y las características de destino (\mathbf{f}^T), la MMD al cuadrado es:
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
donde (\phi) es el mapa de características hacia el RKHS. En la práctica, la MMD se calcula utilizando una función kernel (k(x,y) = \langle \phi(x), \phi(y) \rangle), típicamente el kernel Gaussiano RBF, a menudo con múltiples anchos de banda para capturar diferentes niveles de similitud de distribución.
Las Redes de Adaptación Profunda (DAN), presentadas por Long et al. en 2015, agregan pérdida MMD a múltiples capas específicas de la tarea de una CNN profunda. La pérdida total se convierte en (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), donde (L) es el conjunto de capas en las que se aplica la alineación de dominio. DAN demostró que alinear representaciones de características de nivel superior (en lugar de solo la capa final) mejora significativamente la calidad de la adaptación.
La Alineación de CORrelación (CORAL), presentada por Sun y Saenko en 2016, adopta un enfoque más simple al minimizar la diferencia entre las matrices de covarianza de características de origen y destino:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
donde (C_S) y (C_T) son las matrices de covarianza de características de origen y destino respectivamente, (d) es la dimensión de la característica, y (|\cdot|_F) es la norma de Frobenius. Deep CORAL extiende esto a redes profundas agregando la pérdida CORAL a la función de pérdida de la red. CORAL es computacionalmente eficiente y funciona bien cuando el desplazamiento de dominio está principalmente en la varianza de la característica en lugar de en la media.
Las Redes de Adaptación Conjunta (JAN) extienden DAN al alinear las distribuciones conjuntas de múltiples capas en lugar de tratar cada capa de forma independiente. JAN utiliza MMD Conjunta (JMMD), definida en el producto tensorial de activaciones de múltiples capas. Esto captura las dependencias entre capas que las pérdidas MMD individuales pasan por alto.
Los avances recientes para la inspección de infraestructuras incluyen el marco de Wang et al. (2025) para la segmentación de corrosión, que combina tres módulos de discrepancia complementarios, Preservación de la Estructura Geométrica (GSP) que retiene las relaciones topológicas locales entre dominios utilizando regularización basada en grafos, Discrepancia Local basada en SVD (SLD) que utiliza la descomposición en valores singulares para alinear subespacios de características locales a un nivel detallado, y Alineación de Consistencia Global (GCA) que utiliza MMD para reconciliar los cambios distribucionales globales. Este enfoque combinado, respaldado por el backbone de segmentación ligero EffSegNet, logró una fuerte generalización entre dominios desde imágenes de corrosión de laboratorio hasta condiciones de campo en esclusas, presas e infraestructura de transporte.
Comparación de Métodos UDA
| Método | Categoría | Mecanismo de Alineación | Estabilidad del Entrenamiento | Rendimiento en Infraestructura |
|---|---|---|---|---|
| DANN | Adversarial | Inversión de gradiente + clasificador de dominio | Moderado (requiere ajuste de (\lambda)) | Fuerte (recupera 15–25 ppt mIoU) |
| DAN | Discrepancia | MMD en salidas de múltiples capas | Alta | Bueno (recupera 10–20 ppt mIoU) |
| Deep CORAL | Discrepancia | Alineación de covarianza (estadísticas de 2º orden) | Alta | Moderado (recupera 8–15 ppt mIoU) |
| JAN | Discrepancia | MMD conjunta en pares de capas | Alta | Bueno (recupera 12–18 ppt mIoU) |
| CycleGAN+Det | Generativo | Traducción imagen a imagen + modelo de tarea | Baja (dificultad de entrenamiento GAN) | Fuerte cuando la traducción de imágenes tiene éxito |
| CAT | Adversarial | Contrastivo + adversarial | Moderado | Fuerte (estado del arte en varios benchmarks) |
Aprendizaje de Características Invariantes de Dominio
Las características invariantes de dominio son representaciones de características producidas por una red neuronal que tienen la misma distribución estadística independientemente del dominio del que provenga la entrada. Si (f(x)) es la representación de la característica extraída por la red, la invariancia de dominio significa (P(f(X_S)) \approx P(f(X_T))). El objetivo es aprender una asignación (f) tal que la distancia (d(P(f(X_S)), P(f(X_T)))) se minimice mientras se preserva el poder discriminatorio específico de la tarea.
Los cuatro enfoques principales para aprender características invariantes de dominio manejan la compensación entre invariancia y discriminabilidad de manera diferente. El aprendizaje adversarial (DANN, basado en GAN) empuja al extractor de características a producir características que un discriminador de dominio no puede distinguir. Este es el mecanismo de invariancia más agresivo pero corre el riesgo de eliminar información relevante para la tarea si la textura de la grieta se correlaciona con el tipo de superficie. La igualación de momentos estadísticos (MMD, CORAL) alinea los momentos de distribución, primer orden (media) y segundo orden (covarianza), entre las características de origen y destino. Esto preserva más información relevante para la tarea que la alineación adversarial completa pero puede no capturar diferencias de distribución de orden superior. El transporte óptimo (métodos basados en OT) encuentra una asignación de costo mínimo entre las distribuciones de origen y destino, proporcionando una interpretación geométrica de la alineación de dominio. Los métodos de transferencia de estilo y generativos (CycleGAN, StarGAN) transforman imágenes de un dominio para que se parezcan visualmente a otro antes de pasarlas a través de la red de tareas. Esto opera a nivel de píxel en lugar de a nivel de característica y tiene la ventaja de producir imágenes transformadas interpretables.
La compensación entre invariancia y discriminabilidad es una tensión fundamental en el aprendizaje de características invariantes de dominio. Maximizar la invariancia de dominio puede eliminar información relevante para la tarea que se correlaciona con el dominio. Por ejemplo, si los bordes de las grietas en el asfalto tienen mayor contraste que en el concreto, un detector de características que se basa en la fuerza del contraste del borde será sensible tanto a la presencia de grietas como al tipo de pavimento. Forzar una invariancia completa al tipo de pavimento puede suprimir las características de contraste de borde necesarias para la detección de grietas. Los métodos avanzados abordan esto a través de la alineación multinivel, alineando solo las características semánticas de nivel superior mientras retienen las señales de textura de bajo nivel, y la alineación condicional que alinea las distribuciones condicionadas a la etiqueta de la tarea, preservando la información discriminatoria de clase.
La invariancia de dominio basada en atención aprovecha los mecanismos de atención para centrarse en regiones semánticas independientes del dominio. Un modelo de detección de grietas con un módulo de atención espacial aprende a atender a las estructuras de las grietas independientemente de la textura del pavimento de fondo. Los propios mapas de atención se vuelven más invariantes de dominio que los mapas de características en bruto porque resaltan las ubicaciones espaciales relevantes para la tarea mientras suprimen el fondo específico del dominio. La atención cruzada entre las características de origen y destino fortalece aún más esto al emparejar explícitamente regiones atendidas entre dominios.
Los métodos de adaptación de dominio autosupervisados utilizan tareas pretexto como la predicción de rotación, la resolución de rompecabezas o la discriminación de instancias contrastivas para aprender características que son robustas a la variación de dominio sin requerir etiquetas de dominio. Al resolver estas tareas auxiliares, el modelo aprende a capturar propiedades estructurales y geométricas de la entrada que son compartidas entre dominios. Las características preentrenadas autosupervisadas a menudo exhiben una invariancia de dominio más fuerte que las características puramente supervisadas porque las tareas pretexto no dependen de distribuciones de etiquetas específicas del dominio.
Adaptación de Carretera a Pista de Aterrizaje
La transición de la inspección de pavimentos de carreteras a la inspección de pistas de aterrizaje de aeropuertos representa uno de los problemas de adaptación de dominio más desafiantes en la gestión de activos de infraestructura. Las carreteras y las pistas son estructuras diseñadas fundamentalmente diferentes, construidas para diferentes cargas, velocidades y requisitos de seguridad, lo que produce apariencias visuales y características de defectos dramáticamente diferentes.
| Factor | Pavimento de Carretera | Pavimento de Pista de Aeropuerto |
|---|---|---|
| Norma de diseño | Varía según la jurisdicción | Normas Anexo 14 OACI / FAA |
| Carga por eje | ~10 toneladas (vehículos) | 50–400 toneladas (aeronaves) |
| Material de superficie principal | Asfalto (HMA) | Concreto PCC de alta resistencia (común) o asfalto para servicio pesado |
| Marcas | Marcas de carril amarillas/blancas (múltiples colores) | Solo marcas blancas, patrones complejos (umbral, zona de toma de contacto, punto de mira, línea central) |
| Tipos de defectos principales | Grietas, baches, ahuellamiento, exudación | Grietas, FOD, depósitos de caucho, desprendimiento, degradación de la fricción, erosión por chorro de motor, daños por derrame de combustible |
| Acceso para inspección | Carreteras públicas, acceso fácil sin restricciones | Lado aéreo restringido, requiere pase de aeródromo, escolta de vehículos, comunicación por radio |
| Método de captura dominante | Vehículos terrestres, teléfonos inteligentes, manual | UAV a 30–100 m de altitud, vehículos de inspección especializados |
| Contaminantes de la superficie | Agua, nieve, escombros, aceite | Agua, caucho (crítico, zonas de toma de contacto), fluidos de deshielo, combustible para aviones, fluido hidráulico |
| Parámetro de fricción crítico para la seguridad | Resistencia al deslizamiento para frenado | Coeficiente de acción de frenado para aeronaves en aterrizaje (categorías GRF de la OACI) |
| Marco normativo | Normas FHWA, DOT estatales | Anexo 14 de la OACI, Doc 9137, AC de la FAA |
La interferencia de los depósitos de caucho es el problema de adaptación más desafiante. Los neumáticos de las aeronaves depositan caucho en las pistas durante el aterrizaje, particularmente en la zona de toma de contacto, acumulándose como parches oscuros y continuos en la superficie del pavimento. Estos depósitos de caucho pueden imitar u ocultar grietas visualmente. Un modelo de detección de grietas entrenado en carreteras, que nunca ha encontrado depósitos de caucho de neumáticos, puede no detectar grietas debajo de parches de caucho o clasificar falsamente los bordes de los parches de caucho como grietas. Por lo tanto, la adaptación de carretera a pista debe incorporar el modelado de depósitos de caucho, ya sea mediante aumento sintético de datos de entrenamiento o mediante métodos de adaptación de dominio que aprendan a distinguir el caucho de las grietas.
Las diferencias de escala y resolución son otra barrera de adaptación significativa. Las imágenes de inspección de carreteras generalmente se capturan desde el nivel del suelo a distancias de 1–5 metros, lo que proporciona una resolución muy alta donde los bordes de las grietas individuales abarcan decenas de píxeles. La inspección de pistas con UAV a 30–100 m de altitud produce imágenes con una resolución más gruesa, una grieta que abarca 50 píxeles en una imagen de carretera puede abarcar solo 5–10 píxeles en una imagen de pista capturada desde la altitud. Los campos receptivos del extractor de características y los filtros dependientes de la escala deben adaptarse a esta diferencia en el contenido de frecuencia espacial. Las pirámides de características multiescala y el entrenamiento invariante a la escala son componentes de adaptación esenciales.
El desajuste en la definición de defectos requiere un mapeo cuidadoso entre las taxonomías de deterioro de carreteras y pistas. El Manual de Identificación de Deterioros LTPP de la FHWA define los defectos del pavimento de carreteras en categorías que se superponen parcialmente con los defectos del pavimento de aeropuertos definidos por ASTM D5340 y el Doc 9137 de la OACI, Parte 9. Algunos tipos de defectos son exclusivos de los aeródromos, los depósitos de caucho, la erosión por chorro de motor, los daños por derrame de combustible y la degradación de la fricción no tienen equivalentes en carreteras. Por lo tanto, los modelos entrenados en carreteras necesitan nuevas clases de salida agregadas durante la adaptación, o un enfoque de clasificación jerárquica que primero detecte defectos genéricos y luego los clasifique en categorías específicas del dominio.
El cumplimiento normativo impone una capa adicional de requisito de adaptación. Los modelos de inspección de carreteras producen resultados que informan la priorización del mantenimiento por parte de las agencias DOT. Los modelos de inspección de pistas deben producir resultados que se correspondan con los formatos de notificación obligatorios de la OACI y la FAA, las categorías de condición del Formato de Notificación Mundial (GRF), el Índice de Condición del Pavimento (PCI) según ASTM D5340 y las clasificaciones del Número de Clasificación de Pavimento (PCN). Por lo tanto, el proceso de adaptación también debe adaptar la representación de salida del modelo para alinearse con los estándares de informes regulatorios.
El puente de dominio progresivo, entrenar en conjuntos de datos intermedios que gradualmente abarcan la brecha de la carretera a la pista, ha demostrado ser efectivo. Una tubería de puente típica utiliza tres etapas, primero, entrenar en conjuntos de datos de carreteras (CQU-BPDD, RDD2020, Crack500), segundo, adaptarse a conjuntos de datos de pavimentos generales que incluyen tanto superficies de asfalto como de concreto, tercero, adaptarse a conjuntos de datos específicos de pistas con depósitos de caucho y marcas de aeródromo. Cada etapa reduce la brecha de distribución que la siguiente etapa debe salvar, lo que permite una adaptación más estable y efectiva que la transferencia directa de carretera a pista.
Adaptación a Través de Condiciones Climáticas
Las condiciones climáticas introducen una variación de dominio que es temporal (cambiando con el tiempo en una sola ubicación) y geográfica (variando entre ubicaciones simultáneamente). Un modelo implementado en varios aeropuertos debe manejar ambas dimensiones.
La adaptación de superficie mojada vs. seca es crítica porque las categorías de condición de la superficie de la pista bajo el Formato de Notificación Mundial (GRF) de la OACI distinguen explícitamente entre superficies secas, mojadas, mojadas resbaladizas y contaminadas. Las superficies mojadas alteran la visibilidad de las grietas de varias maneras. El agua que llena las grietas reduce el contraste entre la grieta y el pavimento circundante, las grietas secas aparecen como características lineales oscuras o brillantes de alto contraste, pero las grietas llenas de agua aparecen como características de bajo contraste que pueden ser casi invisibles para un modelo entrenado en superficies secas. La lámina de agua en la superficie del pavimento crea reflejos especulares que introducen regiones brillantes y bordes falsos, confundiendo a los detectores de grietas. El pavimento mojado también aparece más oscuro en general, desplazando el histograma de la imagen y alterando las estadísticas de cada capa de la red.
La adaptación al clima frío aborda los efectos de congelación y descongelación que cambian la apariencia del pavimento. Las superficies congeladas tienen propiedades de reflectancia diferentes a las superficies no congeladas. Los parches de hielo en el pavimento aparecen como regiones lisas y de alta reflectividad que comparten características visuales con los defectos de la superficie del pavimento. La capa de nieve oculta parcial o completamente los defectos de la superficie. La transición entre ciclos de congelación y descongelación produce patrones de deterioro únicos, D-cracking, desconchamiento por congelación-descongelación y levantamiento por heladas, que los modelos entrenados en datos de clima cálido pueden no reconocer.
El aumento de datos para la adaptación climática genera sintéticamente variaciones del dominio objetivo a partir de imágenes del dominio de origen. La adición de estrías de lluvia simuladas, modelos de reflectancia de superficie mojada, máscaras de cobertura de nieve y superposiciones de sombras puede expandir la cobertura del dominio de origen para incluir condiciones climáticas no presentes en los datos de entrenamiento originales. Las políticas de RandAugment con transformaciones fotométricas específicas dirigidas a cambios en el brillo, el contraste y la temperatura de color son particularmente efectivas para la adaptación climática. Los estudios muestran que los enfoques basados únicamente en el aumento de datos recuperan del 50 al 70% del rendimiento perdido debido a los desplazamientos de dominio por iluminación y clima, lo que los convierte en un complemento rentable para métodos adversariales o basados en discrepancia más complejos.
La traducción de dominio basada en CycleGAN proporciona una alternativa al aprender a traducir imágenes entre condiciones climáticas. Un CycleGAN entrenado en imágenes emparejadas o no emparejadas de pistas secas y mojadas aprende a mapear del dominio seco al dominio mojado mientras preserva las ubicaciones y geometrías de las grietas. Los modelos de detección de grietas entrenados con estos datos aumentados aprenden características que son invariantes a la presencia o ausencia de agua en la superficie. La desventaja es la complejidad del entrenamiento de las GAN y el riesgo de alucinar o eliminar características de grietas durante la traducción.
Adaptación a Través de Tipos de Cámara
Los sistemas de inspección de infraestructura utilizan una variedad de plataformas de imagen, cada una con diferentes características ópticas que introducen un desplazamiento de dominio. La adaptación entre tipos de cámara es esencial para cualquier sistema implementado en múltiples aeropuertos, donde las imágenes existentes pueden provenir de diferentes fuentes.
La resolución y la Distancia de Muestreo en el Suelo (GSD) varían ampliamente. La inspección a nivel del suelo con una DSLR de 50 MP produce GSD de 0.1–0.5 mm/píxel. La inspección con UAV a 30 m de altitud produce 0.5–1 cm/píxel. La inspección con UAV a 100 m de altitud produce 2–5 cm/píxel. Las imágenes de satélite pueden tener una resolución de 30–50 cm/píxel. Una grieta de 3 mm de ancho abarca de 6 a 30 píxeles a nivel del suelo, de 0.3 a 0.6 píxeles a 30 m de altitud de UAV y es subpíxel a 100 m. Los modelos entrenados en imágenes terrestres de alta resolución no pueden detectar directamente características en resoluciones más gruesas. El entrenamiento multirresolución, entrenar en imágenes a múltiples escalas de resolución, es la estrategia principal. El extractor de características aprende representaciones invariantes a la escala a través de agrupación piramidal, convoluciones dilatadas o normalización adaptativa a la resolución.
Las diferencias de sensibilidad espectral del sensor entre cámaras afectan la representación del color. Diferentes sensores CMOS y CCD tienen diferentes curvas de eficiencia cuántica en el espectro visible, lo que significa que la misma superficie aparece con valores RGB ligeramente diferentes de diferentes cámaras. La calibración de color utilizando una tabla de colores durante la recopilación de datos reduce este desplazamiento pero rara vez es práctica para programas de inspección a gran escala. La igualación de histogramas y la transferencia de color entre imágenes de origen y destino son alternativas de preprocesamiento. Los enfoques más sofisticados incluyen el aprendizaje de características invariantes al sensor que elimina explícitamente la información de color específica del sensor de las representaciones de características mediante el aumento de la variación de color durante el entrenamiento.
La distorsión de la lente varía según las combinaciones de cámara y lente. Los lentes gran angular utilizados para una cobertura eficiente de la pista introducen distorsión de barril que cambia la geometría de las grietas, las grietas rectas pueden aparecer curvadas cerca de los bordes de la imagen. Para las tareas de detección, esta distorsión afecta la relación espacial entre las características de la imagen. La corrección de distorsión como paso de preprocesamiento normaliza todas las imágenes a una geometría rectificada común antes de alimentarlas al modelo. Alternativamente, el entrenamiento en imágenes con aumento de distorsión sintética hace que el modelo sea robusto a diferentes niveles de distorsión.
Los efectos de obturador rodante de las plataformas UAV introducen distorsión geométrica durante el vuelo, particularmente a alta velocidad o en condiciones de viento. La exposición secuencial de las filas en un sensor CMOS de obturador rodante significa que el movimiento de la cámara durante la exposición produce una geometría de grieta sesgada o distorsionada. Esta distorsión temporal está ausente en las cámaras de obturador global y en la captura estática a nivel del suelo. La adaptación requiere un preprocesamiento para corregir los artefactos del obturador rodante o entrenar en datos que incluyan degradación sintética del obturador rodante.
| Variación de Cámara | Estrategia de Adaptación | Complejidad de Implementación | Recuperación Típica |
|---|---|---|---|
| Resolución / GSD | Entrenamiento multirresolución + agrupación piramidal | Moderada | 5–10% de recuperación de precisión |
| Respuesta cromática del sensor | Aumento de variación de color + igualación de histogramas | Baja | 3–7% de recuperación de precisión |
| Distorsión de la lente | Preprocesamiento de corrección de distorsión | Baja | 2–5% de recuperación de precisión |
| Obturador rodante | Aumento sintético de obturador rodante | Moderada | 3–6% de recuperación de precisión |
| Artefactos de compresión | Aumento de compresión JPEG | Baja | 1–3% de recuperación de precisión |
Fundamentos Matemáticos y Formulaciones Clave
Comprender la adaptación de dominio requiere familiaridad con varias formulaciones matemáticas centrales. El marco de Minimización de Riesgo Empírico (ERM) proporciona el punto de partida. Dado un dominio de origen con muestras etiquetadas ({(x_i^S, y_i^S)}_{i=1}^{n_S}), un modelo estándar minimiza el riesgo empírico:
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
donde (\ell) es la función de pérdida específica de la tarea (entropía cruzada para clasificación, pérdida Dice para segmentación). La adaptación de dominio tiene como objetivo minimizar el riesgo objetivo:
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
El desafío es que (R_T) no se puede minimizar directamente cuando las etiquetas objetivo no están disponibles. Los métodos de adaptación de dominio acotan el riesgo objetivo mediante la suma del riesgo de origen y una medida de divergencia entre las distribuciones de origen y destino.
La H-divergencia proporciona un límite teórico para la adaptación de dominio (Ben-David et al., 2010). Para una clase de hipótesis (\mathcal{H}), la H-divergencia entre las distribuciones de origen y destino es:
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
En la práctica, la H-divergencia se estima entrenando un clasificador para discriminar entre muestras del dominio de origen y destino, exactamente lo que hace el clasificador de dominio en DANN. El resultado teórico garantiza que un modelo entrenado con datos de origen generalizará al dominio objetivo si la H-divergencia entre los dominios es pequeña. Esto proporciona la justificación formal para la adaptación de dominio adversarial.
La MMD en forma funcional utiliza un kernel característico (k) para incrustar distribuciones de probabilidad en un RKHS:
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
Con el kernel gaussiano (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)), la MMD al cuadrado se puede calcular directamente a partir de las medias de las muestras:
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
La pérdida CORAL alinea las estadísticas de segundo orden:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
donde (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) y (C_T) se define de manera análoga para las características objetivo. La norma de Frobenius (|\cdot|_F) es la suma de cuadrados elemento a elemento.
Estos fundamentos matemáticos se traducen directamente en implementación práctica. La pérdida de adaptación de dominio para una red Deep CORAL es:
(\mathcal{L} = \mathcal{L}{tarea}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Para una red DANN:
(\mathcal{L} = \mathcal{L}{tarea}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{dominio}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
donde (\mathbf{D} = {0, 1}) indica el dominio de origen (0) o destino (1), y el signo negativo refleja la inversión del gradiente.
| Método | Función Objetivo | Hiperparámetros Clave |
|---|---|---|
| ERM (sin adaptación) | (\mathcal{L} = \mathcal{L}_{tarea}(D_S, Y_S)) | Tasa de aprendizaje, decadencia de peso |
| DANN | (\mathcal{L} = \mathcal{L}{tarea} - \lambda \mathcal{L}{dominio}) | (\lambda) (fuerza de adaptación), programación GRL |
| DAN | (\mathcal{L} = \mathcal{L}_{tarea} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) por capa, ancho de banda del kernel (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{tarea} + \lambda |C_S - C_T|_F^2) | (\lambda) (peso de alineación) |
| JAN | (\mathcal{L} = \mathcal{L}_{tarea} + \sum_l \lambda_l JMMD_l) | Pares de capas, anchos de banda del kernel |
| Ajuste fino | (\mathcal{L} = \mathcal{L}_{tarea}(D_T, Y_T)) LR reducida | Programa de congelación, factor de reducción de LR |
Protocolos de Evaluación para la Adaptación de Dominio
Evaluar los métodos de adaptación de dominio requiere puntos de referencia estandarizados entre conjuntos de datos que midan el rendimiento en dominios objetivo no vistos durante el entrenamiento. Para la inspección de infraestructuras, se han establecido varios protocolos de referencia.
La evaluación entre conjuntos de datos es el protocolo estándar. El modelo se entrena en un conjunto de datos de origen (por ejemplo, CQU-BPDD, que contiene imágenes de grietas en pavimento bituminoso) y se evalúa en un conjunto de datos objetivo (por ejemplo, RDD2020, que contiene imágenes de grietas en carreteras de múltiples países). El rendimiento en el conjunto de datos objetivo antes de la adaptación sirve como línea base de solo origen. El rendimiento después de la adaptación (con acceso a datos objetivo no etiquetados para UDA o datos objetivo etiquetados limitados para SDA) se mide en comparación con esta línea base. La ganancia de adaptación, la diferencia entre el rendimiento adaptado y no adaptado, cuantifica la efectividad del método de adaptación.
Los puntos de referencia comunes para la detección de grietas en pavimentos incluyen, CQU-BPDD (Conjunto de datos de grietas en pavimento bituminoso) que contiene 60,088 imágenes de grietas en pavimento asfáltico de China, RDD2020 que contiene 26,336 imágenes de grietas en carreteras de India, Japón y la República Checa, Crack500 que contiene 500 imágenes de alta resolución de grietas en pavimentos de superficies de carreteras, DeepCrack que contiene 537 imágenes de grietas en paredes de edificios, y SDNET2018 que contiene 56,000 imágenes de tableros de puentes, muros y pavimentos de concreto. La evaluación entre conjuntos de datos a través de estos conjuntos, particularmente de CQU-BPDD a RDD2020, que representa una transferencia entre países y climas, es el punto de referencia más riguroso.
Las métricas para la evaluación de la adaptación de dominio incluyen mIoU del dominio objetivo (Intersección sobre la Unión media para tareas de segmentación), puntuación F1 del dominio objetivo (para tareas de detección), retención del origen (rendimiento del dominio de origen después de la adaptación, para medir el olvido catastrófico), ganancia de adaptación (mejora en puntos porcentuales sobre la línea base de solo origen) y eficiencia de etiquetas (cuántos datos objetivo etiquetados se necesitan para alcanzar un nivel de rendimiento determinado para métodos supervisados).
La prueba de significación estadística es esencial porque los resultados de la adaptación de dominio pueden ser ruidosos. Se utilizan múltiples ejecuciones con diferentes semillas aleatorias (típicamente 5–10) para calcular la media y la desviación estándar de las métricas de rendimiento. Se utiliza la prueba de rango con signo de Wilcoxon o la prueba t pareada para determinar si las diferencias de rendimiento entre los métodos de adaptación son estadísticamente significativas en los umbrales convencionales ((p < 0.05)).
Para la inspección de infraestructuras, las métricas adicionales específicas de la implementación son relevantes, tasa de falsos positivos en umbrales de gravedad operativos (un detector de grietas que genera 100 falsas alarmas por inspección de pista es inútil operativamente, independientemente de su mIoU), tiempo de inferencia por unidad de área (la adaptación no debería aumentar significativamente el tiempo de procesamiento) y huella de memoria (los métodos basados en adaptadores deberían agregar una sobrecarga de almacenamiento mínima por aeropuerto adicional).
Normas y Referencias Clave
La práctica de la adaptación de dominio para la inspección de infraestructuras se basa en normas e investigaciones de múltiples disciplinas.
Fundamentos del aprendizaje automático, Ganin et al., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), el artículo canónico de DANN que introduce la inversión de gradiente. Long et al., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), que introduce la alineación de dominio multinivel basada en MMD. Sun and Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), que introduce la alineación basada en covarianza. Ben-David et al., “A theory of learning from different domains” (Machine Learning, 2010), el marco teórico para los límites de generalización de la adaptación de dominio.
Adaptación de dominio para inspección de infraestructuras, Liu et al., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), la referencia principal para la adaptación de dominio en la detección de grietas con una arquitectura de dos ramas con pesos compartidos. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), alineación de características multinivel para la detección de grietas entre conjuntos de datos. Wang, Nguyen, Eick et al., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), marco de discrepancia de tres módulos para la corrosión en infraestructuras.
Normas de la OACI y la FAA, Anexo 14 de la OACI, Aeródromos, Volumen I (8ª Edición, 2018 con enmiendas), norma internacional principal para la certificación de aeródromos, que crea el contexto de desplazamiento de dominio entre aeropuertos. Doc 9137 de la OACI, Parte 9, Manual de Servicios de Aeropuerto, Prácticas de Mantenimiento de Aeropuertos, guía de mantenimiento de pavimentos. Formato de Notificación Mundial (GRF) de la OACI para las Condiciones de la Superficie de la Pista (efectivo desde noviembre de 2021), que define los dominios de condición de la superficie (seca, mojada, contaminada). AC 150/5380-6C de la FAA, Guías y Procedimientos para el Mantenimiento de Pavimentos de Aeropuertos. ASTM D5340, Método de Prueba Estándar para Estudios del Índice de Condición del Pavimento de Aeropuertos, el marco cuantitativo para la evaluación de la condición del pavimento que los modelos adaptados por dominio deben respaldar.
Conjuntos de datos de pavimentos, CQU-BPDD (Universidad de Chongqing, 60,088 imágenes de grietas en pavimento asfáltico). RDD2020 (más de 8,300 imágenes de carreteras de India, Japón, República Checa). Crack500 (500 imágenes de alta resolución de grietas en pavimento). SDNET2018 (56,000 imágenes de tableros de puentes, muros y pavimentos de la Universidad Estatal de Utah). Estos conjuntos de datos proporcionan los puntos de referencia estandarizados para la evaluación de la adaptación de dominio en la inspección de pavimentos.
Preguntas Frecuentes
- ¿Qué es la adaptación de dominio en el aprendizaje automático?
- La adaptación de dominio es un subcampo del aprendizaje por transferencia que aborda el problema del desplazamiento de dominio, donde un modelo entrenado en un conjunto de datos de origen funciona mal cuando se implementa en un conjunto de datos objetivo con propiedades estadísticas diferentes. El objetivo es aprender representaciones de características invariantes de dominio para que el modelo generalice entre dominios sin requerir un reentrenamiento completo con datos objetivo etiquetados. La adaptación de dominio se clasifica en supervisada (datos objetivo etiquetados limitados disponibles), no supervisada (sin datos objetivo etiquetados) y semisupervisada (algunos datos objetivo etiquetados más no etiquetados).
- ¿Cómo afecta el desplazamiento de dominio a los modelos de detección de grietas en pavimentos?
- El desplazamiento de dominio en la detección de grietas en pavimentos provoca caídas de rendimiento del 30–45% en la Intersección sobre la Unión media (mIoU) al pasar de un conjunto de datos a otro. Las fuentes de desplazamiento incluyen diferencias en el material de la superficie (asfalto vs. concreto), variación en la morfología de las grietas (longitudinal vs. piel de cocodrilo), cambios en las condiciones de imagen (ángulo de iluminación, resolución, sensor de cámara) y factores geográficos (diferentes tipos de agregados y patrones de envejecimiento). Por ejemplo, un modelo entrenado en el conjunto de datos CQU-BPDD logra un mIoU de 0.72 en los datos de prueba de origen, pero cae a 0.31 cuando se prueba en los datos objetivo de RDD2020 sin adaptación.
- ¿Cuál es la diferencia entre aprendizaje por transferencia y adaptación de dominio?
- El aprendizaje por transferencia adapta un modelo preentrenado en una tarea para realizar una tarea diferente, por ejemplo, ajustar un modelo de clasificación de ImageNet para la detección de grietas. La adaptación de dominio aborda la misma tarea en diferentes distribuciones de datos, por ejemplo, adaptar un detector de grietas en asfalto para detectar grietas en superficies de concreto. En el aprendizaje por transferencia las tareas de origen y objetivo pueden diferir, en la adaptación de dominio la tarea es idéntica pero las distribuciones de entrada difieren.
- ¿Qué son las características invariantes de dominio?
- Las características invariantes de dominio son representaciones extraídas por una red neuronal que tienen la misma distribución estadística independientemente del dominio del que provenga la entrada. Si una red de detección de grietas aprende características que se ven igual ya sea que la entrada sea una imagen de una carretera asfáltica o una pista de concreto, esas características son invariantes de dominio. Se aprenden mediante entrenamiento adversarial (un discriminador de dominio no puede distinguir de qué dominio provienen las características), igualación de momentos estadísticos (MMD, CORAL) o técnicas de transporte óptimo. El desafío fundamental es el equilibrio entre invariancia y discriminabilidad, forzar que las características sean demasiado invariantes de dominio puede eliminar información relevante para la tarea como la textura de la grieta que se correlaciona con el tipo de superficie.
- ¿Cómo funciona la adaptación de dominio no supervisada?
- La adaptación de dominio no supervisada (UDA) utiliza datos de origen etiquetados y datos objetivo no etiquetados para entrenar un modelo que generalice al dominio objetivo. Los tres enfoques principales son, (1) métodos adversariales como DANN, donde un discriminador de dominio intenta identificar de qué dominio provienen las características mientras el extractor de características intenta engañarlo, (2) métodos basados en discrepancias como DeepCORAL y DAN, que minimizan medidas de distancia estadística (MMD, diferencia de covarianza) entre las distribuciones de características de origen y objetivo, y (3) métodos basados en reconstrucción que utilizan autoencoders o GAN para aprender representaciones compartidas.
- ¿Qué desafíos existen al adaptarse de la inspección de carreteras a la de pistas de aterrizaje?
- La adaptación de dominio de carretera a pista de aterrizaje enfrenta diferencias fundamentales en el material de la superficie (asfalto vs. concreto PCC de alta resistencia), características de carga (ejes de vehículos de 10 toneladas vs. cargas de aeronaves de 50–400 toneladas), tipos de defectos (depósitos de caucho, erosión por chorro de motor, daños por derrame de combustible en pistas), acceso para inspección (carreteras públicas vs. lado aire restringido), métodos de captura de imágenes (vehículos terrestres vs. UAV a 30–100 m de altitud) y cumplimiento normativo (normas del Anexo 14 de la OACI). La interferencia de los depósitos de caucho es particularmente desafiante, el caucho de los neumáticos se acumula como parches oscuros en las pistas que pueden imitar u ocultar grietas, una condición que los modelos de carretera nunca encuentran.
- ¿Qué es la Red Neuronal Adversarial de Dominio (DANN)?
- La Red Neuronal Adversarial de Dominio (DANN), presentada por Ganin y Lempitsky en 2015, es la arquitectura canónica para la adaptación de dominio adversarial. Consta de tres componentes, un extractor de características que mapea las entradas a un espacio de características compartido, un predictor de etiquetas que realiza la tarea (por ejemplo, clasificación de grietas) y un clasificador de dominio que predice a qué dominio pertenece la entrada. Una Capa de Inversión de Gradiente (GRL) se encuentra entre el extractor de características y el clasificador de dominio, durante la retropropagación invierte el signo del gradiente, lo que hace que el extractor de características aprenda características que maximizan la confusión de dominio. La pérdida total combina la pérdida de la tarea en las etiquetas de origen menos la pérdida de clasificación de dominio, ponderada por un hiperparámetro lambda.
- ¿Qué estrategias de adaptación de dominio se adaptan a diferentes cantidades de datos objetivo?
- La estrategia sigue la cantidad de datos objetivo disponible. El ajuste fino completo es adecuado para cantidades moderadas de datos objetivo etiquetados, el ajuste de la última capa o basado en adaptadores es adecuado para datos etiquetados muy limitados, y la adaptación no supervisada que utiliza estadísticas de normalización por lotes y alineación de características se utiliza cuando no existen etiquetas objetivo. El descongelamiento progresivo y el aumento de datos adaptado a las condiciones de imagen objetivo ayudan al modelo adaptado a conservar lo que aprendió del dominio de origen.
- ¿Qué es la Discrepancia Máxima Media (MMD)?
- La Discrepancia Máxima Media (MMD) es una prueba estadística basada en kernels que se utiliza para medir la distancia entre dos distribuciones de probabilidad en un Espacio de Hilbert de Reproducción de Kernel (RKHS). En la adaptación de dominio, la MMD se utiliza como una función de pérdida para minimizar la brecha de distribución entre las representaciones de características de origen y objetivo. La fórmula MMD calcula la norma de la diferencia entre las incrustaciones medias de las características de origen y objetivo en el RKHS. Las Redes de Adaptación Profunda (DAN) y las Redes de Adaptación Conjunta (JAN) incorporan la pérdida MMD en múltiples capas de la red para lograr una alineación de dominio multinivel.
- ¿Qué normas de la OACI se relacionan con la adaptación de dominio para la inspección de pistas?
- El Anexo 14 de la OACI establece normas para el diseño y las operaciones de aeródromos que crean un requisito natural de adaptación de dominio, diferentes aeropuertos tienen diferentes materiales de pavimento, climas e historiales de mantenimiento, por lo que los modelos de inspección deben adaptarse entre aeropuertos. El Formato de Notificación Mundial (GRF) define categorías de condición de la superficie de la pista (seca, mojada, mojada resbaladiza, contaminada) que representan dominios visuales distintos. El Doc 9137 de la OACI, Parte 9, y la AC 150/5380-6C de la FAA proporcionan orientación sobre mantenimiento. Al implementar la inspección basada en IA en todos los aeropuertos, la adaptación de dominio es esencial porque un modelo entrenado con datos de un aeropuerto encontrará diferentes iluminaciones, edades de pavimento y morfologías de defectos en otro.
Esta es una entrada de referencia. TarmacView proporciona servicios de inspección con drones y no vende los equipos ni materiales descritos en este glosario.