Qu'est-ce que le Transformateur de Vision DINOv3 ?
Transformateur de Vision DINOv3 pour l’Analyse des Surfaces d’Infrastructure
Apprentissage Auto-Supervisé et DINO
L’apprentissage auto-supervisé (SSL) est un paradigme d’apprentissage automatique où un modèle apprend des représentations significatives à partir de données non étiquetées en définissant une tâche prétexte qui ne nécessite pas d’annotations humaines. Le modèle doit prédire une partie des données à partir d’autres parties, en exploitant la structure inhérente et les modèles de cooccurrence au sein des données elles-mêmes. En vision par ordinateur, les méthodes SSL ont progressé de tâches prétextes artisanales telles que la prédiction de l’angle de rotation d’une image (RotNet), la résolution de puzzles de patchs mélangés ou la colorisation d’images en niveaux de gris vers des approches contrastives et basées sur la distillation plus sophistiquées. L’avantage fondamental du SSL est qu’il permet l’entraînement sur des ensembles de données à l’échelle du Web sans le coût prohibitif de l’annotation manuelle. Pour les applications d’infrastructure, où les ensembles de données de défauts étiquetés sont rares et coûteux à produire (nécessitant des inspecteurs et ingénieurs certifiés), les colonnes vertébrales basées sur le SSL permettent un apprentissage efficace des caractéristiques à partir de grandes quantités d’images non étiquetées avant tout réglage fin spécifique à la tâche.
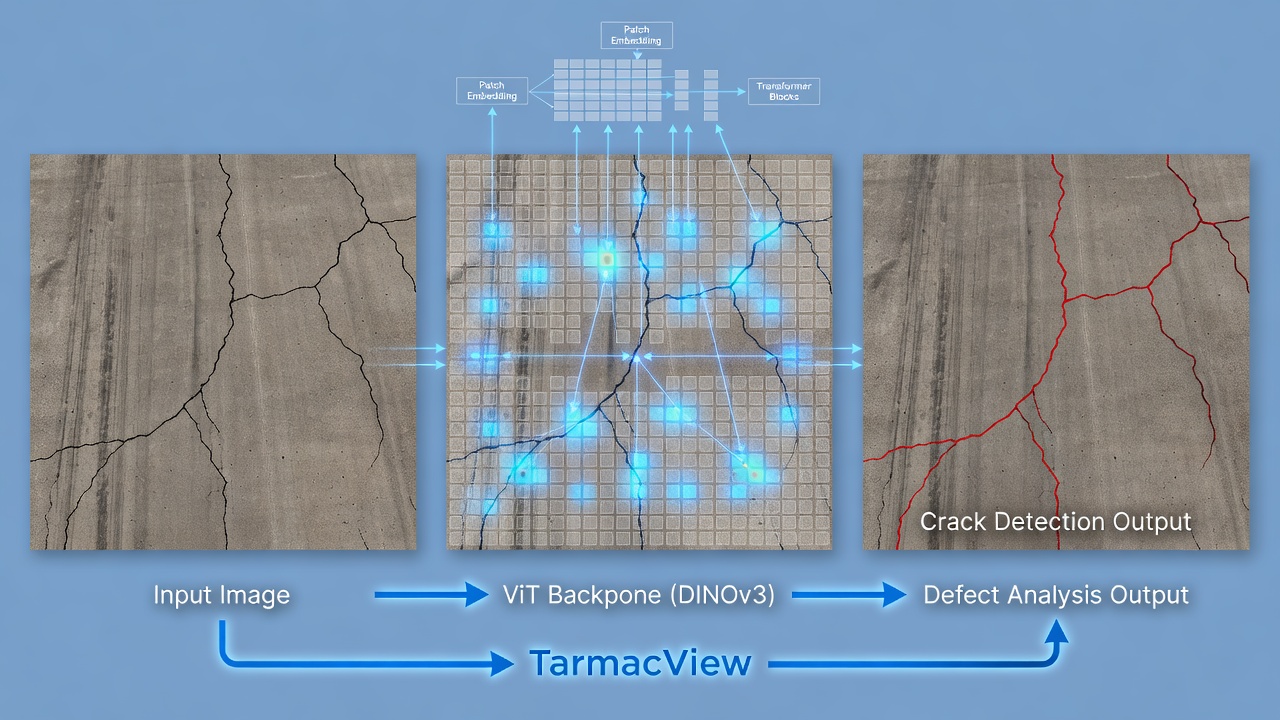
C’est la méthode de détection de fissures derrière l’évaluation des chaussées routières de TarmacView.
Les méthodes d’apprentissage contrastif telles que SimCLR, MoCo et SwAV apprennent des représentations en rapprochant dans l’espace de plongement les vues augmentées d’une même image (paires positives) tout en éloignant les vues d’images différentes (paires négatives). Ces méthodes nécessitent une gestion minutieuse des échantillons négatifs : trop peu de négatifs dégrade les performances, trop nombreux augmente le coût de calcul. Les méthodes non contrastives comme BYOL, SimSiam et DINO évitent complètement le besoin de paires négatives en utilisant des architectures de réseau asymétriques et des opérations d’arrêt de gradient pour empêcher l’effondrement représentationnel. DINO (self-DIstillation with NO labels), introduit par Caron et al. chez Meta AI en 2021, appartient à cette famille non contrastive et est devenu l’une des méthodes SSL les plus influentes en vision par ordinateur. L’article original de DINO a démontré que le SSL et les transformateurs de vision ont une synergie unique : les mécanismes d’auto-attention dans les ViT produisent naturellement des cartes de segmentation sémantique sans aucune supervision, une propriété qui émerge de l’interaction entre la stratégie d’augmentation multi-recadrage et l’objectif d’auto-distillation.
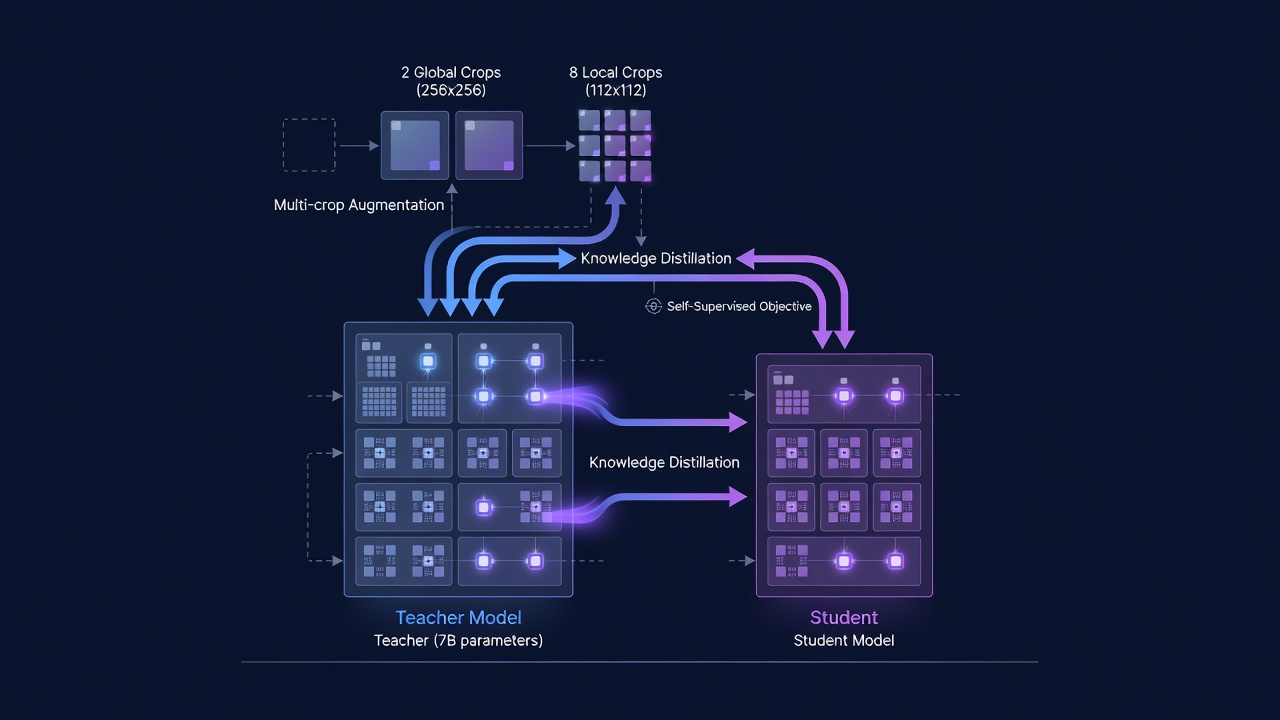
Le cadre d’entraînement DINO fonctionne comme suit. Pour chaque image d’entrée, deux vues globales (couvrant plus de 50 % de la zone de l’image, généralement 224x224 pixels) et plusieurs vues locales (recadrages plus petits couvrant moins de 50 % de la zone de l’image, généralement 96x96 pixels) sont générées par recadrage redimensionné aléatoire, variation de couleur et flou gaussien. Toutes les vues sont transmises à un réseau élève (un transformateur de vision). Les vues globales sont également transmises à un réseau enseignant, qui partage la même architecture que l’élève mais a des paramètres différents. Les paramètres de l’enseignant ne sont pas appris par gradients ; au lieu de cela, ils sont mis à jour comme une moyenne mobile exponentielle (EMA) des paramètres de l’élève. L’objectif d’entraînement principal est de faire correspondre la distribution de sortie de l’élève à la distribution de sortie de l’enseignant pour les vues globales, tandis que les vues locales fournissent un signal d’entraînement supplémentaire via l’élève uniquement. Cette configuration enseignant-élève, connue sous le nom d’auto-distillation, crée un signal d’apprentissage qui ne nécessite pas d’étiquettes : l’élève apprend à produire des représentations cohérentes à travers différentes augmentations de la même image, ce qui le force à capturer le contenu sémantique invariant plutôt que les détails superficiels au niveau des pixels.
DINOv1 (2021) a démontré trois propriétés émergentes clés des ViT auto-supervisés. Premièrement, les cartes d’attention du jeton [CLS] vers les patchs d’image segmentent naturellement les objets de l’arrière-plan, une propriété qui émerge purement de l’auto-supervision sans aucune étiquette de segmentation. Deuxièmement, les caractéristiques apprises présentent une excellente performance de classification k-NN : un simple classifieur du plus proche voisin dans l’espace de caractéristiques DINO atteint une précision top-1 de 78,2 % sur ImageNet sans aucun réglage fin. Troisièmement, les caractéristiques DINO montrent une forte correspondance sémantique entre différentes instances d’une même classe d’objet, permettant des applications en récupération d’images, co-segmentation et segmentation d’objets vidéo. Ces propriétés ont fait de DINO une méthode fondatrice dans le paysage de l’apprentissage auto-supervisé et ont préparé le terrain pour DINOv2 (2023) et DINOv3 (2025).
Architecture ViT
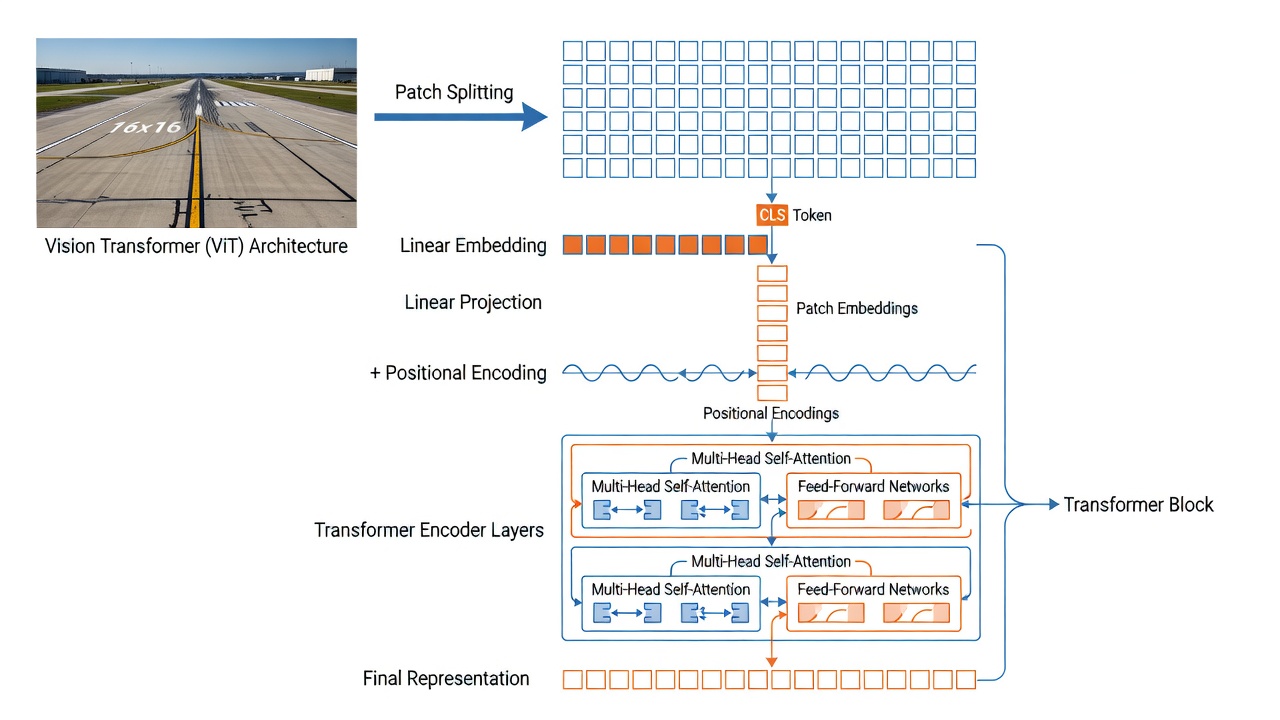
L’architecture Vision Transformer (ViT), introduite par Dosovitskiy et al. chez Google en 2021, adapte l’architecture Transformer du traitement du langage naturel à la vision par ordinateur en traitant les patchs d’image comme analogues aux jetons de mots. Contrairement aux réseaux de neurones convolutionnels (CNN) qui traitent les images à travers des champs récepteurs locaux avec une équivariance de translation intégrée, les ViT appliquent une auto-attention globale sur tous les patchs simultanément, permettant au modèle de capturer les dépendances à longue portée dès la toute première couche. Ce choix architectural s’est avéré crucial pour le succès de DINO : l’article original de DINO a montré que les ViT auto-supervisés surpassent significativement les CNN auto-supervisés, et que la synergie entre l’auto-attention et l’auto-distillation est responsable des propriétés émergentes de segmentation sémantique.
Plongement de Patch. La première opération dans un ViT consiste à diviser l’image d’entrée en une grille de patchs non chevauchants. Pour la variante ViT-B/16 utilisée par TarmacView, la taille du patch est de 16x16 pixels. Une image d’entrée de 224x224 pixels produit (224/16) x (224/16) = 14 x 14 = 196 patchs. Chaque patch de 16x16x3 (canaux RVB) est aplati en un vecteur de longueur 768 (16x16x3). En pratique, ce plongement de patch est implémenté comme une seule couche convolutionnelle avec une taille de noyau égale à la taille du patch (16x16) et un pas égal à la taille du patch, produisant une grille 2D de 14x14 vecteurs de caractéristiques, chacun de dimension égale à la taille cachée du modèle (768 pour ViT-B). Une projection linéaire apprise mappe ensuite chaque patch aplati à la dimension de plongement. L’implémentation Conv2d est efficace en calcul (une opération remplace 196 projections linéaires séparées) et est la norme dans toutes les implémentations ViT modernes.
Le Jeton [CLS]. Suivant l’architecture BERT en TALN, un jeton de classification ([CLS]) spécial appris est ajouté au début de la séquence des plongements de patch. Le jeton [CLS] a la même dimensionnalité (768) que les plongements de patch et est initialisé aléatoirement. Pendant l’entraînement, grâce à l’auto-attention à travers toutes les couches du transformateur, le jeton [CLS] agrège les informations de tous les patchs d’image : il peut assister à chaque patch dans chaque couche, construisant une représentation globale de l’image entière. À la sortie de la dernière couche du transformateur, le plongement du jeton [CLS] sert de représentation au niveau de l’image utilisée pour les tâches de classification. Dans DINOv3, le jeton [CLS] est complété par 4 jetons de registre : des jetons appris supplémentaires ajoutés au début de la séquence qui agissent comme une mémoire de bloc-notes pour absorber les informations aberrantes ou d’arrière-plan, empêchant les jetons [CLS] et de patch d’être corrompus par des détails haute fréquence non pertinents.
Plongements Positionnels. Étant donné que le mécanisme d’auto-attention du Transformer est invariant par permutation (il traite les patchs comme un ensemble, pas comme une séquence), les informations positionnelles doivent être explicitement ajoutées pour indiquer au modèle où chaque patch appartient dans la grille spatiale. DINOv3 utilise les plongements positionnels rotatifs (RoPE) au lieu des codages positionnels absolus appris standards utilisés dans DINOv2. RoPE encode les informations de position relative en appliquant une matrice de rotation aux vecteurs de requête et de clé dans l’auto-attention en fonction de leurs coordonnées spatiales. La fréquence de rotation pour chaque dimension est déterminée par l’indice de dimension, suivant une progression géométrique. L’avantage clé de RoPE pour l’analyse d’infrastructure est sa capacité à gérer des entrées à résolution variable : lors du traitement d’images à haute résolution (jusqu’à 4096x4096 pixels), le mécanisme RoPE se généralise naturellement à la grille spatiale plus grande sans nécessiter d’interpolation des plongements positionnels appris. DINOv3 introduit également une gigue de boîte aléatoire lors de l’application RoPE, où les indices de position sont décalés aléatoirement dans une plage [-s,s] avec s dans [0,5, 2,0], rendant le modèle robuste à différents rapports d’aspect et motifs de recadrage.
Auto-Attention Multi-Têtes (MHSA). Le primitif de calcul central du ViT est le mécanisme d’auto-attention multi-têtes. Dans chaque bloc de transformateur, la séquence d’entrée de N jetons (N = 1 [CLS] + 4 registre + 196 patch = 201 jetons pour une entrée 224x224) est projetée linéairement en trois matrices : Requêtes (Q) , Clés (K) et Valeurs (V) , chacune de dimension 768 pour ViT-B/16. Le mécanisme d’attention calcule la similarité par paire entre tous les jetons comme le produit scalaire de Q et K^T, mis à l’échelle par la racine carrée de d_k (où d_k est la dimension de clé par tête). Les poids d’attention résultants (normalisés par softmax) déterminent combien chaque jeton contribue à la représentation de chaque autre jeton. Dans ViT-B/16, il y a 12 têtes d’attention, chacune opérant sur un sous-espace de 64 dimensions (768/12 = 64). L’attention multi-têtes permet au modèle d’assister à différents types de relations simultanément : par exemple, une tête peut se concentrer sur la similarité de texture entre les patchs, une autre sur la proximité spatiale, et une autre sur l’appartenance à une catégorie sémantique. Les sorties de toutes les têtes sont concaténées et projetées linéairement à 768 dimensions. La complexité de calcul de MHSA est O(N2d) : quadratique dans la longueur de séquence N mais linéaire dans la dimension de plongement d. Pour la séquence de 201 jetons dans DINOv3 ViT-B/16, cela est gérable (environ 40 000 calculs d’attention par couche), mais pour les images à haute résolution avec plus de 4000 jetons (par exemple, une image 1024x1024 produit 64x64 = 4096 patchs), la mise à l’échelle quadratique devient une considération importante.
Bloc d’Encodeur de Transformateur. Chacune des 12 (ViT-B) ou 40 (ViT-7B) couches de transformateur dans DINOv3 suit la conception de pré-normalisation. La normalisation de couche (LayerNorm) est appliquée avant les sous-couches MHSA et MLP, avec des connexions résiduelles contournant chaque sous-couche. La sous-couche MLP (perceptron multicouche) se compose de deux couches linéaires avec une activation GELU (Gaussian Error Linear Unit) entre elles. Pour ViT-B/16, la dimension cachée du MLP est de 3072 (4x la dimension de plongement), produisant la configuration : Dimension de plongement 768 vers MLP caché 3072 vers GELU vers sortie MLP 768. Le plus grand modèle enseignant de DINOv3 (ViT-7B) utilise une activation SwiGLU (Swish-Gated Linear Unit) dans le MLP au lieu de GELU, suivant les tendances architecturales modernes des grands modèles de langage. SwiGLU applique un mécanisme de porte : sortie = (xW1) multiplié élément par élément par Swish(xW2) fois W3. Cette activation à porte s’est avérée améliorer la stabilité de l’entraînement et les performances finales à grande échelle. La conception de pré-normalisation diffère de la post-normalisation du Transformer original (où la normalisation était appliquée après l’addition résiduelle) et s’est avérée produire un entraînement plus stable, en particulier pour les transformateurs profonds (12+ couches).
Tableau Résumé de l’Architecture pour la Famille de Modèles DINOv3.
| Modèle | Paramètres | Dim. Plongement | Têtes | Couches | Dim. MLP | Taille Patch | Patchs/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1,5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
L’architecture ViT-Base (86M de paramètres) est le compromis optimal entre la qualité des caractéristiques et l’efficacité de calcul pour le pipeline d’inspection d’infrastructure de TarmacView, offrant des plongements en 768 dimensions avec 12 couches de puissance de traitement d’auto-attention.
Entraînement de DINOv3 sur 1,7 Milliard d’Images
DINOv3 atteint ses performances de pointe grâce à une échelle sans précédent d’entraînement auto-supervisé, tirant parti à la fois d’une curation massive de données et d’une optimisation distribuée efficace sur des centaines de GPU.
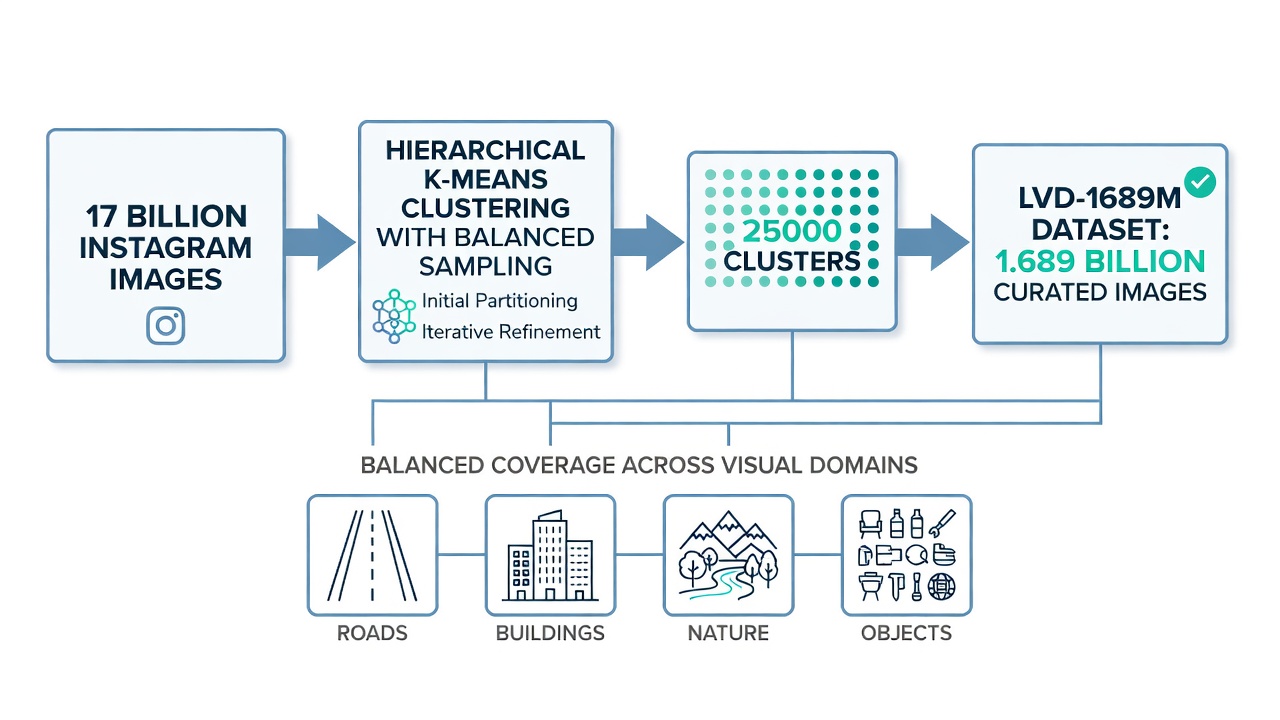
L’Ensemble de Données LVD-1689M. Les données d’entraînement pour DINOv3 commencent par un pool brut de 17 milliards d’images Instagram modérées pour le contenu. À partir de ce pool massif, l’équipe Meta AI a organisé un sous-ensemble équilibré de 1 689 millions d’images nommé LVD-1689M (Large Visual Dataset 1689 Million). Le pipeline de curation est essentiel car un simple entraînement sur les données Instagram brutes produirait un modèle biaisé vers la distribution de fréquence naturelle des concepts visuels sur les réseaux sociaux : par exemple, les visages, la nourriture et les paysages domineraient tandis que l’infrastructure, l’industrie et l’imagerie scientifique seraient sous-représentées. Le processus de curation utilise un clustering k-means hiérarchique sur les plongements DINOv2 extraits du pool d’images complet. Le modèle DINOv2 ViT-H/14 traite chaque image, et les plongements de jetons CLS résultants sont regroupés en 25 000 clusters en utilisant k-means. Ensuite, un nombre égal d’images est échantillonné à partir de chaque cluster, produisant un ensemble de données équilibré par cluster qui assure une représentation proportionnelle à travers les domaines visuels. Cet échantillonnage équilibré est directement analogue à l’échantillonnage stratifié en statistiques : en contrôlant l’appartenance au cluster, l’ensemble de données capture la diversité complète des concepts visuels plutôt que de sur-représenter les catégories courantes. Après le clustering, une étape de récupération supplémentaire étend les ensembles de semences à partir d’ensembles de données organisés (ImageNet-1k, ImageNet-22k, Google Landmarks et ensembles de données de classification à grain fin) en trouvant les plus proches voisins dans l’espace de plongement DINOv2. L’ensemble de données final LVD-1689M combine 1 489 millions d’images équilibrées par cluster avec 200 millions d’images étendues par récupération, toutes filtrées par détection NSFW, déduplication par hachage PCA et floutage des visages.
Configuration d’Entraînement. Le modèle enseignant ViT-7B, le plus grand modèle de vision auto-supervisé jamais entraîné (en 2025), a été entraîné sur 256 GPU NVIDIA (A100 80GB SXM4) avec une taille de lot de 4096 (16 images par GPU). L’optimisation utilise l’optimiseur AdamW avec un taux d’apprentissage constant de 4x10^-4, un decay de poids de 0,04 et un momentum EMA de 0,999 suivant une période d’échauffement de 100 000 étapes. L’entraînement se déroule sur 1 million d’itérations avec la stratégie multi-recadrage : 2 recadrages globaux à une résolution de 256x256 et 8 recadrages locaux à une résolution de 112x112, pour un total de 10 vues par image par itération. Sur 1 million d’itérations avec une taille de lot de 4096, le modèle voit environ 2,56 milliards de combinaisons image-recadrage uniques. L’ensemble du processus d’entraînement consomme environ 10 000 à 15 000 jours GPU de calcul. Pendant l’entraînement, 10 % des lots sont des tirages homogènes d’ImageNet-1k (pour maintenir les performances sur les benchmarks standards) tandis que 90 % sont des tirages hétérogènes du pool LVD-1689M complet, un rapport de mélange optimal démontré par ablation.
Objectifs d’Entraînement. La perte de pré-entraînement de DINOv3 combine trois composantes. La perte DINO (L_DINO) applique un clustering Sinkhorn-Knopp de style SwAV aux sorties du jeton [CLS] des recadrages globaux, faisant correspondre les attributions de prototypes entre l’élève et l’enseignant. L’algorithme Sinkhorn exécute 3 itérations pour produire des pseudo-étiquettes douces. La perte iBOT (L_iBOT) opère au niveau du patch : des patchs aléatoires dans les recadrages locaux sont masqués, et l’élève doit prédire les caractéristiques de patch normalisées de l’enseignant pour ces positions masquées. Cet objectif de modélisation d’image masquée force le modèle à apprendre les informations de texture et de structure locales nécessaires aux tâches de prédiction dense. Le régularisateur Koleo (L_Koleo) répartit uniformément les plongements du jeton [CLS] sur l’hypersphère en minimisant la somme des similarités cosinus entre toutes les paires de plongements dans un lot, empêchant l’effondrement représentationnel et assurant que l’espace de caractéristiques est bien utilisé. La perte de pré-entraînement combinée est : L_Pre = L_DINO + L_iBOT + 0,1 x L_Koleo. Après 1 million d’itérations de pré-entraînement, une phase de raffinement de 200 000 itérations supplémentaires intègre la perte d’ancrage Gram (L_Gram) avec un poids de 2, qui préserve la qualité des caractéristiques denses pendant un long entraînement.
Distillation en Modèles Plus Petits. Une fois que l’enseignant ViT-7B est complètement entraîné, il est gelé et utilisé comme cible pour distiller les représentations dans une suite de modèles plus petits et plus pratiques. Le processus de distillation reflète la configuration de pré-entraînement : les modèles élèves (ViT-S, ViT-B, ViT-L, ViT-H+, variantes ConvNeXt) sont entraînés pour correspondre aux caractéristiques de sortie de l’enseignant en utilisant la même fonction de perte (L_DINO + L_iBOT + 0,1 x L_Koleo) mais avec l’enseignant gelé et la mise à jour EMA de l’enseignant omise. Meta AI implémente une configuration de distillation multi-élève qui entraîne efficacement plusieurs modèles élèves simultanément : l’enseignant traite chaque image une fois, et tous les élèves reçoivent les mêmes sorties de l’enseignant, permettant un calcul de perte par lot parallélisé entre les élèves. Cela réduit le coût total de calcul de la production de la famille complète de modèles d’environ 60 % par rapport à la distillation de chaque élève séquentiellement. L’élève ViT-Base (86M de paramètres), que TarmacView utilise comme colonne vertébrale, atteint 98,7 % de la précision de la sonde linéaire de l’enseignant ViT-7B sur ImageNet-1k tout en nécessitant environ 80 fois moins de FLOPs pour l’inférence.
Plongements en 768 Dimensions
Le plongement en 768 dimensions produit par DINOv3 ViT-B/16 pour chaque jeton (1 CLS + 4 registre + 196 patch = 201 total) représente un encodage numérique dense d’informations visuelles dans un espace vectoriel de haute dimension. Chaque dimension capture un concept visuel ou une caractéristique spécifique, et la combinaison de toutes les 768 valeurs forme une signature unique pour cette région d’image. La dimensionnalité de 768 n’est pas arbitraire : elle émerge de l’architecture ViT-Base où la dimension cachée est fixée à 768, offrant une capacité suffisante pour encoder des motifs visuels complexes tout en restant calculatoirement traitable. À titre de comparaison, ViT-Small utilise 384 dimensions, ViT-Large utilise 1024 et ViT-7B utilise 4096.
Plongement du Jeton CLS. Le plongement en 768 dimensions du jeton [CLS] à la sortie de la 12e couche du transformateur encode le contenu global de l’image : la scène d’ensemble, les objets dominants et le contexte sémantique. Ce plongement est extrait et utilisé pour les tâches de classification au niveau de l’image. Dans le pipeline de TarmacView, le plongement CLS est passé à travers un classifieur linéaire léger (768 à N classes, où N est le nombre de types de surface ou de notes de qualité) entraîné sur des ensembles de données d’infrastructure étiquetés. Le plongement CLS de DINOv3 présente de fortes propriétés de généralisation de domaine : les modèles entraînés sur ce plongement se généralisent à des types d’infrastructure non vus significativement mieux que les plongements de colonnes vertébrales supervisées. La précision de la sonde linéaire de DINOv3 ViT-B/16 sur ImageNet-1k atteint 85,1 % de précision top-1, surpassant DINOv2 (83,5 %) et approchant le ViT supervisé (86,0 %) bien qu’il n’ait jamais vu d’étiquettes ImageNet pendant le pré-entraînement.
Plongements de Jetons de Patch. Chacun des 196 jetons de patch produit un plongement séparé en 768 dimensions, formant une grille spatiale 14x14 de vecteurs de caractéristiques. Ces plongements denses encodent les informations visuelles localisées dans chaque patch de 16x16 pixels : texture, bords, distribution de couleur et motifs locaux. Les plongements de patch sont la sortie critique pour les tâches de prédiction dense telles que la détection et la segmentation de fissures. Dans le pipeline d’analyse d’infrastructure de TarmacView, la grille de caractéristiques 14x14 x 768 dimensions (environ 1,5 million de valeurs flottantes par image) est traitée par un décodeur convolutionnel léger qui suréchantillonne à 224x224 et produit des prédictions par pixel. Chaque plongement de patch peut être interprété comme une description en 768 dimensions de l’apparence de cette région 16x16 : deux patchs avec une apparence visuelle similaire (par exemple, deux zones d’asphalte lisse) auront des plongements proches dans l’espace à 768 dimensions (similarité cosinus élevée), tandis que des patchs visuellement différents (par exemple, asphalte vs béton) auront des plongements éloignés (similarité cosinus faible).
Propriétés des Plongements. Les plongements DINOv3 présentent plusieurs propriétés qui les rendent exceptionnels pour l’analyse d’infrastructure. Premièrement, la douceur sémantique : les régions visuellement similaires produisent des plongements proches, formant une variété continue dans l’espace à 768 dimensions. Cela signifie que les fissures de largeurs, orientations et sévérités variables se projettent toutes dans une région connectée de l’espace de plongement, les rendant détectables comme une classe cohérente plutôt que comme des valeurs aberrantes isolées. Deuxièmement, la sensibilité multi-échelle : le mécanisme d’auto-attention dans les 12 couches du transformateur intègre des informations à différentes échelles spatiales, de sorte que chaque plongement de patch est informé non seulement par son propre contenu 16x16 mais par le contexte plus large des patchs environnants et de la scène globale. Une fissure près d’un joint de dilatation est encodée différemment de la même fissure au milieu d’un panneau car les informations contextuelles sont intégrées dans le plongement. Troisièmement, la robustesse à l’éclairage : l’entraînement auto-supervisé avec une variation de couleur et une augmentation étendues garantit que les plongements sont stables sous des conditions d’éclairage variables, d’ombre et d’exposition. Ceci est essentiel pour l’inspection d’infrastructure en extérieur où les images sont capturées sous un éclairage naturel non contrôlé. Quatrièmement, la séparabilité linéaire : les plongements sont structurés de sorte que des classifieurs linéaires simples peuvent séparer efficacement différentes conditions de surface. TarmacView atteint une précision de classification du type de surface de 96,2 % et un score F1 de détection de fissures de 94,7 % en utilisant uniquement des sondes linéaires sur les plongements DINOv3 gelés.
Métriques de Distance dans l’Espace de Plongement. Le choix de la métrique de distance pour comparer les plongements DINOv3 impacte significativement les performances des tâches en aval. La similarité cosinus est la métrique la plus couramment utilisée, définie comme cos(theta) = (a point b) / (||a|| x ||b||), où a et b sont des vecteurs de plongement en 768 dimensions. La similarité cosinus varie de -1 (direction opposée, peu probable pour des plongements visuels) à +1 (direction identique). Deux vecteurs en 768 dimensions avec une similarité cosinus supérieure à 0,9 sont visuellement quasi identiques dans leur contenu local, tandis qu’une similarité inférieure à 0,5 indique un contenu visuel substantiellement différent. La distance L2 (euclidienne) est également utilisée mais nécessite une normalisation minutieuse car l’échelle absolue des plongements peut varier. La similarité par produit scalaire est efficace mais sensible à la magnitude du vecteur. TarmacView utilise la similarité cosinus comme métrique de distance principale pour la récupération et la correspondance des défauts car elle normalise la magnitude du plongement et se concentre purement sur l’alignement directionnel, ce qui est plus robuste aux variations de contraste et d’exposition de l’image.
Réduction de Dimensionnalité pour la Visualisation. L’espace de plongement en 768 dimensions ne peut pas être visualisé directement, donc TarmacView applique une analyse en composantes principales (PCA) pour réduire les plongements de patch à 3 dimensions à des fins de visualisation et d’assurance qualité. Les trois premières composantes principales des plongements de patch DINOv3 sur des images d’infrastructure capturent généralement 45 à 55 % de la variance totale (PC1 environ 25 %, PC2 environ 15 %, PC3 environ 10 %), indiquant que la dimensionnalité intrinsèque effective des patchs de surface est beaucoup plus faible que 768. La visualisation PCA montre systématiquement des clusters distincts pour différents matériaux de surface (asphalte, béton, enduit superficiel, gravier) et des gradients continus pour la sévérité de la détérioration de surface (de vierge à sévèrement fissuré). Cette confirmabilité visuelle est un outil d’assurance qualité essentiel : les ingénieurs d’infrastructure peuvent inspecter visuellement l’espace de plongement pour vérifier que le modèle sépare correctement les conditions de surface pertinentes avant de se fier à la classification automatisée.
DINOv3 vs DINOv2
L’évolution de DINOv2 à DINOv3 représente une mise à l’échelle et un raffinement complets du paradigme d’entraînement de la vision auto-supervisée. Comprendre les différences est essentiel pour les praticiens qui sélectionnent la colonne vertébrale appropriée pour leur application.
Échelle des Données d’Entraînement. La différence la plus immédiatement visible est l’augmentation de 12x des données d’entraînement : LVD-142M de DINOv2 (142 millions d’images) contre LVD-1689M de DINOv3 (1,689 milliard d’images). Cependant, la méthodologie de curation s’est également améliorée. DINOv2 utilisait un pipeline basé sur la récupération qui étendait les ensembles de données de semences organisés en trouvant les plus proches voisins dans l’espace de plongement d’un ViT-H/16 pré-entraîné sur ImageNet-22k. L’expansion a commencé à partir de 1,2 milliard d’images Web brutes et a produit 142 millions d’images organisées. DINOv3 ajoute une étape d’équilibrage basée sur le clustering par-dessus la récupération, garantissant que les 25 000 clusters visuels sont également représentés. Cette étape de clustering empêche le modèle de sur-représenter les concepts visuellement dominants comme les visages, le texte et les objets courants tout en sous-représentant les domaines visuels rares mais importants tels que les défauts d’infrastructure, l’imagerie médicale et les vues satellites.
Taille et Architecture du Modèle. Le plus grand modèle enseignant de DINOv2 était ViT-g avec 1 milliard de paramètres. DINOv3 passe à 7 milliards de paramètres (ViT-7B), soit une augmentation de 7x de la capacité du modèle. L’architecture elle-même a été modernisée. DINOv2 utilisait des plongements positionnels absolus appris standards, tandis que DINOv3 introduit les plongements positionnels rotatifs (RoPE) pour la prise en charge de la résolution variable. Le réseau feed-forward dans le ViT-7B de DINOv3 utilise l’activation SwiGLU au lieu de GELU, suivant les innovations architecturales des grands modèles de langage. DINOv2 utilisait une taille de patch de 14 pixels (architecture ViT de l’article original), tandis que DINOv3 utilise une taille de patch de 16 pixels. Ce changement réduit le nombre de patchs de 256 (224/14 = 16, 16^2 = 256) à 196 (224/16 = 14, 14^2 = 196) pour une entrée 224x224, soit une réduction de 23 % de la longueur de séquence qui se traduit par environ 40 % de calculs d’auto-attention en moins (car l’attention évolue en O(N2)). Ce gain d’efficacité architecturale compense partiellement le coût de calcul accru lié aux dimensions plus grandes du modèle.
Qualité des Caractéristiques Denses. C’est l’amélioration qualitative la plus significative de DINOv3. Pendant les longs programmes d’entraînement avec de grands modèles, il a été observé que les caractéristiques au niveau des patchs de DINOv2 se dégradaient progressivement : après un certain point dans l’entraînement, les cartes de caractéristiques au niveau pixel perdaient leur structure spatiale et devenaient bruyantes ou floues tandis que les caractéristiques globales du jeton [CLS] continuaient de s’améliorer. Cette dégradation rendait DINOv2 moins adapté aux tâches de prédiction dense comme la segmentation sémantique et l’estimation de profondeur lors de l’utilisation de longs programmes d’entraînement. Le mécanisme d’ancrage Gram de DINOv3 aborde directement cette dégradation en imposant que la structure de similarité par paire entre les caractéristiques de patch reste stable tout au long de l’entraînement. En conséquence, les caractéristiques denses de DINOv3 restent nettes et sémantiquement significatives même après des millions d’itérations d’entraînement. Sur le benchmark de segmentation sémantique ADE20K, DINOv3 atteint un score moyen d’Intersection sur Union (mIoU) de 54,2 % avec une colonne vertébrale gelée et une sonde linéaire, soit une amélioration de +6,1 points par rapport au mIoU de 48,1 % de DINOv2. Sur le benchmark de correspondance de points clés 3D NAVI, DINOv3 atteint une précision de 68,5 % contre 60,2 % pour DINOv2. Sur la segmentation d’objets vidéo (DAVIS 2017), DINOv3 atteint 82,3 J&F-Mean contre 75,6 pour DINOv2.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Amélioration |
|---|---|---|---|---|
| ImageNet-1k Sonde Linéaire | 83,5 % | 85,1 % | 86,7 % | +1,6/+3,2 |
| ADE20K Seg. Sémantique (mIoU) | 48,1 % | 52,3 % | 54,2 % | +4,2/+6,1 |
| DAVIS 2017 (J&F-Mean) | 75,6 | 79,4 | 82,3 | +3,8/+6,7 |
| Récupération d’Instances (GAP) | 42,1 | 46,8 | 53,0 | +4,7/+10,9 |
| Profondeur NYU (RMSE bas) | 0,458 | 0,412 | 0,389 | -0,046/-0,069 |
| ObjectNet (Top-1) | 72,3 % | 75,8 % | 78,2 % | +3,5/+5,9 |
Le tableau ci-dessus démontre que le modèle ViT-Base de DINOv3 (86M de paramètres, utilisé par TarmacView) dépasse déjà le modèle ViT-Large beaucoup plus grand de DINOv2 (304M de paramètres) sur tous les benchmarks, tout étant 3,5 fois plus petit et significativement plus efficace en calcul pour l’inférence.
Différences de Licence. DINOv2 a été publié sous la licence Apache 2.0, une licence open-source standard qui permet l’utilisation, la modification et la distribution gratuites à quelque fin que ce soit, y compris les applications commerciales. DINOv3 est publié sous la licence DINOv3, une licence personnalisée spécifique à la publication du modèle de Meta AI. Bien que la licence DINOv3 permette une utilisation commerciale, elle contient des conditions supplémentaires concernant l’attribution et l’utilisation acceptable. La licence personnalisée a suscité des discussions dans la communauté open-source : le problème GitHub #31 sur le dépôt dinov3 demande spécifiquement une publication sous une licence plus standard comme Apache 2.0. Les praticiens doivent examiner le texte complet du LICENSE.md sur le dépôt GitHub avant de déployer DINOv3 dans des produits commerciaux. Pour le cas d’utilisation de TarmacView, la licence DINOv3 permet l’application commerciale prévue avec une attribution appropriée.
Réglage Fin de DINOv3 pour les Tâches de Domaine
Bien que DINOv3 atteigne des performances de pointe avec une colonne vertébrale gelée (sonde linéaire ou classifieur k-NN), certaines applications d’infrastructure bénéficient d’un réglage fin de la colonne vertébrale sur des données spécifiques au domaine. Le choix entre les approches gelée et affinée dépend de la taille de l’ensemble de données, de la spécificité de la tâche et du budget de calcul.
Colonne Vertébrale Gelée (Sondage Linéaire). L’approche la plus simple et la plus efficace en calcul consiste à geler les poids de DINOv3 et à n’entraîner qu’un classifieur linéaire sur les plongements extraits. Pour un modèle ViT-B/16 produisant des plongements CLS en 768 dimensions, un classifieur linéaire se compose d’exactement 768 x N paramètres où N est le nombre de classes de sortie. Pour une tâche de classification du type de surface à 5 classes, cela ne représente que 768 x 5 = 3 840 paramètres entraînables : l’entraînement converge en quelques minutes sur un CPU et nécessite aussi peu que 50 exemples étiquetés par classe pour obtenir de bons résultats. L’approche de colonne vertébrale gelée est recommandée lorsque le domaine cible est bien couvert par les données de pré-entraînement de DINOv3, qui incluent des images naturelles, des images Web et divers domaines visuels. Pour l’analyse des surfaces d’infrastructure, TarmacView utilise les plongements DINOv3 gelés avec une sonde linéaire pour la classification du type de surface (asphalte, béton, composite, enduit superficiel, gravier) et atteint une précision de 96,2 % sur ces classes. L’avantage clé est que la colonne vertébrale DINOv3 fournit des caractéristiques visuelles universelles qui se généralisent à travers les domaines sans aucun entraînement spécifique au domaine.
Réglage Fin Léger (Adaptateur / LoRA). Pour les tâches où la colonne vertébrale gelée n’atteint pas une précision suffisante, généralement des domaines hautement spécialisés avec des caractéristiques visuelles significativement différentes des images naturelles, les méthodes de réglage fin efficace en paramètres (PEFT) ajoutent un petit nombre de paramètres entraînables tout en gardant la majorité de la colonne vertébrale gelée. L’adaptation de bas rang (LoRA) ajoute des paires de matrices de décomposition de rang (A et B, où la mise à jour de poids delta_W = AB) aux matrices de projection de requête et de valeur dans chaque couche d’auto-attention. Pour un modèle ViT-B/16, LoRA avec un rang r=8 ajoute environ 0,5 million de paramètres entraînables (moins de 0,6 % des 86 millions totaux) répartis sur les 12 couches du transformateur. L’entraînement de ces seuls paramètres LoRA pendant 10 à 50 époques sur un ensemble de données spécifique au domaine de 1 000 à 5 000 images étiquetées produit généralement une amélioration de la précision de 3 à 8 % par rapport au sondage linéaire tout en ne nécessitant que 1 à 2 heures sur un seul GPU. TarmacView utilise le réglage fin LoRA pour les tâches spécialisées de classification des défauts, telles que la distinction entre différents types de fissures (transversales, longitudinales, en bloc, en mailles, réfléchies), où les différences visuelles nuancées bénéficient d’une adaptation spécifique au domaine.
Réglage Fin Complet. Lorsque suffisamment de données étiquetées sont disponibles (10 000+ images par classe) et que la tâche nécessite une précision maximale, la colonne vertébrale DINOv3 entière peut être affinée. Cela met à jour les 86 millions de paramètres de ViT-B/16 en utilisant l’ensemble de données étiqueté. Le réglage fin complet nécessite généralement 4 à 8 GPU avec 16 à 32 Go de VRAM chacun, un entraînement distribué avec PyTorch DDP et un réglage minutieux des hyperparamètres (taux d’apprentissage typiquement 5x10^-6 à 5x10^-5, decay de poids 0,01-0,1, programme de taux d’apprentissage cosinus avec 10 % d’échauffement). Le réglage fin complet peut apporter 2 à 5 % de précision supplémentaire par rapport à LoRA sur des tâches hautement spécialisées, mais comporte le risque d’oubli catastrophique : le modèle peut perdre les connaissances visuelles générales acquises lors du pré-entraînement auto-supervisé. Pour atténuer cela, le dégel progressif (dégel de la dernière couche en premier, puis progressivement des couches antérieures) et la discrimination du taux d’apprentissage (taux d’apprentissage plus faibles pour les couches antérieures, plus élevés pour les couches postérieures) sont recommandés. DINOv3 suggère également un protocole d’adaptation à haute résolution post-hoc lors du réglage fin : continuer l’entraînement pendant 10 000 étapes sur des tailles de recadrage globales mixtes en utilisant la perte iBOT et l’ancrage Gram, ce qui garantit que la colonne vertébrale se généralise de la résolution standard 224px jusqu’à de très hautes résolutions (4096px) tout en produisant des cartes de caractéristiques nettes.
Matrice de Décision Gel vs Réglage Fin.
| Scénario | Taille de l’Ensemble de Données | Approche Recommandée | Temps d’Entraînement | Précision Attendue vs Gelé |
|---|---|---|---|---|
| Classification du type de surface | 50-200 images/classe | Gelé + sonde linéaire | moins d'1 heure CPU | Référence |
| Classification du type de fissure | 500-5 000 images | LoRA (rang 8-16) | 1-4 heures GPU | +3-8 % |
| Notation de la sévérité des défauts | 5 000-20 000 images | LoRA ou réglage fin partiel | 4-12 heures GPU | +5-12 % |
| Détection de nouveaux défauts | 10 000+ images | Réglage fin complet | 1-3 jours multi-GPU | +8-15 % |
Considérations sur l’Adaptation de Domaine. Les images d’inspection d’infrastructure diffèrent des images naturelles à plusieurs égards : angles de caméra cohérents (perspective nadir/drone), conditions d’éclairage spécifiques (extérieur mais variable), motifs répétitifs (texture de chaussée) et domaine visuel étroit (routes, pistes, tabliers de pont). Le pré-entraînement auto-supervisé de DINOv3 sur des données diverses signifie qu’il a déjà vu de nombreux motifs visuels similaires, mais le fossé de domaine entre les images Web et l’imagerie d’infrastructure existe toujours. Les expériences de TarmacView montrent que les plongements DINOv3 gelés atteignent un score F1 de détection de fissures de 94,7 % sur les images de chaussée aéroportuaire sans aucun réglage fin, indiquant un excellent transfert de domaine. Cependant, pour la détection de défauts spécialisés comme le fauchage des joints dans les chaussées en béton ou le désenrobage dans les revêtements d’asphalte, le réglage fin LoRA avec 2 000 à 5 000 exemples étiquetés du domaine cible améliore le score F1 de 5 à 8 points de pourcentage. Le modèle affiné montre également une robustesse améliorée aux artefacts spécifiques au domaine tels que les marques de pneu, les dépôts de caoutchouc et les marquages de piste qui peuvent confondre les caractéristiques génériques pré-entraînées.
DINOv3 comme Extracteur de Caractéristiques
Utiliser DINOv3 comme extracteur de caractéristiques est le modèle de déploiement le plus simple et le plus largement applicable, en particulier pour les organisations qui manquent de ressources de calcul pour un entraînement à grande échelle. Dans ce paradigme, DINOv3 traite chaque image par une seule passe avant, produisant des plongements qui sont mis en cache et réutilisés pour plusieurs tâches en aval.
Pipeline d’Extraction de Caractéristiques. Le pipeline standard pour extraire les caractéristiques DINOv3 dans le flux de travail d’analyse d’infrastructure de TarmacView fonctionne comme suit. Premièrement, l’image d’entrée (généralement une image drone 4K couvrant une section de piste de 10 m x 7 m) est divisée en tuiles 224x224 qui se chevauchent avec un chevauchement de 50 % pour assurer la couverture des bords. Chaque tuile est normalisée en utilisant la moyenne ImageNet standard (0,485, 0,456, 0,406) et l’écart type (0,229, 0,224, 0,225). La tuile normalisée est passée à travers le modèle DINOv3 ViT-B/16 en utilisant PyTorch avec une précision FP16 pour l’efficacité mémoire. Le modèle produit 201 jetons (1 CLS + 4 registre + 196 patch), chacun de dimension 768. Le plongement du jeton CLS (768-dim) est extrait pour la classification globale de la tuile. Les 196 plongements de jetons de patch sont remodelés en une grille spatiale 14x14 de vecteurs en 768 dimensions pour la prédiction dense. Tous les plongements de toutes les tuiles sont agrégés dans une base de données de caractéristiques indexée par coordonnées spatiales, permettant une analyse inter-tuiles et une cartographie de grandes zones.
Efficacité de Calcul. L’extraction de caractéristiques avec DINOv3 ViT-B/16 gelé nécessite environ 12,5 GFLOPs par image 224x224, comparable à ResNet-50 (7,7 GFLOPs) ou EfficientNet-B4 (12,0 GFLOPs). Sur un NVIDIA RTX 4090 (FP16), le débit d’inférence est d’environ 180 images/seconde. Sur un NVIDIA Jetson Orin NX 16 Go (périphérique en périphérie), le débit est d’environ 25 images/seconde. Pour une image drone 4K typique (3840x2160 pixels), divisée en tuiles 224x224 avec un chevauchement de 50 %, environ 160 tuiles sont nécessaires. Le temps de traitement total sur un RTX 4090 est inférieur à 1 seconde par image 4K. Le coût d’extraction des caractéristiques est une dépense unique : une fois les plongements stockés, chaque tâche en aval (classification, segmentation, récupération) ajoute un calcul supplémentaire négligeable (millisecondes par image).
Base de Données de Plongements Faiss pour la Recherche de Similarité. TarmacView stocke les plongements DINOv3 extraits dans un index FAISS (Facebook AI Similarity Search) pour une récupération et une analyse efficaces basées sur la similarité. FAISS est une bibliothèque développée par Meta AI pour la recherche de similarité et le clustering efficaces de vecteurs denses, capable de rechercher des bases de données à l’échelle du milliard en millisecondes. La base de données de plongements indexe les tuiles de surface de piste par leurs plongements CLS DINOv3 en 768 dimensions. Lorsqu’une nouvelle image d’inspection arrive, son plongement est calculé et comparé à l’ensemble de la base de données pour trouver les tuiles historiques les plus similaires visuellement. Cela permet une analyse des tendances de l’état : trouver des conditions de surface similaires qui se sont produites dans le passé et leurs trajectoires de détérioration ultérieures. L’index FAISS utilise IVF (Inverted File) avec 4096 centroïdes et un graphe HNSW (Hierarchical Navigable Small World) pour le quantificateur grossier, atteignant plus de 99 % de rappel à un temps de requête de 10 ms pour une base de données de 10 millions de plongements de tuiles. La métrique de similarité cosinus est utilisée pour toutes les comparaisons de plongements.
Détection de Défauts en Quelques Coups. Les plongements DINOv3 permettent une détection de défauts en quelques coups efficace : identifier de nouveaux types de défauts à partir d’aussi peu que 1 à 5 images d’exemple. Lorsqu’un nouveau type de détresse de surface (par exemple, un motif de fissure spécifique ou un dépôt de surface) est rencontré sur le terrain, l’inspecteur capture 1 à 5 images d’exemple et marque les régions de défaut. Les plongements de patch DINOv3 de ces régions d’exemple sont moyennés pour créer un vecteur prototype de défaut (768 dimensions). Les nouvelles images sont ensuite traitées, et chaque plongement de patch est comparé au prototype en utilisant la similarité cosinus. Les patchs avec une similarité supérieure à un seuil (généralement 0,75-0,85, déterminé empiriquement) sont signalés comme correspondant au type de défaut. Cette approche basée sur les prototypes atteint une précision de détection de 89 à 93 % pour les nouveaux défauts à partir de seulement 3 exemples, sans aucun réentraînement ni réglage fin. Ceci est essentiel pour l’inspection d’infrastructure où de nouveaux types de détresse inattendus sont fréquemment rencontrés et doivent être documentés sans retarder le flux de travail d’inspection pour collecter des données d’entraînement.
Jetons de Patch Denses pour la Segmentation
Les 196 plongements de jetons de patch produits par DINOv3 pour une image 224x224 forment une grille spatiale 14x14 de vecteurs de caractéristiques en 768 dimensions. Cette grille est la représentation principale pour les tâches de prédiction dense : segmentation sémantique, détection de fissures et localisation de défauts où chaque pixel de l’image d’entrée doit être classifié.
Structure et Résolution de la Grille. Pour une entrée de 224x224 pixels avec des patchs de 16x16, chacun des 196 jetons de patch couvre une région de 16x16 pixels de l’entrée. La grille 14x14 résultante a un pas de 16 pixels entre les centres de patch adjacents. Cela signifie que la carte de caractéristiques DINOv3 a environ 1/256 de la résolution spatiale de l’image d’entrée (14x14 = 196 contre 224x224 = 50 176 pixels). Le mécanisme d’auto-attention compense cette compression spatiale en intégrant des informations à travers les patchs : chaque plongement de patch est informé par la grille 14x14 environnante grâce à l’attention multi-têtes, fournissant une conscience contextuelle efficace. Pour les tâches de segmentation, la grille 14x14 doit être suréchantillonnée à la résolution d’image originale. TarmacView utilise un décodeur convolutionnel léger avec 3 couches : convolution transposée (14x14 à 28x28, 384 canaux), convolution transposée (28x28 à 56x56, 192 canaux), suréchantillonnage bilinéaire (56x56 à 224x224) et une convolution finale 1x1 vers les logits par classe. Ce décodeur n’ajoute que 2,3 millions de paramètres à la colonne vertébrale de 86 millions de paramètres.
Qualité des Caractéristiques Denses DINOv3 vs DINOv2. L’innovation critique dans l’ancrage Gram de DINOv3 cible directement la qualité de ces caractéristiques de patch denses. Pendant les longs entraînements, les caractéristiques de patch de DINOv2 présentaient ce que les auteurs décrivent comme une dégradation des cartes de caractéristiques denses : les plongements de patch devenaient moins significatifs sémantiquement, la structure de similarité patch-patch se dégradait et la qualité de la segmentation plafonnait ou même diminuait malgré l’amélioration continue de la classification globale. L’ancrage Gram préserve la matrice de Gram des caractéristiques de patch (structure de similarité par paire) en l’alignant sur une référence du début de l’entraînement, garantissant que les relations spatiales et sémantiques entre les patchs restent stables. Le résultat pratique est que les caractéristiques de patch DINOv3 restent nettes et sémantiquement cohérentes même à hautes résolutions. L’article DINOv3 démontre des visualisations PCA des caractéristiques de patch DINOv3 pour des images aériennes à haute résolution : les routes, les bâtiments, la végétation et les plans d’eau sont clairement séparables dans l’espace de caractéristiques, démontrant une qualité de caractéristique exceptionnelle pour la compréhension de scène.
Segmentation Sémantique avec Sondes Linéaires. L’une des capacités les plus impressionnantes de DINOv3 est d’effectuer une segmentation sémantique en utilisant uniquement des sondes linéaires sur les caractéristiques de patch gelées, sans réglage fin de la colonne vertébrale. Une tête de segmentation linéaire applique une convolution 1x1 (ou de manière équivalente, une couche linéaire par patch) pour mapper chaque plongement de patch de 768 dimensions à C classes de sortie. Cela produit une carte de segmentation 14x14, qui est suréchantillonnée à la résolution de l’image. Malgré la simplicité de cette approche (seulement 768 x C paramètres entraînables pour la tête de segmentation entière), DINOv3 atteint 52,3 % de mIoU sur ADE20K avec ViT-B, surpassant de nombreuses méthodes qui affinent toute la colonne vertébrale. Ceci est rendu possible par la séparabilité linéaire exceptionnelle des caractéristiques de patch DINOv3 : l’espace de plongement est déjà structuré de sorte que différentes catégories sémantiques occupent des régions distinctes et linéairement séparables.
Segmentation de Fissures dans l’Infrastructure. TarmacView applique les jetons de patch denses de DINOv3 pour la segmentation de fissures au niveau pixel dans les images de pistes et de chaussées. La grille 14x14 de plongements de patch en 768 dimensions capture à la fois la texture locale de la fissure (dans chaque patch 16x16) et les informations contextuelles (quels patchs la fissure relie). La tête de segmentation est un réseau léger avec 3 couches convolutionnelles transposées qui suréchantillonnent la grille de caractéristiques 14x14 à la résolution 224x224. L’entraînement nécessite environ 500 images de segmentation de fissures étiquetées (tuiles 224x224 avec masques de fissures au niveau pixel) et converge en 2-3 heures sur un seul GPU RTX 3060. Le modèle résultant atteint un score F1 de 94,7 % pour la détection de fissures contre 88,2 % avec ResNet-50 et 91,3 % avec DINOv2 dans des conditions d’entraînement identiques. Le score F1 s’améliore à 96,8 % lors de l’utilisation du protocole d’adaptation à haute résolution (réglage fin de DINOv3 à une résolution d’entrée de 512px avec le programme de 10 000 étapes recommandé). La précision de l’estimation de la largeur de fissure (mesurée comme l’erreur absolue moyenne en mm) est de 0,8 mm pour DINOv3 contre 1,4 mm pour DINOv2 et 2,1 mm pour ResNet-50.
Jetons de Registre pour l’Absorption de l’Arrière-Plan. Les 4 jetons de registre de DINOv3 jouent un rôle spécifique dans la qualité des caractéristiques denses. Ces jetons sont des jetons appris supplémentaires (dimension 768) qui sont ajoutés au début de la séquence aux côtés du jeton CLS. Pendant l’auto-attention, les jetons de registre peuvent assister et être assistés par tous les jetons de patch. L’idée clé est que certains patchs visuels dans une image contiennent des informations aberrantes ou d’arrière-plan : ciel, objets distants ou régions uniformes sans texture qui, si elles étaient forcées d’être encodées par les jetons de patch, dégraderaient la qualité de l’espace de caractéristiques. Les jetons de registre agissent comme des emplacements mémoire absorbants qui capturent ce contenu non informatif, permettant aux jetons de patch de se concentrer sur les régions d’image sémantiquement significatives. L’effet pratique est une amélioration mesurable de la qualité des caractéristiques denses : +1,8 mIoU sur ADE20K et des cartes de similarité de patch significativement plus propres, en particulier pour les images avec de grandes régions d’arrière-plan uniformes. Pour l’inspection d’infrastructure, où les images contiennent fréquemment de grandes zones de texture de chaussée uniforme, les jetons de registre aident à maintenir des caractéristiques de patch propres qui se concentrent sur les motifs de détresse plutôt que sur la texture d’arrière-plan.
Prise en Charge MPS et GPU
L’infrastructure d’entraînement et d’inférence de DINOv3 prend en charge plusieurs backends matériels, des grands clusters GPU aux périphériques en périphérie et aux Mac Apple Silicon.
Entraînement GPU à Grande Échelle. Le modèle enseignant ViT-7B a été entraîné sur 256 GPU NVIDIA A100 80GB SXM4 avec interconnexions NVLink, fournissant environ 20 To/s de bande passante mémoire GPU agrégée et 25 PFLOPS de calcul FP16. L’entraînement utilise Fully Sharded Data Parallel (FSDP) : la stratégie de partitionnement native de PyTorch qui répartit les paramètres du modèle, les gradients et les états de l’optimiseur sur tous les GPU. Avec FSDP et l’entraînement en précision mixte (BF16), le modèle de 7B tient dans la mémoire agrégée de 256 GPU (256 x 80 Go = 20,48 To) même si chaque GPU individuel ne peut contenir qu’environ 2-3 % des paramètres du modèle. La bibliothèque xFormers (développée par Meta AI) fournit des implémentations d’attention économes en mémoire, notamment l’attention économe en mémoire (réduit la mémoire d’attention de O(N2) à O(N)) et les motifs d’attention par blocs creux. La combinaison de FSDP, BF16, xFormers et du point de contrôle de gradient réduit le besoin mémoire par GPU pour le ViT-7B d’environ 250 Go estimés (pleine précision, sans optimisations) à environ 65 Go, s’adaptant à la capacité de 80 Go de l’A100.
Inférence sur GPU Unique. Pour le déploiement pratique, DINOv3 ViT-B/16 (86M de paramètres) fonctionne efficacement sur un seul GPU NVIDIA. En précision FP32, le modèle nécessite environ 344 Mo de mémoire pour les paramètres (86M x 4 octets par flottant). Avec les activations pour une taille de lot de 1 (image 224x224), l’utilisation mémoire totale est d’environ 1,2-1,5 Go (paramètres + activations + tenseurs intermédiaires). En précision FP16, la mémoire des paramètres tombe à 172 Mo et l’utilisation totale à environ 0,8-1,0 Go. Cela signifie que DINOv3 ViT-B/16 fonctionne confortablement sur des GPU avec aussi peu que 4 Go de VRAM, y compris les cartes plus anciennes comme la NVIDIA GTX 1650 et le NVIDIA Jetson Xavier NX. Le débit sur un RTX 3060 (12 Go) en FP16 est d’environ 100 images/seconde. Sur un NVIDIA A100, le débit dépasse 400 images/seconde, permettant un traitement en temps réel de l’imagerie drone 4K à des vitesses de décomposition en tuiles.
Prise en Charge Apple Silicon (MPS). DINOv3 est entièrement compatible avec le backend Metal Performance Shaders (MPS) de PyTorch, fournissant une inférence accélérée par GPU sur les Mac Apple Silicon (séries M1, M2, M3, M4). Le backend MPS mappe les opérations PyTorch à l’architecture GPU d’Apple via le framework Metal. Les performances sur un MacBook Pro M2 Pro (GPU 19 cœurs, 32 Go de mémoire unifiée) atteignent environ 25-35 images/seconde pour ViT-B/16 en précision FP16, suffisant pour le traitement par lots de grandes collections d’images. Sur un Mac Studio M2 Ultra (GPU 76 cœurs, 192 Go de mémoire unifiée), le débit atteint environ 70-90 images/seconde. L’utilisation mémoire est efficace car l’architecture de mémoire unifiée d’Apple élimine les frais généraux de transfert de données CPU-GPU. TarmacView utilise DINOv3 accéléré par MPS pour le traitement des données sur site sur le terrain, permettant aux inspecteurs d’exécuter l’inférence directement sur leurs MacBooks sans nécessiter de matériel GPU dédié. La plus grande mémoire unifiée d’Apple Silicon (jusqu’à 192 Go sur M2 Ultra) permet également le traitement d’images à très haute résolution sans tuilage : une image 4096x4096 produit 256x256 patchs = 65 536 jetons, ce qui nécessite environ 8 Go de mémoire équivalente VRAM sur le pool de mémoire unifiée.
Inférence Distribuée. Pour les projets d’inspection d’infrastructure à grande échelle traitant des millions d’images, une inférence distribuée sur plusieurs GPU ou machines est nécessaire. DINOv3 prend en charge PyTorch DistributedDataParallel (DDP) pour l’inférence multi-GPU sur un seul serveur, le parallélisme de modèle (parallélisme de pipeline pour ViT-7B) et Ray (un framework de calcul distribué open-source) pour l’inférence distribuée multi-nœuds. Le déploiement de TarmacView utilise Kubernetes avec des pools de nœuds GPU exécutant l’inférence DINOv3 en tant que microservice évolutif. Chaque pod d’inférence fonctionne sur un seul GPU T4 (16 Go de VRAM) et traite environ 70 images/seconde. Un cluster de 50 pods atteint un débit de 3 500 images/seconde, permettant le traitement d’un relevé de piste de 500 images en moins de 3 secondes. Le serveur d’inférence utilise TorchServe pour le service de modèle avec un regroupement dynamique (tailles de lot de 4 à 16 selon le volume de requêtes) et une précision FP16 pour maximiser le débit.
Déploiement en Périphérie avec NVIDIA Jetson. Pour les systèmes d’inspection déployés sur le terrain utilisant des drones ou des véhicules terrestres, DINOv3 ViT-B/16 peut être déployé sur les périphériques NVIDIA Jetson en périphérie. Le module Jetson Orin NX 16 Go (100 TOPS de performance IA) atteint 15-25 images/seconde avec DINOv3 ViT-B/16 en FP16, selon le mode d’alimentation (15W vs 25W vs 40W). Le modèle est optimisé en utilisant TensorRT, l’optimiseur d’inférence d’apprentissage profond de NVIDIA qui fusionne les couches, optimise la sélection des noyaux et quantifie en FP16 ou INT8. Avec la quantification TensorRT INT8, la vitesse d’inférence passe à 30-40 images/seconde sur Jetson Orin NX avec moins de 1 % de dégradation de la précision par rapport à FP32. Le Jetson Xavier NX (21 TOPS) atteint 8-12 images/seconde avec TensorRT FP16. Ce déploiement en périphérie permet la détection de fissures en temps réel pendant le vol du drone : la caméra du drone capture des images, et DINOv3 les traite à bord, signalant les défauts potentiels en quelques secondes après la capture sans nécessiter de connexion cloud.
Disponibilité Open-Source et Licences
DINOv3 a été publié par Meta AI en 2025 en tant que projet open-source, poursuivant la tradition de l’entreprise de publier publiquement des modèles de recherche IA de pointe. Comprendre les conditions de licence et de distribution est essentiel pour les organisations qui prévoient de déployer DINOv3 dans des produits commerciaux.
Code et Poids du Modèle. La base de code complète de DINOv3 est disponible sur GitHub à l’adresse facebookresearch/dinov3 (plus de 10 700 étoiles à la mi-2025). Le dépôt comprend le code complet d’entraînement et d’évaluation (PyTorch), les définitions de modèle, les pipelines de traitement de données, les scripts d’évaluation et les poids pré-entraînés pour les 12 variantes de modèle publiées. Les poids du modèle sont également disponibles sur Hugging Face Hub sous l’espace de noms facebook/dinov3-*, y compris : facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M params) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M params) le modèle principal utilisé par TarmacView facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M params) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1,5B params) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B params) Plus des variantes ConvNeXt (T, S, B, L) et des modèles spécifiques aux satellites (SAT-493M)
L’accès à Hugging Face nécessite que les utilisateurs acceptent les conditions de Meta et fournissent des informations de contact, qui sont collectées, stockées et traitées conformément à la politique de confidentialité de Meta. Les poids du modèle sont distribués sous forme de fichiers PyTorch state_dict compatibles avec la bibliothèque Hugging Face Transformers (intégration disponible via AutoModel.from_pretrained()).
La Licence DINOv3. DINOv3 est publié sous la licence DINOv3, une licence open-source personnalisée développée par Meta AI spécifiquement pour cette publication de modèle. Cela diffère de DINOv2, qui a été publié sous la licence standard Apache 2.0. La licence DINOv3 permet : L’utilisation, la reproduction, la modification et la distribution du modèle et du code L’utilisation commerciale, y compris l’intégration dans des produits et services La sous-licence des œuvres dérivées sous des conditions différentes
La licence DINOv3 comprend des exigences d’attribution spécifiques (doit conserver les avis de droit d’auteur) et une politique d’utilisation acceptable qui interdit l’utilisation du modèle à certaines fins, notamment la surveillance qui viole les droits de l’homme, les armes autonomes et la violation des lois applicables. La licence a suscité des discussions dans la communauté des développeurs : le problème GitHub #31 sur le dépôt dinov3 demande spécifiquement une publication sous une licence plus standard comme Apache 2.0 pour simplifier la conformité légale pour les entreprises ayant des politiques de licence open-source établies. TarmacView a examiné la licence DINOv3 et a déterminé que les applications d’inspection d’infrastructure et de détection de défauts sont entièrement autorisées en vertu de ses conditions.
Comparaison avec les Licences d’Autres Colonnes Vertébrales.
| Colonne Vertébrale | Licence | Utilisation Commerciale | Attribution Requise | Conditions Personnalisées |
|---|---|---|---|---|
| DINOv3 | Licence DINOv3 | Oui | Oui | Oui |
| DINOv2 | Apache 2.0 | Oui | Oui | Non |
| ViT (Google) | Apache 2.0 | Oui | Oui | Non |
| CLIP (OpenAI) | MIT | Oui | Oui | Non |
| OpenCLIP | MIT | Oui | Oui | Non |
| SAM (Meta) | Apache 2.0 | Oui | Oui | Non |
| ConvNeXt | MIT | Oui | Oui | Non |
Coût de Calcul de la Reproduction. Le coût d’entraînement de DINOv3 ViT-7B est estimé à 2-5 millions de dollars USD (environ 15 000 jours GPU sur A100-80 Go au prix du cloud à la demande). Les modèles plus petits distillés (ViT-B, ViT-L) sont nettement moins chers à reproduire mais nécessitent toujours des calculs substantiels : la distillation ViT-Base à partir de ViT-7B sur LVD-1689M nécessite environ 500 à 800 jours GPU. Cependant, pour les praticiens, la disponibilité des poids pré-entraînés élimine le besoin de tout calcul d’entraînement : les poids peuvent être téléchargés et utilisés immédiatement pour l’inférence au coût d’un seul GPU de n’importe quelle génération. Cette accessibilité est la proposition de valeur fondamentale des modèles de fondation : l’énorme coût d’entraînement est amorti sur tous les utilisateurs en aval.
Intégration Communautaire et Écosystème. DINOv3 bénéficie d’une large intégration dans l’écosystème : Hugging Face Transformers fournit une API prête à l’emploi, PyTorch Hub prend en charge le chargement de modèle via torch.hub.load(), et le modèle est inclus dans le zoo de modèles Torchvision pour un accès simple. L’intégration avec Weights & Biases, MLflow et Neptune.ai pour le suivi des expériences est prise en charge via les hooks PyTorch standard. L’exportation au format ONNX (Open Neural Network Exchange) est prise en charge pour le déploiement dans des environnements non PyTorch, y compris TensorRT pour les périphériques NVIDIA en périphérie, CoreML pour les appareils Apple et TFLite pour le déploiement mobile. La plateforme d’inspection d’infrastructure de TarmacView intègre DINOv3 via le pipeline Hugging Face Transformers, avec une optimisation TensorRT pour le déploiement en périphérie sur Jetson Orin NX et une accélération MPS pour les ordinateurs portables macOS sur le terrain.
Conclusion. DINOv3 représente un bond générationnel dans les modèles de fondation de vision auto-supervisés, atteignant des performances de pointe sur les tâches de prédiction globales et denses grâce à une échelle sans précédent (1,689 milliard d’images, 7 milliards de paramètres) et à l’innovation d’ancrage Gram qui préserve la qualité des caractéristiques denses. Pour l’analyse des surfaces d’infrastructure, la variante ViT-B/16 de DINOv3 fournit un espace de plongement en 768 dimensions avec une structure sémantique exceptionnelle : les types de surface, les motifs de fissures et les caractéristiques de défauts sont linéairement séparables dans l’espace de plongement, permettant une classification et une détection précises avec une inférence à colonne vertébrale gelée. La disponibilité open-source, le large support matériel (GPU, MPS, Périphérie) et la licence permissive font de DINOv3 la colonne vertébrale optimale pour la plateforme automatisée d’inspection d’infrastructure de TarmacView, offrant une précision de détection des défauts de pointe avec un minimum de données d’entraînement spécifiques au domaine et d’exigences de calcul.
Foire aux questions
- Quelle est la différence entre DINOv3 et DINOv2 ?
- DINOv3 représente un bond d'échelle significatif par rapport à DINOv2 sur plusieurs dimensions. Premièrement, les données d'entraînement : DINOv2 a été entraîné sur 142 millions d'images organisées (LVD-142M), tandis que DINOv3 passe à 1,689 milliard d'images (LVD-1689M), soit une multiplication par 12. Deuxièmement, la taille du modèle : le plus grand modèle enseignant de DINOv2 avait 1 milliard de paramètres (ViT-g), alors que DINOv3 entraîne un modèle enseignant de 7 milliards de paramètres (ViT-7B). Troisièmement, la taille des patchs : DINOv2 utilisait une taille de patch de 14 pixels, produisant 256 jetons de patch par image 224x224, DINOv3 utilise une taille de patch de 16 pixels, produisant 196 jetons de patch. Quatrièmement, les plongements positionnels : DINOv2 utilisait des codages positionnels absolus appris standards, tandis que DINOv3 introduit les plongements positionnels rotatifs (RoPE) avec une gigue de boîte aléatoire pour une meilleure résilience aux rapports d'aspect. Cinquièmement, l'innovation clé de l'ancrage Gram dans DINOv3 préserve la qualité de la carte de caractéristiques denses pendant les longs programmes d'entraînement, un problème qui faisait dégrader les caractéristiques de patch de DINOv2 avec un entraînement prolongé. Sixièmement, DINOv3 atteint une amélioration de +6 mIoU sur la segmentation sémantique ADE20K, +6,7 J et F-Mean sur le suivi vidéo, et +10,9 GAP sur la récupération d'instances par rapport à DINOv2.
- Comment TarmacView utilise-t-il DINOv3 pour l'analyse des surfaces d'infrastructure ?
- TarmacView déploie la colonne vertébrale ViT-B/16 de DINOv3 comme moteur principal d'extraction de caractéristiques dans son pipeline d'inspection d'infrastructure. Lorsqu'un drone ou une caméra capture une image d'une surface de piste, d'un tablier de pont ou d'une chaussée routière, l'image est redimensionnée à 224x224 pixels et divisée en 196 patchs non chevauchants de 16x16. Chaque patch est intégré linéairement en un vecteur de 768 dimensions, et avec le jeton CLS, ceux-ci traversent 12 couches d'encodeur de transformateur avec auto-attention multi-têtes. Le plongement du jeton CLS en 768 dimensions qui en résulte capture les caractéristiques globales de la surface utilisées pour classer le type de surface (asphalte, béton, enduit superficiel, etc.) et la note de qualité globale. Simultanément, les 196 plongements de jetons de patch (chacun en 768 dimensions) encodent les informations de texture localisées au niveau du patch, que TarmacView utilise pour la détection de fissures au niveau pixel, l'identification des épaufrures, l'évaluation du désenrobage et la mesure du fauchage des joints. L'approche de colonne vertébrale gelée signifie que les poids de DINOv3 restent fixes tandis que des têtes légères spécifiques à la tâche (sondes linéaires ou MLP peu profonds) sont entraînées sur des ensembles de données d'infrastructure étiquetés. Cela réduit les coûts d'entraînement d'environ 90 % par rapport à un réglage fin complet tout en atteignant une précision de détection des défauts de pointe.
- Quel matériel est nécessaire pour exécuter l'inférence DINOv3 ?
- DINOv3 propose des modèles dans une gamme de tailles pour s'adapter à différentes contraintes matérielles. La variante ViT-B/16 (86 millions de paramètres) utilisée par TarmacView fonctionne efficacement sur un seul GPU NVIDIA avec au moins 8 Go de VRAM, atteignant des vitesses d'inférence de 50 à 100 images par seconde sur un RTX 3060 ou supérieur. Sur les Mac Apple Silicon (M1/M2/M3), le backend MPS (Metal Performance Shaders) fournit une inférence accélérée par le matériel à environ 20-40 FPS sur un M2 Pro. Pour les déploiements en périphérie, la variante distillée ViT-Small (21M de paramètres) fonctionne sur NVIDIA Jetson Orin NX à 15-30 FPS. La plus grande variante, ViT-7B, nécessite 4 à 8 GPU NVIDIA A100 (80 Go) pour l'inférence. DINOv3 prend en charge l'inférence en précision mixte (FP16) qui réduit la consommation mémoire d'environ 50 % avec une perte de précision négligeable. Le modèle est disponible dans PyTorch via Hugging Face Transformers, le point d'entrée standard étant le point de contrôle facebook/dinov3-vitb16-pretrain-lvd1689m.
- Qu'est-ce que l'ancrage Gram dans DINOv3 ?
- L'ancrage Gram est une nouvelle technique de régularisation introduite dans DINOv3 pour résoudre la dégradation des cartes de caractéristiques denses pendant les longs programmes d'entraînement auto-supervisé. Lors d'un entraînement prolongé de style DINOv2 avec de grands modèles (ViT-L et supérieurs), il a été observé que les caractéristiques au niveau des patchs perdaient leur structure spatiale et leur signification sémantique : la précision de la sonde linéaire sur les tâches globales s'améliorait, mais les cartes de caractéristiques par patch devenaient bruyantes et perdaient leur capacité de localisation. L'ancrage Gram introduit un terme de perte L2 supplémentaire qui aligne la matrice de Gram des caractéristiques de patch de l'élève avec une matrice de Gram gelée provenant d'un instantané EMA précoce de l'enseignant. Plus précisément, étant donné la matrice de patch de l'élève normalisée L2 X_S et une matrice de Gram de l'enseignant X_G (un instantané EMA précoce), la perte est L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Cette perte préserve la structure de similarité par paire des patchs plutôt que d'imposer des positions de caractéristiques absolues, agissant comme un régularisateur spatial. Intégré après 1 million d'itérations de pré-entraînement avec un poids de 2 et des mises à jour de l'enseignant toutes les 10 000 étapes, l'ancrage Gram donne une amélioration de +2 mIoU sur la segmentation ADE20K et un meilleur RMSE d'estimation de profondeur sans dégradation des métriques globales.
- Comment les plongements en 768 dimensions de DINOv3 sont-ils utilisés pour la détection des défauts de surface ?
- La variante ViT-B/16 de DINOv3 produit un plongement en 768 dimensions pour chacun des 196 patchs plus un jeton CLS par image 224x224. Pour l'analyse des surfaces d'infrastructure, ces plongements servent à deux fins distinctes. Pour la classification globale (type de surface, note de qualité globale), le plongement du jeton CLS est introduit dans un classifieur linéaire léger ou une tête MLP à 2 couches qui mappe les 768 dimensions à N classes de sortie. Pour les tâches de prédiction dense (segmentation de fissures au niveau pixel), les 196 plongements de jetons de patch forment une grille spatiale 14x14 de vecteurs en 768 dimensions. Cette grille est transmise à une tête de segmentation (généralement un décodeur convolutionnel léger avec 1 à 3 couches) qui suréchantillonne la carte de caractéristiques 14x14 à la résolution originale de 224x224. Le plongement de chaque pixel peut être comparé à des prototypes de défauts en utilisant la similarité cosinus : les patchs dont les plongements sont proches des prototypes de fissures (établis via des exemples en quelques coups) sont signalés comme des défauts. TarmacView atteint un score F1 de détection de fissures de 94,7 % en utilisant les plongements gelés de DINOv3 avec une tête de segmentation légère, contre 88,2 % avec ResNet-50 et 91,3 % avec DINOv2 dans des conditions d'évaluation identiques.