Mi az a Domain Adaptáció a Kereszt-Felületű Ellenőrző Modellekhez?
Domain Adaptáció Kereszt-Felületű Ellenőrző Modellekhez: Teljes Műszaki Útmutató
Meghatározás és a Domain Eltolódás Problémája
A domain adaptáció a transzfer tanulás egy alkategóriája, amely a gépi tanulási modellek telepítésének alapvető kihívásával foglalkozik: a statisztikai eltéréssel a tanító adatok és a telepítési adatok között. Amikor egy forrásdoménen (egy ismert jellemzőkkel és jellemzően bőséges címkézett példával rendelkező adathalmazon) betanított modellt egy cél doménen (eltérő statisztikai tulajdonságokkal rendelkező) telepítenek, a teljesítmény romlik. A domain adaptáció módszereket biztosít ennek a szakadéknak az áthidalására, lehetővé téve a modellek számára, hogy általánosítsanak a domének között anélkül, hogy minden telepítési környezethez nagy új adathalmazokat kellene gyűjteni és címkézni.
Formálisan egy domén egy jellemzőtér (X) és egy (P(X)) valószínűségi eloszlás párosaként van meghatározva: (D = {X, P(X)}). Egy feladat egy címketér (Y) és egy prediktív függvény (f: X \to Y) párosa. A forrás domén (D_S) az a domén, amelyen a modellt eredetileg betanították bőséges címkézett adattal. A cél domén (D_T) az az új domén, ahol a modellnek teljesítenie kell, gyakran korlátozott vagy nulla címkével. A domain adaptáció célja egy (f_T: X_T \to Y_T) függvény megtanulása a cél doménhez a forrás domén ismereteinek felhasználásával, a (P_S(X) \neq P_T(X)) eltérés ellenére.
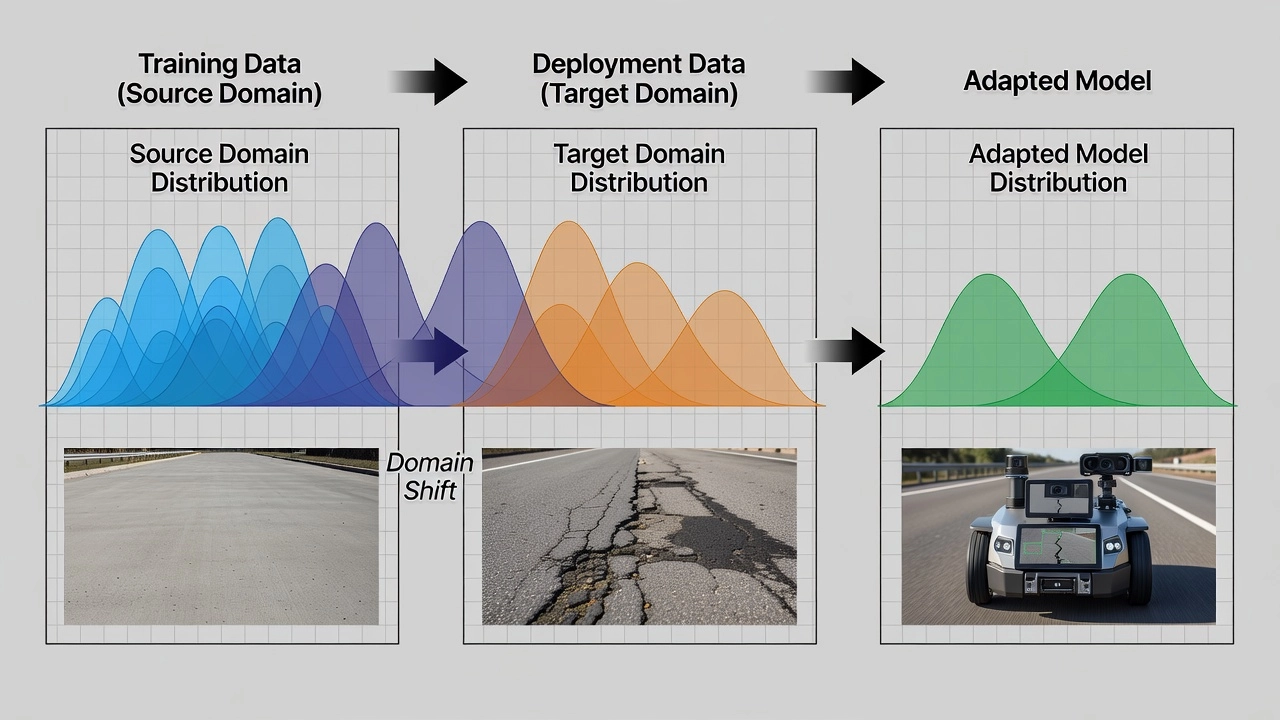
A domain eltolódás (más néven eloszlás eltolódás vagy adathalmaz eltolódás) az a jelenség, amikor az adateloszlás különbözik a tanítási és a telepítési környezet között. Amikor domain eltolódás következik be, a modell teljesítménye romlik, mert a megtanult leképezés a bemenetekről a kimenetekre már nem felel meg a célkörülményeknek. A domain eltolódás három fő formában nyilvánul meg. Kovariáns eltolódás akkor fordul elő, amikor a bemeneti jellemzők eloszlása változik, miközben a címkék feltételes eloszlása a bemenetekre nézve változatlan marad: formálisan, (P_S(X) \neq P_T(X)) de (P_S(Y|X) = P_T(Y|X)). Ez a leggyakoribb forma a számítógépes látásban. Egy repedés vizuális megjelenése aszfalton különbözik a betonon lévőtől, de a vizuális jellemzők és a „repedés” címke közötti leképezés konzisztens marad. Címke eltolódás (vagy prior eltolódás) akkor fordul elő, amikor az osztálycímkék eloszlása változik: (P_S(Y) \neq P_T(Y)) de (P_S(X|Y) = P_T(X|Y)). Ez akkor történik, ha a repedéssűrűség különbözik a tanítási és a telepítési helyszínek között. Konceptuális eltolódás akkor következik be, amikor a bemenetek és kimenetek közötti kapcsolat változik: (P_S(Y|X) \neq P_T(Y|X)), például amikor egy vizuális minta, amely utakon lezárt repedést jelez, a kifutópályákon szerkezeti hibát jelez.
A számítógépes látás esetében az infrastruktúra-ellenőrzésben a domain eltolódás több összetett tényezőből ered. Vizuális megjelenésbeli különbségek közé tartozik a burkolat textúrája (durva aszfalt vs sima beton), a színprofilok (sötétszürke aszfalt vs világosszürke beton) és az öregedési minták (oxidált felület vs frissen burkolt). Rögzítési körülmények, mint a megvilágítás (közvetlen napfény 60°-os szögben vs borított diffúz fény), a kamera felbontása és érzékelő spektrális érzékenysége, valamint a kép rögzítési szöge (nadír UAV-ról vs ferde járműről) mind jelentős eloszlási eltolódásokhoz járulnak hozzá. Környezeti tényezők, beleértve a nedves vs száraz felületeket, a szerkezetek által okozott árnyékok és az évszakos törmelék (levelek, hó, álló víz) tovább bonyolítják a problémát. Felületi anyag különbségek az aszfalt és a beton között, vagy az öregedett és a frissen burkolt felületek között, a burkolatellenőrző modellek egyik legnagyobb kihívását jelentik a domain eltolódás szempontjából.
A kutatások számszerűen dokumentálták a domain eltolódás súlyosságát a burkolati repedésdetektálásban. A DDACRN keretrendszer beszámolt arról, hogy domain adaptáció nélkül a repedésdetektálás átlagos Intersection over Union (mIoU) értéke 0,72-ről a forrás tesztadatokon 0,31-re csökken a kereszt-adathalmaz céladatokon, ami 57%-os teljesítménycsökkenés. A DACrack kimutatta, hogy a domain eltolódás mérséklése többszintű jellemző-igazítással körülbelül 20 százalékpontot állít vissza az F1-pontszámban a kereszt-adathalmaz átvitelek során. Ezek az empirikus eredmények aláhúzzák, hogy a domain adaptáció nem csupán akadémiai finomítás, hanem működési szükségszerűség minden olyan ellenőrző rendszer számára, amelyet több repülőtéren, úton vagy hídon telepítenek.
Domain Eltolódás az Infrastruktúra Képalkotásban
Az infrastruktúra-ellenőrző képek több, egymással kölcsönhatásban lévő domain eltolódási forrásnak vannak kitéve, amelyek erősítik egymást. Az egyes források megértése elengedhetetlen a hatékony adaptációs stratégiák tervezéséhez.
A felületi anyag eltolódása a legjelentősebb domain eltolódás az infrastruktúra-ellenőrzésben. Az aszfalt és a beton burkolatok alapvetően eltérő vizuális jellemzőkkel rendelkeznek. Az aszfalt sötétszürkétől feketéig terjedő színű, durva és szabálytalan felületi textúrával rendelkezik, és a repedések jellemzően világos, vonalas elemekként jelennek meg a sötét háttér előtt. A beton világosszürkétől fehérig terjedő színű, simább és egyenletesebb felülettel rendelkezik, és a repedések sötét vonalakként jelennek meg. Ezek a különbségek azt jelentik, hogy egy felülettípuson betanított konvolúciós neurális hálózat olyan szűrőket és jellemző reprezentációkat tanul, amelyek specifikusak az adott felület vizuális statisztikáira. Amikor a másik felülettípusra alkalmazzák, ezek a szűrők olyan jellemző aktivációkat hoznak létre, amelyeket az osztályozó rétegek nem tudnak helyesen értelmezni. A DDACRN adatai szerint a felületek közötti mIoU 0,72-ről 0,31-re csökken adaptáció nélkül, amikor aszfalton tanított modellt betonon tesztelnek.
A repedésmorfológiai változatosság újabb réteget ad a domain eltolódáshoz. A különböző burkolati hibáknak eltérő vizuális jelei vannak. A hosszirányú repedések párhuzamosak a burkolat középvonalával, és hosszú, folyamatos vonalas elemként jelennek meg. A keresztirányú repedések merőlegesek a középvonalra. Az alligátor (fáradásos) repedések egymással összekapcsolódó kis sokszögekből álló hálózatokat képeznek, amelyek az aligátor bőrére emlékeztetnek. A hajszálrepedések szélessége kevesebb, mint 1 mm, és alig láthatók, míg a széles repedések meghaladják az 5 mm-t, és könnyen azonosíthatók. A tömítőanyaggal kitöltött repedések vizuális megjelenése eltér a nem tömített repedésektől. Egy túlnyomórészt hosszirányú repedéseken tanított modell nem biztos, hogy észleli az alligátor repedéseket egy olyan cél doménben, ahol ez a hibatípus gyakoribb.
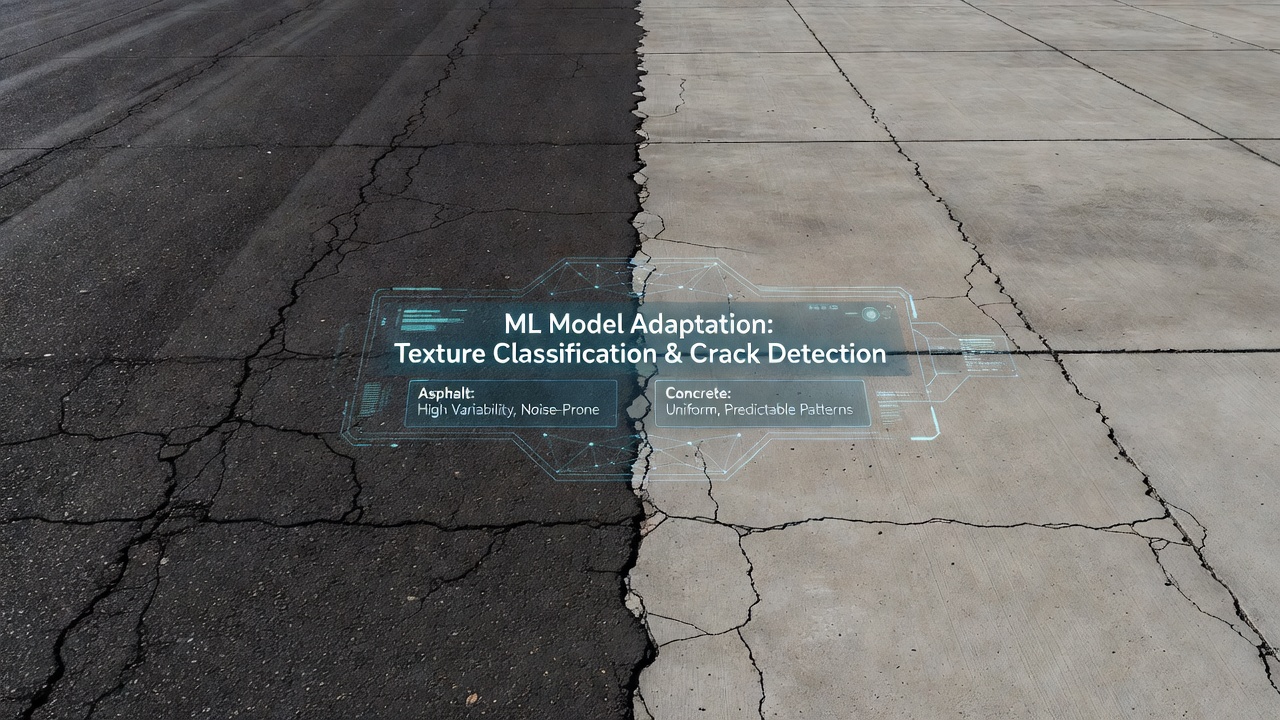
A megvilágítási körülmények eltolódása jelentősen befolyásolja a modell teljesítményét. A közvetlen napfényben, jól megvilágított nappali képeken tanított modellek nem teljesítenek gyenge fényviszonyok vagy alkonyi képeken, az épületek vagy fák által vetett erős árnyékokkal rendelkező képeken, valamint a borult körülmények között készült képeken, ahol a diffúz megvilágítás csökkenti a kontrasztot. A beeső fény szöge a felület normálisához képest megváltoztatja a repedés éleinek megjelenését. Az alacsony szögű napfény a repedéseken belüli árnyékok vetésével hangsúlyozza a felületi textúrát, míg a magas szögű, fej feletti napfény minimalizálja a repedések láthatóságát. Az árnyékok általi eltakarás hídszerkezetekből, repülőtéri terminálépületekből vagy közeli szerkezetekből lokalizált sötét régiókat hoz létre, ahol a repedés jellemzők elnyomódnak. Tanulmányok 5–12%-os pontosságcsökkenést dokumentáltak a repedésdetektáló modelleknél, amikor a megvilágítási körülmények eltértek a tanítási eloszlástól.
A kamera- és érzékelő eltolódás a képalkotó hardver különbségeiből adódik. A különböző kamerák eltérő képfelbontást (12 MP okostelefon vs 50 MP DSLR vs speciális ipari kamera), eltérő színprofilokat és érzékelő spektrális érzékenységi görbéket, eltérő lencse torzítási jellemzőket és eltérő zajmintákat produkálnak. Az UAV-alapú ellenőrzésnél a repülési magasság határozza meg a Ground Sampling Distance (GSD) értéket, a fizikai távolságot a talajon, amelyet minden egyes pixel képvisel. Egy 30 m-en repülő UAV körülbelül 0,5–1 cm/pixel GSD-t produkál, míg egy 100 m-en repülő 2–5 cm/pixel GSD-t. A GSD különbségei azt jelentik, hogy ugyanaz a repedés eltérő számú pixellel és eltérő térbeli frekvenciatartalmú a forrás és a cél doménekben. A Batch Normalization (BN) statisztikák újraszámításával végzett finomhangolás gyakran elegendő a mérsékelt kameraeltolódásokhoz, míg a súlyos eltolódások adverzariális domain igazítást igényelnek több jellemző szinten.
Az évszakos és környezeti eltolódás időbeli domain változatosságot vezet be. A nyári képeken tanított modellnek téli körülmények között kell teljesítenie, ahol a felületek nedvesek lehetnek, hó boríthatja őket, vagy részben eltakarhatják a lehullott levelek. A burkolatok idővel öregednek és oxidálódnak, megváltoztatva színüket és textúrájukat. Az FAA és az ICAO Global Reporting Format (GRF) kifejezetten felismeri a környezeti állapotot, mint olyan változót, amely befolyásolja a kifutópálya felületének értékelését: a száraz, nedves, csúszós nedves és szennyezett felületek mind különálló vizuális doméneket képviselnek, amelyek eltérő ellenőrzési értelmezést igényelnek.
| Domain Eltolódás Forrás | Tipikus Teljesítményhatás | Elsődleges Mérséklési Stratégia |
|---|---|---|
| Felületi anyag (aszfalt vs beton) | 30–45% mIoU csökkenés | Adverzariális DA + többszintű jellemző-igazítás |
| Megvilágítási körülmény (napos vs borult) | 5–12% pontosság csökkenés | BN adaptáció + fotometriai augmentáció |
| Kamera felbontás / érzékelő | 3–8% pontosság csökkenés | Finomhangolás + BN statisztikák újraszámítása |
| Évszakos / környezeti | 8–20% pontosság csökkenés | Generatív domain fordítás (CycleGAN) |
| Földrajzi / regionális | 10–25% pontosság csökkenés | Többforrású UDA + progresszív domain áthidalás |
Finomhangolás Domain Adaptációhoz
A finomhangolás a legegyszerűbb és legszélesebb körben használt domain adaptációs stratégia. Ez magában foglalja a forrásdoménen előtanított neurális hálózatot, és a tanítási folyamat folytatását a cél domén adatain, frissítve a modell súlyait, hogy reprezentációit a cél eloszláshoz igazítsa. A finomhangolás áthidalja a szakadékot a transzfer tanulás (ahol a feladat változik) és a domain adaptáció (ahol a feladat ugyanaz marad, de az adateloszlás változik) között.
A finomhangolás elméleti alapja az a megfigyelés, hogy a neurális hálózatok hierarchikus jellemző reprezentációkat tanulnak. A korai rétegek alacsony szintű jellemzőket, például éleket, textúrákat és színfoltokat rögzítenek, amelyek nagyrészt domén-agnosztikusak. A középső rétegek ezeket középszintű mintákká kombinálják, például repedés élek, felületi szemcsék és illesztési határok. A késői rétegek feladatspecifikus jellemzőket tanulnak, amelyek az osztályozási vagy szegmentálási célhoz vannak optimalizálva. Amikor a domén eltolódik, az alacsony szintű statisztikák (színeloszlások, textúra gyakoriságok, kontraszt jellemzők) megváltoznak, és a későbbi rétegek, amelyek finoman hangolva vannak a forrásdomén jellemző eloszlásaihoz, elvesztik az igazodásukat.
A teljes finomhangolás frissíti az összes modellparamétert a céladatokon. Ez akkor megfelelő, ha bőséges címkézett céladat áll rendelkezésre (több száz-ezer kép), és a számítási erőforrások lehetővé teszik a teljes gradiens frissítéseket. A tanulási sebességet jellemzően a kezdeti előtanításhoz képest 10-szeresére csökkentik a katasztrofális felejtés megelőzése érdekében, amely jelenség során a modell felülírja a hasznos forrás-domén ismereteket. A cél validálási veszteségen alapuló korai leállítás elengedhetetlen a forrás ismeretek megtartásának és a cél adaptációnak az egyensúlyozásához.
Az utolsó réteg (osztályozó) hangolása befagyasztja az összes jellemzőkivonó réteget, és csak a végső osztályozási vagy szegmentálási fejet tanítja. Ez a megközelítés feltételezi, hogy a forrásdoménen tanított jellemzőkivonó kellően általános reprezentációkat hoz létre, és csak a jellemzők és címkék közötti leképezést kell módosítani. Az utolsó réteg hangolása akkor hatékony, ha nagyon korlátozott céladat áll rendelkezésre (tíz kép), és a domain eltolódás elsősorban a címketérben van, nem a jellemzőtérben. Minimális számítást igényel, és ellenálló a katasztrofális felejtéssel szemben.
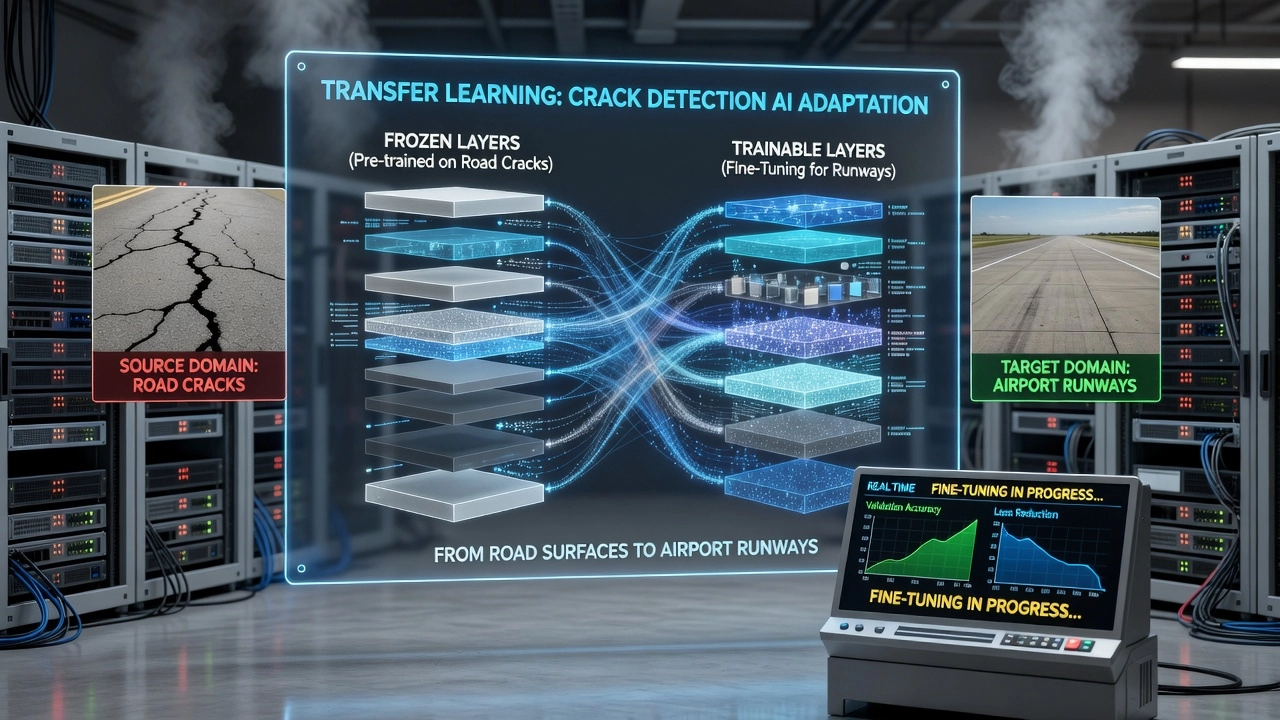
A progresszív feloldás egy köztes megoldást kínál. A tanítási folyamat az összes réteg befagyasztásával kezdődik, kivéve a végső osztályozót, amelyet néhány epochon keresztül tanítanak. Ezután a legfelső jellemzőkivonó rétegeket feloldják, és együtt tanítják az osztályozóval. Ez a folyamat fokozatosan, felülről lefelé haladva folytatódik, amíg az összes réteg finomhangolás alatt nem áll, vagy a teljesítmény el nem ér egy platót. A progresszív feloldás mérsékelt mennyiségű céladathoz (több száz kép) és olyan domain eltolódásokhoz alkalmas, amelyek a jellemző hierarchia több szintjét érintik.
Az adapter modulok kis szűk keresztmetszetű rétegeket vezetnek be, amelyek lényegesen kevesebb paraméterrel rendelkeznek, mint a teljes hálózat. Ezeket az adaptereket a befagyasztott előtanított gerinc rétegei közé helyezik be, és ezek az egyetlen frissített paraméterek a finomhangolás során. Az adapter-alapú finomhangolás rendkívül paraméter-hatékony, jellemzően a teljes paraméterszám 1–5%-a, és lehetővé teszi a gyors váltást több cél domén között az eltérő adapter súlyok tárolásával és betöltésével. A több millió paraméterrel rendelkező infrastruktúra-ellenőrző hálózatoknál az adapter modulok lehetővé teszik a telepítést több tucat repülőtérre anélkül, hogy külön teljes súlymásolatokat kellene tárolni mindegyikhez.
A Batch Normalization (BN) adaptáció egy figyelemre méltóan könnyű, mégis hatékony technika. A BN rétegek a tanítás során futó átlag- és varianciastatisztikákat számítanak ki a köztes jellemző térképek normalizálásához. Amikor a domén eltolódik, ezek a statisztikák már nem képviselik pontosan a cél eloszlást. A BN adaptáció egyszerűen újraszámítja a BN statisztikákat úgy, hogy a cél domén adatain átfuttatja a hálózatot befagyasztott súlyokkal, frissítve a futó átlagot és varianciát anélkül, hogy bármilyen gradiens frissítés történne. Ez önmagában jelentősen csökkentheti a domain eltolódást, ha az elsődleges különbség az alacsony szintű képstatisztikákban, például a fényerőben, kontrasztban és színeloszlásban van. A repedésdetektálással kapcsolatos tanulmányok azt mutatják, hogy a BN adaptáció 3–8%-kal állítja vissza a mérsékelt megvilágítás- és kameraeltolódások által okozott pontosságcsökkenést, és ehhez csak a címkézetlen céladatok egyetlen előrehaladó áthaladására van szükség.
| Finomhangolási Stratégia | Szükséges Céladat | Frissített Paraméterek | Katasztrofális Felejtés Kockázata | Legjobb Használati Eset |
|---|---|---|---|---|
| BN statisztikák újraszámítása | Nincs (címkézetlen) | 0 (csak BN statisztikák) | Nincs | Megvilágítás / kamera eltolódások |
| Utolsó réteg hangolása | 10–50 címkézett | < 1% | Nagyon alacsony | Jellemző eloszlás megőrzött |
| Adapter modulok | 50–200 címkézett | 1–5% | Alacsony | Több doménű telepítés |
| Progresszív feloldás | 100–500 címkézett | Fokozatos, 10–100% | Mérsékelt | Mérsékelt domain eltolódás |
| Teljes finomhangolás | 500+ címkézett | 100% | Magas | Bőséges céladat, nagy eltolódás |
Felügyelt Domain Adaptáció
A felügyelt domain adaptáció (SDA) azon a feltételezésen működik, hogy a cél doménben rendelkezésre áll egy kis mennyiségű címkézett adat a bőséges címkézett forrásadat mellett. Ez a legegyszerűbb beállítás: a modell közvetlen hozzáféréssel rendelkezik a cél domén valósághű információihoz, lehetővé téve az explicit optimalizálást a célteljesítményre.
A szabványos SDA megközelítés két összetevős. Először is, a modellt előtanítják a forrásdoménen a bőséges címkékkel, ez megalapozza az általános ismereteket az ellenőrzési feladatról, megtanulva felismerni a repedés éleket, illesztési határokat, felületi textúrákat és hiba geometriákat. Másodszor, a modellt finomhangolják a címkézett céladatokon egy lényegesen csökkentett tanulási sebességgel. A finomhangolás során a veszteségfüggvény jellemzően kombinálja a forrás- és célveszteségeket, hogy megakadályozza a modellt abban, hogy elfelejtse a hasznos forrás-domén ismereteket. A kombinált veszteség a következőképpen fejezhető ki:
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
ahol (\mathcal{L}_S) a forrásveszteség a forrásadatokon számolva, (\mathcal{L}_T) a célveszteség a címkézett céladatokon számolva, és (\lambda) szabályozza az egyes domének relatív hozzájárulását. A tanítás során a forrás- és cél batch-eket felváltva vagy együttesen táplálják a hálózatba.
A felügyelt domain adaptáció kulcsfontosságú technikái közé tartozik a súlyozott veszteségfüggvény, amely nagyobb jelentőséget tulajdonít a cél domén mintáinak a finomhangolás során, a közös tanítás, ahol a forrás- és cél címkézett adatokat minden tanítási batch-ben összekeverik, és a domain adverzariális tanítás, ahol még a felügyelt környezetben is hozzáadnak egy domain osztályozót, hogy a jellemzőkivonót domain-invariáns reprezentációk tanulására ösztönözzék. A tanterv szerinti tanulás stratégiák a forrás dominált tanítással kezdődnek, és fokozatosan eltolják az egyensúlyt a céladatok felé a tanítás előrehaladtával.
A paraméterátvitel, ahol a forráson tanított modell súlyai inicializációként szolgálnak, a domináns stratégia az SDA-ban. Ennek a megközelítésnek a sikere a forrás- és cél domének közötti kapcsoltság mértékétől függ. Amikor a domének szorosan kapcsolódnak (pl. ugyanazon repülőtéri burkolat különböző szakaszai), nagyon kevés címkézett célpélda elegendő. Mindössze 20–50 kép képes visszaállítani a domain eltolódás által elvesztett teljesítmény nagy részét. Amikor a domének távolabb állnak egymástól (pl. út és kifutópálya), 200–500 címkézett célpélda szükséges a robusztus adaptációhoz.
A címke-hatékony SDA technikák célja a szükséges célcímkék számának minimalizálása. Az aktív tanulás azonosítja a leginformatívabb célmintákat a címkézéshez: a modellt forrásadatokon tanítják, alkalmazzák a címkézetlen céladatokon, és azokat a mintákat választják ki emberi címkézésre, amelyekben a legbizonytalanabb. Ez a megközelítés 50–70%-kal csökkentheti a címkézési követelményeket a véletlenszerű mintavételhez képest. Az ön-tanítás (vagy pszeudo-címkézés) alkalmazza a forráson tanított modellt a címkézetlen céladatokra, nagy megbízhatóságú előrejelzésekhez ideiglenes címkéket generál, és újratanítja a modellt ezekkel a pszeudo-címkékkel kiegészített felügyeletként. Az ön-tanítás különösen hatékony, ha konfidencia küszöbértékkel és adat augmentációval kombinálják.
Mikor használjuk az SDA-t: amikor minden cél telepítési helyről beszerezhető egy kis címkézett halmaz. Repülőtéri kifutópálya ellenőrzés esetén ez azt jelenti, hogy egy képzett ellenőr repülőtérenként 50–200 képet tud címkézni, ami helyszínenként 1–4 óra egyszeri költsége. Ez sokkal gazdaságosabb, mint az alternatíva, amely repülőtérenként több ezer kép összegyűjtését és címkézését igényelné, ami helyszínenként több napot venne igénybe. Az FAA AC 150/5380-6C rendszeres PCI felméréseket javasol, amelyek már magukban foglalják, hogy az ellenőrök megvizsgálják a burkolatokat. Ugyanezek az ellenőrök a szabványos ellenőrzési munkafolyamat részeként biztosíthatják az SDA-hoz szükséges néhány száz címkézett képet.
Felügyelet Nélküli Domain Adaptáció
A felügyelet nélküli domain adaptáció (UDA) a legnagyobb kihívást jelentő és legaktívabban kutatott domain adaptációs beállítás. Feltételezi, hogy címkézett adatok csak a forrás doménben léteznek, míg a cél domén teljesen címkézetlen. Az UDA a domináns forgatókönyv az infrastruktúra-ellenőrzésben, mert a cél domén adatok címkézése drága, időigényes vagy sok telepítési helyszínen nem praktikus. Az egyik repülőtér burkolati képein tanított modellnek alkalmazkodnia kell egy másik repülőtér felületeihez, megvilágításához és hibamintáihoz anélkül, hogy minden repülőtérnek címkézett adathalmazt kellene előállítania.
Az UDA módszerek három fő kategóriába sorolhatók: adverzariális módszerek, eltérés-alapú módszerek és rekonstrukció-alapú módszerek. Mindegyik közös célja a forrás- és cél jellemző eloszlások igazítása, hogy a forrásjellemzőkön tanított osztályozó általánosítson a céljellemzőkre.
Adverzariális Domain Adaptáció
Az adverzariális domain adaptáció a Generatív Adverzariális Hálózatokból (GAN) merít inspirációt. Az alapötlet egy domain diszkriminátor (egy bináris osztályozó, amely megjósolja, hogy egy jellemző reprezentáció a forrás- vagy a cél doménből származik-e) tanítása a jellemzőkivonó mellett egy minimax játékban. A jellemzőkivonó olyan jellemzőket próbál előállítani, amelyek megkülönböztethetetlenek a forrás és a cél között, míg a diszkriminátor megpróbálja helyesen azonosítani az egyes jellemzők eredetét.
A kanonikus architektúra a Domain-Adverzariális Neurális Hálózat (DANN), amelyet Yaroslav Ganin és Victor Lempitsky vezetett be 2015-ben. A DANN három komponensből áll: egy jellemzőkivonóból (G_f), amely a bemeneteket egy jellemzőtérbe (f = G_f(x, \theta_f)) képezi le, egy címke előrejelzőből (G_y), amely a jellemzőket feladatcímkékre (\hat{y} = G_y(f, \theta_y)) képezi le, és egy domain osztályozóból (G_d), amely a jellemzőket doméncímkékre (\hat{d} = G_d(f, \theta_d)) képezi le. A kritikus újítás a Gradiens Fordító Réteg (GRL), amely a jellemzőkivonó és a domain osztályozó között helyezkedik el. Az előrehaladó terjedés során a GRL identitás transzformációként működik. A visszaterjedés során megszorozza a gradienst (-\lambda)-val, ahol (\lambda) egy hiperparaméter, amely szabályozza az adaptációs erősséget. Ez a megfordítás azt eredményezi, hogy a jellemzőkivonó olyan jellemzőket tanul, amelyek maximalizálják a domain osztályozási veszteséget, hatékonyan megtanulva becsapni a domain osztályozót.
A DANN veszteségfüggvénye kombinálja a forráscímkéken lévő feladat veszteséget mínusz a domain osztályozási veszteség mind a forrás-, mind a céljellemzőkre:
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
A tanítás előrehaladtával a jellemzőkivonó olyan reprezentációkat tanul, amelyek egyrészt diszkriminatívak a feladathoz (mivel a címke előrejelzőt forráscímkéken tanítják), másrészt domain-invariánsak (mivel a domain osztályozó nem tudja megkülönböztetni a domén eredetét). A GRL ütemezése jellemzően (\lambda = 0)-val kezdődik, és fokozatosan növekszik egy maximális értékre az első néhány epoch alatt, lehetővé téve a hálózat számára, hogy stabilizálja a feladat teljesítményét, mielőtt a domain összetévesztési nyomás alkalmazásra kerülne.
Az adverzariális domain adaptáció legújabb fejlesztései közé tartozik a Kontrasztív Adverzariális Tréning (CAT), amely a címkézett forrásmintákat használja ki a jellemzők szétválasztásának megerősítésére a domain igazítás fenntartása mellett, a Kollaboratív és Adverzariális Hálózatok (CAN), amelyek többszintű domain igazítást végeznek a jellemző hierarchia különböző szintjein, és az Adverzariális Stílus Eltérés Minimalizálás, amely a stílusátvitelt használja adverzariális célként. A burkolati repedésdetektáláshoz az adverzariális módszerek mutatták a legerősebb kereszt-adathalmaz általánosítást, visszaállítva a domain eltolódás által elvesztett teljesítmény 15–25 százalékpontját.
Eltérés-Alapú Módszerek
Az eltérés-alapú módszerek más megközelítést alkalmaznak: az adverzariális tanítás helyett explicit módon minimalizálnak egy statisztikai távolság mértéket a forrás- és cél jellemző eloszlások között. Az előny a tanítás stabilitása, nincsenek adverzariális dinamikák, amelyek gondos hiperparaméter hangolást igényelnek, a potenciális gyengébb igazítás árán.
A Maximum Mean Discrepancy (MMD) a legszélesebb körben használt eltérés mérték a domain adaptációhoz. Az MMD egy kernel-alapú statisztikai teszt, amely két eloszlás közötti távolságot méri egy Reprodukáló Kernel Hilbert-térben (RKHS). Adott forrásjellemzők (\mathbf{f}^S) és céljellemzők (\mathbf{f}^T) esetén a négyzetes MMD:
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
ahol (\phi) a jellemző leképezés az RKHS-be. A gyakorlatban az MMD-t egy kernel függvény (k(x,y) = \langle \phi(x), \phi(y) \rangle) segítségével számítják ki, jellemzően a Gauss-féle RBF kernellel, gyakran több sávszélességgel, hogy az eloszlási hasonlóság különböző szintjeit rögzítsék.
A Deep Adaptation Networks (DAN), amelyet Long és munkatársai vezettek be 2015-ben, MMD veszteséget ad hozzá egy mély CNN több feladatspecifikus rétegéhez. A teljes veszteség a következő lesz: (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), ahol (L) azon rétegek halmaza, ahol a domain igazítást alkalmazzák. A DAN kimutatta, hogy a magasabb szintű jellemző reprezentációk igazítása (nem csak a végső réteg) jelentősen javítja az adaptáció minőségét.
A CORrelation ALignment (CORAL), amelyet Sun és Saenko vezetett be 2016-ban, egy egyszerűbb megközelítést alkalmaz a forrás- és cél jellemző kovariancia mátrixok közötti különbség minimalizálásával:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
ahol (C_S) és (C_T) a forrás és cél jellemzők kovariancia mátrixai, (d) a jellemző dimenzió, és (|\cdot|_F) a Frobenius norma. A Deep CORAL ezt kiterjeszti mély hálózatokra a CORAL veszteség hozzáadásával a hálózat veszteségfüggvényéhez. A CORAL számításilag hatékony, és jól teljesít, ha a domain eltolódás elsősorban a jellemző varianciában van, nem az átlagban.
A Joint Adaptation Networks (JAN) kiterjeszti a DAN-t azáltal, hogy több réteg együttes eloszlásait igazítja ahelyett, hogy minden réteget egymástól függetlenül kezelne. A JAN Joint MMD (JMMD) használ, amely több réteg aktivációinak tenzor szorzatán van definiálva. Ez rögzíti a rétegközi függőségeket, amelyeket az egyes MMD veszteségek elmulasztanak.
Az infrastruktúra-ellenőrzés legújabb fejlesztései közé tartozik a Wang és munkatársai (2025) által a korrózió szegmentáláshoz kifejlesztett keretrendszer, amely három kiegészítő eltérés modult kombinál: Geometriai Szerkezet Megőrzés (GSP), amely megtartja a lokális topológiai kapcsolatokat a domének között gráf-alapú regularizáció segítségével, SVD-alapú Lokális Eltérés (SLD), amely szinguláris érték felbontást használ a lokális jellemző alterek finom szintű igazításához, és Globális Konzisztencia Igazítás (GCA), amely MMD-t használ a globális eloszlási eltolódások összeegyeztetésére. Ez a kombinált megközelítés, amelyet a könnyű EffSegNet szegmentálási gerinc támogat, erős kereszt-domain általánosítást ért el a laboratóriumi korróziós képektől a valós körülményekig a zsilipek, gátak és közlekedési infrastruktúra területén.
Az UDA Módszerek Összehasonlítása
| Módszer | Kategória | Igazítási Mechanizmus | Tanítás Stabilitása | Infrastruktúra Teljesítmény |
|---|---|---|---|---|
| DANN | Adverzariális | Gradiens fordítás + domain osztályozó | Mérsékelt (λ hangolást igényel) | Erős (15–25 ppt mIoU-t állít vissza) |
| DAN | Eltérés | MMD több réteg kimenetén | Magas | Jó (10–20 ppt mIoU-t állít vissza) |
| Deep CORAL | Eltérés | Kovariancia igazítás (2. rendű statisztikák) | Magas | Mérsékelt (8–15 ppt mIoU-t állít vissza) |
| JAN | Eltérés | Joint MMD réteg párokon | Magas | Jó (12–18 ppt mIoU-t állít vissza) |
| CycleGAN+Det | Generatív | Kép–kép fordítás + feladat modell | Alacsony (GAN tanítás nehézsége) | Erős, ha a képfordítás sikeres |
| CAT | Adverzariális | Kontrasztív + adverzariális | Mérsékelt | Erős (jelenlegi legjobb több benchmarkon) |
Domain-Invariáns Jellemző Tanulás
A domain-invariáns jellemzők olyan jellemző reprezentációk, amelyeket egy neurális hálózat hoz létre, és amelyeknek ugyanaz a statisztikai eloszlása, függetlenül attól, hogy a bemenet melyik doménből származik. Ha (f(x)) a hálózat által kivont jellemző reprezentáció, a domain invariancia azt jelenti, hogy (P(f(X_S)) \approx P(f(X_T))). A cél egy olyan (f) leképezés megtanulása, amely minimalizálja a (d(P(f(X_S)), P(f(X_T)))) távolságot, miközben megőrzi a feladatspecifikus diszkriminatív erőt.
A domain-invariáns jellemzők tanulásának négy fő megközelítése mindegyike eltérően kezeli az invariancia-diszkriminabilitás kompromisszumot. Az adverzariális tanulás (DANN, GAN-alapú) arra készteti a jellemzőkivonót, hogy olyan jellemzőket hozzon létre, amelyeket egy domain diszkriminátor nem tud megkülönböztetni. Ez a legagresszívebb invariancia mechanizmus, de fennáll a veszélye, hogy eltávolítja a feladathoz releváns információkat, ha a repedés textúrája korrelál a felület típusával. A statisztikai momentum illesztés (MMD, CORAL) igazítja az eloszlás momentumait, elsőrendű (átlag) és másodrendű (kovariancia) a forrás- és céljellemzők között. Ez több feladathoz releváns információt őriz meg, mint a teljes adverzariális igazítás, de nem biztos, hogy rögzíti a magasabb rendű eloszlási különbségeket. Az optimális transzport (OT-alapú módszerek) megtalálja a minimális költségű leképezést a forrás- és céleloszlások között, geometriai értelmezést biztosítva a domain igazításnak. A stílusátviteli és generatív módszerek (CycleGAN, StarGAN) a képeket egyik doménről a másikra alakítják át, hogy vizuálisan hasonlítsanak a másikra, mielőtt átadnák őket a feladat hálózatnak. Ez a pixel szinten működik, nem a jellemző szinten, és előnye, hogy értelmezhető átalakított képeket állít elő.
Az invariancia-diszkriminabilitás kompromisszuma alapvető feszültséget jelent a domain-invariáns jellemző tanulásban. A domain invariancia maximalizálása eltávolíthatja a feladathoz releváns információkat, amelyek korrelálnak a doménnel. Például, ha a repedés élek aszfalton nagyobb kontrasztúak, mint betonon, egy olyan jellemző detektor, amely az élkontraszt erősségére támaszkodik, érzékeny lesz mind a repedés jelenlétére, mind a burkolat típusára. A burkolat típusával szembeni teljes invariancia kikényszerítése elnyomhatja a repedésdetektáláshoz szükséges élkontraszt jellemzőket. A fejlett módszerek ezt többszintű igazítással kezelik, csak a magasabb szintű szemantikai jellemzőket igazítva, miközben megtartják az alacsony szintű textúra jelzéseket, és feltételes igazítással, amely a feladat címke szerint feltételesen igazítja az eloszlásokat, megőrizve az osztály-diszkriminatív információkat.
A figyelem-alapú domain invariancia figyelmi mechanizmusokat használ a domén-agnosztikus szemantikai régiókra való összpontosításhoz. Egy repedésdetektáló modell térbeli figyelmi modullal megtanul a repedés szerkezetekre összpontosítani a háttér burkolati textúrától függetlenül. A figyelmi térképek maguk is domain-invariánsabbá válnak, mint a nyers jellemző térképek, mert kiemelik a feladathoz releváns térbeli helyeket, miközben elnyomják a doménspecifikus hátteret. A kereszt-figyelem a forrás- és céljellemzők között tovább erősíti ezt azáltal, hogy explicit módon összehasonlítja a figyelt régiókat a domének között.
Az ön-felügyelt domain adaptációs módszerek előfeladatokat használnak, mint a forgatás előrejelzése, kirakós játék megoldása vagy kontrasztív példány diszkrimináció, hogy olyan jellemzőket tanuljanak, amelyek robusztusak a domain változatossággal szemben anélkül, hogy bármilyen doméncímkére lenne szükség. Ezen segédfeladatok megoldásával a modell megtanulja rögzíteni a bemenet olyan strukturális és geometriai tulajdonságait, amelyek közösek a domének között. Az ön-felügyelt előtanított jellemzők gyakran erősebb domain invarianciát mutatnak, mint a tisztán felügyelt jellemzők, mivel az előfeladatok nem függnek a doménspecifikus címkeeloszlásoktól.
Adaptáció Útról Kifutópályára
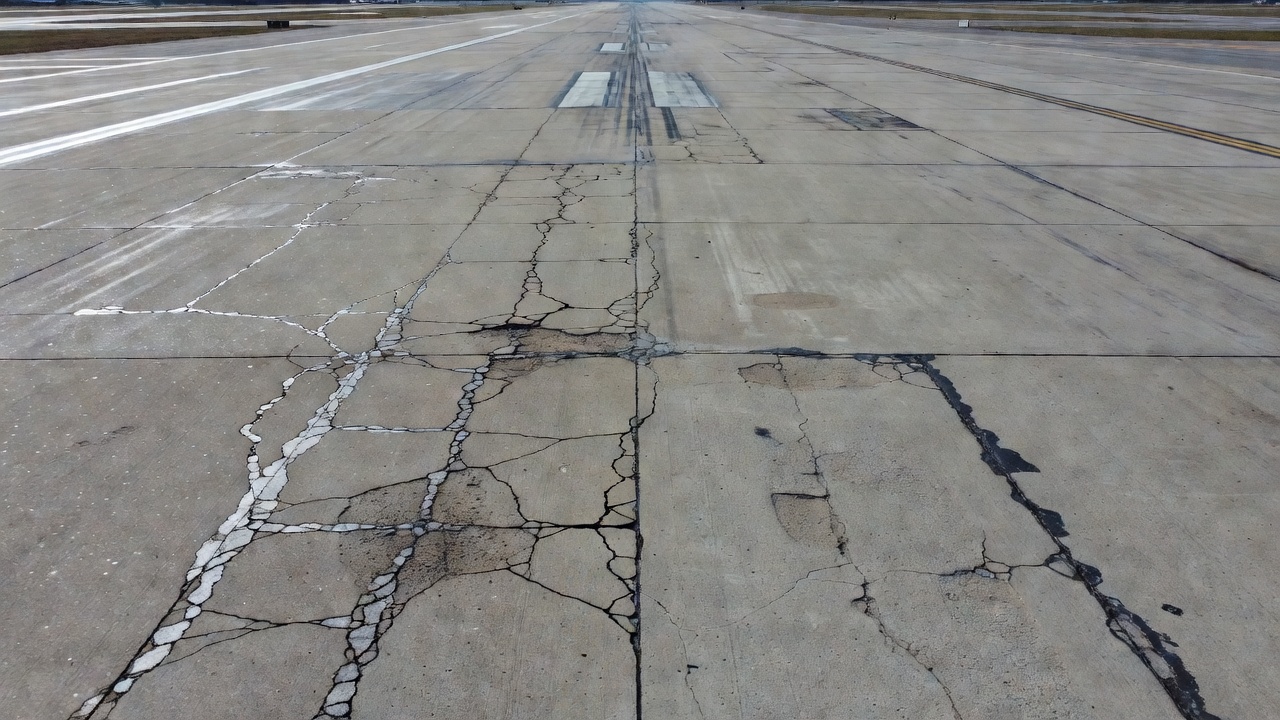
Az útburkolat-ellenőrzésről a repülőtéri kifutópálya-ellenőrzésre való áttérés az infrastruktúra vagyonkezelésének egyik legnagyobb kihívást jelentő domain adaptációs problémája. Az utak és kifutópályák alapvetően eltérő tervezésű szerkezetek, amelyeket különböző terhelésekre, sebességekre és biztonsági követelményekre terveztek, ami drámaian eltérő vizuális megjelenést és hibajellemzőket eredményez.
| Tényező | Útburkolat | Repülőtéri Kifutópálya Burkolat |
|---|---|---|
| Tervezési szabvány | Joghatóságonként változó | ICAO Annex 14 / FAA szabványok |
| Terhelés tengelyenként | ~10 tonna (járművek) | 50–400 tonna (repülőgépek) |
| Elsődleges felületi anyag | Aszfalt (HMA) | Nagy szilárdságú PCC beton (gyakori) vagy nehéz teherbírású aszfalt |
| Jelölések | Sárga/fehér sávjelölések (több szín) | Csak fehér jelölések, összetett mintázatok (küszöb, érintkezési zóna, célzási pont, középvonal) |
| Elsődleges hibatípusok | Repedések, kátyúk, nyomvályúk, bitumen kifolyás | Repedések, FOD, gumilerakódások, felületi kátyúsodás, súrlódás csökkenés, sugárhajtású gép erózió, üzemanyag-kiömlés károsodás |
| Ellenőrzési hozzáférés | Nyilvános utak, könnyű, korlátozás nélküli hozzáférés | Korlátozott légoldal, repülőtéri belépőt, járműkísérőt, rádiókapcsolatot igényel |
| Domináns rögzítési módszer | Földi járművek, okostelefonok, manuális | UAV 30–100 m magasságban, speciális ellenőrző járművek |
| Felületi szennyeződések | Víz, hó, törmelék, olaj | Víz, gumi (kritikus, érintkezési zónák), jégtelenítő folyadékok, sugárhajtómű üzemanyag, hidraulika folyadék |
| Biztonságkritikus súrlódási paraméter | Csúszásállóság fékezéshez | Fékezési hatástényező a leszálló repülőgépekhez (ICAO GRF kategóriák) |
| Szabályozási keretrendszer | FHWA, állami DOT szabványok | ICAO Annex 14, Doc 9137, FAA AC-k |
A gumilerakódás zavarása a legnagyobb kihívást jelentő adaptációs probléma. A repülőgép abroncsok gumit raknak le a kifutópályákon a leszállás során, különösen az érintkezési zónában, sötét, folyamatos foltokként halmozódva fel a burkolat felületén. Ezek a gumilerakódások vizuálisan utánozhatják vagy elfedhetik a repedéseket. Egy úton tanított repedésdetektáló modell, amely soha nem találkozott gumiabroncs lerakódásokkal, vagy nem észleli a repedéseket a gumifoltok alatt, vagy tévesen a gumifolt széleit osztályozza repedésként. Az út–kifutópálya adaptációnak ezért tartalmaznia kell a gumilerakódás modellezését, akár a tanítóadatok szintetikus augmentációján, akár olyan domain adaptációs módszereken keresztül, amelyek megtanulják megkülönböztetni a gumit a repedésektől.
A méret- és felbontásbeli különbségek egy másik jelentős adaptációs akadályt jelentenek. Az útellenőrzési képeket jellemzően talajszintről, 1–5 méteres távolságból rögzítik, ami nagyon nagy felbontást eredményez, ahol az egyes repedés élek tíz pixelt is átfognak. A kifutópálya-ellenőrzés UAV-k segítségével 30–100 m magasságban durvább felbontású képeket eredményez. Egy repedés, amely egy útképben 50 pixelt fed le, egy magasból készült kifutópálya képen csak 5–10 pixelt fedhet le. A jellemzőkivonó receptív mezőinek és skálafüggő szűrőinek alkalmazkodniuk kell a térbeli frekvencia tartalom ezen különbségéhez. A többskálájú jellemző piramisok és a skála-invariáns tanítás elengedhetetlen adaptációs összetevők.
A hiba definíció eltérése gondos leképezést igényel az út- és kifutópálya hibák taxonómiái között. Az FHWA LTPP Distress Identification Manual az útburkolati hibákat olyan kategóriákban határozza meg, amelyek részben átfedésben vannak az ASTM D5340 és az ICAO Doc 9137 9. része által meghatározott repülőtéri burkolati hibákkal. Néhány hibatípus egyedi a repülőterek számára: a gumilerakódásoknak, a sugárhajtású gép eróziónak, az üzemanyag-kiömlés károsodásnak és a súrlódás csökkenésnek nincs útbeli megfelelője. Az úton tanított modelleknek ezért új kimeneti osztályokat kell hozzáadni az adaptáció során, vagy egy hierarchikus osztályozási megközelítést kell alkalmazniuk, amely először általános hibákat észlel, majd azokat doménspecifikus kategóriákba sorolja.
A szabályozási megfelelés további réteget ad az adaptációs követelményekhez. Az útellenőrzési modellek olyan kimeneteket produkálnak, amelyek a DOT ügynökségek karbantartási prioritásait tájékoztatják. A kifutópálya-ellenőrzési modelleknek olyan kimeneteket kell produkálniuk, amelyek megfelelnek az ICAO- és FAA által előírt jelentési formátumoknak: a Global Reporting Format (GRF) állapotkategóriái, a Pavement Condition Index (PCI) az ASTM D5340 szerint, és a Pavement Classification Number (PCN) besorolások. Az adaptációs folyamatnak ezért a modell kimeneti reprezentációját is hozzá kell igazítania a szabályozási jelentési szabványokhoz.
A progresszív domain áthidalás, amely fokozatosan áthidalja a szakadékot az úttól a kifutópályáig terjedő köztes adathalmazokon való tanítás révén, hatékonynak bizonyult. Egy tipikus áthidaló csővezeték három szakaszból áll: először tanítás út adathalmazokon (CQU-BPDD, RDD2020, Crack500), másodszor adaptáció általános burkolati adathalmazokra, amelyek aszfalt- és betonfelületeket is tartalmaznak, harmadszor adaptáció kifutópálya-specifikus adathalmazokra gumilerakódásokkal és repülőtéri jelölésekkel. Minden egyes szakasz csökkenti az eloszlási szakadékot, amelyet a következő szakasznak át kell hidalnia, lehetővé téve a stabilabb és hatékonyabb adaptációt, mint a közvetlen út–kifutópálya átvitel.
Adaptáció Éghajlati Körülmények Között
Az éghajlati körülmények olyan domain változatosságot vezetnek be, amely időbeli (idővel változik egyetlen helyszínen) és földrajzi (helyszínek között egyidejűleg változik). A több repülőtéren telepített modellnek mindkét dimenziót kezelnie kell.
A nedves vs száraz felület adaptáció kritikus, mert a kifutópálya felületi állapot kategóriái az ICAO Global Reporting Format szerint kifejezetten megkülönböztetik a száraz, nedves, csúszós nedves és szennyezett felületeket. A nedves felületek többféleképpen is megváltoztatják a repedések láthatóságát. A repedéseket kitöltő víz csökkenti a kontrasztot a repedés és a környező burkolat között. A száraz repedések nagy kontrasztú sötét vagy világos vonalasként jelennek meg, de a vízzel teli repedések alacsony kontrasztú jellemzőkként jelennek meg, amelyek szinte láthatatlanok lehetnek egy száraz felületeken tanított modell számára. A burkolat felületén lévő vízfilm tükörreflexiókat hoz létre, amelyek világos régiókat és hamis éleket vezetnek be, összezavarva a repedésdetektorokat. A nedves burkolat összességében sötétebbnek tűnik, eltolva a kép hisztogramját és megváltoztatva a hálózat minden rétegének statisztikáit.
A hideg éghajlati adaptáció a fagyás-olvadás hatásokkal foglalkozik, amelyek megváltoztatják a burkolat megjelenését. A fagyott felületek eltérő reflexiós tulajdonságokkal rendelkeznek, mint a felolvadt felületek. A burkolaton lévő jégfoltok sima, nagy reflexiójú régiókként jelennek meg, amelyek vizuális jellemzőikben osztoznak a burkolati felületi hibákkal. A hótakaró részben vagy teljesen eltakarja a felületi hibákat. A fagyás és olvadás közötti átmeneti ciklusok egyedi károsodási mintákat hoznak létre: D-repedés, fagyás-olvadás hámlás és fagyfelverődés, amelyeket a meleg éghajlati adatokon tanított modellek nem ismernek fel.
Az adat augmentáció az éghajlati adaptációhoz szintetikusan generálja a cél domén variációit a forrás domén képeiből. Szimulált esőcsíkok, nedves felületi reflexiós modellek, hótakaró maszkok és árnyék overlay-ek hozzáadása kibővítheti a forrás domén lefedettségét olyan éghajlati körülményekre, amelyek nem voltak jelen az eredeti tanító adatokban. A RandAugment szabályzatok, amelyek specifikus fotometriai transzformációkat céloznak meg a fényerő, kontraszt és színhőmérséklet eltolódásokra, különösen hatékonyak az éghajlati adaptációhoz. Tanulmányok azt mutatják, hogy a csak augmentációs megközelítések a megvilágítás és időjárás domain eltolódások által elvesztett teljesítmény 50–70%-át állítják vissza, így költséghatékony kiegészítői a bonyolultabb adverzariális vagy eltérés-alapú módszereknek.
A CycleGAN-alapú domain fordítás alternatívát kínál azáltal, hogy megtanulja a képek lefordítását az éghajlati viszonyok között. Egy CycleGAN, amelyet száraz és nedves kifutópályák párosított vagy párosítatlan képein tanítanak, megtanul leképezni a száraz doménről a nedves doménre, miközben megőrzi a repedések helyét és geometriáját. Az ezen augmentált adatokon tanított repedésdetektáló modellek olyan jellemzőket tanulnak, amelyek invariánsak a víz jelenlétére vagy hiányára a felületen. A hátránya a GAN-ok tanításának összetettsége és annak kockázata, hogy a fordítás során a repedés jellemzők hallucinálódnak vagy eltávolításra kerülnek.
Adaptáció Kamera Típusok Között
Az infrastruktúra-ellenőrző rendszerek különféle képalkotó platformokat használnak, amelyek mindegyike eltérő optikai jellemzőkkel rendelkezik, amelyek domain eltolódást vezetnek be. A kamera típusok közötti adaptáció elengedhetetlen minden olyan rendszer számára, amelyet több repülőtéren telepítenek, ahol a meglévő képek különböző forrásokból származhatnak.
A felbontás és a Ground Sampling Distance (GSD) széles skálán mozog. A talajszintű ellenőrzés 50 MP DSLR-rel 0,1–0,5 mm/pixel GSD-t produkál. Az UAV ellenőrzés 30 m magasságban 0,5–1 cm/pixel GSD-t produkál. Az UAV ellenőrzés 100 m magasságban 2–5 cm/pixel GSD-t produkál. A műholdképek felbontása 30–50 cm/pixel lehet. Egy 3 mm széles repedés 6–30 pixelt fed le talajszinten, 0,3–0,6 pixelt 30 m-es UAV magasságban, és szub-pixeles 100 m-en. A nagy felbontású talajképeken tanított modellek nem tudják közvetlenül észlelni a jellemzőket durvább felbontásokon. A többszintű felbontású tanítás, a képek több felbontási skálán történő tanítása az elsődleges stratégia. A jellemzőkivonó skála-invariáns reprezentációkat tanul piramis pooling, dilatált konvolúció vagy felbontás-adaptív normalizáció segítségével.
Az érzékelő spektrális érzékenységének különbségei a kamerák között befolyásolják a színreprezentációt. A különböző CMOS és CCD érzékelők eltérő kvantumhatékonysági görbékkel rendelkeznek a látható spektrumban, ami azt jelenti, hogy ugyanaz a felület kissé eltérő RGB-értékekkel jelenik meg a különböző kamerákból. A színkalibráció színellenőrző kártya használatával az adatgyűjtés során csökkenti ezt az eltolódást, de ritkán praktikus nagyszabású ellenőrzési programoknál. A hisztogram illesztés és színátvitel a forrás- és célképek között előfeldolgozási alternatívák. Kifinomultabb megközelítések közé tartozik az érzékelő-invariáns jellemző tanulás, amely explicit módon eltávolítja az érzékelőspecifikus színinformációkat a jellemző reprezentációkból színzavaró augmentációval a tanítás során.
A lencse torzítás a kamera és objektív kombinációk között változik. A széles látószögű objektíveket, amelyeket a kifutópálya hatékony lefedésére használnak, hordó torzítás jellemzi, amely megváltoztatja a repedés geometriáját. Az egyenes repedések íveltnek tűnhetnek a kép szélei közelében. A detektálási feladatoknál ez a torzítás befolyásolja a képi jellemzők közötti térbeli kapcsolatot. A torzítás korrekciója előfeldolgozási lépésként normalizálja az összes képet egy közös rektifikált geometriára, mielőtt a modellbe táplálná. Alternatív megoldásként a szintetikus torzítás augmentációval végzett tanítás robusztussá teszi a modellt a változó torzítási szintekkel szemben.
A görgős zár hatásai az UAV platformokról geometriai torzítást vezetnek be repülés közben, különösen nagy sebességnél vagy szeles körülmények között. A görgős zár CMOS érzékelő sorainak egymás utáni expozíciója azt jelenti, hogy a kamera mozgása az expozíció során ferde vagy torz repedésgeometriát eredményez. Ez az időbeli torzítás hiányzik a globális zárral rendelkező kamerákból és a talajszintű statikus rögzítésből. Az adaptációhoz vagy a görgős zár műtermékek kijavítására szolgáló előfeldolgozásra, vagy olyan adatokon való tanításra van szükség, amelyek szintetikus görgős zár romlást tartalmaznak.
| Kamera Változás | Adaptációs Stratégia | Megvalósítás Bonyolultsága | Tipikus Helyreállítás |
|---|---|---|---|
| Felbontás / GSD | Többszintű felbontású tanítás + piramis pooling | Mérsékelt | 5–10% pontosság helyreállítás |
| Érzékelő színválasza | Színzavaró augmentáció + hisztogram illesztés | Alacsony | 3–7% pontosság helyreállítás |
| Lencse torzítás | Torzítás korrekció előfeldolgozás | Alacsony | 2–5% pontosság helyreállítás |
| Görgős zár | Szintetikus görgős zár augmentáció | Mérsékelt | 3–6% pontosság helyreállítás |
| Tömörítési műtermékek | JPEG tömörítés augmentáció | Alacsony | 1–3% pontosság helyreállítás |
Matematikai Alapok és Kulcsfontosságú Formulációk
A domain adaptáció megértése megköveteli több alapvető matematikai formuláció ismeretét. Az Empirikus Kockázat Minimalizálás (ERM) keretrendszer biztosítja a kiindulópontot. Adott forrásdomén címkézett mintákkal ({(x_i^S, y_i^S)}_{i=1}^{n_S}), egy szabványos modell minimalizálja az empirikus kockázatot:
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
ahol (\ell) a feladatspecifikus veszteségfüggvény (keresztentrópia osztályozáshoz, Dice veszteség szegmentáláshoz). A domain adaptáció célja a célkockázat minimalizálása:
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
A kihívás az, hogy (R_T) nem minimalizálható közvetlenül, ha a célcímkék nem állnak rendelkezésre. A domain adaptációs módszerek a célkockázatot a forráskockázat és a forrás- és céleloszlások közötti divergencia mértékének összegével korlátozzák.
Az H-divergencia elméleti korlátot biztosít a domain adaptációhoz (Ben-David et al., 2010). Egy (\mathcal{H}) hipotézisosztály esetén a forrás- és céleloszlások közötti H-divergencia:
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
A gyakorlatban a H-divergenciát egy osztályozónak a forrás- és cél domén minták közötti megkülönböztetésére való tanításával becsülik, pontosan azt, amit a DANN domain osztályozója csinál. Az elméleti eredmény garantálja, hogy a forrásadatokon tanított modell általánosít a cél doménre, ha a domének közötti H-divergencia kicsi. Ez biztosítja az adverzariális domain adaptáció formális igazolását.
Az MMD funkcionális formában egy karakterisztikus kernelt (k) használ a valószínűségi eloszlások RKHS-be való beágyazásához:
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
A Gauss-kernel (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)) esetén a négyzetes MMD közvetlenül kiszámítható a mintaátlagokból:
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
A CORAL veszteség a másodrendű statisztikákat igazítja:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
ahol (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) és (C_T) analóg módon van definiálva a céljellemzőkre. A Frobenius norma (|\cdot|_F) az elemekre vonatkozó négyzetösszeg.
Ezek a matematikai alapok közvetlenül lefordíthatók gyakorlati megvalósításra. A Deep CORAL hálózat domain adaptációs vesztesége:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Egy DANN hálózat esetében:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{domain}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
ahol (\mathbf{D} = {0, 1}) a forrás (0) vagy cél (1) domént jelöli, és a negatív előjel a gradiens fordítást tükrözi.
| Módszer | Célfüggvény | Kulcs Hiperparaméterek |
|---|---|---|
| ERM (nincs adaptáció) | (\mathcal{L} = \mathcal{L}_{task}(D_S, Y_S)) | Tanulási sebesség, súlycsökkenés |
| DANN | (\mathcal{L} = \mathcal{L}{task} - \lambda \mathcal{L}{domain}) | (\lambda) (adaptációs erősség), GRL ütemezés |
| DAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) rétegenként, kernel sávszélesség (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{task} + \lambda |C_S - C_T|_F^2) | (\lambda) (igazítási súly) |
| JAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l JMMD_l) | Réteg párok, kernel sávszélességek |
| Finomhangolás | (\mathcal{L} = \mathcal{L}_{task}(D_T, Y_T)) csökkentett LR | Befagyasztási ütemezés, LR csökkentési tényező |
Értékelési Protokollok a Domain Adaptációhoz
A domain adaptációs módszerek értékeléséhez szabványosított kereszt-adathalmaz benchmarkokra van szükség, amelyek mérik a teljesítményt a tanítás során nem látott cél doméneken. Az infrastruktúra-ellenőrzéshez több benchmark protokollt hoztak létre.
A kereszt-adathalmaz értékelés a szabványos protokoll. A modellt egy forrás adathalmazon tanítják (pl. CQU-BPDD, amely bitumenes burkolati repedésképeket tartalmaz), és egy cél adathalmazon értékelik (pl. RDD2020, amely több országból származó út repedésképeket tartalmaz). A cél adathalmazon elért teljesítmény adaptáció előtt a csak-forrás alapvonal. Az adaptáció utáni teljesítményt (címkézetlen céladatokhoz való hozzáféréssel az UDA esetében, vagy korlátozott címkézett céladatokkal az SDA esetében) ehhez az alapvonalhoz viszonyítva mérik. Az adaptációs nyereség, az adaptált és nem adaptált teljesítmény közötti különbség, számszerűsíti az adaptációs módszer hatékonyságát.
Gyakori benchmarkok a burkolati repedésdetektáláshoz a következők: CQU-BPDD (Bituminous Pavement Crack Dataset), amely 60 088 képből álló aszfaltburkolati repedéseket tartalmaz Kínából, RDD2020, amely 26 336 képből álló út repedéseket tartalmaz Indiából, Japánból és Csehországból, Crack500, amely 500 nagy felbontású képből álló útburkolati repedéseket tartalmaz, DeepCrack, amely 537 képből álló épületfal repedéseket tartalmaz, és SDNET2018, amely 56 000 képből álló beton hídfedélzet, fal és burkolati képeket tartalmaz. A kereszt-adathalmaz értékelés ezeken az adathalmazokon, különösen a CQU-BPDD-től RDD2020-ig, amely egy kereszt-ország és kereszt-klíma átvitelt reprezentál, a legszigorúbb benchmark.
A domain adaptáció értékelésének metrikái közé tartozik a cél-domén mIoU (átlagos Intersection over Union a szegmentálási feladatokhoz), a cél-domén F1-pontszám (detektálási feladatokhoz), a forrásmegtartás (forrás domén teljesítmény adaptáció után, a katasztrofális felejtés mérésére), az adaptációs nyereség (százalékpontos javulás a csak-forrás alapvonalhoz képest) és a címkehatékonyság (mennyi cél címkézett adatra van szükség egy adott teljesítményszint eléréséhez a felügyelt módszereknél).
A statisztikai szignifikancia tesztelése elengedhetetlen, mert a domain adaptációs eredmények zajosak lehetnek. Több futtatás különböző véletlen magokkal (jellemzően 5–10) segítségével számítják ki a teljesítménymutatók átlagát és szórását. A Wilcoxon előjeles rang teszt vagy páros t-teszt segítségével határozzák meg, hogy az adaptációs módszerek közötti teljesítménykülönbségek statisztikailag szignifikánsak-e a hagyományos küszöbértékeken ((p < 0,05)).
Az infrastruktúra-ellenőrzéshez további telepítésspecifikus metrikák relevánsak: téves pozitív arány működési súlyossági küszöbértékeken (egy repedésdetektor, amely 100 téves riasztást generál kifutópálya-ellenőrzésenként, működésileg használhatatlan, függetlenül a mIoU-jától), következtetési idő egységnyi területre vetítve (az adaptáció nem növelheti jelentősen a feldolgozási időt), és memórialábnyom (az adapter-alapú módszereknek minimális tárolási többletet kellene hozzáadniuk minden további repülőtérhez).
Kulcsfontosságú Szabványok és Referenciák
A domain adaptáció gyakorlata az infrastruktúra-ellenőrzésben több tudományág szabványaira és kutatásaira támaszkodik.
Gépi tanulási alapok: Ganin et al., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), a kanonikus DANN cikk a gradiens fordítás bevezetésével. Long et al., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), az MMD-alapú többrétegű domain igazítás bevezetése. Sun and Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), a kovariancia-alapú igazítás bevezetése. Ben-David et al., “A theory of learning from different domains” (Machine Learning, 2010), a domain adaptáció általánosítási korlátainak elméleti keretrendszere.
Infrastruktúra-ellenőrzés domain adaptáció: Liu et al., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), a repedésdetektálás domain adaptáció elsődleges referenciája kétágú, megosztott súlyú architektúrával. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), többszintű jellemző-igazítás a kereszt-adathalmaz repedésdetektáláshoz. Wang, Nguyen, Eick et al., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), hárommodulos eltérés keretrendszer az infrastruktúra korróziójához.
ICAO és FAA szabványok: ICAO Annex 14, Aerodromes, Volume I (8. kiadás, 2018 módosításokkal), elsődleges nemzetközi szabvány a repülőterek minősítéséhez, amely létrehozza a domain eltolódás kontextusát a repülőterek között. ICAO Doc 9137, Part 9, Airport Services Manual, Airport Maintenance Practices, burkolatkarbantartási útmutató. ICAO Global Reporting Format (GRF) for Runway Surface Conditions (2021. novemberétől hatályos), a felületi állapot domének (száraz, nedves, szennyezett) meghatározása. FAA AC 150/5380-6C, Guidelines and Procedures for Maintenance of Airport Pavements. ASTM D5340, Standard Test Method for Airport Pavement Condition Index Surveys, a burkolati állapot számszerű értékelésének keretrendszere, amelyet a domain-adaptált modelleknek támogatniuk kell.
Burkolati adathalmazok: CQU-BPDD (Chongqing University, 60 088 aszfaltburkolati repedéskép). RDD2020 (8 300+ út kép Indiából, Japánból, Csehországból). Crack500 (500 nagy felbontású burkolati repedéskép). SDNET2018 (56 000 hídfedélzeti, fali és burkolati kép a Utah State University-től). Ezek az adathalmazok biztosítják a szabványosított benchmarkokat a domain adaptáció értékeléséhez a burkolatellenőrzésben.
Gyakran Ismételt Kérdések
- Mi a domain adaptáció a gépi tanulásban?
- A domain adaptáció a transzfer tanulás egy részterülete, amely a domain eltolódás problémáját kezeli, ahol egy forrás adathalmazon betanított modell rosszul teljesít, ha egy eltérő statisztikai tulajdonságokkal rendelkező cél adathalmazon alkalmazzák. A cél az, hogy domain-invariáns jellemző reprezentációkat tanuljunk, hogy a modell általánosítson a domének között anélkül, hogy teljes újratanításra lenne szükség címkézett céladatokon. A domain adaptáció kategóriái: felügyelt (korlátozott címkézett céladat áll rendelkezésre), felügyelet nélküli (nincs címkézett céladat) és fél-felügyelt (néhány címkézett plusz címkézetlen céladat) változatok.
- Hogyan érinti a domain eltolódás a burkolati repedésdetektáló modelleket?
- A domain eltolódás a burkolati repedésdetektálásban 30–45%-os teljesítménycsökkenést okoz az átlagos Intersection over Union (mIoU) értékben, amikor egyik adathalmazról a másikra váltunk. Az eltolódás forrásai közé tartoznak a felületi anyagkülönbségek (aszfalt vs beton), a repedésmorfológiai változatosság (hosszirányú vs alligátor repedés), a képalkotási körülmények változása (fényerősség szög, felbontás, kamera érzékelő) és a földrajzi tényezők (különböző aggregátum típusok és öregedési minták). Például egy CQU-BPDD adathalmazon betanított modell 0,72 mIoU-t ér el a forrás tesztadatokon, de 0,31-re csökken, ha RDD2020 céladatokon tesztelik adaptáció nélkül.
- Mi a különbség a transzfer tanulás és a domain adaptáció között?
- A transzfer tanulás egy modellt adaptál, amelyet egy feladatra tanítottak, hogy egy másik feladatot végezzen el, például egy ImageNet osztályozó modell finomhangolása repedésdetektáláshoz. A domain adaptáció ugyanazt a feladatot kezeli különböző adateloszlások között, például egy aszfalt repedésdetektor adaptálása betonfelületeken lévő repedések detektálásához. A transzfer tanulásnál a forrás- és célfeladatok eltérhetnek, a domain adaptációnál a feladat azonos, de a bemeneti eloszlások különböznek.
- Mik a domain-invariáns jellemzők?
- A domain-invariáns jellemzők olyan reprezentációk, amelyeket egy neurális hálózat von ki, és amelyeknek ugyanaz a statisztikai eloszlása, függetlenül attól, hogy a bemenet melyik doménből származik. Ha egy repedésdetektáló hálózat olyan jellemzőket tanul, amelyek ugyanúgy néznek ki, akár egy aszfaltút, akár egy beton kifutópálya kép a bemenet, akkor ezek a jellemzők domain-invariánsak. Ezeket adverzariális tréninggel (egy domain diszkriminátor nem tudja megmondani, melyik doménből származnak a jellemzők), statisztikai momentum-illesztéssel (MMD, CORAL) vagy optimális transzport technikákkal tanulják. Az alapvető kihívás az invariancia-diszkriminabilitás kompromisszuma: a jellemzők túlzott domain-invariánssá tétele eltávolíthatja a feladathoz releváns információkat, mint a repedés textúrája, amely korrelál a felület típusával.
- Hogyan működik a felügyelet nélküli domain adaptáció?
- A felügyelet nélküli domain adaptáció (UDA) címkézett forrásadatokat és címkézetlen céladatokat használ egy olyan modell betanításához, amely általánosít a cél doménre. A három fő megközelítés: (1) adverzariális módszerek, mint a DANN, ahol egy domain diszkriminátor megpróbálja azonosítani, melyik doménből származnak a jellemzők, miközben a jellemzőkivonó megpróbálja becsapni, (2) eltérés-alapú módszerek, mint a DeepCORAL és a DAN, amelyek minimalizálják a statisztikai távolság mértékeket (MMD, kovariancia különbség) a forrás- és cél jellemzőeloszlások között, és (3) rekonstrukció-alapú módszerek, amelyek autoenkódereket vagy GAN-okat használnak a megosztott reprezentációk tanulásához.
- Milyen kihívások merülnek fel az útról kifutópályára történő adaptáció során?
- Az út–kifutópálya domain adaptáció alapvető különbségekkel szembesül a felületi anyagban (aszfalt vs nagy szilárdságú PCC beton), a terhelési jellemzőkben (10 tonnás járműtengelyek vs 50–400 tonnás repülőgép terhelések), a hibák típusaiban (gumilerakódások, sugárhajtású gép erózió, üzemanyag-kiömlés károsodás a kifutópályákon), az ellenőrzési hozzáférésben (nyilvános utak vs korlátozott légoldal), a képalkotási módszerekben (földi járművek vs UAV 30–100 m magasságban) és a szabályozási megfelelésben (ICAO Annex 14 szabványok). A gumilerakódás zavarása különösen kihívást jelent, a gumiabroncsok sötét foltokként halmozódnak fel a kifutópályákon, amelyek utánozhatják vagy elfedhetik a repedéseket, ez olyan állapot, amellyel az útmodellek soha nem találkoznak.
- Mi a Domain-Adverzariális Neurális Hálózat (DANN)?
- A Domain-Adverzariális Neurális Hálózat (DANN), amelyet Ganin és Lempitsky vezetett be 2015-ben, az adverzariális domain adaptáció kanonikus architektúrája. Három komponensből áll: egy jellemzőkivonóból, amely a bemeneteket egy megosztott jellemzőtérbe képezi le, egy címke előrejelzőből, amely végrehajtja a feladatot (pl. repedés osztályozás), és egy domain osztályozóból, amely megjósolja, hogy a bemenet melyik doménhez tartozik. A jellemzőkivonó és a domain osztályozó között egy Gradiens Fordító Réteg (GRL) található, amely a visszaterjedés során megfordítja a gradiens előjelét, arra késztetve a jellemzőkivonót, hogy olyan jellemzőket tanuljon, amelyek maximalizálják a domain összetévesztést. A teljes veszteség a forráscímkéken lévő feladat veszteség mínusz a domain osztályozási veszteség, súlyozva egy lambda hiperparaméterrel.
- Mely domain adaptációs stratégiák illeszkednek a céladat különböző mennyiségeihez?
- A stratégia a rendelkezésre álló céladat mennyiségétől függ. A teljes finomhangolás alkalmas mérsékelt mennyiségű címkézett céladathoz, az utolsó réteg vagy adapter-alapú hangolás nagyon korlátozott címkézett adatokhoz, a felügyelet nélküli adaptáció batch normalizációs statisztikák és jellemző igazítás használatával akkor használatos, ha nincsenek célcímkék. A progresszív feloldás és a cél képalkotási körülményekhez szabott augmentáció segít az adaptált modellnek megtartani a forrás doménből tanultakat.
- Mi a Maximum Mean Discrepancy (MMD)?
- A Maximum Mean Discrepancy (MMD) egy kernel-alapú statisztikai teszt, amelyet két valószínűségi eloszlás közötti távolság mérésére használnak egy Reprodukáló Kernel Hilbert-térben (RKHS). A domain adaptációban az MMD-t veszteségfüggvényként használják a forrás- és cél jellemző reprezentációk közötti eloszlási szakadék minimalizálására. Az MMD képlet kiszámítja a forrás- és cél jellemzők átlagos beágyazásai közötti különbség normáját az RKHS-ben. A Deep Adaptation Networks (DAN) és a Joint Adaptation Networks (JAN) az MMD veszteséget több hálózati rétegben alkalmazzák a többszintű domain igazítás eléréséhez.
- Milyen ICAO szabványok kapcsolódnak a domain adaptációhoz a kifutópálya-ellenőrzésben?
- Az ICAO Annex 14 szabványokat határoz meg a repülőterek tervezésére és üzemeltetésére, ami természetes domain adaptációs követelményt teremt. A különböző repülőterek eltérő burkolati anyagokkal, éghajlatokkal és karbantartási előzményekkel rendelkeznek, ezért az ellenőrző modelleknek alkalmazkodniuk kell a repülőterek között. A Global Reporting Format (GRF) meghatározza a kifutópálya felületi állapot kategóriáit (száraz, nedves, csúszós nedves, szennyezett), amelyek különálló vizuális doméneket képviselnek. Az ICAO Doc 9137 9. része és az FAA AC 150/5380-6C karbantartási útmutatót nyújt. Amikor AI-alapú ellenőrzést telepítenek repülőterek között, a domain adaptáció elengedhetetlen, mert egy repülőtér adatain betanított modell eltérő megvilágítással, burkolati korral és hiba morfológiákkal találkozik egy másik repülőtéren.
Ez egy referenciabejegyzés. A TarmacView drónos ellenőrzési szolgáltatásokat nyújt, és nem árulja az ebben a szószedetben leírt felszereléseket vagy anyagokat.