Čo je adaptácia domény pre medzipovrchové inšpekčné modely?
Adaptácia domény pre medzipovrchové inšpekčné modely: Kompletný technický průvodník
Definícia a problém doménového posunu
Adaptácia domény je podkategória prenosového učenia, ktorá rieši zásadnú výzvu v nasadení modelov strojového učenia: štatistický nesúlad medzi tréningovými dátami a dátami nasadenia. Keď model trénovaný na zdrojovej doméne, dátovej množine s známymi charakteristikami a typicky abundatnými označenými príkladmi, je nasadený na cieľovej doméne s rôznymi štatistickými vlastnosťami, výkonnosť degraduje. Adaptácia domény poskytuje metódy na preklenutie tohto gapu, umožňujúc modelom generalizovať medzi doménami bez zbierania a označovania veľkých nových dátových množín pre každé prostredie nasadenia.
Formálne, doména je definovaná ako pár skladajúci sa z priestoru vlastností (X) a distribúcie pravdepodobnosti (P(X)) nad tým priestorom: (D = {X, P(X)}). Úloha je pár skladajúci sa z priestoru označiek (Y) a prediktívnej funkcie (f: X \to Y). Zdrojová doména (D_S) je doména, na ktorej model je pôvodne trénovaný s abundatnými označenými dátami. Cieľová doména (D_T) je nová doména, kde model musí fungovať, často s obmedzenými alebo žiadnymi označkami. Cieľom adaptácie domény je naučiť funkciu (f_T: X_T \to Y_T) pre cieľovú doménu, využívajúc znalosti z zdrojovej domény, napriek nesúladu (P_S(X) \neq P_T(X)).
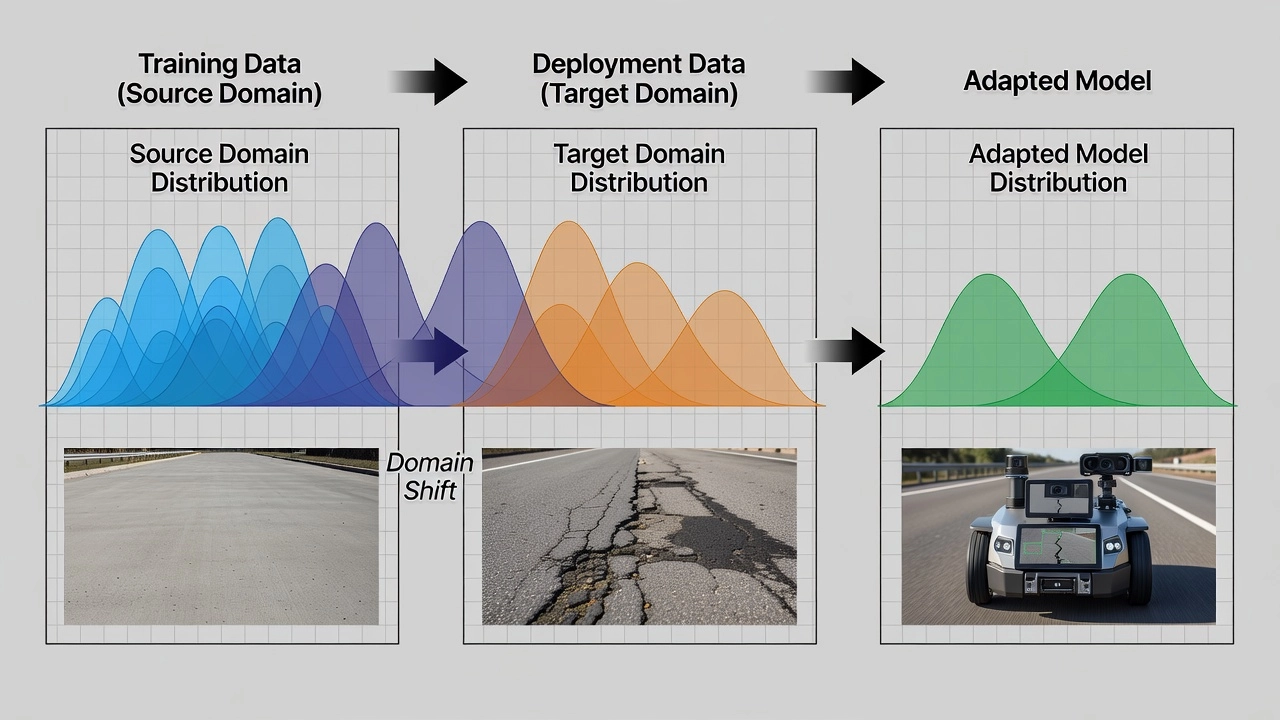
Doménový posun (tiež nazývaný distribúciový posun alebo posun dátovej množiny) je fenomén, kde distribúcia dát líši sa medzi prostrediami tréningu a nasadenia. Keď nastáva doménový posun, výkonnosť modelu degraduje, pretože naučené mapovanie z vstupov na výstupy viac nezodpovedá cieľovým podmienkam. Doménový posun manifestuje sa v troch hlavných formách. Kovariátový posun nastáva, keď distribúcia vstupných vlastností sa mení, zatiaľ čo kondicionálna distribúcia označiek daných vstupmi ostáva rovnaká: formálne, (P_S(X) \neq P_T(X)) ale (P_S(Y|X) = P_T(Y|X)). To je najčastejšia forma v počítačovej vízii, vizuálny vzhľad trhlíny na asfalte líši sa od trhlíny na betóne, ale mapovanie z vizuálnych vlastností na označku “trhlínový” ostáva konzistentné. Posun označiek (alebo priorový posun) nastáva, keď distribúcia triedových označiek sa mení: (P_S(Y) \neq P_T(Y)) ale (P_S(X|Y) = P_T(X|Y)). To nastáva, keď hustota trhlín líši sa medzi miestami tréningu a nasadenia. Konceptový posun nastáva, keď relácia medzi vstupmi a výstupmi sa mení: (P_S(Y|X) \neq P_T(Y|X)), napríklad, keď vizuálny vzor, ktorý indikuje zaliatu trhlínu na cestách, indikuje štrukturálny defekt na dráhach.
Pre počítačovú víziu v inšpekcii infraštruktúry, doménový posun vzniká z viacerých kompoundných faktorov. Rôznice vo vizuálnom vzhľade zahŕňajú textúru vozovky (hrubý asfalt vs hladký betón), farbové profily (tmavosivý asfalt vs svetlosivý betón) a vzory starnutia (oxidovaný povrch vs čerstvo vyliaty). Podmienky zobrazovania ako svetlo (priame slnko pod 60° uhlom vs zamračené difúzne svetlo), rozlíšenie kamery a spektrálna senzitivita senzora, a uhol zobrazovania (nadir z UAV vs šikmý z vozidla) všetky prispievajú signifikantnými distribúciovými posunmi. Prostredné faktory zahŕňajú mokré vs suché povrchy, tieňové oklúzie od štruktúr a sezónne debris (listy, sneh, stojaca voda) ďalej kompoundujú problém. Rôznice v materiáli povrchu medzi asfaltom a betónom, alebo medzi starými a čerstvo vyliatymi povrchmi, reprezentujú jeden z najvýzvnejších doménových posunov pre modely inšpekcie vozovky.
Výskum dokumentoval závažnosť doménového posunu v detekcii trhlín v vozovke kvantitatívne. Rámec DDACRN reportoval, že bez adaptácie domény, stredná Intersection over Union (mIoU) detekcie trhlín padá z 0,72 na zdrojových testovacích dátach na 0,31 na medzidátových cieľových dátach, čo je 57% redukcia výkonnosti. DACrack demonštroval, že mitigácia doménového posunu prostredníctvom viacúrovňového zarovnania vlastností obnovuje približne 20 percentuálnych bodov v F1-skóre na medzidátových transferoch. Tieto empirické výsledky podčiarkujú, že adaptácia domény nie je len akademickým zlepšením, ale operacionálnou nevyhnutnosťou pre každý inšpekčný systém nasadený na viacerých letiskách, cestách alebo mostových sieťach.
Doménový posun v zobrazovaní infraštruktúry
Obrazy inšpekcie infraštruktúry sú podrobené viacerým interagujúcim zdrojom doménového posunu, ktoré sa vzájomne kompoundujú. Rozumenie každého zdroja je esenciálne pre dizajn efektívnych adaptáciových stratégií.
Posun materiálu povrchu je najvýraznejší doménový posun v inšpekcii infraštruktúry. Asfaltové a betónové vozovky majú zásadne rôzne vizuálne charakteristiky. Asfalt je tmavosivý až čierny v farbe, má hrubú a nepravidelnú textúru povrchu, a trhliny typicky vyzerajú ako svetlé lineárne vlastnosti proti tmavému pozadiu. Betón je svetlosivý až biely, má hladší a uniformnejší povrch, a trhliny vyzerajú ako tmavé linie. Tieto rôznice znamenajú, že konvolučná neurónová sieť trénovaná na jednom type povrchu učí sa filtre a reprezentácie vlastností špecifické pre štatistiku vizuálu toho povrchu. Keď je aplikovaná na druhý typ povrchu, tieto filtre produkujú aktivácie vlastností, ktoré klasifikátorové vrstvy nemôžu správne interpretovať. Dáta z DDACRN zobrazujú, že medzipovrchová mIoU padá z 0,72 na 0,31 bez adaptácie pri transferovaní z asfalt-trénovaných na betón-testovaných modelov.
Variácia morfológie trhlín uvádza ďalšiu vrstvu doménového posunu. Rôzne typy distressu vozovky majú odlišné vizuálne signatúry. Pozdĺžne trhliny bežia paralelne s osou vozovky a vyzerajú ako dlhé, kontinuálne lineárne vlastnosti. Transverzálne trhliny bežia perpendicularne k osi. Aligátorové (fatigue) trhliny formujú interkonektované siete malých polygonov pripominajúcich aligátorovú kožu. Vlasové trhliny merajú menej ako 1 mm v širine a môžu byť ledva viditeľné, zatiaľ čo široké trhliny prekračajú 5 mm a sú ľahko identifikovateľné. Zaliaté trhliny naplnené zalievacím materiálom majú rôzny vizuálny vzhľad než nezaliaté trhliny. Model trénovaný prevažne na pozdĺžnych trhlinách môže zlyhať detekovať aligátorové trhliny v cieľovej doméne, kde ten typ distressu je prevalentnejší.
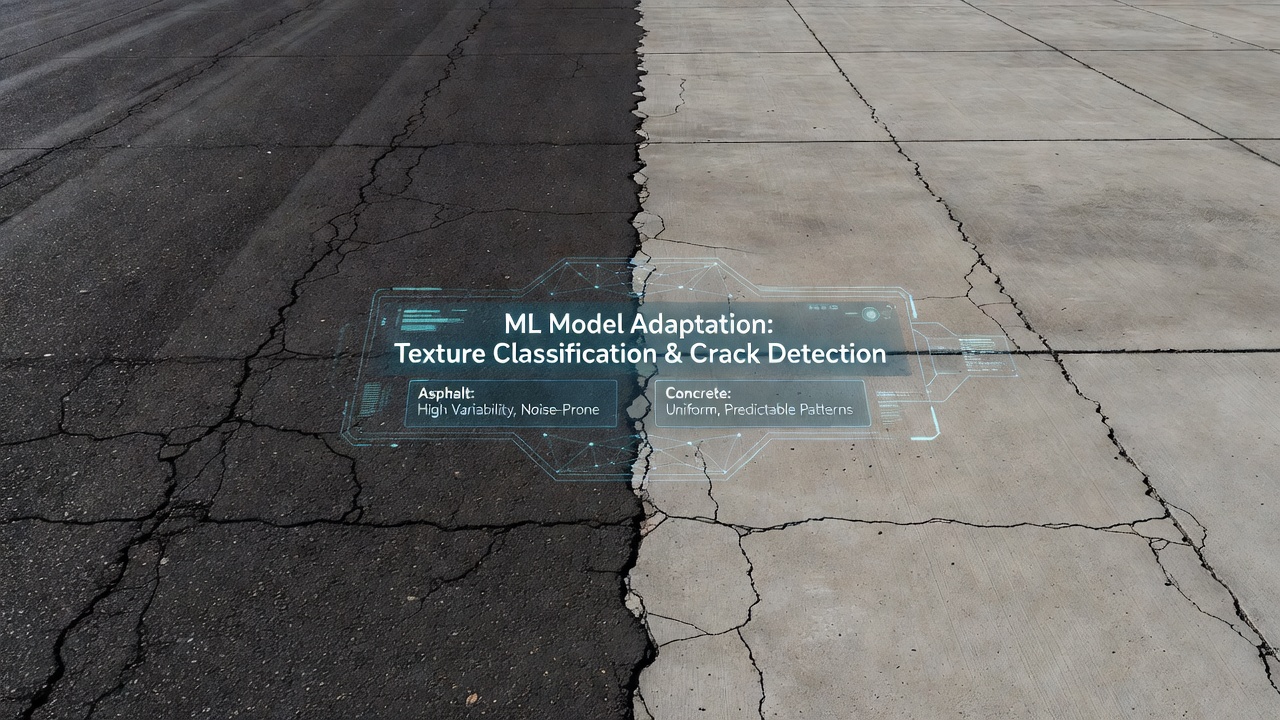
Posun svetelnej podmienky signifikantne ovplyvňuje výkonnosť modelu. Modely trénované na dobre osvetlených denných obrazoch pod priamym slnkom zlyhajú na obrazoch pri slabom svetle alebo za svitania, obrazoch s ostrými tieňmi od štruktúr alebo stromov, a obrazoch pod zamračenými podmienkami, kde difúzne svetlo redukuje kontrast. Uhol incidentného svetla relatívne k normále povrchu mení vzhľad okrajov trhlín, nízke slnko zdôrazňuje textúru povrchu metalím tieňov vnútri trhlín, zatiaľ čo vysoke slnko nad hlavou minimalizuje viditeľnosť trhlín. Tieňová oklúzia od mostových nadštruktúr, terminálových budov letiska alebo blízkych štruktúr produkuje lokalizované tmavé regióny, kde vlastnosti trhlín sú supresované. Štúdie dokumentovali 5–12% padov v presnosti pre modely detekcie trhlín, keď svetelné podmienky posunú sa z tréningovej distribúcie.
Posun kamery a senzora vzniká z rôznic v zobrazovacom hardvéri. Rôzne kamery produkujú rôzne rozlíšenia obrazov (12 MP smartfón vs 50 MP DSLR vs špecializovaná industriálna kamera), rôzne farbové profily a krivky spektrálnej senzitivity senzora, rôzne charakteristiky distorzie objektívu a rôzne vzory šumu. Pre UAV-založenú inšpekciu, výška letu determinuje Ground Sampling Distance (GSD), fyzickú vzdialenosť na zemi reprezentovanú každým pixelom. UAV letiaci na 30 m produkuje približne 0,5–1 cm/pixel GSD, zatiaľ čo jeden na 100 m produkuje 2–5 cm/pixel. Rôznice v GSD znamenajú, že rovnaká trhlína je reprezentovaná rôznym počtom pixelov a rôznym priestorovým frekvenčným obsahom v zdrojovej vs cieľovej doméne. Doutovanie s rekomputáciou štatistik Batch Normalization (BN) je často dostatočné pre stredné posuny kamery, zatiaľ čo závažné posuny vyžadujú adversariálne doménové zarovnanie na viacerých úrovniach vlastností.
Sezónny a prostredný posun uvádza temporálnu doménovú variáciu. Model trénovaný na letných obrazoch musí fungovať v zimných podmienkach, kde povrchy môžu byť mokré, snehom pokryté alebo čiastočne zakryté padlými listmi. Povrchy vozovky podstupujú starnutiu a oxidácii v čase, meniac ich farbu a textúru. FAA a ICAO Global Reporting Format (GRF) explicitne uznáva prostrednú podmienku ako variablu, ktorá ovplyvňuje ocenu stavu povrchu dráhy: suchá, mokrá, klzká mokrá a kontaminovaná povrchy každá reprezentuje odlišnú vizuálnu doménu vyžadujúcu rôznu inšpekčnú interpretáciu.
| Zdroj doménového posunu | Typický vplyv na výkonnosť | Primárna mitigáciová stratégia |
|---|---|---|
| Materiál povrchu (asfalt vs betón) | 30–45% pad mIoU | Adversariálna DA + viacúrovňové zarovnanie vlastností |
| Svetelné podmienky (slnečno vs zamračeno) | 5–12% pad presnosti | BN adaptácia + fotometrická augmentácia |
| Rozlíšenie / senzor kamery | 3–8% pad presnosti | Doutovanie + rekomputácia BN štatistik |
| Sezónne / prostredné | 8–20% pad presnosti | Generatívny doménový preklad (CycleGAN) |
| Geografické / regionálne | 10–25% pad presnosti | Viaczdrojová UDA + progresívne doménové preklenovanie |
Doutovanie pre adaptáciu domény
Doutovanie je najjednostavnejšia a najširšie používaná stratégia adaptácie domény. Zahŕňa branie neurónovej siete predtrénovanej na zdrojovej doméne a kontinuovanie tréningového procesu na cieľových dátach domény, aktualizujúc váhy modelu na zarovnanie jeho reprezentácií s cieľovou distribúciou. Doutovanie preklenuje gap medzi prenosovým učením (kde úloha sa mení) a adaptáciou domény (kde úloha ostáva rovnaká, ale distribúcia dát sa mení).
Teoretický základ doladenia spočíva na observácii, že neurónové siete učia sa hierarchické reprezentácie vlastností. Ranné vrstvy zachycujú nízkoúrovňové vlastnosti ako okraje, textúry a farbové bloby, ktoré sú z veľkej časti doménovo-agnostické. Stredné vrstvy kombinujú ich do strednoúrovňových vzorov ako okraje trhlín, zrno povrchu a medze škár. Neskoré vrstvy učia sa úlohovo-špecifické vlastnosti optimalizované pre klasifikáciový alebo segmentáciový cieľ. Keď doména posunie sa, nízkoúrovňové štatistiky (farbové distribúcie, textúrne frekvencie, kontrastové charakteristiky) sa menia, a neskoré vrstvy, ktoré sú fino prispôsobené zdrojovým distribúciám vlastností, strácajú zarovnanie.
Úplné doladenie aktualizuje všetky parametre modelu na cieľových dátach. To je vhodné, keď abundatné označené cieľové dáta sú dostupné (stovky až tisíce obrazov) a výpočtové resursy umožňujú kompletné gradientové aktualizácie. Rýchlosť učenia je typicky redukovaná faktorom 10 relatívne k pôvodnému predtrénovaniu, aby sa predišlo katastrofickému zapomínaniu, fenoménu, kde model prepisuje užitočné zdrojové znalosti. Ranné stopovanie založené na cieľovej validáciovej strate je esenciálne na balansovanie retencie zdrojových znalostí s cieľovou adaptáciou.
Doutovanie poslednej vrstvy (klasifikátora) zamrazuje všetky vrstvy extrakcie vlastností a trénuje len finálnu klasifikáciovú alebo segmentáciovú hlavu. Tento prístup predpokladá, že extraktor vlastností naučený na zdrojovej doméne produkuje reprezentácie, ktoré sú dostatočne všeobecné, a len mapovanie z vlastností na označky potrebuje prispôsobenie. Doutovanie poslednej vrstvy je efektívne, keď veľmi obmedzené cieľové dáta sú dostupné (desiatky obrazov) a doménový posun je primárne v priestore označiek, nie v priestore vlastností. Vyžaduje minimálnu výpočtovú prácu a je rezistentné na katastrofické zapomínanie.
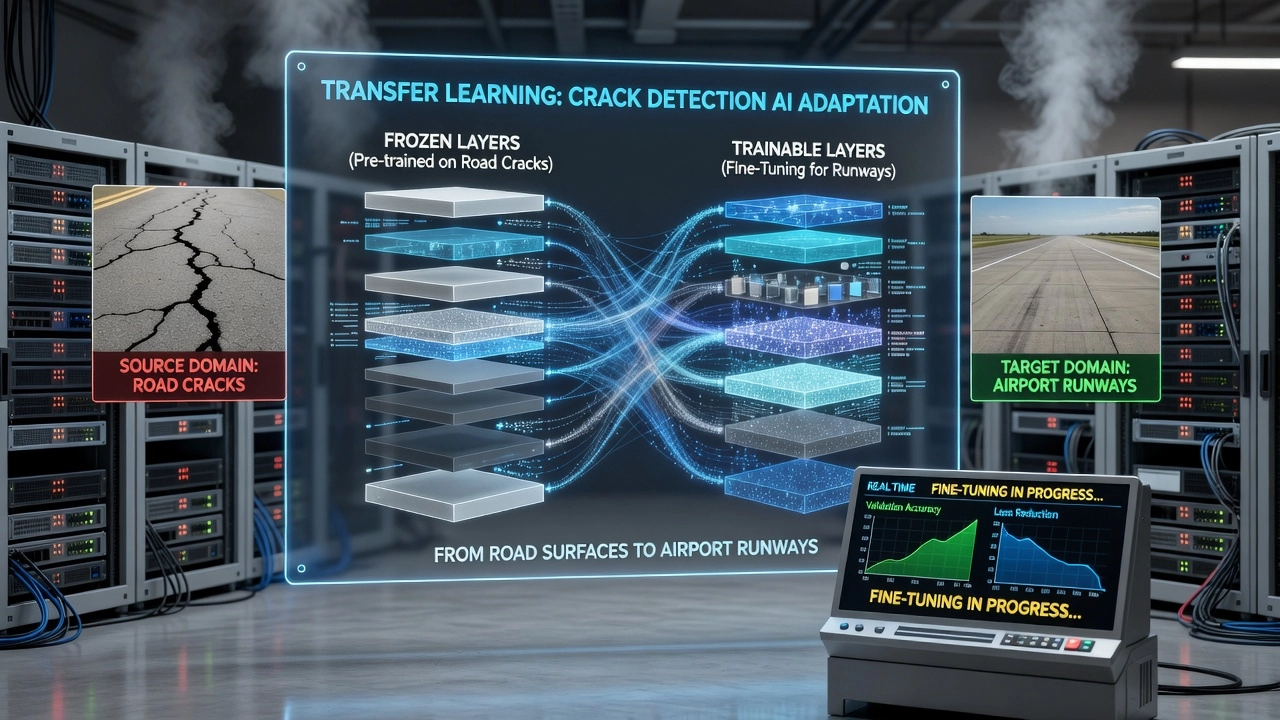
Progresívne odmrazovanie poskytuje strednú cestu. Tréningový proces začína so všetkými vrstvami zamrazenými okrem finálneho klasifikátora, ktorý je trénovaný niekoľko epoch. Potom, najvyššie vrstvy extrakcie vlastností sú odmrazené a trénované spolu s klasifikátorom. Tento proces kontinuuje, postupne odmrazujúc vrstvy od vrchu do dnu, až kým všetky vrstvy sú doladené alebo dosiahnutý je plató výkonnosti. Progresívne odmrazovanie je vhodné pre stredné množstvo cieľových dát (stovky obrazov) a doménové posuny, ktoré ovplyvňujú viaceré úrovne hierarchie vlastností.
Adaptérové moduly uvádzajú malé úzke vrstvy s signifikantne menej parametrov než celá sieť. Tieto adaptéry sú vložené medzi vrstvy zamrazeného predtrénovaného backboneu a sú jedinými parametrami aktualizovanými počas doladenia. Adaptérové doladenie je vysoko parametrovo-efektívne, typicky 1–5% z celkového počtu parametrov, a umožňuje rýchle preklapanie medzi viacerými cieľovými doménami prostredníctvom skladovania a načítania rôznych adaptérových váh. Pre inšpekčné siete s miliónmi parametrov, adaptérové moduly umožňujú nasadenie na desiatkach letísk bez skladovania separátnych kopií kompletných váh pre každé.
Adaptácia Batch Normalization (BN) je zarážajúco ľahká a pritom efektívna technika. BN vrstvy vypočítujú bežné stredné hodnoty a variancie počas tréningu na normalizáciu intermediárnych map vlastností. Keď doména posunie sa, tieto štatistiky viac presne nereprezentujú cieľovú distribúciu. BN adaptácia jednoducho rekomputuje BN štatistiky prostredníctvom prechodu cieľových dát domény prostredníctvom siete so zamrazenými váhami, aktualizujúc bežné stredné hodnoty a variancie bez akýchkoľvek gradientových aktualizácií. To samo môže signifikantne redukovať doménový posun, keď primárny rôzdieľ je v nízkoúrovňových štatistikách obrazu ako jas, kontrast a farbová distribúcia. Štúdie na detekcii trhlín zobrazujú, že BN adaptácia obnovuje 3–8% padov presnosti spôsobených strednými posunmi svetla a kamery, vyžadujúc len jeden forward pass neoznačených cieľových dát.
| Stratégia doladenia | Vyžadované cieľové dáta | Aktualizované parametre | Riziko katastrofického zapomínania | Najlepší prípad použitia |
|---|---|---|---|---|
| Rekomputácia BN štatistik | Žiadne (neoznačené) | 0 (len BN štatistiky) | Žiadne | Posuny svetla / kamery |
| Doutovanie poslednej vrstvy | 10–50 označených | < 1% | Veľmi nízke | Distribúcia vlastností zachovaná |
| Adaptérové moduly | 50–200 označených | 1–5% | Nízke | Viacdoménové nasadenie |
| Progresívne odmrazovanie | 100–500 označených | Postupné, 10–100% | Stredné | Stredný doménový posun |
| Úplné doladenie | 500+ označených | 100% | Vysoké | Abundatné cieľové dáta, veľký posun |
Rízorovná adaptácia domény
Rízorovná adaptácia domény (SDA) operuje pod predpokladom, že malé množstvo označených dát je dostupné v cieľovej doméne spolu s abundatnými označenými zdrojovými dátami. To je najjednostavnejšie nastavenie: model má priamy prístup k ground-truth informácii o cieľovej doméne, umožňujúc explicitnú optimalizáciu pre cieľovú výkonnosť.
Standardný SDA prístup má dve komponenty. Prvý, model je predtrénovaný na zdrojovej doméne s jej abundatnými označkami, to ustanovuje všeobecné znalosti o inšpekčnej úlohe, učiac sa rozpoznávať okraje trhlín, medze škár, textúry povrchu a geometrie defektov. Druhý, model je doladený na označených cieľových dátach používajúc substanciálne redukovanú rýchlosť učenia. Počas doladenia, strata funkcia typicky kombinuje zdrojové a cieľové straty, aby predišla modelu zapomínať užitočné zdrojové znalosti. Kombinovaná strata je vyjadrená ako:
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
kde (\mathcal{L}_S) je zdrojová strata vypočítaná na zdrojových dátach, (\mathcal{L}_T) je cieľová strata vypočítaná na označených cieľových dátach, a (\lambda) kontroluje relatívny príspevok každej domény. Počas tréningu, zdrojové a cieľové batche sú alternatívne alebo spoločne prechádzane prostredníctvom siete.
Kľučové techniky pre řízorovnú adaptáciu domény zahŕňajú vážené strata funkcie, ktoré dávajú vyššiu dôležitosť vzorkám cieľovej domény počas doladenia, spoločný tréning, kde zdrojové a cieľové označené dáta sú miešané v každom tréningovom batche, a doménový adversariálny tréning, kde doménový klasifikátor je pridaný aj v řízorovnom nastavení, aby povzbudil extraktor vlastností učiť sa doménovo-invariantné reprezentácie. Kurikulové učenie stratégie začínajú so zdrojovo-dominovaným tréningom a postupne preklápajú balans smerom k cieľovým dátam, ako tréning pokračuje.
Prenos parametrov, kde váhy zdrojovo-trénovaného modelu slúžia ako inicializácia, je dominantná stratégia v SDA. Úspech tohto prístupu závisí od stupňa príbuznosti medzi zdrojovou a cieľovou doménou. Keď domény sú blízko príbuzné (napr. rôzne sekcie rovnakej letiskovej vozovky), veľmi málo označených cieľových príkladov je dostatočných, až 20–50 obrazov môže obnoviť väčšinu výkonnosti stratenej na doménový posun. Keď domény sú vzdialenejšie (napr. cesta na dráhu), 200–500 označených cieľových príkladov je typicky vyžadovaných pre robustnú adaptáciu.
Označkovo-efektívne SDA techniky cielia minimalizovať počet potrebných cieľových označiek. Aktívne učenie identifikuje najinformatívnejšie cieľové vzorky pre označenie: model je trénovaný na zdrojových dátach, aplikovaný na neoznačené cieľové dáta, a vzorky, kde je najviac neistý, sú vybrané pre ľudské označenie. Tento prístup môže redukovať vyžadovania označovania o 50–70% v porovnaní s náhodným vzorkovaním. Samotréning (alebo pseudo-označovanie) aplikuje zdrojovo-trénovaný model na neoznačené cieľové dáta, generuje provizórne označky pre vysoko-isté predikcie, a retrénuje model používajúc tieto pseudo-označky ako dodatočnú superviziu. Samotréning je obzvlášť efektívny, keď kombinovaný s konfidenčným prahom a augmentáciou dát.
Kedy používať SDA: keď získanie malej označenej množiny z každého cieľového miesta nasadenia je realizovateľné. Pre inšpekciu letiskovej dráhy, to znamená, že trénovaný inšpektor môže označiť 50–200 obrazov na letisko, jednorázový náklad 1–4 hodín na miesto. To je oveľa ekonomickejšie než alternatíva zbierania a označovania tisícok obrazov na letisko, ktorá by vyžadovala viaceré dni na miesto. FAA AC 150/5380-6C odporúča regulárne PCI prieskumy, ktoré už zahŕňajú inšpektorov examinujúcich povrchy vozovky, tí istí inšpektori môžu poskytnúť tie niekoľko sto označených obrazov potrebných pre SDA ako časť ich štandardného inšpekčného workflowu.
Neřízorovná adaptácia domény
Neřízorovná adaptácia domény (UDA) je najvýzvnejšie a najaktívnejšie výskumané nastavenie adaptácie domény. Predpokladá, že označené dáta existujú len v zdrojovej doméne, zatiaľ čo cieľová doména je kompletne neoznačená. UDA je dominantný scenár pre inšpekciu infraštruktúry, pretože označovanie cieľových dát domény je nákladné, časovo náročné alebo nepraktické na viacerých miestach nasadenia. Model trénovaný na obrazoch vozovky jedného letiska musí adaptovať sa na rôzne povrchy, svetlo a vzory defektov druhého letiska bez vyžadovania, aby každé letisko produkovalo označenú dátovú množinu.
UDA metódy padajú do troch hlavných kategórií: adversariálne metódy, diskrepancné metódy a rekonštrukčné metódy. Všetky zdieľajú koreňový cieľ zarovnania zdrojových a cieľových distribúcií vlastností tak, že klasifikátor trénovaný na zdrojových vlastnostiach generalizuje na cieľové vlastnosti.
Adversariálna adaptácia domény
Adversariálna adaptácia domény čerpá inspiráciu z Generative Adversarial Networks (GAN). Koreňová idea je trénovať doménový diskriminátor (binárny klasifikátor, ktorý predikuje, či reprezentácia vlastností prišla zo zdrojovej alebo cieľovej domény) spolu s extraktorom vlastností v minimaxovej igre. Extraktor vlastností pokúša produkovať vlastnosti, ktoré sú nerozoznateľné medzi zdrojom a cieľom, zatiaľ čo diskriminátor pokúša správne identifikovať pôvod každej vlastnosti.
Kanonická architektúra je Domain-Adversarial Neural Network (DANN), predstavený Yaroslavom Ganinom a Victorom Lempitskym v 2015. DANN skladá sa z troch komponentov: extraktor vlastností (G_f) mapujúci vstupy do priestoru vlastností (f = G_f(x, \theta_f)), prediktor označiek (G_y) mapujúci vlastnosti na úlohové označky (\hat{y} = G_y(f, \theta_y)), a doménový klasifikátor (G_d) mapujúci vlastnosti na doménové označky (\hat{d} = G_d(f, \theta_d)). Kritická inovácia je Vrstva obrátenia gradientu (GRL) umiestnená medzi extraktorom vlastností a doménovým klasifikátorom. Počas forward propagácie, GRL funguje ako identitná transformácia. Počas backpropagácie, násobí gradient (-\lambda), kde (\lambda) je hyperparameter kontrolujúci silu adaptácie. Toto obrátenie spôsobuje, že extraktor vlastností učí sa vlastnosti, ktoré maximalizujú stratu doménovej klasifikácie, efektívne učiac sa oklamať doménový klasifikátor.
Strata funkcia DANN kombinuje stratu úlohy na zdrojových označkách mínus stratu doménovej klasifikácie na oboch zdrojových a cieľových vlastnostiach:
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
Ako tréning pokračuje, extraktor vlastností učí sa reprezentácie, ktoré sú súčasne diskriminatívne pre úlohu (pretože prediktor označiek je trénovaný na zdrojových označkách) a doménovo-invariantné (pretože doménový klasifikátor nemôže rozoznať doménový pôvod). Plánovanie GRL typicky začína s (\lambda = 0) a postupne zvyšuje na maximalnú hodnotu počas prvých epoch, umožňujúc sieti stabilizovať jej úlohovú výkonnosť pred tlakom doménovej konfúzie.
Nedávne pokroky v adversariálnej adaptácii domény zahŕňajú Contrastive Adversarial Training (CAT), ktorý využíva označené zdrojové vzorky na zosilnenie separácie vlastností pri zachovaní doménového zarovnania, Collaborative and Adversarial Networks (CAN), ktoré vykonávajú viacúrovňové doménové zarovnanie na rôznych úrovniach hierarchie vlastností, a Adversarial Style Discrepancy Minimization, ktorý používa preklad štýlu ako adversariálny cieľ. Pre detekciu trhlín v vozovke, adversariálne metódy demonštrovali najsilnejšie medzidátové generalizácie, obnovujúc 15–25 percentuálnych bodov výkonnosti stratenej na doménový posun.
Diskrepancné metódy
Diskrepancné metódy berú rôzny prístup: namiesto adversariálneho tréningu, explicitne minimalizujú štatistickú mieru vzdialenosti medzi zdrojovými a cieľovými distribúciami vlastností. Výhoda je stabilita tréningu, žiadne adversariálne dynamiky vyžadujúce opatrnú hyperparametrovú tuningu, za náklad potenciálne slabšieho zarovnania.
Maximum Mean Discrepancy (MMD) je najširšie používaná diskrepancná miera pre adaptáciu domény. MMD je kernelový štatistický test, ktorý meria vzdialenosť medzi dvoma distribúciami v Reproducing Kernel Hilbert Space (RKHS). Dané zdrojové vlastnosti (\mathbf{f}^S) a cieľové vlastnosti (\mathbf{f}^T), kvadratická MMD je:
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
kde (\phi) je mapa vlastností do RKHS. V praxi, MMD je vypočítaná používajúc kernel funkciu (k(x,y) = \langle \phi(x), \phi(y) \rangle), typicky Gaussov RBF kernel, často s viacerými širinami pásma na zachycenie rôznych úrovní podobnosti distribúcie.
Deep Adaptation Networks (DAN), predstavené Long et al. v 2015, pridávajú MMD stratu na viaceré úlohovo-špecifické vrstvy hlbokej CNN. Celková strata stáva (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), kde (L) je množina vrstiev, na ktorých doménové zarovnanie je aplikované. DAN demonštrovalo, že zarovnanie vyšších úrovní reprezentácií vlastností (nielen finálnej vrstvy) signifikantne zlepšuje kvalitu adaptácie.
CORrelation ALignment (CORAL), predstavený Sun a Saenko v 2016, berie jednoduchší prístup minimalizujúc rôzdieľ medzi zdrojovými a cieľovými kovariančnými maticami vlastností:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
kde (C_S) a (C_T) sú kovariančné matice vlastností zdroja a cieľa, (d) je dimenzia vlastností, a (|\cdot|_F) je Frobeniusova norma. Deep CORAL rozširuje to na hlboké siete pridávaním CORAL straty do stratovej funkcie siete. CORAL je výpočtovo efektívny a funguje dobre, keď doménový posun je primárne v variancii vlastností, nie v strednej hodnote.
Joint Adaptation Networks (JAN) rozširujú DAN zarovnaním spoločných distribúcií viacerých vrstiev namiesto traktovania každej vrstvy nezávisle. JAN používa Joint MMD (JMMD), definovaný na tenzorový produkt aktivácií z viacerých vrstiev. To zachycuje medzivrstvové závislosti, ktoré individuálne MMD straty missujú.
Nedávne pokroky pre inšpekciu infraštruktúry zahŕňajú rámec Wang et al. (2025) pre segmentáciu korózie, ktorý kombinuje tri komplementárne diskrepancné moduly: Geometric Structure Preservation (GSP), ktorý zachováva lokálne topologické relácie medzi doménami používajúc grafovú regularizáciu, SVD-based Local Discrepancy (SLD), ktorý používa singular value decomposition na zarovnanie lokálnych podpriestorí vlastností na fino-zrnitom úrovni, a Global Consistency Alignment (GCA), ktorý používa MMD na zosúladenie globálnych distribúciových posunov. Tento kombinovaný prístup, podporený ľahkým EffSegNet segmentáciovým backboneom, dosiahol silnú medzidoménovú generalizáciu z laboratórnych obrazov korózie na polné podmienky na zámkoch, damoch a transportačnej infraštruktúre.
Porovnanie UDA metód
| Metóda | Kategória | Mechanizmus zarovnania | Stabilita tréningu | Výkonnosť infraštruktúry |
|---|---|---|---|---|
| DANN | Adversariálna | Obrátenie gradientu + doménový klasifikátor | Stredná (vyžaduje tuningu (\lambda)) | Silná (obnovuje 15–25 ppt mIoU) |
| DAN | Diskrepancná | MMD na výstupoch viacerých vrstiev | Vysoká | Dobrá (obnovuje 10–20 ppt mIoU) |
| Deep CORAL | Diskrepancná | Kovariančné zarovnanie (2. rád štatistik) | Vysoká | Stredná (obnovuje 8–15 ppt mIoU) |
| JAN | Diskrepancná | Joint MMD na pároch vrstiev | Vysoká | Dobrá (obnovuje 12–18 ppt mIoU) |
| CycleGAN+Det | Generatívna | Preklad obrazu na obraz + úlohový model | Nízka (ťažkosť tréningu GAN) | Silná, keď preklad obrazu úspeje |
| CAT | Adversariálna | Kontrastívna + adversariálna | Stredná | Silná (state-of-the-art na viacerých benchmarkoch) |
Učenie doménovo-invariantných vlastností
Doménovo-invariantné vlastnosti sú reprezentácie vlastností produkované neurónovou sieťou, ktoré majú rovnakú štatistickú distribúciu bez ohľadu na to, z ktorej domény vstup pochádza. Ak (f(x)) je reprezentácia vlastností extrahovaná sieťou, doménová invariancia znamená (P(f(X_S)) \approx P(f(X_T))). Cieľom je naučiť mapovanie (f) také, že vzdialenosť (d(P(f(X_S)), P(f(X_T)))) je minimalizovaná pri zachovaní úlohovo-špecifickej diskriminatívnej sily.
Štyri hlavné prístupy k učeniu doménovo-invariantných vlastností každý traktuje kompromis invariancie-diskriminability rôzne. Adversariálne učenie (DANN, GAN-založené) tlačí extraktor vlastností produkovať vlastnosti, ktoré doménový diskriminátor nemôže rozoznať. To je najagresívnejší mechanizmus invariancie, ale rizikuje odstránenie úlohovo-relevantnej informácie, ak textúra trhlín koreluje s typom povrchu. Štatistické porovnávanie momentov (MMD, CORAL) zarovnáva momenty distribúcie, prvý rád (stredná hodnota) a druhý rád (kovariancia), medzi zdrojovými a cieľovými vlastnosťami. To zachováva viac úlohovo-relevantnej informácie než kompletné adversariálne zarovnanie, ale môže nezachyciť rôznice vyššieho rádu distribúcie. Optimálny transport (OT-založené metódy) nachádza mapovanie minimálneho nákladu medzi zdrojovými a cieľovými distribúciami, poskytujúc geometrickú interpretáciu doménového zarovnania. Preklad štýlu a generatívne metódy (CycleGAN, StarGAN) transformujú obrazy z jednej domény, aby vizuálne pripominali druhú pred prechodom prostredníctvom úlohovej siete. To operuje na pixelovom úrovni namiesto úrovne vlastností a má výhodu produkcie interpretovateľných transformovaných obrazov.
Kompromis invariancie-diskriminability je zásadné napätie v učení doménovo-invariantných vlastností. Maximalizácia doménovej invariancie môže odstrániť úlohovo-relevantnú informáciu, ktorá koreluje s doménou. Napríklad, ak okraje trhlín na asfalte majú vyšší kontrast než na betóne, detektor vlastností, ktorý závisí od sily kontrastu okraja, bude senzitívny na prítomnosť trhlíny a typ vozovky. Nútenie kompletnej invariancie na typ vozovky môže supresovať vlastnosti kontrastu okraja potrebné pre detekciu trhlín. Pokročilé metódy adresujú to prostredníctvom viacúrovňového zarovnania, zarovnávajúc len vyššie semantické vlastnosti pri zachovaní nízkoúrovňových textúrnych cue, a kondicionálneho zarovnania, ktoré zarovnáva distribúcie kondicionované na úlohovú označku, zachovujúc triedovo-diskriminatívnu informáciu.
Pozornostné doménová invariancia využíva mechanizmy pozornosti na fokus na doménovo-agnostické semantické regióny. Model detekcie trhlín s priestorovým modulom pozornosti učí sa pozorovať štruktúry trhlín bez ohľadu na textúru pozadia vozovky. Samé mapy pozornosti stávajú doménovo-invariantnejšie než surové mapy vlastností, pretože zdôrazňujú úlohovo-relevantné priestorové lokácie pri supresovaní doménovo-špecifického pozadia. Krížová pozornosť medzi zdrojovými a cieľovými vlastnosťami ďalej zosilňuje to explicitným porovnávaním pozorných regiónov medzi doménami.
Samovizovné metódy adaptácie domény používajú pretextové úlohy ako predikciu rotácie, riešenie jigsaw puzzle alebo kontrastívnu instančnú diskrimináciu na učenie vlastností, ktoré sú robustné na doménovú variáciu bez vyžadovania akýchkoľvek doménových označiek. Prostredníctvom riešenia týchto auxiliárnych úloh, model učí sa zachycovať štrukturálne a geometrické vlastnosti vstupu, ktoré sú zdieľané medzi doménami. Samovizovné predtrénované vlastnosti často vykazujú silnejšiu doménovú invarianciu než čisto řízorovné vlastnosti, pretože pretextové úlohy nezávisia od doménovo-špecifických distribúcií označiek.
Adaptácia z cesty na dráhu
Prechod z inšpekcie cestnej vozovky na inšpekciu letiskovej dráhy reprezentuje jednu z najvýzvnejších problémov adaptácie domény v manažmente infraštruktúry. Cesty a dráhy sú zásadne rôzne inžinierske štruktúry dizajnované pre rôzne zaťaženia, rýchlosti a bezpečnostné vyžadovania, produkujúc dramaticky rôzne vizuálne vzhľady a charakteristiky defektov.
| Faktor | Cestná vozovka | Letisková dráha |
|---|---|---|
| Dizajnový štandard | Líši sa podľa jurisdikcie | ICAO Annex 14 / FAA normy |
| Zaťaženie na os | ~10 ton (vozidlá) | 50–400 ton (letadlá) |
| Primárny materiál povrchu | Asfalt (HMA) | Vysokopevnosťový PCC betón (často) alebo ťažký asfalt |
| Markirungy | Žlté/biele pásové markirungy (viaceré farby) | Len biele markirungy, komplexné vzory (prah, touchdown zóna, cieľový bod, osová línia) |
| Primárne typy defektov | Trhliny, vyjazdené koľaje, výtlky, vytekanie | Trhliny, FOD, gumové depozity, raveling, degradácia trenia, erózia od jet blast, škody od paliva |
| Prístup inšpekcie | Verejné cesty, ľahký neobmedzený prístup | Obmedzená airside, vyžaduje airside pass, vozidlový eskort, radiokomunikáciu |
| Dominantná metóda zobrazovania | Zemské vozidlá, smartfóny, manuálne | UAV na 30–100m výške, špecializované inšpekčné vozidlá |
| Povrchové kontaminanty | Voda, sneh, debris, olej | Voda, guma (kritická, touchdown zóny), de-icing tekutiny, jet palivo, hydraulická tekutina |
| Bezpečnostno-kritický parameter trenia | Rezistencia na sklz pre brzdenie | Koeficient brzdenia pre letadlá pri pristávaní (ICAO GRF kategórie) |
| Regulatívny rámec | FHWA, štátne DOT normy | ICAO Annex 14, Doc 9137, FAA ACs |
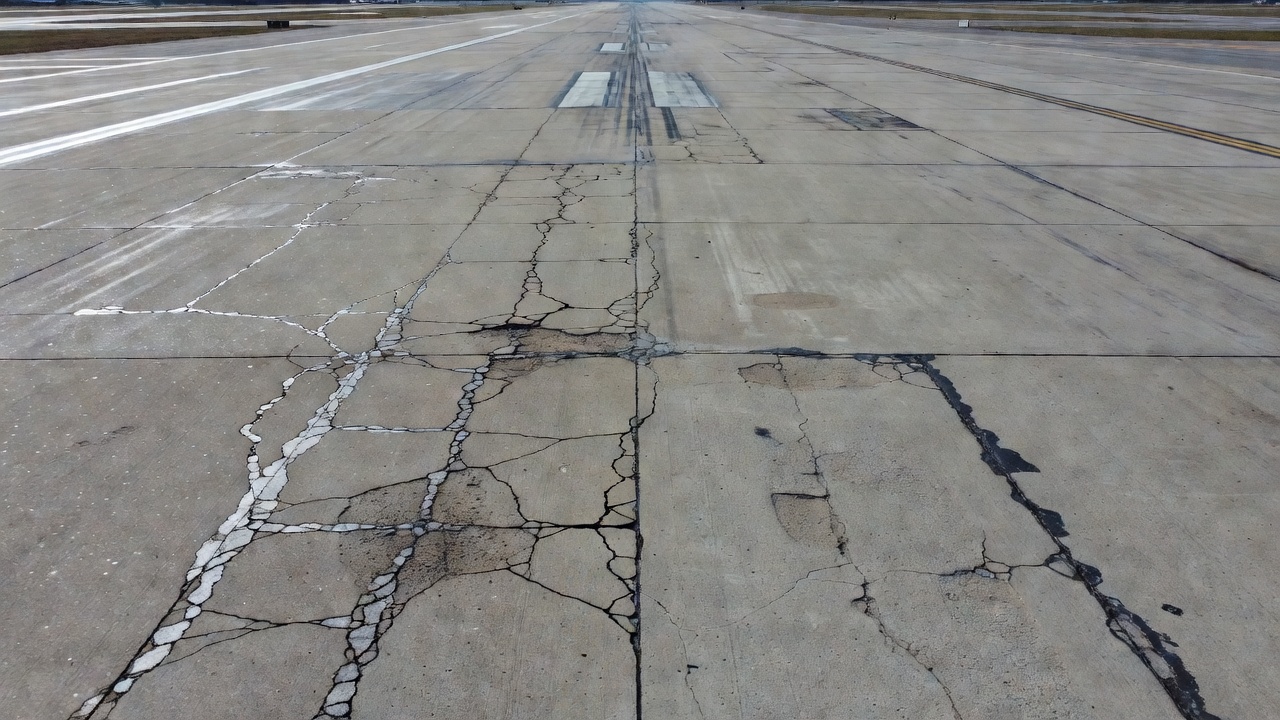
Interferencia gumových depozitov je jediná najvýzvnejšia adaptáciová issue. Letadlá deponujú gumu na dráhach počas pristávania, obzvlášť v touchdown zóne, akumulujúc ako tmavé, kontinuálne pláty na povrchu vozovky. Tieto gumové depozity môžu vizuálne imitovať alebo zakrývať trhliny. Cestno-trénovaný model detekcie trhlín, ktorý nikdy neprišiel do kontaktu s gumovými depozitmi, môže buď zlyhať detekovať trhliny pod gumovými plátmi, alebo falošne klasifikovať okraje gumových plátov ako trhliny. Adaptácia z cesty na dráhu musí preto inkorporovať modelovanie gumových depozitov, buď prostredníctvom syntetickej augmentácie tréningových dát, alebo prostredníctvom metód adaptácie domény, ktoré učia sa rozoznávať gumu od trhlín.
Rôznice v mierke a rozlíšení sú ďalšou signifikantnou bariérou adaptácie. Obrazy cestnej inšpekcie sú typicky zobrazované z zemského úrovnia na vzdialenostiach 1–5 metrov, produkujúc veľmi vysoke rozlíšenie, kde individuálne okraje trhlín spannujú desiatky pixelov. Inšpekcia dráhy používajúca UAV na 30–100m výške produkuje obrazy s hrubším rozlíšením, trhlína, ktorá spannuje 50 pixelov v cestnom obraze, môže spannovať len 5–10 pixelov v obraze dráhy z výšky. Receptívne polia extraktora vlastností a závisné od mierky filtre musia adaptovať sa na tento rôzdieľ v priestorovej frekvenčnej sadržine. Viacmierkové pyramídy vlastností a mierkovo-invariantný tréning sú esenciálne adaptáciové komponenty.
Nesúlad definície defektov vyžaduje opatrnú mapovanie medzi cestnými a dráhovými taxonomiami distressu. FHWA LTPP Distress Identification Manual definuje defekty cestnej vozovky v kategóriách, ktoré čiastočne prekryvajú defekty letiskovej vozovky definované ASTM D5340 a ICAO Doc 9137 Part 9. Niektoré typy defektov sú unikálne pre letiská: gumové depozity, erózia od jet blast, škody od paliva a degradácia trenia nemajú cestné ekvivalenty. Cestno-trénované modely preto potrebujú nové výstupové triedy pridané počas adaptácie, alebo hierarchický klasifikáciový prístup, ktorý prv detekuje generické defekty a potom klasifikuje ich do doménovo-špecifických kategórií.
Regulatívna súlada uvalá ďalšiu vrstvu vyžadovania adaptácie. Modely cestnej inšpekcie produkujú výstupy, ktoré informujú priorizáciu údržby agentúrami DOT. Modely inšpekcie dráhy musia produkovať výstupy, ktoré mapujú na ICAO- a FAA-mandované reportovacie formáty: kategórie stavu povrchu Global Reporting Format (GRF), Pavement Condition Index (PCI) per ASTM D5340 a Pavement Classification Number (PCN) ratingy. Proces adaptácie musí preto tiež adaptovať výstupovú reprezentáciu modelu na zarovnanie s regulatívnymi reportovacími normami.
Progresívne doménové preklenovanie, tréning na intermediárnych dátových množinách, ktoré postupne spannujú gap od cesty k dráhe, sa ukázalo ako efektívne. Typický preklenovací pipeline používa tri fázy: prvý, trénovať na cestných dátových množinách (CQU-BPDD, RDD2020, Crack500), druhý, adaptovať na všeobecné dátové množiny vozovky, ktoré zahŕňajú oba asfaltové a betónové povrchy, tretí, adaptovať na dráho-špecifické dátové množiny s gumovými depozitmi a letiskovými markirungami. Každá fáza redukuje distribúciový gap, ktorý nasledujúca fáza musí preklenúť, umožňujúc stabilnejšiu a efektívnejšiu adaptáciu než priamy transfer z cesty na dráhu.
Adaptácia medzi klimatickými podmienkami
Klimatické podmienky uvádzajú doménovú variáciu, ktorá je temporálna (meniaca sa v čase na jednej lokácii) a geografická (variujúca medzi lokáciami súčasne). Model nasadený na viacerých letiskách musí traktovať obe dimenzie.
Adaptácia mokrý vs suchý povrch je kritická, pretože kategórie stavu povrchu dráhy pod ICAO Global Reporting Format explicitne rozoznávajú suché, mokré, klzké mokré a kontaminované povrchy. Mokré povrchy menia viditeľnosť trhlín viacerými spôsobmi. Voda naplňujúca trhliny redukuje kontrast medzi trhlínou a okolnou vozovkou, suché trhliny vyzerajú ako vysoko-kontrastné tmavé alebo svetlé lineárne vlastnosti, ale vodou-naplnené trhliny vyzerajú ako nízko-kontrastné vlastnosti, ktoré môžu byť skoro neviditeľné pre model trénovaný na suchých povrchoch. Vodná pláta na povrchu vozovky vytvára spekulárne reflexie, ktoré uvádzajú svetlé regióny a falošné okraje, konfundujúc detektory trhlín. Mokrá vozovka tiež vyzerá tmavšia celkovo, posunujúc histogram obrazu a meniac štatistiky každej vrstvy v sieti.
Adaptácia chladnej klímy adresuje efekty zamrzania-odmrzania, ktoré menia vzhľad vozovky. Zamrznuté povrchy majú rôzne reflexívne vlastnosti než nezmrznuté povrchy. Icy pláty na vozovke vyzerajú ako hladké, vysoko-reflexívne regióny, ktoré zdieľajú vizuálne charakteristiky s defektmi povrchu vozovky. Snežná pokryvka čiastočne alebo kompletne zakryva defekty povrchu. Prechod medzi cyklami zamrzania a odmrzania produkuje unikálne vzory distressu, D-cracking, freeze-thaw spalling a frost heave, ktoré modely trénované na dátech z teplej klímy môžu nerozoznať.
Augmentácia dát pre klimatickú adaptáciu synteticky generuje cieľové doménové variácie z zdrojových obrazov domény. Pridanie simulovaných dažďových pásov, modelov mokrej reflexie povrchu, masiek snežnej pokryvky a tieňových prekryvkov môže rozširiť pokrytie zdrojovej domény na zahŕňanie klimatických podmienok neprítomných v pôvodných tréningových dátach. RandAugment politiky s špecifickými fotometrickými transformami cieliacimi jas, kontrast a farbovú teplotu sú obzvlášť efektívne pre klimatickú adaptáciu. Štúdie zobrazujú, že augmentácia-len prístupy obnovujú 50–70% výkonnosti stratenej na posuny svetla a počasia, činíc ich nákladovo-efektívnym komplementom komplexnejším adversariálnym alebo diskrepancným metódam.
CycleGAN-založený doménový preklad poskytuje alternatívu prostredníctvom učenia prekladať obrazy medzi klimatickými podmienkami. CycleGAN trénovaný na párových alebo nepárových obrazoch z suchých a mokrých dráh učí sa mapovať z suchej domény na mokrú doménu pri zachovaní lokácií a geometrií trhlín. Modely detekcie trhlín trénované na týchto augmentovaných dátach učia sa vlastnosti, ktoré sú invariantné na prítomnosť alebo absenciu vody na povrchu. Nevýhoda je tréningová komplexnosť GANov a riziko halucinovania alebo odstránenia vlastností trhlín počas prekladu.
Adaptácia medzi typmi kamer
Infrastruktúrne inšpekčné systémy používajú rôzne zobrazovacie platformy, každá s rôznymi optickými charakteristikami, ktoré uvádzajú doménový posun. Adaptácia medzi typmi kamer je esenciálna pre každý systém nasadený na viacerých letiskách, kde existujúce obrazy môžu pochádzať z rôznych zdrojov.
Rozlíšenie a Ground Sampling Distance (GSD) variujú široko. Zemská inšpekcia s 50 MP DSLR produkuje GSD 0,1–0,5 mm/pixel. UAV inšpekcia na 30 m výške produkuje 0,5–1 cm/pixel. UAV inšpekcia na 100 m výške produkuje 2–5 cm/pixel. Satelitné obrazy môžu mať 30–50 cm/pixel rozlíšenie. Trhlína, ktorá je 3 mm široká, spannuje 6–30 pixelov na zemskom úrovni, 0,3–0,6 pixelov na 30 m UAV výške, a je sub-pixel na 100 m. Modely trénované na vysoko-rozlíšných zemských obrazoch nemôžu priamo detekovať vlastnosti na hrubších rozlíšeniach. Viacrozlíšný tréning, tréning na obrazoch na viacerých mierkach rozlíšenia, je primárna stratégia. Extraktor vlastností učí sa mierkovo-invariantné reprezentácie prostredníctvom pyramidového poolingu, dilatovaných konvolúcií alebo rozlíšno-adaptívnej normalizácie.
Spektrálna senzitivita senzora rôznice medzi kamerami ovplyvňujú farbovú reprezentáciu. Rôzne CMOS a CCD senzory majú rôzne kvantové efektívne krivky cez viditeľný spektrum, čo znamená, že rovnaký povrch vyzerá s mierne rôznymi RGB hodnotami z rôznych kamer. Farbová kalibrácia používajúca farbový checker chart počas zbierania dát redukuje tento posun, ale je zriedka praktická pre veľko-mierkové inšpekčné programy. Histogramové porovnávanie a farbový preklad medzi zdrojovými a cieľovými obrazmi sú preprocessingové alternatívy. Sofistikovanejšie prístupy zahŕňajú senzorovo-invariantné učenie vlastností, ktoré explicitne odstraňuje senzorovo-špecifickú farbovú informáciu z reprezentácií vlastností prostredníctvom farbovej jitter augmentácie počas tréningu.
Distorzia objektívu variuje medzi kombináciami kamery a objektívu. Širokouhlé objektívy používané pre efektívne pokrytie dráhy uvádzajú barelovú distorziu, ktorá mení geometriu trhlín, rovné trhliny môžu vyzerať krivé blízko okrajov obrazu. Pre detekčné úlohy, táto distorzia ovplyvňuje priestorovú reláciu medzi vlastnosťami obrazu. Korekcia distorzie ako preprocessingový krok normalizuje všetky obrazy na spoločnú rektifikovanú geometriu pred podávaním modelu. Alternatívne, tréning na obrazoch so syntetickou augmentáciou distorzie činí model robustný na variujúce úrovne distorzie.
Rolling shutter efekty z UAV platforiem uvádzajú geometrickú distorziu počas letu, obzvlášť pri vysokej rýchlosti alebo veterných podmienkach. Sekvenciálna expozícia riadkov v rolling shutter CMOS senzore znamená, že pohyb kamery počas expozície produkuje šikmú alebo zkrivenú geometriu trhlín. Táto temporálna distorzia je absencná v global shutter kamerách a v zemskom statickom zobrazovaní. Adaptácia vyžaduje buď preprocessing na korekciu rolling shutter artefaktov, alebo tréning na dátach, ktoré zahŕňajú syntetickú rolling shutter degradáciu.
| Variácia kamery | Stratégia adaptácie | Implementáciová komplexnosť | Typická obnova |
|---|---|---|---|
| Rozlíšenie / GSD | Viacrozlíšný tréning + pyramidový pooling | Stredná | 5–10% obnova presnosti |
| Farbová odpoved senzora | Farbová jitter augmentácia + histogramové porovnávanie | Nízka | 3–7% obnova presnosti |
| Distorzia objektívu | Korekcia distorzie preprocessing | Nízka | 2–5% obnova presnosti |
| Rolling shutter | Syntetická rolling shutter augmentácia | Stredná | 3–6% obnova presnosti |
| Kompresiové artefakty | JPEG kompresiová augmentácia | Nízka | 1–3% obnova presnosti |
Matematické základy a kľučové formulácie
Rozumenie adaptácie domény vyžaduje znalosť niekoľkých koreňových matematických formulácií. Empirical Risk Minimization (ERM) rámec poskytuje začínací bod. Daná zdrojová doména s označenými vzorkami ({(x_i^S, y_i^S)}_{i=1}^{n_S}), štandardný model minimalizuje empirický risk:
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
kde (\ell) je úlohovo-špecifická strata funkcia (krížová entropia pre klasifikáciu, Dice strata pre segmentáciu). Adaptácia domény cieli minimalizovať cieľový risk:
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
Výzva je, že (R_T) nemôže byť priamo minimalizovaný, keď cieľové označky sú nedostupné. Metódy adaptácie domény obmedzujú cieľový risk sumou zdrojového risku a divergencnej miery medzi zdrojovými a cieľovými distribúciami.
H-divergencia poskytuje teoretickú hranicu pre adaptáciu domény (Ben-David et al., 2010). Pre hypotézovú triedu (\mathcal{H}), H-divergencia medzi zdrojovou a cieľovou distribúciou je:
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
V praxi, H-divergencia je estimovaná trénovaním klasifikátora na diskrimináciu medzi zdrojovými a cieľovými vzorkami domény, presne to, čo doménový klasifikátor v DANN robí. Teoretický výsledok garantuje, že model trénovaný na zdrojových dátach bude generalizovať na cieľovú doménu, ak H-divergencia medzi doménami je malá. To poskytuje formálnu justifikáciu pre adversariálnu adaptáciu domény.
MMD v funkcionálnej forme používa charakteristický kernel (k) na embedovanie distribúcií pravdepodobnosti v RKHS:
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
S Gaussovým kernelom (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)), kvadratická MMD môže byť vypočítaná priamo z stredných hodnôt vzoriek:
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
CORAL strata zarovnáva štatistiky druhého rádu:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
kde (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) a (C_T) je definovaný analogicky pre cieľové vlastnosti. Frobeniusova norma (|\cdot|_F) je elementová suma kvadratov.
Tieto matematické základy prekladajú sa priamo na praktickú implementáciu. Strata adaptácie domény pre Deep CORAL sieť je:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Pre DANN sieť:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{domain}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
kde (\mathbf{D} = {0, 1}) indikuje zdrojovú (0) alebo cieľovú (1) doménu, a negatívny znak reflektuje obrátenie gradientu.
| Metóda | Cieľová funkcia | Kľučové hyperparametre |
|---|---|---|
| ERM (bez adaptácie) | (\mathcal{L} = \mathcal{L}_{task}(D_S, Y_S)) | Rýchlosť učenia, weight decay |
| DANN | (\mathcal{L} = \mathcal{L}{task} - \lambda \mathcal{L}{domain}) | (\lambda) (sila adaptácie), GRL plán |
| DAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) per vrstva, kernel širina pásma (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{task} + \lambda |C_S - C_T|_F^2) | (\lambda) (váha zarovnania) |
| JAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l JMMD_l) | Páry vrstiev, kernel širiny pásma |
| Doutovanie | (\mathcal{L} = \mathcal{L}_{task}(D_T, Y_T)) redukovaná LR | Plán zamrazovania, faktor redukcie LR |
Evaluáciové protokoly pre adaptáciu domény
Evaluácia metód adaptácie domény vyžaduje štandardizované medzidátové benchmarky, ktoré merajú výkonnosť na cieľových doménach nevidných počas tréningu. Pre inšpekciu infraštruktúry, niekoľko benchmarkových protokolov bolo ustanovených.
Medzidátová evaluácia je štandardný protokol. Model je trénovaný na zdrojovej dátovej množine (napr. CQU-BPDD, ktorá obsahuje obrazy trhlín bituminoznej vozovky) a evaluovaný na cieľovej dátovej množine (napr. RDD2020, ktorá obsahuje obrazy cestných trhlín z viacerých krajín). Výkonnosť na cieľovej dátovej množine pred adaptáciou slúži ako zdrojovo-len baseline. Výkonnosť po adaptácii (s prístupom k neoznačeným cieľovým dátam pre UDA alebo obmedzeným označeným cieľovým dátam pre SDA) je meraná proti tomuto baseline. Adaptáciový zisk, rôzdieľ medzi adaptovanou a neadaptovanou výkonnosťou, kvantifikuje efektívnosť metódy adaptácie.
Spoločné benchmarky pre detekciu trhlín v vozovke zahŕňajú: CQU-BPDD (Bituminous Pavement Crack Dataset) obsahujúci 60 088 obrazov asfaltových trhlín vozovky z Číny, RDD2020 obsahujúci 26 336 obrazov cestných trhlín z Indie, Japónie a Českej republiky, Crack500 obsahujúci 500 vysoko-rozlíšných obrazov trhlín vozovky z cestných povrchov, DeepCrack obsahujúci 537 obrazov trhlín stien budov, a SDNET2018 obsahujúci 56 000 obrazov betónových mostových dek, stien a vozoviek. Medzidátová evaluácia cez tieto dátové množiny, obzvlášť z CQU-BPDD na RDD2020, reprezentujúca medzikrajový a medziklimatický transfer, je najprísnejší benchmark.
Metriky pre ocenu adaptácie domény zahŕňajú cieľová-doménová mIoU (mean Intersection over Union pre segmentáciové úlohy), cieľová-doménová F1-skóre (pre detekčné úlohy), zdrojová retencia (výkonnosť zdrojovej domény po adaptácii, na meranie katastrofického zapomínania), adaptáciový zisk (percentuálny bod zlepšenia nad zdrojovo-len baseline), a označková efektívnosť (koľko cieľových označených dát je potrebných na dosiahnutie danej úrovne výkonnosti pre řízorovné metódy).
Štatistická signifikancia testovanie je esenciálne, pretože výsledky adaptácie domény môžu byť šumové. Viaceré runy s rôznymi náhodnými semenmi (typicky 5–10) sú používané na výpočet strednej hodnoty a štandardnej deviácie metrík výkonnosti. Wilcoxon signed-rank test alebo párový t-test je používaný na determináciu, či rôznice v výkonnosti medzi metódami adaptácie sú štatisticky signifikantné na konvencionálnych prahoch ((p < 0,05)).
Pre inšpekciu infraštruktúry, dodatočné nasadenie-špecifické metriky sú relevantné: falošná pozitívna rýchlosť na operacionálnych prahoch závažnosti (detektor trhlín, ktorý generuje 100 falošných alarmov na inšpekciu dráhy je operacionálne neupotrebný bez ohľadu na jeho mIoU), inferenčný čas na jednotku plochy (adaptácia by nemala signifikantne zvýšiť čas procesovania), a pamäťová stopa (adaptérové metódy by mali pridať minimálnu skladovaciu overhead na dodatočné letisko).
Kľučové normy a referencie
Praksa adaptácie domény pre inšpekciu infraštruktúry čerpá na normách a výskume z viacerých disciplín.
Základy strojového učenia: Ganin et al., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), kanonický DANN paper uvádzajúci obrátenie gradientu. Long et al., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), uvádzajúci MMD-založené viacúrovňové doménové zarovnanie. Sun and Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), uvádzajúci kovariančné zarovnanie. Ben-David et al., “A theory of learning from different domains” (Machine Learning, 2010), teoretický rámec pre hranice generalizácie adaptácie domény.
Adaptácia domény pre inšpekciu infraštruktúry: Liu et al., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), primárna referencia pre adaptáciu domény detekcie trhlín s dvojvetvovou váho-zdieľanou architektúrou. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), viacúrovňové zarovnanie vlastností pre medzidátovú detekciu trhlín. Wang, Nguyen, Eick et al., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), trojmodulový diskrepancný rámec pre koróziu infraštruktúry.
ICAO a FAA normy: ICAO Annex 14, Aerodromes, Volume I (8. edícia, 2018 s amendementmi), primárny medzinárodný štandard pre certifikáciu aerodromov, vytvárajúci kontext doménového posunu medzi letiskami. ICAO Doc 9137, Part 9, Airport Services Manual, Airport Maintenance Practices, smernice údržby vozovky. ICAO Global Reporting Format (GRF) for Runway Surface Conditions (efektívny november 2021), definujúci domény stavu povrchu (suchá, mokrá, kontaminovaná). FAA AC 150/5380-6C, Guidelines and Procedures for Maintenance of Airport Pavements. ASTM D5340, Standard Test Method for Airport Pavement Condition Index Surveys, kvantitatívny rámec pre ocenu stavu vozovky, ktorý doménovo-adaptované modely musia podporovať.
Dátové množiny vozovky: CQU-BPDD (Chongqing University, 60 088 obrazov asfaltových trhlín vozovky). RDD2020 (8 300+ cestných obrazov z Indie, Japónie, Českej republiky). Crack500 (500 vysoko-rozlíšných obrazov trhlín vozovky). SDNET2018 (56 000 obrazov mostových dek, stien a vozoviek z Utah State University). Tieto dátové množiny poskytujú štandardizované benchmarky pre evaluáciu adaptácie domény v inšpekcii vozovky.
Často kladené otázky
- Čo je adaptácia domény v strojovom učení?
- Adaptácia domény je podoblasť prenosového učenia, ktorá rieši problém doménového posunu, kde model trénovaný na zdrojovej dátovej množine funguje slabo, keď je nasadený na cieľovej dátovej množine s rôznymi štatistickými vlastnosťami. Cieľom je naučiť sa doménovo-invariantné reprezentácie vlastností tak, aby model generalizoval medzi doménami bez potreby kompletného pretrénovania na označených cieľových dátach. Adaptácia domény je kategorizovaná na řízorovnú (obmedzené označené cieľové dáta), neriadenú (bez označených cieľových dát) a semi-řízorovnú (niektoré označené plus neoznačené cieľové dáta) varianty.
- Ako doménový posun ovplyvňuje modely detekcie trhlín v vozovke?
- Doménový posun v detekcii trhlín v vozovke spôsobuje pokles výkonnosti o 30–45% v strednej Intersection over Union (mIoU) pri prechode z jednej dátovej množiny na druhú. Zdroje posunu zahŕňajú rôznice v materiáli povrchu (asfalt vs betón), variáciu morfológie trhlín (pozdĺžne vs aligátorové trhliny), zmeny v podmienkach zobrazovania (uhol svetla, rozlíšenie, senzor kamery) a geografické faktory (rôzne typy agregátov a vzory starnutia). Napríklad, model trénovaný na dátovej množine CQU-BPDD dosahuje 0,72 mIoU na zdrojových testovacích dátach, ale padá na 0,31 pri testovaní na cieľových dátach RDD2020 bez adaptácie.
- Aký je rôzdieľ medzi prenosovým učením a adaptáciou domény?
- Prenosové učenie prispôsobuje model predtrénovaný na jednej úlohe na vykonanie rôznej úlohy, napríklad doladenie modelu klasifikácie ImageNet na detekciu trhlín. Adaptácia domény rieši rovnakú úlohu medzi rôznymi distribúciami dát, napríklad prispôsobenie asfaltového detektora trhlín na detekciu trhlín na betónových povrchoch. V prenosovom učení sa zdrojová a cieľová úloha môžu líšiť, v adaptácii domény je úloha identická, ale distribúcie vstupov sa líšia.
- Čo sú doménovo-invariantné vlastnosti?
- Doménovo-invariantné vlastnosti sú reprezentácie extrahované neurónovou sieťou, ktoré majú rovnakú štatistickú distribúciu bez ohľadu na to, z ktorej domény vstup pochádza. Ak sieť detekcie trhlín naučí sa vlastnosti, ktoré vyzerajú rovnako, či vstup je obraz asfaltovej cesty alebo betónovej dráhy, tie vlastnosti sú doménovo-invariantné. Sú naučené prostredníctvom adversariálneho tréningu (doménový diskriminátor nemôže povedať, z ktorej domény vlastnosti pochádzajú), štatistického porovnávania momentov (MMD, CORAL) alebo techník optimálneho transportu. Základným výzvom je kompromis invariancie-diskriminability: nútenie vlastností byť príliš doménovo-invariantnými môže odstrániť úlohovo-relevantnú informáciu, ako textúru trhlín, ktorá koreluje s typom povrchu.
- Ako funguje neriadená adaptácia domény?
- Neřízorovná adaptácia domény (UDA) používa označené zdrojové dáta a neoznačené cieľové dáta na trénovanie modelu, ktorý generalizuje na cieľovú doménu. Tri hlavné prístupy sú: (1) adversariálne metódy ako DANN, kde doménový diskriminátor pokúša identifikovať, z ktorej domény vlastnosti pochádzajú, zatiaľ čo extraktor vlastností pokúša ho oklamať, (2) diskrepancné metódy ako DeepCORAL a DAN, ktoré minimalizujú štatistické miery vzdialenosti (MMD, kovariančný rôzdieľ) medzi zdrojovými a cieľovými distribúciami vlastností, a (3) rekonštrukčné metódy, ktoré používajú autoenkodéry alebo GANy na učenie zdieľaných reprezentácií.
- Aké výzvy existujú pri adaptácii z cesty na inšpekciu dráhy?
- Adaptácia z cesty na dráhu čelí základným rôzdieľom v materiáli povrchu (asfalt vs vysokopevnosťový PCC betón), charakteristikách zaťaženia (10-tonové osi vozidiel vs 50–400 tonové zaťaženia letadiel), typoch defektov (gumové depozity, erózia od jet blast, škody od paliva na dráhach), prístupe inšpekcie (verejné cesty vs obmedzená airside), metódach zobrazovania (zemské vozidlá vs UAV na 30–100m výške) a regulatívnej súlade (normy ICAO Annex 14). Interferencia gumových depozitov je obzvlášť výzvou, gumová guma akumuluje sa ako tmavé pláty na dráhach, ktoré môžu imitovať alebo zakrývať trhliny, stav, s ktorým cestné modely nikdy neprichádzajú do kontaktu.
- Čo je Domain-Adversarial Neural Network (DANN)?
- Domain-Adversarial Neural Network (DANN), predstavený Ganinom a Lempitskym v 2015, je kanonická architektúra pre adversariálnu adaptáciu domény. Skladá sa z troch komponentov: extraktor vlastností, ktorý mapuje vstupy do zdieľaného priestoru vlastností, prediktor označiek, ktorý vykonáva úlohu (napr. klasifikáciu trhlín), a doménový klasifikátor, ktorý predikuje, ktorej domény vstup patrí. Vrstva obrátenia gradientu (GRL) sedí medzi extraktorom vlastností a doménovým klasifikátorom, počas backpropagácie obracia znak gradientu, čo spôsobuje, že extraktor vlastností učí sa vlastnosti, ktoré maximalizujú doménovú konfúziu. Celková strata kombinuje stratu úlohy na zdrojových označkách mínus stratu doménovej klasifikácie, váženú hyperparametrom lambda.
- Ktoré stratégie adaptácie domény pasujú rôznym množstvám cieľových dát?
- Stratégia sleduje množstvo dostupných cieľových dát. Úplné doladenie pasuje strednému množstvu označených cieľových dát, doladenie poslednej vrstvy alebo adaptérov pasuje veľmi obmedzeným označeným cieľovým dátam, a neriadená adaptácia používajúca štatistiky batch normalizácie a zarovnanie vlastností sa používa, keď neexistujú žiadne cieľové označky. Progresívne odmrazovanie a augmentácia prispôsobená cieľovým podmienkam zobrazovania pomáhajú adaptovanému modelu zachovať to, čo sa naučil z zdrojovej domény.
- Čo je Maximum Mean Discrepancy (MMD)?
- Maximum Mean Discrepancy (MMD) je kernelový štatistický test používaný na meranie vzdialenosti medzi dvoma distribúciami pravdepodobnosti v Reproducing Kernel Hilbert Space (RKHS). V adaptácii domény, MMD sa používa ako strata funkcia na minimalizáciu distribúciového gapu medzi zdrojovými a cieľovými reprezentáciami vlastností. Vzorec MMD vypočíta normu rôzdieľu medzi strednými embeddinkami zdrojových a cieľových vlastností v RKHS. Deep Adaptation Networks (DAN) a Joint Adaptation Networks (JAN) inkorporujú MMD stratu na viacerých vrstvách siete, aby dosiahli viacúrovňové doménové zarovnanie.
- Ktoré normy ICAO sú relevantné pre adaptáciu domény pre inšpekciu dráhy?
- ICAO Annex 14 ustanovuje normy pre dizajn a operácie aerodromov, ktoré vytvárajú prírodnú potrebu adaptácie domény: rôzne letiská majú rôzne materiály vozovky, klímy a histórie údržby, takže inšpekčné modely musia adaptovať sa medzi letiskami. Global Reporting Format (GRF) definuje kategórie stavu povrchu dráhy (suchá, mokrá, klzká mokrá, kontaminovaná), ktoré reprezentujú odlišné vizuálne domény. ICAO Doc 9137 Part 9 a FAA AC 150/5380-6C poskytujú smernice údržby. Pri nasadení AI-založenej inšpekcie medzi letiskami, adaptácia domény je esenciálna, pretože model trénovaný na dátach z jedného letiska bude čeliť rôznemu svetlu, veku vozovky a morfológiám defektov na druhom.
Toto je referenčný záznam. TarmacView poskytuje služby dronovej inšpekcie a nepredáva vybavenie ani materiály opísané v tomto slovníku.