Mi az a DINOv3 Vision Transformer?
DINOv3 Vision Transformer az Infrastruktúra-felület Elemzéshez
Önfelügyelt Tanulás és DINO
Az önfelügyelt tanulás (SSL) a gépi tanulás egy olyan paradigmája, ahol a modell értelmes reprezentációkat tanul címkézetlen adatokból egy olyan előfeladat meghatározásával, amely nem igényel emberi annotációt. A modellnek az adatok egy részét más részekből kell megjósolnia, kihasználva az adatokon belüli belső szerkezetet és együttes előfordulási mintákat. A számítógépes látásban az SSL módszerek a kézzel készített előfeladatoktól, mint például a kép elforgatási szögének előrejelzése (RotNet), a megkevert foltok kirakós játékának megoldása vagy a szürkeárnyalatos képek kiszínezése, a kifinomultabb kontrasztív és desztillációs alapú megközelítések felé haladtak. Az SSL alapvető előnye, hogy lehetővé teszi a webes méretű adathalmazokon való képzést a kézi annotáció tiltó költsége nélkül. Infrastruktúra alkalmazásokhoz, ahol a címkézett hibadatkészletek ritkák és drágák előállítani (tanúsított ellenőrök és mérnökök szükségesek), az SSL-alapú gerincek lehetővé teszik a hatékony jellemzőtanulást hatalmas mennyiségű címkézetlen képből, mielőtt bármilyen feladatspecifikus finomhangolásra sor kerülne.
A TarmacView útburkolat felmérése aktív fejlesztés alatt áll, és még nem elérhető.
A kontrasztív tanulás módszerei, mint a SimCLR, MoCo és SwAV, reprezentációkat tanulnak azáltal, hogy ugyanazon kép nagyított nézeteit (pozitív párok) összehúzzák a beágyazási térben, miközben a különböző képek nézeteit (negatív párok) széttolják. Ezek a módszerek gondos kezelést igényelnek a negatív minták tekintetében – túl kevés negatív rontja a teljesítményt, túl sok növeli a számítási költséget. A nem kontrasztív módszerek, mint a BYOL, SimSiam és DINO, teljesen elkerülik a negatív párok szükségességét aszimmetrikus hálózati architektúrák és stop-gradiens műveletek használatával a reprezentációs összeomlás megelőzésére. A DINO (ön-desztilláció címkék nélkül), amelyet Caron és munkatársai mutattak be a Meta AI-nál 2021-ben, ebbe a nem kontrasztív családba tartozik, és a számítógépes látás egyik legbefolyásosabb SSL módszerévé vált. Az eredeti DINO cikk bemutatta, hogy az SSL-nek és a Vision Transformer-eknek egyedi szinergiája van – a ViT-k önfigyelmi mechanizmusai természetesen hoznak létre szemantikus szegmentációs térképeket bármilyen felügyelet nélkül, ez a tulajdonság a többterméses nagyítási stratégia és az ön-desztillációs cél kölcsönhatásából ered.
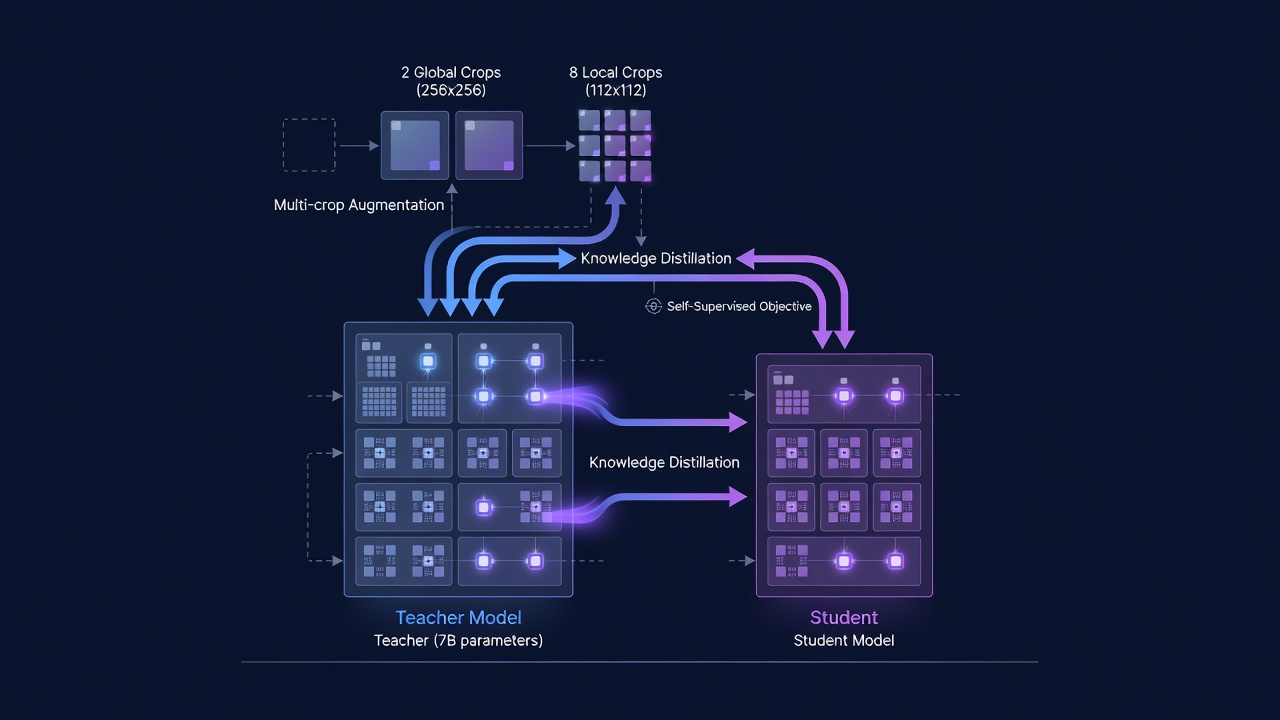
A DINO képzési keretrendszer a következőképpen működik. Minden bemeneti képhez két globális nézet (amely a képterület több mint 50%-át fedi le, jellemzően 224x224 pixel) és több helyi nézet (kisebb termések, amelyek a képterület kevesebb mint 50%-át fedik le, jellemzően 96x96 pixel) jön létre véletlenszerű átméretezett vágással, szín vibrálással és Gauss-elmosással. Az összes nézetet átvezetik egy diák hálózaton (egy Vision Transformer). A globális nézeteket egy tanár hálózaton is átvezetik, amely ugyanazzal az architektúrával rendelkezik, mint a diák, de eltérő paraméterekkel. A tanár paraméterei nem gradienseken keresztül tanulnak – ehelyett a diák paramétereinek exponenciális mozgóátlagaként (EMA) frissülnek. A képzés alapvető célja, hogy a diák kimeneti eloszlása megegyezzen a tanár kimeneti eloszlásával a globális nézetek esetében, míg a helyi nézetek további képzési jelet biztosítanak csak a diák számára. Ez a tanár-diák felállás, amelyet ön-desztillációnak neveznek, olyan tanulási jelet hoz létre, amely nem igényel címkéket – a diák megtanul konzisztens reprezentációkat előállítani ugyanazon kép különböző nagyításaihoz, ami arra kényszeríti, hogy a felületes pixelszintű részletek helyett a változatlan szemantikai tartalmat rögzítse.
A DINOv1 (2021) három kulcsfontosságú emergens tulajdonságot mutatott be az önfelügyelt ViT-k esetében. Először is, a [CLS] token figyelmi térképei a képfoltokhoz természetesen szegmentálják az objektumokat a háttértől – ez a tulajdonság pusztán az önfelügyeletből ered, bármilyen szegmentációs címke nélkül. Másodszor, a tanult jellemzők kiváló k-NN osztályozási teljesítményt mutatnak – egy egyszerű legközelebbi szomszéd osztályozó a DINO jellemzőtérben 78,2%-os top-1 pontosságot ér el az ImageNet-en bármilyen finomhangolás nélkül. Harmadszor, a DINO jellemzők erős szemantikus megfelelést mutatnak ugyanazon objektumosztály különböző példányai között, lehetővé téve alkalmazásokat a kép-visszakeresésben, a ko-szegmentációban és a videó objektum szegmentációban. Ezek a tulajdonságok tették a DINO-t alapvető módszerré az önfelügyelt tanulás területén, és előkészítették a terepet a DINOv2 (2023) és a DINOv3 (2025) számára.
ViT Architektúra
A Vision Transformer (ViT) architektúrát, amelyet Dosovitskiy és munkatársai mutattak be a Google-nál 2021-ben, a Transformer architektúrát adaptálja a természetes nyelvi feldolgozásból a számítógépes látásba azáltal, hogy a képfoltokat szó tokenek analógjaiként kezeli. Ellentétben a konvolúciós neurális hálózatokkal (CNN), amelyek a képeket lokális receptív mezőkön keresztül dolgozzák fel beépített transzlációs ekvivarianciával, a ViT-k globális önfigyelmet alkalmaznak az összes folton egyidejűleg, lehetővé téve a modell számára, hogy az első rétegtől kezdve hosszú távú függőségeket rögzítsen. Ez az architekturális választás bizonyult döntő fontosságúnak a DINO sikerében – az eredeti DINO cikk megmutatta, hogy az önfelügyelt ViT-k jelentősen felülmúlják az önfelügyelt CNN-eket, és hogy az önfigyelem és az ön-desztilláció közötti szinergia felelős az emergens szemantikus szegmentációs tulajdonságokért.
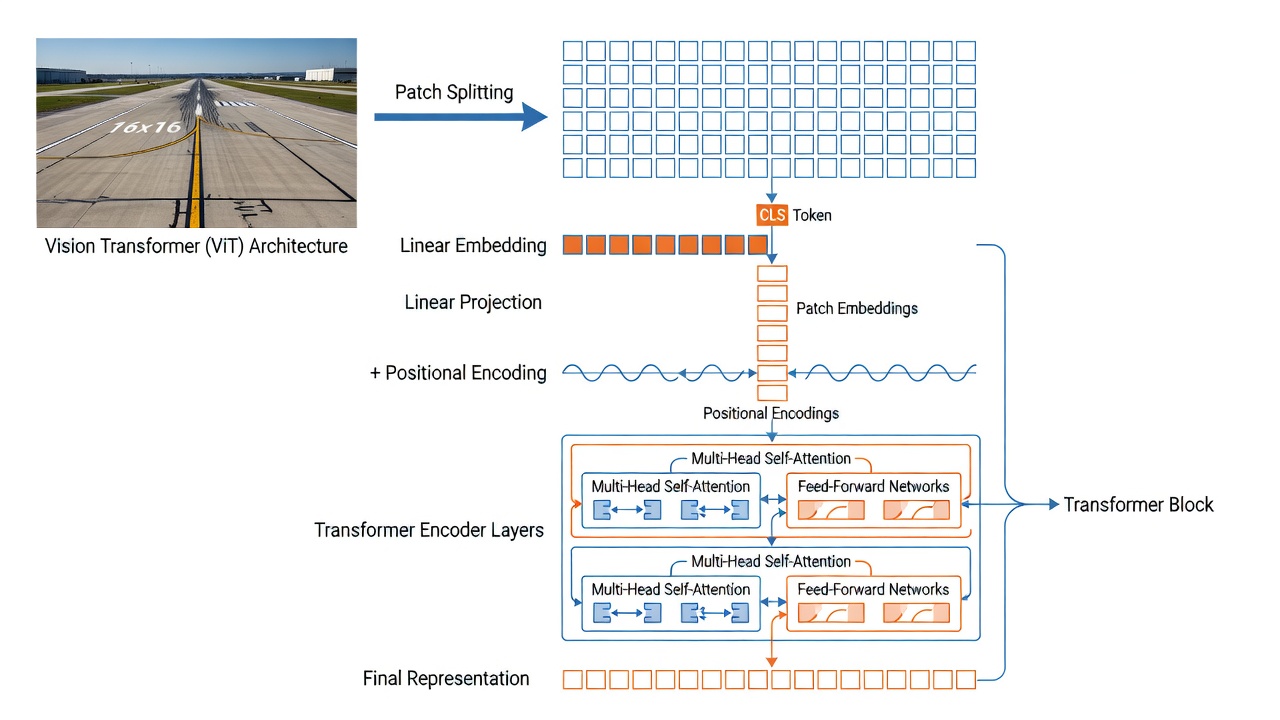
Folt Beágyazás. A ViT első művelete a bemeneti kép felosztása egy átfedés nélküli foltokból álló rácsra. A ViT-B/16 változat esetében a foltméret 16x16 pixel. Egy 224x224 pixeles bemeneti kép (224/16) x (224/16) = 14 x 14 = 196 foltot eredményez. Minden 16x16x3 (RGB csatornák) foltot egy 768 hosszúságú vektorba lapítanak (16x16x3). A gyakorlatban ezt a folt beágyazást egyetlen konvolúciós rétegként valósítják meg, amelynek kernel mérete megegyezik a foltmérettel (16x16), és lépésköze megegyezik a foltmérettel, így egy 14x14-es jellemzővektor rácsot hoz létre, amelyek mindegyikének dimenziója megegyezik a modell rejtett méretével (768 a ViT-B esetében). Egy tanulható lineáris vetítés ezután leképezi az egyes lapított foltokat a beágyazási dimenzióra. A Conv2d implementáció számítási szempontból hatékony (egy művelet helyettesíti a 196 különálló lineáris vetítést), és ez a szabvány minden modern ViT implementációban.
A [CLS] Token. A BERT architektúrát követve az NLP-ben, egy speciális tanulható osztályozási token ([CLS]) kerül a folt beágyazások sorozata elé. A [CLS] token ugyanolyan dimenziójú (768), mint a folt beágyazások, és véletlenszerűen inicializálják. A képzés során, az összes transzformer rétegen átívelő önfigyelem révén, a [CLS] token információkat gyűjt az összes képfoltból – minden rétegben minden foltra figyelhet, így a teljes kép globális reprezentációját építi fel. Az utolsó transzformer réteg kimenetén a [CLS] token beágyazás szolgál a képszintű reprezentációként, amelyet osztályozási feladatokhoz használnak. A DINOv3-ban a [CLS] tokent 4 regiszter token egészíti ki – további tanulható tokenek, amelyeket a sorozat elé helyeznek, és amelyek vázlatmemóriaként működnek a kiugró vagy háttérinformációk elnyelésére, megakadályozva, hogy a [CLS] és folt tokeneket irreleváns nagyfrekvenciás részletek rontsák el.
Pozíciós Beágyazások. Mivel a Transformer önfigyelmi mechanizmusa permutáció-invariáns (a foltokat halmazként dolgozza fel, nem sorozatként), a pozíciós információkat explicit módon kell hozzáadni, hogy a modell tudja, hová tartozik az egyes foltok a térbeli rácsban. A DINOv3 Rotary Position Embeddings (RoPE) alkalmaz a DINOv2-ben használt szabványos tanulható abszolút pozíciós kódolások helyett. A RoPE relatív pozíció információt kódol egy rotációs mátrix alkalmazásával a lekérdezési és kulcsvektorokra az önfigyelemben a térbeli koordinátáik alapján. Az egyes dimenziók rotációs frekvenciáját a dimenzió indexe határozza meg, egy geometriai progressziót követve. A RoPE kulcsfontosságú előnye az infrastruktúra elemzés szempontjából a változó felbontású bemenetek kezelésének képessége – nagy felbontású képek (akár 4096x4096 pixel) feldolgozásakor a RoPE mechanizmus természetesen általánosít a nagyobb térbeli rácsra anélkül, hogy a tanult pozíciós beágyazások interpolációját igényelné. A DINOv3 véletlenszerű doboz zajt is bevezet a RoPE alkalmazása során, ahol a pozíció indexeket véletlenszerűen eltolják egy [-s,s] tartományon belül, ahol s [0.5,2.0] között van, így a modell ellenállóvá válik a különböző képarányokkal és vágási mintákkal szemben.
Többszálú Önfigyelem (MHSA). A ViT alapvető számítási primitívje a többszálú önfigyelmi mechanizmus. Minden transzformer blokkban a bemeneti N token sorozatot (N = 1 [CLS] + 4 regiszter + 196 folt = 201 token egy 224x224-es bemenethez) lineárisan három mátrixba vetítik: Lekérdezések (Q) , Kulcsok (K) és Értékek (V) , amelyek mindegyikének dimenziója 768 a ViT-B/16 esetében. Az figyelmi mechanizmus kiszámítja az összes token közötti páronkénti hasonlóságot a Q és K^T pontszorzataként, skálázva d_k négyzetgyökével (ahol d_k a kulcs dimenziója szálenként). Az eredményül kapott figyelmi súlyok (softmax által normalizálva) határozzák meg, hogy az egyes tokenek mennyiben járulnak hozzá minden más token reprezentációjához. A ViT-B/16-ban 12 figyelmi szál van, amelyek mindegyike egy 64 dimenziós altérben működik (768/12 = 64). A többszálú figyelem lehetővé teszi a modell számára, hogy egyidejűleg különböző típusú kapcsolatokra figyeljen – például az egyik szál a foltok közötti textúra hasonlóságra összpontosíthat, egy másik a térbeli közelségre, egy harmadik pedig a szemantikus kategória tagságra. Az összes szál kimenetét összefűzik, és lineárisan visszavetítik 768 dimenzióra. Az MHSA számítási komplexitása O(N2d) – négyzetes az N sorozathosszban, de lineáris a d beágyazási dimenzióban. A DINOv3 ViT-B/16 201 tokenből álló sorozatához ez kezelhető (körülbelül 40K figyelmi számítás rétegenként), de nagy felbontású képeknél 4000+ token esetén (pl. egy 1024x1024-es kép 64x64 = 4096 foltot eredményez) a négyzetes skálázás jelentős szemponttá válik.
Transzformer Kódoló Blokk. A DINOv3 mind a 12 (ViT-B) vagy 40 (ViT-7B) transzformer rétege az elő-normalizációs kialakítást követi. A Réteg Normalizációt (LayerNorm) az MHSA és az MLP alrétegek előtt is alkalmazzák, reziduális kapcsolatokkal, amelyek megkerülik az egyes alrétegeket. Az MLP (többrétegű perceptron) alréteg két lineáris rétegből áll, közöttük egy GELU (Gaussian Error Linear Unit) aktivációval. A ViT-B/16 esetében az MLP rejtett dimenziója 3072 (4-szerese a beágyazási dimenziónak), ami a következő konfigurációt eredményezi: Beágyazási dimenzió 768 -> MLP rejtett 3072 -> GELU -> MLP kimenet 768. A DINOv3 nagyobb tanár modellje (ViT-7B) SwiGLU (Swish-Gated Linear Unit) aktivációt használ az MLP-ben a GELU helyett, követve a modern LLM architektúra trendeket. A SwiGLU egy kapuzási mechanizmust alkalmaz: kimenet = (xW1) elemenként szorozva Swish(xW2) szorozva W3. Ez a kapuzott aktiváció javítja a képzés stabilitását és a végső teljesítményt nagy méretekben. Az elő-normalizációs kialakítás eltér az eredeti Transformer utó-normalizációjától (ahol a normalizációt a reziduális összeadás után alkalmazták), és stabilabb képzést eredményez, különösen mély (12+ rétegű) transzformerek esetében.
Architektúra Összefoglaló Táblázat a DINOv3 Modellcsaládhoz.
| Modell | Paraméterek | Beágyazási Dimenzió | Szálak | Rétegek | MLP Dimenzió | Folt Méret | Foltok/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1.5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
A ViT-Base (86M paraméter) architektúra az optimális kompromisszum a jellemzőminőség és a számítási hatékonyság között az infrastruktúra-ellenőrzési csővezetékek számára, 768 dimenziós beágyazásokat kínálva 12 rétegnyi önfigyelmi feldolgozási teljesítménnyel.
DINOv3 Képzés 1,7 Milliárd Képen
A DINOv3 a legmodernebb teljesítményét az önfelügyelt képzés példátlan méretarányán keresztül éri el, kihasználva mind a hatalmas adatkurálást, mind a hatékony elosztott optimalizálást több száz GPU-n.
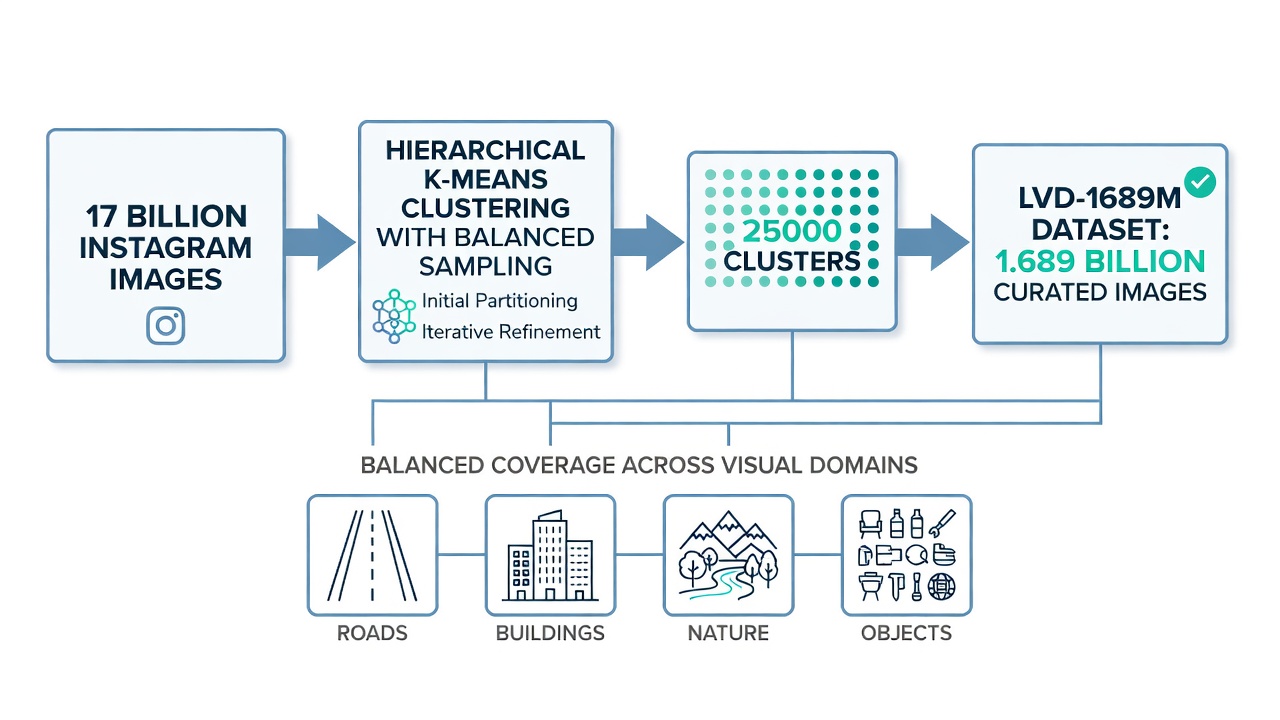
Az LVD-1689M Adathalmaz. A DINOv3 képzési adatai egy 17 milliárd tartalommal moderált Instagram képből álló nyers készlettel kezdődnek. Ebből a hatalmas készletből a Meta AI csapata egy kiegyensúlyozott részhalmazt kurált 1,689 millió képből, amelyet LVD-1689M-nek (Large Visual Dataset 1689 Million) neveztek el. A kurálási csővezeték kritikus fontosságú, mert a nyers Instagram adatokon való egyszerű képzés olyan modellt eredményezne, amely torzít a közösségi médiában előforduló vizuális koncepciók természetes gyakorisági eloszlása felé – például az arcok, ételek és tájak dominálnának, míg az infrastruktúra, ipari és tudományos képek alulreprezentáltak lennének. A kurálási folyamat hierarchikus k-közép klaszterezést alkalmaz a teljes képkészletből kinyert DINOv2 beágyazásokon. A DINOv2 ViT-H/14 modell feldolgozza az egyes képeket, és az eredményül kapott CLS token beágyazásokat 25 000 klaszterbe klaszterezi k-közép segítségével. Ezt követően minden klaszterből azonos számú képet mintavételeznek, így egy klaszter-kiegyensúlyozott adathalmazt hozva létre, amely arányos reprezentációt biztosít a vizuális tartományok között. Ez a kiegyensúlyozott mintavételezés közvetlenül analóg a statisztikában használt rétegzett mintavételezéssel – a klasztertagság szabályozásával az adathalmaz a vizuális koncepciók teljes sokféleségét rögzíti ahelyett, hogy a gyakori kategóriákat túlreprezentálná. A klaszterezés után egy további visszakeresési lépés kibővíti a kurált adathalmazokból (ImageNet-1k, ImageNet-22k, Google Landmarks és finom részletességű osztályozási adathalmazok) származó magkészleteket a DINOv2 beágyazási térben lévő legközelebbi szomszédok megtalálásával. A végső LVD-1689M adathalmaz 1,489 millió klaszter-kiegyensúlyozott képet és 200 millió visszakereséssel bővített képet egyesít, amelyek mindegyikét NSFW detektáláson, PCA hash deduplikáción és arc elmosáson szűrik át.
Képzési Konfiguráció. A ViT-7B tanár modellt, a valaha képzett legnagyobb önfelügyelt látásmodellt (2025-ös állapot szerint), 256 NVIDIA GPU-n (A100 80GB SXM4) tanították 4096-os kötegmérettel (16 kép GPU-nként). Az optimalizálás az AdamW optimalizálót használja 4x10^-4 konstans tanulási sebességgel, 0,04-es súlycsökkenéssel és 0,999-es EMA lendülettel, egy 100 000 lépéses bemelegítési időszakot követően. A képzés 1 millió iteráción keresztül tart a többterméses stratégiával: 2 globális termés 256x256-os felbontáson és 8 helyi termés 112x112-es felbontáson, összesen 10 nézetet képezve iterációnként. 1 millió iteráció alatt 4096-os kötegméret mellett a modell körülbelül 2,56 milliárd egyedi kép-termés kombinációt lát. A teljes képzési folyamat becslések szerint 10 000-15 000 GPU-napnyi számítást fogyaszt. A képzés során a kötegek 10%-a homogén kivonat az ImageNet-1k-ból (a szabványos benchmarkokon nyújtott teljesítmény fenntartása érdekében), míg 90%-a heterogén kivonat a teljes LVD-1689M készletből, ami egy ablációval igazolt optimális keverési arány.
Képzési Célok. A DINOv3 előképzési vesztesége három komponenst egyesít. A DINO veszteség (L_DINO) egy SwAV-stílusú Sinkhorn-Knopp klaszterezést alkalmaz a globális termések [CLS] token kimeneteire, illesztve a prototípus-hozzárendeléseket a diák és a tanár között. A Sinkhorn algoritmus 3 iterációt futtat a lágy pszeudocímkék előállításához. Az iBOT veszteség (L_iBOT) a folt szintjén működik – a helyi termésekben lévő véletlenszerű foltokat maszkolják, és a diáknak meg kell jósolnia a tanár normalizált folt jellemzőit ezekre a maszkolt pozíciókra. Ez a maszkolt kép modellezési cél arra kényszeríti a modellt, hogy megtanulja a helyi textúra és szerkezet információkat, amelyek szükségesek a sűrű előrejelzési feladatokhoz. A Koleo regularizáló (L_Koleo) egyenletesen szórja szét a [CLS] token beágyazásokat a hipergömbön azáltal, hogy minimalizálja a kötegben lévő összes beágyazáspár közötti koszinusz hasonlóságok összegét, megakadályozva a reprezentációs összeomlást és biztosítva a jellemzőtér jó kihasználtságát. A kombinált előképzési veszteség: L_Pre = L_DINO + L_iBOT + 0,1 x L_Koleo. 1 millió iterációs előképzés után egy 200 ezer további iterációból álló finomítási fázis beépíti a Gram rögzítési veszteséget (L_Gram) 2-es súllyal, amely megőrzi a sűrű jellemzők minőségét a hosszú képzés során.
Desztilláció Kisebb Modellekbe. Miután a ViT-7B tanár teljesen betanult, befagyasztják, és célként használják a reprezentációk desztillálására kisebb, praktikusabb modellek sorozatába. A desztillációs folyamat tükrözi az előképzési beállítást: a diák modelleket (ViT-S, ViT-B, ViT-L, ViT-H+, ConvNeXt változatok) arra tanítják, hogy illeszkedjenek a tanár kimeneti jellemzőihez ugyanazt a veszteségfüggvényt (L_DINO + L_iBOT + 0,1 x L_Koleo) használva, de a tanár befagyasztva és az EMA tanár frissítés elhagyva. A Meta AI egy többdiákos desztillációs beállítást valósít meg, amely hatékonyan tanít több diák modellt egyidejűleg – a tanár minden képet egyszer dolgoz fel, és az összes diák ugyanazokat a tanár kimeneteket kapja, lehetővé téve a köteg veszteségszámítás párhuzamosítását a diákok között. Ez körülbelül 60%-kal csökkenti a teljes modellcsalád előállításának teljes számítási költségét az egyes diákok szekvenciális desztillálásához képest. A ViT-Base (86M paraméter) diák eléri a ViT-7B tanár lineáris szonda pontosságának 98,7%-át az ImageNet-1k-n, miközben körülbelül 80-szor kevesebb FLOP-ot igényel a következtetéshez.
768 Dimenziós Beágyazások
A DINOv3 ViT-B/16 által minden tokenre (1 CLS + 4 regiszter + 196 folt = 201 összesen) előállított 768 dimenziós beágyazás a vizuális információ sűrű numerikus kódolását képviseli egy magas dimenziós vektortérben. Minden dimenzió egy adott vizuális koncepciót vagy jellemzőt rögzít, és mind a 768 érték kombinációja egyedi aláírást képez ehhez a képterülethez. A 768-as dimenzió nem önkényes – a ViT-Base architektúrából ered, ahol a rejtett dimenzió 768-ra van állítva, elegendő kapacitást biztosítva az összetett vizuális minták kódolásához, miközben számításilag kezelhető marad. Összehasonlításképpen, a ViT-Small 384 dimenziót, a ViT-Large 1024-et, a ViT-7B pedig 4096-ot használ.
CLS Token Beágyazás. A [CLS] token 768 dimenziós beágyazása a 12. transzformer réteg kimenetén a globális kép tartalmát kódolja – a teljes jelenetet, domináns objektumokat és szemantikus kontextust. Ezt a beágyazást kinyerik és képszintű osztályozási feladatokhoz használják. Egy tipikus csővezetékben a CLS beágyazást egy könnyű lineáris osztályozón (768-tól N osztályig, ahol N a felülettípusok vagy minőségi fokozatok száma) vezetik át, amelyet címkézett infrastruktúra adathalmazokon tanítanak. A DINOv3 CLS beágyazása erős tartomány-általánosítási tulajdonságokat mutat – az ezen a beágyazáson tanított modellek jelentősen jobban általánosítanak a nem látott infrastruktúra típusokra, mint a felügyelt gerincekből származó beágyazások. A DINOv3 ViT-B/16 lineáris szonda pontossága az ImageNet-1k-n eléri a 85,1%-os top-1 pontosságot, felülmúlva a DINOv2-t (83,5%) és megközelítve a felügyelt ViT-et (86,0%), annak ellenére, hogy soha nem látott semmilyen ImageNet címkét az előképzés során.
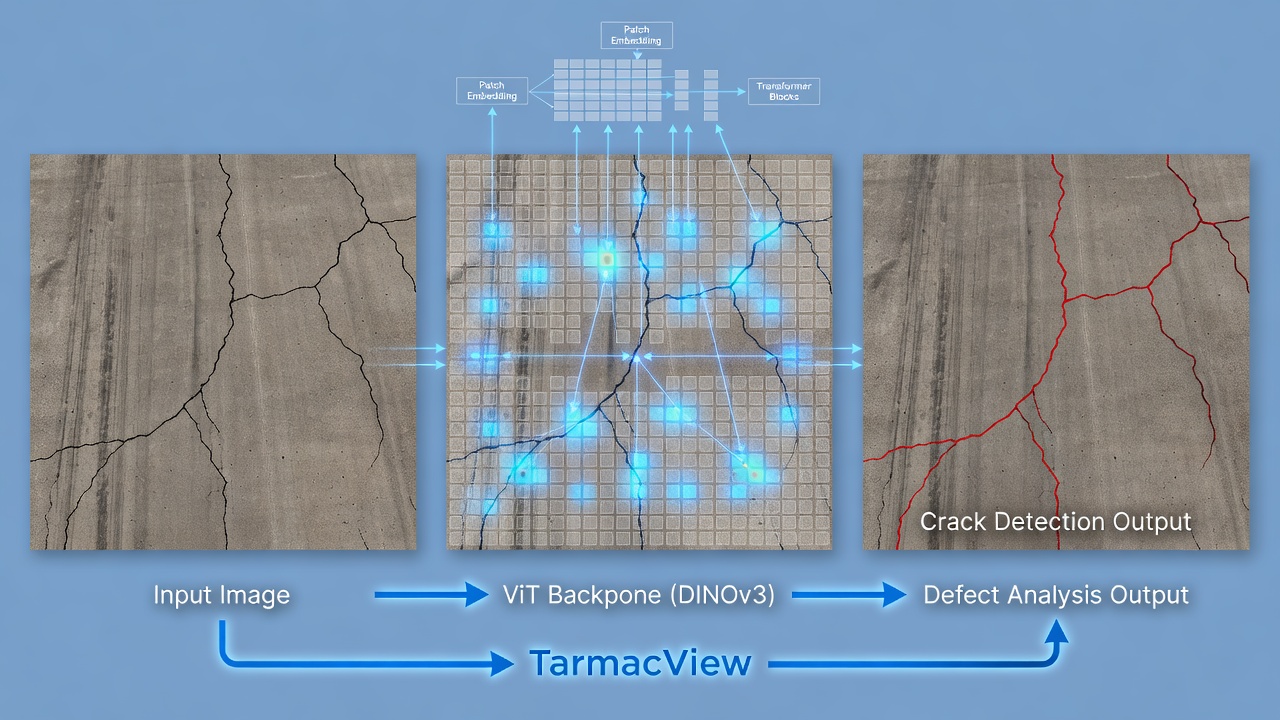
Folt Token Beágyazások. A 196 folt token mindegyike külön 768 dimenziós beágyazást hoz létre, egy 14x14-es térbeli jellemzővektor rácsot alkotva. Ezek a sűrű beágyazások lokalizált vizuális információkat kódolnak az egyes 16x16 pixeles foltokon belül – textúrát, éleket, színeloszlást és helyi mintákat. A folt beágyazások a kritikus kimenetek a sűrű előrejelzési feladatokhoz, mint a repedésdetektálás és szegmentáció. Egy infrastruktúra elemzési csővezetékben a 14x14 x 768 dimenziós jellemzőrácsot (körülbelül 1,5 millió lebegőpontos érték képenként) egy könnyű konvolúciós dekóderen keresztül dolgozzák fel, amely 224x224-re nagyít fel, és pixelenkénti előrejelzéseket hoz létre. Minden folt beágyazás értelmezhető úgy, mint egy 768 dimenziós leírása annak, hogy néz ki az a 16x16-os régió – két hasonló vizuális megjelenésű folt (pl. sima aszfalt két területe) közeli beágyazásokkal rendelkezik a 768 dimenziós térben (magas koszinusz hasonlóság), míg a vizuálisan eltérő foltok (pl. aszfalt vs. beton) távoli beágyazásokkal rendelkeznek (alacsony koszinusz hasonlóság).
Beágyazási Tulajdonságok. A DINOv3 beágyazások számos olyan tulajdonsággal rendelkeznek, amelyek kivételessé teszik őket az infrastruktúra elemzéshez. Először is, szemantikus simaság – a vizuálisan hasonló régiók közeli beágyazásokat hoznak létre, egy folytonos sokaságot alkotva a 768 dimenziós térben. Ez azt jelenti, hogy a különböző szélességű, tájolású és súlyosságú repedések mind a beágyazási tér egy összefüggő régiójába képeződnek le, így koherens osztályként detektálhatók, nem pedig elszigetelt kiugró értékekként. Másodszor, többszintű érzékenység – a 12 transzformer rétegben lévő önfigyelmi mechanizmus információkat integrál a különböző térbeli skálákról, így minden folt beágyazást nemcsak a saját 16x16-os tartalma, hanem a környező foltok és a globális jelenet tágabb kontextusa is befolyásol. Egy dilatációs hézag közelében lévő repedés másképp van kódolva, mint ugyanaz a repedés a panel közepén, mert a kontextuális információ beépül a beágyazásba. Harmadszor, megvilágítással szembeni robusztusság – az önfelügyelt képzés kiterjedt szín vibrálással és nagyítással biztosítja, hogy a beágyazások stabilak legyenek változó fényviszonyok, árnyék és expozíció mellett. Ez kritikus a kültéri infrastruktúra-ellenőrzésnél, ahol a képeket nem szabályozott természetes megvilágítás mellett rögzítik. Negyedszer, lineáris szétválaszthatóság – a beágyazások úgy vannak strukturálva, hogy az egyszerű lineáris osztályozók hatékonyan el tudják választani a különböző felületi állapotokat. A befagyasztott DINOv3 beágyazásokon végzett lineáris szondák gyakori könnyű alapvonalat jelentenek a felület típusának osztályozásához és a repedésdetektáláshoz.
Távolságmetrikák a Beágyazási Térben. A DINOv3 beágyazások összehasonlítására használt távolságmetrika megválasztása jelentősen befolyásolja a downstream feladat teljesítményét. A koszinusz hasonlóság a leggyakrabban használt metrika, amelyet a következőképpen definiálnak: cos(theta) = (a dot b) / (||a|| x ||b||), ahol a és b 768 dimenziós beágyazási vektorok. A koszinusz hasonlóság -1 (ellentétes irány, nem valószínű vizuális beágyazások esetén) és +1 (azonos irány) között mozog. Két 768 dimenziós vektor, amelyek koszinusz hasonlósága nagyobb, mint 0,9, vizuálisan majdnem azonos a helyi tartalmukban, míg a 0,5-nél kisebb hasonlóság lényegesen eltérő vizuális tartalmat jelez. Az L2 (euklideszi) távolság is használatos, de gondos normalizálást igényel, mert a beágyazások abszolút skálája változhat. A pontszorzat hasonlóság hatékony, de érzékeny a vektor nagyságára. A koszinusz hasonlóság a szokásos elsődleges távolságmetrika a hibavisszakereséshez és illesztéshez, mert normalizálja a beágyazás nagyságát, és kizárólag az iránybeli igazításra összpontosít, ami robusztusabb a kép kontrasztjának és expozíciójának változásaival szemben.
Dimenziócsökkentés Vizualizációhoz. A 768 dimenziós beágyazási tér nem vizualizálható közvetlenül, ezért a Főkomponens Analízist (PCA) gyakran alkalmazzák a folt beágyazások 3 dimenzióra csökkentésére vizualizációs és minőségbiztosítási célokra. A DINOv3 folt beágyazások első három főkomponense infrastruktúra képeken jellemzően a teljes variancia 45-55%-át rögzíti (PC1 körülbelül 25%, PC2 körülbelül 15%, PC3 körülbelül 10%), jelezve, hogy a felületi foltok effektív belső dimenziója sokkal alacsonyabb, mint 768. A PCA vizualizáció következetesen különálló klasztereket mutat a különböző felületi anyagokhoz (aszfalt, beton, zúzottkő záróréteg, kavics) és folytonos gradienseket a felületi romlás súlyosságához (az érintetlentől a súlyosan repedezettig). Ez a vizuális megerősíthetőség kritikus minőségbiztosítási eszköz – az infrastruktúra mérnökök vizuálisan ellenőrizhetik a beágyazási teret, hogy megbizonyosodjanak arról, hogy a modell helyesen választja el a releváns felületi állapotokat, mielőtt az automatizált osztályozásra hagyatkoznának.
DINOv3 vs DINOv2
A DINOv2-ről a DINOv3-ra való fejlődés az önfelügyelt látás képzési paradigma átfogó skálázását és finomítását képviseli. A különbségek megértése elengedhetetlen a gyakorlati szakemberek számára, akik a megfelelő gerincet választják ki alkalmazásukhoz.
A Képzési Adatok Mérete. A legszembetűnőbb különbség a képzési adatok 12-szeres növekedése: a DINOv2 LVD-142M (142 millió kép) szemben a DINOv3 LVD-1689M (1,689 milliárd kép) adatkészletével. A kurálási módszertan azonban szintén javult. A DINOv2 egy visszakeresés-alapú csővezetéket használt, amely kibővítette a kurált mag adathalmazokat az ImageNet-22k-n előtanított ViT-H/16 beágyazási terében lévő legközelebbi szomszédok megtalálásával. A bővítés 1,2 milliárd nyers webes képből indult, és 142 millió kurált képet eredményezett. A DINOv3 egy klaszterezés-alapú kiegyensúlyozási lépést ad a visszakeresés tetejére, biztosítva, hogy a 25 000 vizuális klaszter egyenlő arányban legyen képviselve. Ez a klaszterezési lépés megakadályozza, hogy a modell túlreprezentálja a vizuálisan domináns koncepciókat, mint az arcok, szövegek és gyakori objektumok, miközben alulreprezentálja a ritka, de fontos vizuális tartományokat, mint az infrastruktúra hibák, orvosi képek és műholdfelvételek.
Modell Méret és Architektúra. A DINOv2 legnagyobb tanár modellje a ViT-g volt 1 milliárd paraméterrel. A DINOv3 ezt 7 milliárd paraméterre (ViT-7B) skálázza – a modellkapacitás 7-szeres növekedése. Maga az architektúra is modernizálódott. A DINOv2 szabványos tanult abszolút pozíciós beágyazásokat használt, míg a DINOv3 Rotary Position Embeddings (RoPE) alkalmaz a változó felbontás támogatásához. A DINOv3 ViT-7B előrecsatolt hálózata SwiGLU aktivációt használ a GELU helyett, követve a nagy nyelvi modellek architekturális újításait. A DINOv2 14 pixeles foltméretet használt (az eredeti cikk ViT architektúrája), míg a DINOv3 16 pixeles foltméretet használ. Ez a változás 256-ról (224/14 = 16, 16^2 = 256) 196-ra (224/16 = 14, 14^2 = 196) csökkenti a foltok számát egy 224x224-es bemenet esetén, ami 23%-os csökkenés a sorozathosszban, ami körülbelül 40%-kal kevesebb önfigyelmi számítást jelent (mivel a figyelem O(N2)-ként skálázódik). Ez az architekturális hatékonysági nyereség részben ellensúlyozza a nagyobb modellméretekből származó megnövekedett számítási költséget.
Sűrű Jellemző Minőség. Ez a legjelentősebb minőségi javulás a DINOv3-ban. A nagy modellekkel végzett hosszú képzési ütemezések során a DINOv2 folt szintű jellemzőiről megfigyelték, hogy fokozatosan romlanak a képzés egy bizonyos pontja után – a pixelszintű jellemzőtérképek elveszítik térbeli szerkezetüket, és zajossá vagy elmosódottá válnak, miközben a globális [CLS] token jellemzők tovább javulnak. Ez a romlás kevésbé alkalmassá tette a DINOv2-t a sűrű előrejelzési feladatokra, mint a szemantikus szegmentáció és mélységbecslés, ha hosszú képzési ütemezéseket használtak. A DINOv3 Gram rögzítési mechanizmusa közvetlenül kezeli ezt a romlást azáltal, hogy kikényszeríti, hogy a folt jellemzők közötti páronkénti hasonlósági szerkezet stabil maradjon a képzés során. Ennek eredményeként a DINOv3 sűrű jellemzői élesek és szemantikailag értelmesek maradnak még milliónyi képzési iteráció után is. Az ADE20K szemantikus szegmentációs benchmarkon a DINOv3 54,2%-os átlagos Intersection over Union (mIoU) pontszámot ér el egy befagyasztott gerinccel és lineáris szondával – ez +6,1 pontos javulás a DINOv2 48,1%-os mIoU-jához képest. A NAVI 3D kulcspont illesztési benchmarkon a DINOv3 68,5%-os pontosságot ér el a DINOv2 60,2%-ával szemben. A videó objektum szegmentációban (DAVIS 2017) a DINOv3 82,3 J&F-Mean értéket ér el a DINOv2 75,6-ával szemben.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Javulás |
|---|---|---|---|---|
| ImageNet-1k Lineáris Szonda | 83,5% | 85,1% | 86,7% | +1,6/+3,2 |
| ADE20K Szem. Szegm. (mIoU) | 48,1% | 52,3% | 54,2% | +4,2/+6,1 |
| DAVIS 2017 (J&F-Mean) | 75,6 | 79,4 | 82,3 | +3,8/+6,7 |
| Példány Visszakeresés (GAP) | 42,1 | 46,8 | 53,0 | +4,7/+10,9 |
| NYU Mélység (RMSE le) | 0,458 | 0,412 | 0,389 | -0,046/-0,069 |
| ObjectNet (Top-1) | 72,3% | 75,8% | 78,2% | +3,5/+5,9 |
A fenti táblázat azt mutatja, hogy a DINOv3 ViT-Base modellje (86M paraméter) már minden benchmarkon felülmúlja a DINOv2 sokkal nagyobb ViT-Large modelljét (304M paraméter), miközben 3,5-szer kisebb és jelentősen számítási szempontból hatékonyabb a következtetéshez.
Licenc Különbségek. A DINOv2 az Apache 2.0 licenc alatt jelent meg, egy szabványos nyílt forráskódú licenc, amely engedélyezi a szabad használatot, módosítást és terjesztést bármilyen célra, beleértve a kereskedelmi alkalmazásokat is. A DINOv3 a DINOv3 Licenc alatt jelenik meg, egy egyedi licenc, amelyet a Meta AI fejlesztett ki a modell kiadásához. Bár a DINOv3 Licenc engedélyezi a kereskedelmi használatot, további feltételeket tartalmaz a nevesítésre és az elfogadható használatra vonatkozóan. Az egyedi licenc vitát váltott ki a nyílt forráskódú közösségben – a dinov3 adattár #31-es GitHub issue-ja kifejezetten egy szabványosabb licenc, például az Apache 2.0 alatti kiadást kéri. A gyakorlati szakembereknek át kell tekinteniük a teljes LICENSE.md szöveget a GitHub adattárban, mielőtt a DINOv3-t kereskedelmi termékekben telepítenék. A DINOv3 Licenc engedélyezi a kereskedelmi alkalmazásokat, mint például az infrastruktúra-ellenőrzés, megfelelő nevesítéssel.
DINOv3 Finomhangolása Domain Feladatokra
Bár a DINOv3 a legmodernebb teljesítményt éri el egy befagyasztott gerinccel (lineáris szonda vagy k-NN osztályozó), bizonyos infrastruktúra alkalmazások profitálnak a gerinc domain-specifikus adatokon való finomhangolásából. A befagyasztott és finomhangolt megközelítések közötti választás az adathalmaz méretétől, a feladat specifikusságától és a számítási költségvetéstől függ.
Befagyasztott Gerinc (Lineáris Szondázás). A legegyszerűbb és számítási szempontból leghatékonyabb megközelítés a DINOv3 súlyainak befagyasztása, és csak egy lineáris osztályozó tanítása a kinyert beágyazások tetején. Egy 768 dimenziós CLS beágyazásokat előállító ViT-B/16 modell esetében egy lineáris osztályozó pontosan 768 x N paraméterből áll, ahol N a kimeneti osztályok száma. Egy 5 osztályos felület típus osztályozási feladathoz ez csak 768 x 5 = 3 840 tanítható paraméter – a képzés percek alatt konvergál CPU-n, és osztályonként akár 50 címkézett példát is elegendő a jó eredmények eléréséhez. A befagyasztott gerinc megközelítés akkor ajánlott, ha a cél tartományt jól lefedi a DINOv3 előképzési adata, amely természetes képeket, webes képeket és változatos vizuális tartományokat tartalmaz. Infrastruktúra-felület elemzéshez a befagyasztott DINOv3 beágyazások lineáris szondával gyakori kiindulópontot jelentenek a felület típusának osztályozásához (aszfalt, beton, kompozit, zúzottkő záróréteg, kavics). A kulcsfontosságú előny, hogy a DINOv3 gerinc univerzális vizuális jellemzőket biztosít, amelyek általánosíthatók a tartományok között bármilyen domain-specifikus képzés nélkül.
Könnyű Finomhangolás (Adapter / LoRA). Azokhoz a feladatokhoz, ahol a befagyasztott gerinc nem ér el elegendő pontosságot – jellemzően erősen specializált tartományok, amelyek vizuális jellemzői jelentősen eltérnek a természetes képektől – a paraméter-hatékony finomhangolási (PEFT) módszerek kis számú tanítható paramétert adnak hozzá, miközben a gerinc nagy részét befagyasztva tartják. A Low-Rank Adaptation (LoRA) rang-dekompozíciós mátrixpárokat (A és B, ahol a súlyfrissítés delta_W = AB) ad a lekérdezési és érték vetítési mátrixokhoz minden önfigyelmi rétegben. Egy ViT-B/16 modell esetében a LoRA r=8 ranggal körülbelül 0,5 millió tanítható paramétert ad hozzá (kevesebb, mint a 86 milliós összmennyiség 0,6%-a), elosztva mind a 12 transzformer rétegben. Csak ezeknek a LoRA paramétereknek a tanítása 10-50 epochon keresztül egy 1 000-5 000 címkézett képből álló domain-specifikus adathalmazon jellemzően 3-8%-os pontosságjavulást eredményez a lineáris szondázáshoz képest, miközben csak 1-2 órát igényel egyetlen GPU-n. A LoRA finomhangolás alkalmas specializált hibabesorolási feladatokhoz, mint például a különböző repedéstípusok (keresztirányú, hosszirányú, blokk, alligátor, tükröződő) megkülönböztetése, ahol az árnyalt vizuális különbségek profitálnak a domain-specifikus adaptációból.
Teljes Finomhangolás. Ha elegendő címkézett adat áll rendelkezésre (10 000+ kép osztályonként), és a feladat maximális pontosságot igényel, a teljes DINOv3 gerinc finomhangolható. Ez frissíti a ViT-B/16 mind a 86 millió paraméterét a címkézett adathalmaz segítségével. A teljes finomhangolás jellemzően 4-8 GPU-t igényel, egyenként 16-32 GB VRAM-mal, elosztott képzést PyTorch DDP-vel, és gondos hiperparaméter hangolást (tanulási sebesség jellemzően 5x10^-6 és 5x10^-5 között, súlycsökkenés 0,01-0,1, koszinusz tanulási sebesség ütemezés 10%-os bemelegítéssel). A teljes finomhangolás további 2-5%-os pontosságot eredményezhet a LoRA-hoz képest erősen specializált feladatokon, de magában hordozza a katasztrofális felejtés kockázatát – a modell elveszítheti az önfelügyelt előképzés során megszerzett általános vizuális tudást. Ennek enyhítésére a fokozatos feloldás (először az utolsó réteg feloldása, majd fokozatosan a korábbi rétegek) és a tanulási sebesség diszkrimináció (alacsonyabb tanulási sebesség a korábbi rétegekhez, magasabb a későbbi rétegekhez) ajánlott. A DINOv3 egy utólagos nagy felbontású adaptációs protokollt is javasol finomhangoláskor: folytassa a képzést 10 ezer lépésig vegyes globális termésméreteken az iBOT veszteség és a Gram rögzítés használatával, ami biztosítja, hogy a gerinc általánosítson a szabványos 224px felbontástól a nagyon nagy felbontásokig (4096px), miközben éles jellemzőtérképeket állít elő.
Befagyasztás vs Finomhangolás Döntési Mátrix.
| Forgatókönyv | Adathalmaz Mérete | Ajánlott Megközelítés | Képzési Idő | Várható Pontosság a Befagyasztotthoz Képest |
|---|---|---|---|---|
| Felület típus osztályozás | 50-200 kép/osztály | Befagyasztott + lineáris szonda | kevesebb mint 1 óra CPU | Alapvonal |
| Repedés típus osztályozás | 500-5 000 kép | LoRA (rang 8-16) | 1-4 óra GPU | +3-8% |
| Hiba súlyosság besorolás | 5 000-20 000 kép | LoRA vagy részleges finomhangolás | 4-12 óra GPU | +5-12% |
| Új hiba detektálás | 10 000+ kép | Teljes finomhangolás | 1-3 nap több GPU | +8-15% |
Domain Adaptációs Megfontolások. Az infrastruktúra-ellenőrzési képek több szempontból is eltérnek a természetes képektől: konzisztens kameraszögek (nadír/drón perspektíva), specifikus fényviszonyok (kültéri, de változó), ismétlődő minták (burkolati textúra) és szűk vizuális tartomány (utak, kifutópályák, hídfedélzetek). A DINOv3 önfelügyelt előképzése változatos adatokon azt jelenti, hogy már sok hasonló vizuális mintát látott, de a webes képek és az infrastruktúra képek közötti tartományrés továbbra is fennáll. A befagyasztott DINOv3 beágyazások gyakran jól átvihetők a burkolati képekre bármilyen finomhangolás nélkül. Az olyan specializált hibák detektálásához azonban, mint a betonburkolatok hézaglépcsőzése vagy az aszfaltfedőrétegek kátyúsodása, a LoRA finomhangolás 2 000-5 000 címkézett példával a cél tartományból 5-8 százalékponttal javítja az F1-pontszámot. A finomhangolt modell javított robusztusságot is mutat a domain-specifikus műtermékekkel szemben, mint a guminyomok, gumimaradványok és kifutópálya jelölések, amelyek összetéveszthetik az általános előtanított jellemzőket.
DINOv3 mint Jellemzőkinyerő
A DINOv3 jellemzőkinyerőként való használata a legegyszerűbb és legszélesebb körben alkalmazható telepítési minta, különösen azon szervezetek számára, amelyek nem rendelkeznek a nagyszabású képzéshez szükséges számítási erőforrásokkal. Ebben a paradigmában a DINOv3 minden képet egyetlen előrevezetésen keresztül dolgoz fel, beágyazásokat hozva létre, amelyeket gyorsítótáraznak és újra felhasználnak több downstream feladathoz.
Jellemzőkinyerési Csővezeték. A DINOv3 jellemzők kinyerésének szabványos csővezetéke egy infrastruktúra elemzési munkafolyamatban a következőképpen működik. Először is, a bemeneti képet (jellemzően egy 4K drónkép, amely egy 10m x 7m-es kifutópálya szakaszt fed le) átfedő 224x224-es csempékre osztják 50%-os átfedéssel a szélek lefedésének biztosítása érdekében. Minden csempét normalizálnak a szabványos ImageNet átlaggal (0,485, 0,456, 0,406) és szórással (0,229, 0,224, 0,225). A normalizált csempét átvezetik a DINOv3 ViT-B/16 modellen PyTorch használatával FP16 pontossággal a memória hatékonyság érdekében. A modell 201 tokent állít elő (1 CLS + 4 regiszter + 196 folt), mindegyik 768 dimenziós. A CLS token beágyazást (768-dim) kinyerik a globális csempe osztályozáshoz. A 196 folt token beágyazást egy 14x14-es térbeli rácsba rendezik át 768 dimenziós vektorokból a sűrű előrejelzéshez. Az összes csempéből származó összes beágyazást egy térbeli koordináták által indexált jellemző adatbázisba gyűjtik, lehetővé téve a csempék közötti elemzést és a nagy területű térképezést.
Számítási Hatékonyság. A jellemzőkinyerés befagyasztott DINOv3 ViT-B/16-tal körülbelül 12,5 GFLOP-ot igényel 224x224-es képenként – összehasonlítható a ResNet-50-nel (7,7 GFLOP) vagy az EfficientNet-B4-gyel (12,0 GFLOP). Egy NVIDIA RTX 4090-en (FP16) a következtetési átviteli sebesség körülbelül 180 kép/másodperc. Egy NVIDIA Jetson Orin NX 16GB-on (peremeszköz) az átviteli sebesség körülbelül 25 kép/másodperc. Egy tipikus 4K drónképhez (3840x2160 pixel), amelyet 224x224-es csempékre osztanak 50%-os átfedéssel, körülbelül 160 csempére van szükség. A teljes feldolgozási idő egy RTX 4090-en kevesebb, mint 1 másodperc 4K képenként. A jellemzőkinyerés költsége egyszeri kiadás – miután a beágyazásokat eltárolták, minden downstream feladat (osztályozás, szegmentáció, visszakeresés) elhanyagolható további számítást ad (ezredmásodpercek képenként).
Faiss Beágyazási Adatbázis Hasonlósági Kereséshez. A kinyert DINOv3 beágyazások tárolhatók egy FAISS (Facebook AI Similarity Search) indexben a hatékony hasonlóság-alapú visszakereséshez és elemzéshez. A FAISS egy a Meta AI által fejlesztett könyvtár a sűrű vektorok hatékony hasonlósági kereséséhez és klaszterezéséhez, amely képes milliárdos méretű adatbázisok ezredmásodpercek alatti keresésére. Egy ilyen adatbázis indexelheti a kifutópálya felületi csempéket a 768 dimenziós DINOv3 CLS beágyazásaik alapján. Amikor egy új ellenőrzési kép érkezik, a beágyazását kiszámítják, és összehasonlítják a teljes adatbázissal, hogy megtalálják a leginkább vizuálisan hasonló történelmi csempéket. Ez lehetővé teszi az állapot trend elemzést – hasonló felületi állapotok megtalálását, amelyek a múltban előfordultak, és azok későbbi romlási pályáit. Egy tipikus FAISS index IVF (Inverted File) 4096 centroiddal és HNSW (Hierarchical Navigable Small World) gráfot használ a durva kvantálóhoz, több mint 99%-os visszahívást érve el 10 ms lekérdezési idő alatt egy 10 millió csempe beágyazást tartalmazó adatbázis esetén. A koszinusz hasonlósági metrikát használják az összes beágyazás összehasonlításához.
Keves Példás Hiba Detektálás. A DINOv3 beágyazások lehetővé teszik a hatékony kevés példás hiba detektálást – új hibatípusok azonosítását akár 1-5 példaképből. Amikor egy új típusú felületi károsodást (pl. egy adott repedésmintát vagy felületi lerakódást) észlelnek a terepen, az ellenőr 1-5 példaképet készít, és megjelöli a hibás régiókat. A DINOv3 folt beágyazásokat ezekből a példarégiókból átlagolják, hogy létrehozzanak egy hiba prototípus vektort (768 dimenziós). Az új képeket ezután feldolgozzák, és minden folt beágyazást összehasonlítanak a prototípussal koszinusz hasonlóság segítségével. A küszöbérték feletti hasonlóságú foltokat (jellemzően 0,75-0,85, empirikusan meghatározva) a hibatípusnak megfelelőként jelölik meg. Ez a prototípus-alapú megközelítés 89-93%-os detektálási pontosságot ér el új hibák esetén mindössze 3 példából, bármilyen újratanítás vagy finomhangolás nélkül. Ez kritikus az infrastruktúra-ellenőrzésben, ahol gyakran találkoznak új, váratlan károsodási típusokkal, amelyeket dokumentálni kell anélkül, hogy késleltetnék az ellenőrzési munkafolyamatot a képzési adatok gyűjtéséhez.
Sűrű Folt Tokenek Szegmentációhoz
A DINOv3 által egy 224x224-es képhez előállított 196 folt token beágyazás egy 14x14-es térbeli rácsot alkot 768 dimenziós jellemzővektorokból. Ez a rács az elsődleges reprezentáció a sűrű előrejelzési feladatokhoz – szemantikus szegmentáció, repedésdetektálás és hiba lokalizáció –, ahol a bemeneti kép minden pixelét osztályozni kell.
Rács Szerkezet és Felbontás. Egy 224x224 pixeles bemenethez 16x16-os foltokkal a 196 folt token mindegyike a bemenet egy 16x16 pixeles régióját fedi le. Az eredményül kapott 14x14-es rács lépésköze 16 pixel a szomszédos folt középpontok között. Ez azt jelenti, hogy a DINOv3 jellemzőtérkép térbeli felbontása körülbelül 1/256-a a bemeneti képének (14x14 = 196 vs 224x224 = 50 176 pixel). Az önfigyelmi mechanizmus kompenzálja ezt a térbeli tömörítést azáltal, hogy információkat integrál a foltok között – minden folt beágyazást a környező 14x14-es rács tájékoztat a többszálú figyelem révén, hatékony kontextus tudatosságot biztosítva. Szegmentációs feladatokhoz a 14x14-es rácsot fel kell nagyítani az eredeti képfelbontásra. Egy könnyű konvolúciós dekóder néhány réteggel tipikus, és csak a gerinc paraméterszámának kis töredékét adja hozzá.
DINOv3 Sűrű Jellemző Minőség vs DINOv2. A DINOv3 kritikus újítása, a Gram rögzítés, közvetlenül ezeknek a sűrű folt jellemzőknek a minőségét célozza meg. Hosszú képzési futtatások során a DINOv2 folt jellemzői azt mutatták, amit a szerzők a sűrű jellemzőtérképek romlásaként írnak le: a folt beágyazások kevésbé szemantikailag értelmessé válnak, a folt-folt hasonlósági szerkezet romlik, és a szegmentációs minőség platót ér el vagy akár csökken a globális osztályozás folyamatos javulása ellenére. A Gram rögzítés megőrzi a folt jellemzők Gram mátrixát (páronkénti hasonlósági szerkezet) azáltal, hogy egy korai képzésből származó referenciához igazítja, biztosítva, hogy a foltok közötti térbeli és szemantikus kapcsolatok stabilak maradjanak. A gyakorlati eredmény az, hogy a DINOv3 folt jellemzők élesek és szemantikailag koherensek maradnak még nagy felbontásokon is. A DINOv3 cikk PCA vizualizációkat mutat be a DINOv3 folt jellemzőiről nagy felbontású légifelvételekhez – utak, épületek, növényzet és víztestek egyértelműen elkülöníthetők a jellemzőtérben, kivételes jellemzőminőséget demonstrálva a jelenetértelmezéshez.
Szemantikus Szegmentáció Lineáris Szondákkal. A DINOv3 egyik leglenyűgözőbb képessége a szemantikus szegmentáció végrehajtása csak lineáris szondák használatával a befagyasztott folt jellemzőkön – a gerinc finomhangolása nem szükséges. Egy lineáris szegmentációs fej egy 1x1-es konvolúciót (vagy ezzel egyenértékűen, egy lineáris réteget foltonként) alkalmaz, hogy minden folt beágyazást 768 dimenzióból C kimeneti osztályba képezzen le. Ez egy 14x14-es szegmentációs térképet hoz létre, amelyet a képfelbontásra nagyítanak fel. A megközelítés egyszerűsége ellenére (csak 768 x C tanítható paraméter a teljes szegmentációs fejhez), a DINOv3 52,3%-os mIoU-t ér el az ADE20K-n a ViT-B-vel, felülmúlva számos olyan módszert, amelyek finomhangolják a teljes gerincet. Ezt a DINOv3 folt jellemzők kivételes lineáris szétválaszthatósága teszi lehetővé – a beágyazási tér már úgy van strukturálva, hogy a különböző szemantikus kategóriák elkülönülő, lineárisan szétválasztható régiókat foglaljanak el.
Repedés Szegmentáció Infrastruktúrában. A sűrű folt tokenek kiválóan alkalmasak a pixelszintű repedés szegmentációra kifutópálya és burkolati képekben. A 14x14-es, 768 dimenziós folt beágyazásokból álló rács rögzíti mind a helyi repedés textúrát (az egyes 16x16-os foltokon belül), mind a kontextuális információkat (mely foltokat köt össze a repedés). A szegmentációs fej egy könnyű hálózat 3 transzponált konvolúciós réteggel, amely a 14x14-es jellemzőrácsot 224x224-es felbontásra nagyítja fel. A képzéshez körülbelül 500 címkézett repedés szegmentációs képre (224x224-es csempék pixelszintű repedés maszkokkal) van szükség, és 2-3 óra alatt konvergál egyetlen RTX 3060 GPU-n. A közzétett összehasonlítások általában azt mutatják, hogy a DINO-családba tartozó gerincek azonos képzési körülmények között felülmúlják a ResNet-típusú gerinceket a repedésdetektálásban, és hogy a DINOv3 finomhangolása magasabb bemeneti felbontáson tovább javítja az eredményt.
Regiszter Tokenek a Háttér Elnyeléséhez. A DINOv3 4 regiszter tokenje specifikus szerepet játszik a sűrű jellemzők minőségében. Ezek a tokenek további tanulható tokenek (768 dimenzió), amelyeket a CLS token mellett a sorozat elé helyeznek. Az önfigyelem során a regiszter tokenek figyelhetnek az összes folt tokenre, és azok is figyelhetnek rájuk. A kulcsfontosságú felismerés az, hogy a kép egyes vizuális foltjai kiugró vagy háttérinformációkat tartalmaznak – eget, távoli objektumokat vagy egységes textúra nélküli régiókat –, amelyeket, ha a folt tokenek kénytelenek lennének kódolni, rontanák a jellemzőtér minőségét. A regiszter tokenek abszorbens memóriahelyekként működnek, amelyek rögzítik ezt a nem informatív tartalmat, lehetővé téve a folt tokenek számára, hogy a szemantikailag jelentős képterületekre összpontosítsanak. A gyakorlati hatás a sűrű jellemzők minőségének mérhető javulása: +1,8 mIoU az ADE20K-n és jelentősen tisztább folt hasonlósági térképek, különösen nagy egységes háttérrégiókkal rendelkező képek esetén. Infrastruktúra-ellenőrzésnél, ahol a képek gyakran tartalmaznak nagy területeket egységes burkolati textúrával, a regiszter tokenek segítenek fenntartani a tiszta folt jellemzőket, amelyek a károsodási mintákra összpontosítanak a háttér textúra helyett.
MPS és GPU Képzés
A DINOv3 képzési és következtetési infrastruktúrája több hardver háttérrendszert támogat, a nagy GPU klaszterektől a peremeszközökig és az Apple Silicon Mac-ekig.
GPU Képzés Nagy Méretben. A ViT-7B tanár modellt 256 NVIDIA A100 80GB SXM4 GPU-n tanították NVLink összeköttetésekkel, ami körülbelül 20 TB/s aggregált GPU memória sávszélességet és 25 PFLOPS FP16 számítási teljesítményt biztosít. A képzés a Fully Sharded Data Parallel (FSDP) – a PyTorch natív széttöredezési stratégiája – használja, amely a modell paramétereit, gradienseit és optimalizáló állapotait az összes GPU között particionálja. Az FSDP-vel és vegyes pontosságú képzéssel (BF16) a 7B modell belefér a 256 GPU aggregált memóriájába (256 x 80GB = 20,48 TB), annak ellenére, hogy minden egyes GPU csak a modell paramétereinek körülbelül 2-3%-át tudja tárolni. Az xFormers könyvtár (a Meta AI által fejlesztett) memóriahatékony figyelmi implementációkat biztosít, beleértve a memóriahatékony figyelmet (a figyelmi memória csökkentése O(N2)-ről O(N)-re) és a blokk-ritka figyelmi mintákat. Az FSDP, BF16, xFormers és gradiens ellenőrzőpontok kombinációja a ViT-7B GPU-nkénti memóriaigényét a becsült 250 GB-ról (teljes pontosság, optimalizálások nélkül) körülbelül 65 GB-ra csökkenti, beleférve a 80 GB-os A100 kapacitásába.
Egy GPU-s Következtetés. Gyakorlati telepítéshez a DINOv3 ViT-B/16 (86M paraméter) hatékonyan fut egyetlen NVIDIA GPU-n. FP32 pontosságnál a modell körülbelül 344 MB memóriát igényel a paraméterekhez (86M x 4 bájt per lebegőpontos). Az 1-es kötegméretű (224x224 kép) aktivációkkal együtt a teljes memóriahasználat körülbelül 1,2-1,5 GB (paraméterek + aktivációk + köztes tenzorok). FP16 pontosságnál a paraméter memória 172 MB-ra csökken, a teljes használat pedig körülbelül 0,8-1,0 GB-ra. Ez azt jelenti, hogy a DINOv3 ViT-B/16 kényelmesen fut akár 4 GB VRAM-mal rendelkező GPU-kon is, beleértve az olyan régebbi kártyákat, mint az NVIDIA GTX 1650 és az NVIDIA Jetson Xavier NX. Az átviteli sebesség egy RTX 3060-on (12GB) FP16-on körülbelül 100 kép/másodperc. Egy NVIDIA A100-on az átviteli sebesség meghaladja a 400 kép/másodpercet, lehetővé téve a 4K drónfelvételek valós idejű feldolgozását csempe bontási sebességgel.
Apple Silicon (MPS) Támogatás. A DINOv3 teljes mértékben kompatibilis az Apple Metal Performance Shaders (MPS) háttérrendszerével a PyTorch-ban, GPU-gyorsított következtetést biztosítva Apple Silicon Mac-eken (M1, M2, M3, M4 sorozat). Az MPS háttérrendszer a PyTorch műveleteket az Apple GPU architektúrájára képezi le a Metal keretrendszeren keresztül. A teljesítmény egy M2 Pro MacBook Pro-n (19 magos GPU, 32 GB egyesített memória) eléri a körülbelül 25-35 kép/másodpercet a ViT-B/16 esetében FP16 pontosságnál – elegendő a nagy képgyűjtemények kötegelt feldolgozásához. Egy M2 Ultra Mac Studio-n (76 magos GPU, 192 GB egyesített memória) az átviteli sebesség körülbelül 70-90 kép/másodperc. A memóriahasználat hatékony, mert az Apple egyesített memória architektúrája kiküszöböli a CPU-GPU adatátviteli többletköltséget. Az MPS-gyorsított DINOv3 lehetővé teszi az ellenőrök számára, hogy közvetlenül egy MacBook-on futtassák a következtetést a terepen, dedikált GPU hardver nélkül. Az Apple Silicon nagyobb egyesített memóriája (akár 192 GB az M2 Ultra-n) lehetővé teszi a nagyon nagy felbontású képek feldolgozását csempézés nélkül – egy 4096x4096-os kép 256x256 foltot = 65 536 tokent eredményez, ami körülbelül 8 GB VRAM-egyenértékű memóriát igényel az egyesített memóriakészleten.
Elosztott Következtetés. Nagy léptékű infrastruktúra-ellenőrzési projektekhez, amelyek milliónyi képet dolgoznak fel, elosztott következtetésre van szükség több GPU-n vagy gépen. A DINOv3 támogatja a PyTorch DistributedDataParallel (DDP) használatát több GPU-s következtetéshez egyetlen szerveren, a modell párhuzamosságot (csővezeték párhuzamosság a ViT-7B-hez) és a Ray (egy nyílt forráskódú elosztott számítási keretrendszer) használatát több csomópontos elosztott következtetéshez. A nagyméretű telepítések általában Kubernetes-t használnak GPU csomópont készletekkel, amelyek a DINOv3 következtetést skálázható mikroszolgáltatásként futtatják. Minden következtetési pod egyetlen T4 GPU-n (16 GB VRAM) fut, és körülbelül 70 kép/másodpercet dolgoz fel. Egy 50 podból álló klaszter 3 500 kép/másodperc átviteli sebességet ér el, lehetővé téve egy 500 képből álló kifutópálya felmérés feldolgozását kevesebb mint 3 másodperc alatt. A következtetési szerver a TorchServe használja a modell kiszolgálásához dinamikus kötegeléssel (4-16 közötti kötegméretek a kérés mennyiségétől függően) és FP16 pontossággal az átviteli sebesség maximalizálása érdekében.
Peremtelepítés NVIDIA Jetson-nal. Terepen telepített ellenőrző rendszerekhez, amelyek drónokat vagy földi járműveket használnak, a DINOv3 ViT-B/16 telepíthető NVIDIA Jetson peremeszközökre. A Jetson Orin NX 16GB modul (100 TOPS AI teljesítmény) 15-25 kép/másodpercet ér el a DINOv3 ViT-B/16-tal FP16-on, a teljesítmény módtól függően (15W vs 25W vs 40W). A modellt a TensorRT – az NVIDIA mély tanulási következtetés optimalizálója – segítségével optimalizálják, amely összeolvasztja a rétegeket, optimalizálja a kernel kiválasztást, és FP16-ra vagy INT8-ra kvantál. A TensorRT INT8 kvantálással a következtetési sebesség 30-40 kép/másodpercre nő a Jetson Orin NX-en, kevesebb mint 1%-os pontosságromlással az FP32-hez képest. A Jetson Xavier NX (21 TOPS) 8-12 kép/másodpercet ér el a TensorRT FP16-tal. Ez a peremtelepítés lehetővé teszi a valós idejű repedésdetektálást a drónrepülés során – a drón kamera képeket rögzít, a DINOv3 feldolgozza azokat a fedélzeten, és másodperceken belül jelzi a lehetséges hibákat anélkül, hogy felhőkapcsolatra lenne szükség.
Nyílt Forráskódú Elérhetőség és Licencelés
A DINOv3-t a Meta AI 2025-ben nyílt forráskódú projektként adta ki, folytatva a vállalat hagyományát, hogy nyilvánosan kiadja a legmodernebb AI kutatási modelleket. A licencelési és terjesztési feltételek megértése elengedhetetlen azon szervezetek számára, amelyek a DINOv3-t kereskedelmi termékekben tervezik telepíteni.
Kód és Modell Súlyok. A teljes DINOv3 kódbázis elérhető a GitHub-on a facebookresearch/dinov3 címen (10 700+ csillag 2025 közepén). Az adattár tartalmazza a teljes képzési és kiértékelési kódot (PyTorch), a modell definíciókat, az adatfeldolgozási csővezetékeket, a kiértékelő szkripteket és az előtanított súlyokat mind a 12 kiadott modellváltozathoz. A modell súlyok a Hugging Face Hub-on is elérhetők a facebook/dinov3-* névtér alatt, beleértve: facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M param) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M param) – a gyakran használt alapmodell facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M param) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1,5B param) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B param) Plus ConvNeXt változatok (T, S, B, L) és műhold-specifikus modellek (SAT-493M)
A Hugging Face hozzáféréshez a felhasználóknak el kell fogadniuk a Meta feltételeit, és meg kell adniuk kapcsolattartási adatokat, amelyeket a Meta Adatvédelmi Szabályzattal összhangban gyűjtenek, tárolnak és dolgoznak fel. A modell súlyok PyTorch state_dict fájlokként kerülnek terjesztésre, amelyek kompatibilisek a Hugging Face Transformers könyvtárral (az integráció elérhető az AutoModel.from_pretrained() segítségével).
A DINOv3 Licenc. A DINOv3 a DINOv3 Licenc alatt jelenik meg, egy egyedi nyílt forráskódú licenc, amelyet a Meta AI fejlesztett ki kifejezetten ehhez a modell kiadáshoz. Ez eltér a DINOv2-től, amely a szabványos Apache 2.0 licenc alatt jelent meg. A DINOv3 Licenc engedélyezi: A modell és a kód használatát, sokszorosítását, módosítását és terjesztését Kereskedelmi használatot, beleértve a termékekbe és szolgáltatásokba való integrálást Származtatott művek altalícencezését eltérő feltételek mellett
A DINOv3 Licenc specifikus nevesítési követelményeket tartalmaz (a szerzői jogi közleményeket meg kell őrizni), és egy elfogadható használati szabályzatot, amely megtiltja a modell használatát bizonyos célokra, beleértve az emberi jogokat sértő megfigyelést, az autonóm fegyvereket és az alkalmazandó törvények megsértését. A licenc vitát váltott ki a fejlesztői közösségben – a dinov3 adattár #31-es GitHub issue-ja kifejezetten egy szabványosabb licenc, például az Apache 2.0 alatti kiadást kéri a vállalati nyílt forráskódú licencpolitikák megfelelőségének egyszerűsítése érdekében. Az olvasóknak át kell tekinteniük a licenc feltételeket a saját felhasználási esetükkel szemben.
Összehasonlítás Más Gerinc Licencekkel.
| Gerinc | Licenc | Kereskedelmi Használat | Nevesítés Szükséges | Egyedi Feltételek |
|---|---|---|---|---|
| DINOv3 | DINOv3 Licenc | Igen | Igen | Igen |
| DINOv2 | Apache 2.0 | Igen | Igen | Nem |
| ViT (Google) | Apache 2.0 | Igen | Igen | Nem |
| CLIP (OpenAI) | MIT | Igen | Igen | Nem |
| OpenCLIP | MIT | Igen | Igen | Nem |
| SAM (Meta) | Apache 2.0 | Igen | Igen | Nem |
| ConvNeXt | MIT | Igen | Igen | Nem |
A Reprodukció Számítási Költsége. A DINOv3 ViT-7B képzési költsége becslések szerint 2-5 millió USD (körülbelül 15 000 GPU-nap A100-80GB-on, igény szerinti felhő árazás mellett). A desztillált kisebb modellek (ViT-B, ViT-L) jelentősen olcsóbbak reprodukálni, de még mindig jelentős számítást igényelnek – a ViT-Base desztilláció a ViT-7B-ből az LVD-1689M-en körülbelül 500-800 GPU-napot igényel. A gyakorlati szakemberek számára azonban az előtanított súlyok elérhetősége kiküszöböli a képzési számítás szükségességét – a súlyok letölthetők és azonnal használhatók következtetésre egyetlen bármilyen generációs GPU költségén. Ez a hozzáférhetőség az alapmodellek alapvető értékajánlata: a hatalmas képzési költség amortizálódik az összes downstream felhasználó között.
Közösségi és Ökoszisztéma Integráció. A DINOv3 széles körű ökoszisztéma-integrációból profitál: a Hugging Face Transformers plug-and-play API-t biztosít, a PyTorch Hub támogatja a modell betöltését a torch.hub.load() segítségével, és a modell szerepel a Torchvision modellkészletben az egyszerű hozzáférés érdekében. A Weights & Biases, MLflow és Neptune.ai integrációja a kísérletkövetéshez szabványos PyTorch horgokon keresztül támogatott. Az ONNX (Open Neural Network Exchange) formátumú exportálás támogatott a nem PyTorch környezetekbe történő telepítéshez, beleértve a TensorRT-t NVIDIA peremeszközökhöz, a CoreML-t Apple eszközökhöz és a TFLite-ot mobil telepítéshez. A DINOv3 a Hugging Face Transformers csővezetéken keresztül integrálódik, TensorRT optimalizálással a Jetson Orin NX peremtelepítéshez és MPS gyorsítással macOS laptopokhoz.
Következtetés. A DINOv3 generációs ugrást jelent az önfelügyelt látás alapmodelljeiben, a legmodernebb teljesítményt érve el a globális és sűrű előrejelzési feladatokon a példátlan méretarány (1,689 milliárd kép, 7 milliárd paraméter) és a Gram rögzítési innováció révén, amely megőrzi a sűrű jellemzők minőségét. Infrastruktúra-felület elemzéshez a DINOv3 ViT-B/16 változata egy 768 dimenziós beágyazási teret biztosít kivételes szemantikus szerkezettel – a felület típusok, repedés minták és hiba jellemzők lineárisan szétválaszthatók a beágyazási térben, lehetővé téve a pontos osztályozást és detektálást befagyasztott gerinc következtetéssel. A nyílt forráskódú elérhetőség, a széles hardvertámogatás (GPU, MPS, Edge) és a megengedő licencelés a DINOv3-t erős gerincévé teszik az automatizált infrastruktúra-ellenőrzésnek, szerény domain-specifikus képzési adatokkal és számítási követelményekkel.
Gyakran Ismételt Kérdések
- Mi a különbség a DINOv3 és a DINOv2 között?
- A DINOv3 jelentős skálázási ugrást jelent a DINOv2-höz képest több dimenzióban. Először is, a képzési adatok: a DINOv2-t 142 millió kurált képen (LVD-142M) tanították, míg a DINOv3 1,689 milliárd képre (LVD-1689M) skálázódik, ami 12-szeres növekedés. Másodszor, a modell mérete: a DINOv2 legnagyobb tanár modellje 1 milliárd paraméterrel rendelkezett (ViT-g), míg a DINOv3 egy 7 milliárd paraméteres tanárt (ViT-7B) tanít. Harmadszor, a foltméret: a DINOv2 14 pixeles foltméretet használt, ami 256 folt tokent eredményezett 224x224-es képenként, a DINOv3 16 pixeles foltméretet használ, ami 196 folt tokent eredményez. Negyedszer, a pozíciós beágyazások: a DINOv2 szabványos tanult pozíciós kódolásokat használt, míg a DINOv3 bevezeti a Rotary Position Embeddings (RoPE) alkalmazását véletlenszerű doboz zajjal a jobb képarány-ellenállóság érdekében. Ötödször, a DINOv3 kulcsfontosságú újítása, a Gram rögzítés, megőrzi a sűrű jellemzőtérkép minőségét hosszú képzési ütemezések során – ez egy olyan probléma, amely a DINOv2 folt jellemzőinek romlását okozta a hosszabb képzés során. Hatodszor, a DINOv3 +6 mIoU javulást ér el az ADE20K szemantikus szegmentációban, +6,7 J és F-Mean értéket a videókövetésben, és +10,9 GAP értéket a példány-visszakeresésben a DINOv2-höz képest.
- Hogyan használható a DINOv3 infrastruktúra-felület elemzésre?
- A DINOv3 ViT-B/16 gerince szolgálhat elsődleges jellemzőkinyerő motorként egy infrastruktúra-ellenőrzési csővezetékben. Amikor egy drón vagy kamera képet készít egy kifutópálya felületéről, hídfedélzetről vagy útburkolatról, a képet 224x224 pixelre méretezik, és 196 átfedés nélküli 16x16-os foltra osztják. Minden foltot lineárisan beágyaznak egy 768 dimenziós vektorba, és a CLS tokennel együtt ezek 12 transzformer kódoló rétegen haladnak át többszálú önfigyelemmel. Az eredményül kapott 768 dimenziós CLS token beágyazás rögzíti a globális felületi jellemzőket, amelyeket a felület típusának (aszfalt, beton, zúzottkő záróréteg stb.) és az általános minőségi osztályozására használnak. Ezzel egyidejűleg a 196 folt token beágyazás (mindegyik 768 dimenziós) lokalizált textúra információkat kódol a folt szintjén, amelyek támogatják a pixel szintű repedésdetektálást és más sűrű előrejelzési feladatokat. A befagyasztott gerinc megközelítés azt jelenti, hogy a DINOv3 súlyai rögzítettek maradnak, miközben könnyű, feladatspecifikus fejeket (lineáris szondák vagy sekély MLP-k) tanítanak címkézett infrastruktúra adathalmazokon. Ez körülbelül 90%-kal csökkenti a képzési költségeket a teljes finomhangoláshoz képest, miközben a legmodernebb hibadetektálási pontosságot éri el.
- Milyen hardver szükséges a DINOv3 következtetés futtatásához?
- A DINOv3 modelleket a méretek széles skáláján kínálja a különböző hardverkorlátokhoz való alkalmazkodás érdekében. A ViT-B/16 változat (86 millió paraméter) hatékonyan fut egyetlen NVIDIA GPU-n, legalább 8 GB VRAM-mal, és 50-100 képkocka/másodperc következtetési sebességet ér el egy RTX 3060 vagy magasabb kártyán. Apple Silicon Mac-eken (M1/M2/M3) az MPS (Metal Performance Shaders) háttérrendszer hardveresen gyorsított következtetést biztosít körülbelül 20-40 FPS sebességgel egy M2 Pro-n. Peremtelepítésekhez a desztillált ViT-Small változat (21M paraméter) 15-30 FPS sebességgel fut NVIDIA Jetson Orin NX-en. A legnagyobb változat, a ViT-7B, 4-8 NVIDIA A100 (80 GB) GPU-t igényel a következtetéshez. A DINOv3 támogatja a vegyes pontosságú (FP16) következtetést, ami körülbelül 50%-kal csökkenti a memóriafogyasztást elhanyagolható pontosságveszteség mellett. A modell PyTorch-on keresztül érhető el a Hugging Face Transformers segítségével, a facebook/dinov3-vitb16-pretrain-lvd1689m ellenőrzőpont a szabványos belépési pont.
- Mi az a Gram rögzítés a DINOv3-ban?
- A Gram rögzítés egy új regularizációs technika, amelyet a DINOv3-ban vezettek be a sűrű jellemzőtérképek hosszú önfelügyelt képzési ütemezések során történő romlásának megoldására. A DINOv2-stílusú hosszabb képzés során nagy modellekkel (ViT-L és felette) megfigyelték, hogy a folt szintű jellemzők elveszítik térbeli szerkezetüket és szemantikai jelentésüket – a lineáris szonda pontossága a globális feladatokon javulna, de a foltonkénti jellemzőtérképek zajossá válnának és elveszítenék lokalizációs képességüket. A Gram rögzítés bevezet egy további L2 veszteségtagot, amely a diák folt jellemzőinek Gram mátrixát egy befagyasztott Gram mátrixhoz igazítja a tanár egy korai EMA pillanatképéből. Pontosabban, adott a L2-normalizált diák folt mátrix X_S és egy Gram tanár mátrix X_G (egy korai EMA pillanatkép), a veszteség L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Ez a veszteség megőrzi a páronkénti folt hasonlósági szerkezetét ahelyett, hogy abszolút jellemző pozíciókat kényszerítene ki, térbeli regularizátorként működve. 1 millió előképzési iteráció után integrálva 2-es súllyal és 10 000 lépésenkénti tanár frissítésekkel, a Gram rögzítés +2 mIoU javulást eredményez az ADE20K szegmentációban és jobb mélységbecslési RMSE-t a globális mérőszámok romlása nélkül.
- Hogyan használják a DINOv3 768 dimenziós beágyazásait felületi hibák detektálására?
- A DINOv3 ViT-B/16 változata egy 768 dimenziós beágyazást hoz létre a 196 folt mindegyikéhez, plusz egy CLS tokent 224x224-es képenként. Infrastruktúra-felület elemzéshez ezek a beágyazások két különböző célt szolgálnak. Globális osztályozáshoz (felület típusa, általános minőségi besorolás) a CLS token beágyazást egy könnyű lineáris osztályozóba vagy 2 rétegű MLP fejbe táplálják, amely 768 dimenziót N kimeneti osztályra képez le. Sűrű előrejelzési feladatokhoz (pixel szintű repedés szegmentáció) a 196 folt token beágyazás egy 14x14-es térbeli rácsot alkot 768 dimenziós vektorokból. Ezt a rácsot egy szegmentációs fejen (általában egy könnyű konvolúciós dekóderen 1-3 réteggel) vezetik át, amely a 14x14-es jellemzőtérképet az eredeti 224x224-es felbontásra nagyítja fel. Minden pixel beágyazása összehasonlítható a hibaprototípusokkal koszinusz hasonlóság segítségével – a repedés prototípusokhoz közeli beágyazásokkal rendelkező foltokat (néhány példán keresztül meghatározva) hibaként jelölik meg.
Ez egy referenciabejegyzés. A TarmacView drónos ellenőrzési szolgáltatásokat nyújt, és nem árulja az ebben a szószedetben leírt felszereléseket vagy anyagokat.