Czym jest DINOv3 Vision Transformer?
DINOv3 Vision Transformer do Analizy Powierzchni Infrastruktury
Uczenie Samonadzorowane i DINO
Uczenie samonadzorowane (SSL) to paradygmat uczenia maszynowego, w którym model uczy się znaczących reprezentacji z nieoznaczonych danych poprzez zdefiniowanie zadania pretekstowego, które nie wymaga adnotacji ludzkich. Model musi przewidzieć część danych na podstawie innych części, wykorzystując nieodłączną strukturę i wzorce współwystępowania w samych danych. W wizji komputerowej metody SSL ewoluowały od ręcznie wykonanych zadań pretekstowych, takich jak przewidywanie kąta obrotu obrazu (RotNet), rozwiązywanie puzzli z przetasowanych fragmentów czy kolorowanie obrazów w skali szarości, do bardziej wyrafinowanych podejść opartych na kontrastowaniu i destylacji. Podstawową zaletą SSL jest to, że umożliwia trenowanie na ogromnych zbiorach danych z sieci bez wygórowanych kosztów ręcznej adnotacji. W przypadku zastosowań infrastrukturalnych, gdzie oznaczone zbiory danych o defektach są rzadkie i drogie w produkcji (wymagają certyfikowanych inspektorów i inżynierów), szkielety oparte na SSL umożliwiają efektywne uczenie się cech z ogromnych ilości nieoznaczonych obrazów przed jakimkolwiek dostrajaniem specyficznym dla zadania.
Ocena nawierzchni drogowych TarmacView jest w fazie aktywnego rozwoju i nie jest jeszcze oferowana.
Uczenie kontrastowe metody takie jak SimCLR, MoCo i SwAV uczą się reprezentacji poprzez przyciąganie do siebie w przestrzeni osadzeń powiększonych widoków tego samego obrazu (pary pozytywne), jednocześnie odpychając widoki różnych obrazów (pary negatywne). Metody te wymagają starannego doboru próbek negatywnych – zbyt mało negatywów pogarsza wydajność, zbyt wiele zwiększa koszt obliczeniowy. Metody niekontrastowe, takie jak BYOL, SimSiam i DINO, całkowicie unikają potrzeby stosowania par negatywnych, wykorzystując asymetryczne architektury sieci i operacje zatrzymania gradientu, aby zapobiec załamaniu reprezentacji. DINO (samodzielna destylacja bez etykiet), wprowadzony przez Carona i in. w Meta AI w 2021 roku, należy do tej niekontrastowej rodziny i stał się jedną z najbardziej wpływowych metod SSL w wizji komputerowej. Oryginalna praca DINO wykazała, że SSL i Transformery Wizyjne mają unikalną synergię – mechanizmy samouwagi w ViT w naturalny sposób generują mapy segmentacji semantycznej bez żadnego nadzoru, co jest właściwością wynikającą z interakcji między strategią augmentacji multi-crop a celem samodestylacji.
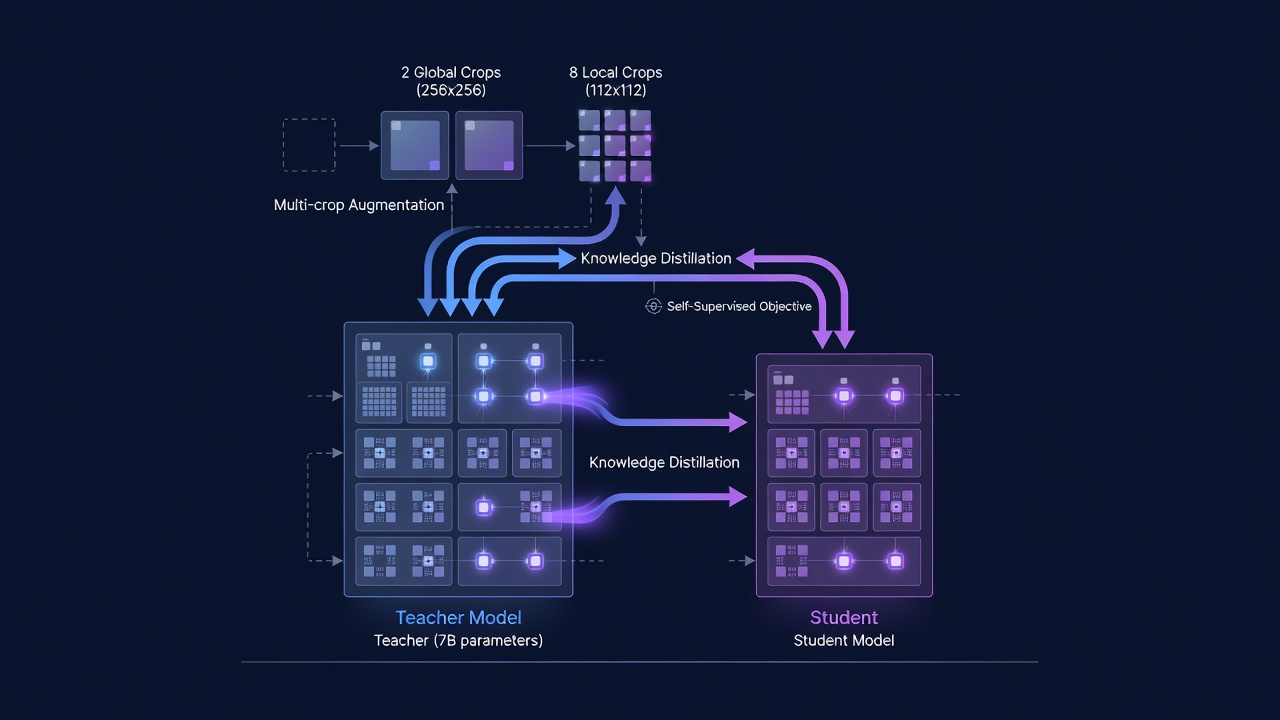
Ramy treningowe DINO działają w następujący sposób. Dla każdego obrazu wejściowego generowane są dwa widoki globalne (pokrywające ponad 50% obszaru obrazu, zazwyczaj 224x224 pikseli) oraz kilka widoków lokalnych (mniejsze przycięcia pokrywające mniej niż 50% obszaru obrazu, zazwyczaj 96x96 pikseli) poprzez losowe przycinanie ze zmianą rozmiaru, dithering kolorów i rozmycie Gaussa. Wszystkie widoki są przekazywane przez sieć ucznia (Transformer Wizyjny). Widoki globalne są również przekazywane przez sieć nauczyciela, która ma tę samą architekturę co uczeń, ale różne parametry. Parametry nauczyciela nie są uczone przez gradienty – zamiast tego są aktualizowane jako wykładnicza średnia ruchoma (EMA) parametrów ucznia. Podstawowym celem treningowym jest dopasowanie rozkładu wyjściowego ucznia do rozkładu wyjściowego nauczyciela dla widoków globalnych, podczas gdy widoki lokalne dostarczają dodatkowego sygnału treningowego tylko przez ucznia. Taka konfiguracja nauczyciel-uczeń, znana jako samodestylacja, tworzy sygnał uczący, który nie wymaga etykiet – uczeń uczy się generować spójne reprezentacje dla różnych augmentacji tego samego obrazu, co zmusza go do uchwycenia niezmiennej treści semantycznej, a nie powierzchownych szczegółów na poziomie pikseli.
DINOv1 (2021) wykazał trzy kluczowe emergentne właściwości samonadzorowanych ViT. Po pierwsze, mapy uwagi z tokena [CLS] do fragmentów obrazu w naturalny sposób segmentują obiekty od tła – właściwość, która pojawia się wyłącznie z samonadzoru, bez żadnych etykiet segmentacji. Po drugie, wyuczone cechy wykazują doskonałą wydajność klasyfikacji k-NN – prosty klasyfikator najbliższego sąsiada w przestrzeni cech DINO osiąga 78,2% dokładności top-1 na ImageNet bez żadnego dostrajania. Po trzecie, cechy DINO wykazują silną korespondencję semantyczną pomiędzy różnymi instancjami tej samej klasy obiektów, umożliwiając zastosowania w wyszukiwaniu obrazów, współsegmentacji i segmentacji obiektów wideo. Te właściwości uczyniły DINO fundamentalną metodą w krajobrazie uczenia samonadzorowanego i przygotowały grunt pod DINOv2 (2023) i DINOv3 (2025).
Architektura ViT
Architektura Vision Transformer (ViT), wprowadzona przez Dosovitskiy’ego i in. w Google w 2021 roku, adaptuje architekturę Transformera z przetwarzania języka naturalnego do wizji komputerowej, traktując fragmenty obrazu jako analogiczne do tokenów słów. W przeciwieństwie do konwolucyjnych sieci neuronowych (CNN), które przetwarzają obrazy przez lokalne pola recepcyjne z wbudowaną ekwiwariancją translacji, ViT stosują globalną samouwagę jednocześnie do wszystkich fragmentów, umożliwiając modelowi wychwytywanie zależności dalekiego zasięgu już od pierwszej warstwy. Ten wybór architektoniczny okazał się kluczowy dla sukcesu DINO – oryginalna praca DINO wykazała, że samonadzorowane ViT znacząco przewyższają samonadzorowane CNN, a synergia między samouwagi a samodestylacją odpowiada za emergentne właściwości segmentacji semantycznej.
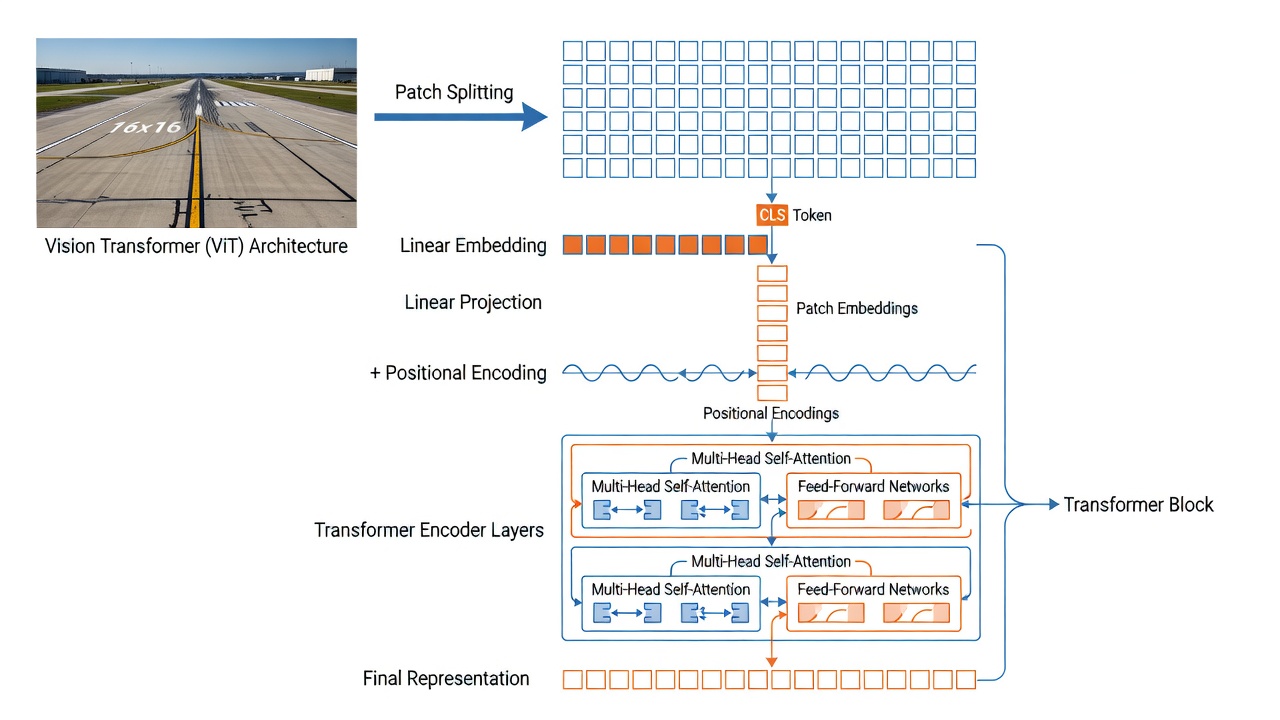
Osadzanie fragmentów. Pierwszą operacją w ViT jest podzielenie obrazu wejściowego na siatkę nienakładających się fragmentów. Dla wariantu ViT-B/16 rozmiar fragmentu wynosi 16x16 pikseli. Obraz wejściowy 224x224 pikseli generuje (224/16) x (224/16) = 14 x 14 = 196 fragmentów. Każdy fragment 16x16x3 (kanały RGB) jest spłaszczany do wektora o długości 768 (16x16x3). W praktyce to osadzanie fragmentów jest implementowane jako pojedyncza warstwa konwolucyjna z rozmiarem jądra równym rozmiarowi fragmentu (16x16) i krokiem równym rozmiarowi fragmentu, generując dwuwymiarową siatkę 14x14 wektorów cech, każdy o wymiarze równym ukrytemu rozmiarowi modelu (768 dla ViT-B). Uczona projekcja liniowa mapuje następnie każdy spłaszczony fragment do wymiaru osadzenia. Implementacja Conv2d jest wydajna obliczeniowo (jedna operacja zastępuje 196 oddzielnych projekcji liniowych) i jest standardem we wszystkich nowoczesnych implementacjach ViT.
Token [CLS]. Zgodnie z architekturą BERT w NLP, specjalny uczony token klasyfikacyjny ([CLS]) jest dodawany na początku sekwencji osadzeń fragmentów. Token [CLS] ma ten sam wymiar (768) co osadzenia fragmentów i jest inicjowany losowo. Podczas treningu, poprzez samouwagę we wszystkich warstwach transformera, token [CLS] agreguje informacje ze wszystkich fragmentów obrazu – może zwracać uwagę na każdy fragment w każdej warstwie, budując globalną reprezentację całego obrazu. Na wyjściu ostatniej warstwy transformera osadzenie tokena [CLS] służy jako reprezentacja na poziomie obrazu używana do zadań klasyfikacyjnych. W DINOv3 token [CLS] jest uzupełniony o 4 tokeny rejestrowe – dodatkowe uczone tokeny dodawane na początku sekwencji, które działają jak pamięć podręczna do absorbowania informacji odstających lub tła, zapobiegając zanieczyszczeniu tokenów [CLS] i fragmentów przez nieistotne szczegóły wysokiej częstotliwości.
Osadzenia pozycyjne. Ponieważ mechanizm samouwagi Transformera jest niezmienniczy względem permutacji (przetwarza fragmenty jako zbiór, a nie jako sekwencję), informacja pozycyjna musi być jawnie dodana, aby powiedzieć modelowi, gdzie każdy fragment znajduje się w siatce przestrzennej. DINOv3 używa obrotowych osadzeń pozycyjnych (RoPE) zamiast standardowych, uczonych absolutnych kodowań pozycyjnych stosowanych w DINOv2. RoPE koduje informację o względnej pozycji poprzez zastosowanie macierzy obrotu do wektorów zapytań i kluczy w samouwadze na podstawie ich współrzędnych przestrzennych. Częstotliwość obrotu dla każdego wymiaru jest określona przez indeks wymiaru, zgodnie z postępem geometrycznym. Kluczową zaletą RoPE dla analizy infrastruktury jest możliwość obsługi wejść o zmiennej rozdzielczości – podczas przetwarzania obrazów o wysokiej rozdzielczości (do 4096x4096 pikseli) mechanizm RoPE w naturalny sposób uogólnia się na większą siatkę przestrzenną bez konieczności interpolacji wyuczonych osadzeń pozycyjnych. DINOv3 wprowadza również losowy dithering ramki podczas stosowania RoPE, gdzie indeksy pozycji są losowo przesuwane w zakresie [-s,s] z s w [0.5,2.0], co czyni model odpornym na różne proporcje i wzorce przycinania.
Samouwaga wielogłowicowa (MHSA). Podstawowym prymitywem obliczeniowym ViT jest mechanizm samouwagi wielogłowicowej. W każdym bloku transformera sekwencja wejściowa N tokenów (N = 1 [CLS] + 4 rejestrowe + 196 fragmentów = 201 tokenów dla wejścia 224x224) jest rzutowana liniowo na trzy macierze: Zapytania (Q) , Klucze (K) i Wartości (V) , każda o wymiarze 768 dla ViT-B/16. Mechanizm uwagi oblicza podobieństwo parami między wszystkimi tokenami jako iloczyn skalarny Q i K^T, skalowany przez pierwiastek kwadratowy z d_k (gdzie d_k to wymiar klucza na głowicę). Wynikowe wagi uwagi (znormalizowane przez softmax) określają, w jakim stopniu każdy token przyczynia się do reprezentacji każdego innego tokena. W ViT-B/16 istnieje 12 głowic uwagi, z których każda działa w 64-wymiarowej podprzestrzeni (768/12 = 64). Uwaga wielogłowicowa pozwala modelowi jednocześnie zwracać uwagę na różne typy relacji – na przykład jedna głowica może skupić się na podobieństwie tekstury między fragmentami, inna na bliskości przestrzennej, a jeszcze inna na przynależności do kategorii semantycznej. Wyjścia wszystkich głowic są łączone i rzutowane liniowo z powrotem do 768 wymiarów. Złożoność obliczeniowa MHSA wynosi O(N2d) – kwadratowa względem długości sekwencji N, ale liniowa względem wymiaru osadzenia d. Dla sekwencji 201 tokenów w DINOv3 ViT-B/16 jest to do opanowania (około 40 000 obliczeń uwagi na warstwę), ale dla obrazów o wysokiej rozdzielczości z 4000+ tokenami (np. obraz 1024x1024 generuje 64x64 = 4096 fragmentów) kwadratowe skalowanie staje się znaczącym czynnikiem.
Blok enkodera Transformera. Każda z 12 (ViT-B) lub 40 (ViT-7B) warstw transformera w DINOv3 jest zgodna z projektem pre-normalizacji. Normalizacja warstwowa (LayerNorm) jest stosowana przed podwarstwami MHSA i MLP, z połączeniami resztkowymi omijającymi każdą podwarstwę. Podwarstwa MLP (multilayer perceptron) składa się z dwóch warstw liniowych z aktywacją GELU (Gaussian Error Linear Unit) pomiędzy nimi. Dla ViT-B/16 ukryty wymiar MLP wynosi 3072 (4x wymiar osadzenia), co daje konfigurację: Wymiar osadzenia 768 do ukrytego MLP 3072 do GELU do wyjścia MLP 768. Większy model nauczyciela DINOv3 (ViT-7B) używa aktywacji SwiGLU (Swish-Gated Linear Unit) w MLP zamiast GELU, zgodnie z nowoczesnymi trendami architektury dużych modeli językowych. SwiGLU stosuje mechanizm bramkowania: wyjście = (xW1) pomnożone elementowo przez Swish(xW2) razy W3. Ta bramkowana aktywacja wykazała poprawę stabilności treningu i końcowej wydajności przy skali. Projekt pre-normalizacji różni się od oryginalnej post-normalizacji Transformera (gdzie normalizacja była stosowana po dodaniu resztkowym) i wykazał bardziej stabilny trening, szczególnie dla głębokich (12+ warstw) transformerów.
Tabela podsumowująca architekturę dla rodziny modeli DINOv3.
| Model | Parametry | Wymiar osadzenia | Głowice | Warstwy | Wymiar MLP | Rozmiar fragmentu | Fragmenty/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1.5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
Architektura ViT-Base (86M parametrów) jest optymalnym kompromisem między jakością cech a wydajnością obliczeniową dla potoków inspekcji infrastruktury, oferując 768-wymiarowe osadzenia z 12 warstwami mocy obliczeniowej samouwagi.
Trening DINOv3 na 1,7 Miliarda Obrazów
DINOv3 osiąga swoją najwyższą wydajność dzięki bezprecedensowej skali treningu samonadzorowanego, wykorzystując zarówno masową kuratorię danych, jak i efektywną optymalizację rozproszoną na setkach GPU.
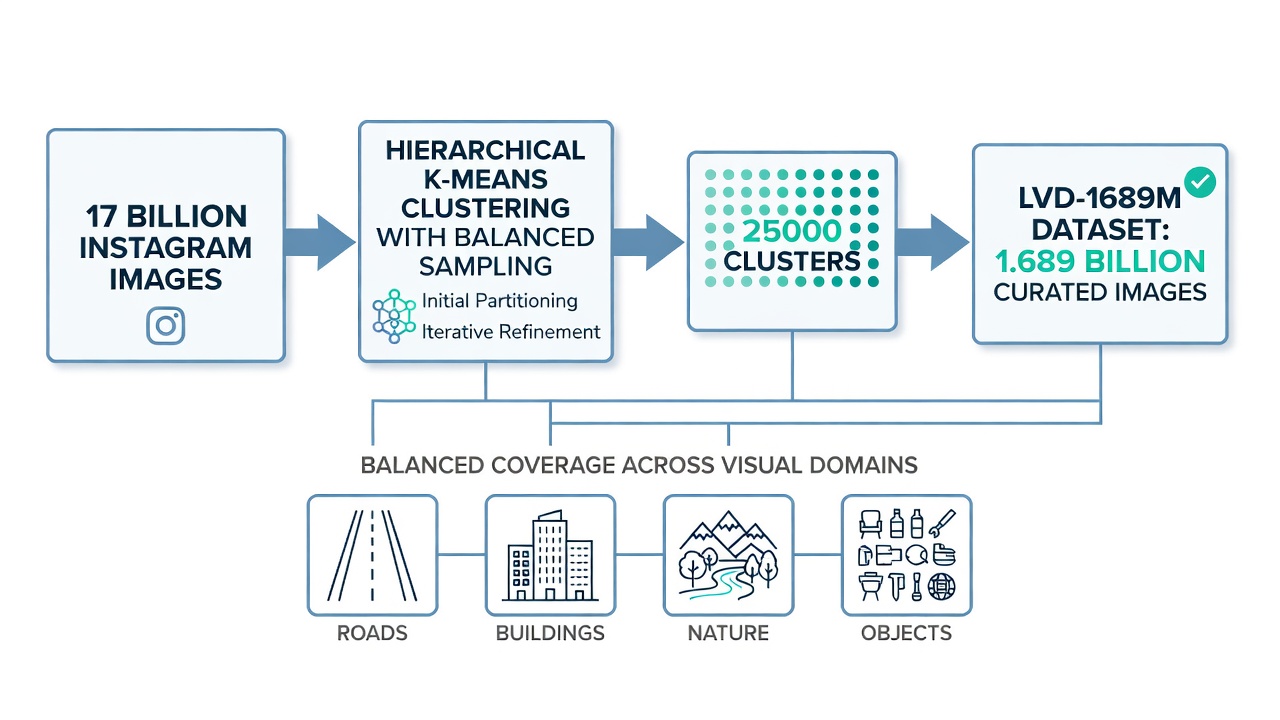
Zbiór danych LVD-1689M. Dane treningowe dla DINOv3 zaczynają się od surowej puli 17 miliardów obrazów z Instagrama z moderacją treści. Z tej ogromnej puli zespół Meta AI wyselekcjonował zrównoważony podzbiór 1,689 miliona obrazów nazwany LVD-1689M (Large Visual Dataset 1689 Million). Potok kuratorii jest krytyczny, ponieważ proste trenowanie na surowych danych z Instagrama dałoby model obciążony w kierunku naturalnego rozkładu częstotliwości koncepcji wizualnych w mediach społecznościowych – na przykład twarze, jedzenie i krajobrazy dominowałyby, podczas gdy infrastruktura, obrazy przemysłowe i naukowe byłyby niedoreprezentowane. Proces kuratorii wykorzystuje hierarchiczne grupowanie k-średnich na osadzeniach DINOv2 wyodrębnionych z pełnej puli obrazów. Model DINOv2 ViT-H/14 przetwarza każdy obraz, a wynikowe osadzenia tokena CLS są grupowane w 25 000 klastrów przy użyciu k-średnich. Następnie z każdego klastra próbkowana jest równa liczba obrazów, co daje zbiór danych zrównoważony względem klastrów, zapewniający proporcjonalną reprezentację w różnych domenach wizualnych. To zrównoważone próbkowanie jest bezpośrednio analogiczne do próbkowania warstwowego w statystyce – kontrolując przynależność do klastra, zbiór danych wychwytuje pełną różnorodność koncepcji wizualnych, zamiast nadreprezentować typowe kategorie. Po grupowaniu dodatkowy krok wyszukiwania rozszerza zbiory nasion z wyselekcjonowanych zbiorów danych (ImageNet-1k, ImageNet-22k, Google Landmarks i zbiory danych do klasyfikacji drobnoziarnistej) poprzez znalezienie najbliższych sąsiadów w przestrzeni osadzeń DINOv2. Ostateczny zbiór danych LVD-1689M łączy 1,489 miliona obrazów zrównoważonych względem klastrów z 200 milionami obrazów rozszerzonych przez wyszukiwanie, wszystkie przefiltrowane przez wykrywanie NSFW, deduplikację PCA hash i rozmycie twarzy.
Konfiguracja treningowa. Model nauczyciela ViT-7B, największy kiedykolwiek wytrenowany samonadzorowany model wizyjny (stan na 2025 rok), został wytrenowany na 256 kartach NVIDIA GPU (A100 80GB SXM4) z rozmiarem partii 4096 (16 obrazów na GPU). Optymalizacja wykorzystuje optymalizator AdamW ze stałą szybkością uczenia 4x10^-4, zanikiem wagi 0,04 i pędem EMA 0,999 po 100 000-krokowym okresie rozgrzewki. Trening trwa 1 milion iteracji ze strategią multi-crop: 2 globalne przycięcia w rozdzielczości 256x256 i 8 lokalnych przycięć w rozdzielczości 112x112, co daje łącznie 10 widoków na obraz na iterację. Przez 1M iteracji z rozmiarem partii 4096 model widzi około 2,56 miliarda unikalnych kombinacji obraz-przycięcie. Cały proces treningowy pochłania szacunkowo 10 000-15 000 GPU-dni mocy obliczeniowej. Podczas treningu 10% partii stanowią jednorodne pobrania z ImageNet-1k (w celu utrzymania wydajności na standardowych benchmarkach), podczas gdy 90% to heterogeniczne pobrania z pełnej puli LVD-1689M, co jest optymalnym stosunkiem mieszania wykazanym przez ablację.
Cele treningowe. Strata przedtreningowa DINOv3 łączy trzy komponenty. Strata DINO (L_DINO) stosuje klasteryzację w stylu SwAV Sinkhorn-Knopp do wyjść tokena [CLS] z globalnych przycięć, dopasowując przypisania prototypów między uczniem a nauczycielem. Algorytm Sinkhorn wykonuje 3 iteracje, aby wygenerować miękkie pseudo-etykiety. Strata iBOT (L_iBOT) działa na poziomie fragmentów – losowe fragmenty w lokalnych przycięciach są maskowane, a uczeń musi przewidzieć znormalizowane cechy fragmentów nauczyciela dla tych zamaskowanych pozycji. Ten cel maskowanego modelowania obrazu zmusza model do uczenia się lokalnych informacji o teksturze i strukturze niezbędnych do zadań gęstej predykcji. Regularyzator Koleo (L_Koleo) rozprasza osadzenia tokena [CLS] równomiernie po hipersferze, minimalizując sumę podobieństw cosinusowych między wszystkimi parami osadzeń w partii, zapobiegając załamaniu reprezentacji i zapewniając dobre wykorzystanie przestrzeni cech. Połączona strata przedtreningowa wynosi: L_Pre = L_DINO + L_iBOT + 0,1 x L_Koleo. Po 1M iteracjach wstępnego treningu faza udoskonalania 200 000 dodatkowych iteracji włącza stratę kotwicowania Gram (L_Gram) z wagą 2, która zachowuje jakość gęstych cech podczas długiego treningu.
Destylacja do mniejszych modeli. Gdy model nauczyciela ViT-7B jest w pełni wytrenowany, jest zamrażany i używany jako cel do destylacji reprezentacji do zestawu mniejszych, bardziej praktycznych modeli. Proces destylacji odzwierciedla konfigurację przedtreningową: modele uczniów (ViT-S, ViT-B, ViT-L, ViT-H+, warianty ConvNeXt) są trenowane, aby dopasować cechy wyjściowe nauczyciela przy użyciu tej samej funkcji straty (L_DINO + L_iBOT + 0,1 x L_Koleo), ale z zamrożonym nauczycielem i pominiętą aktualizacją EMA nauczyciela. Meta AI implementuje destylację wielouczniową, która efektywnie trenuje wiele modeli uczniów jednocześnie – nauczyciel przetwarza każdy obraz raz, a wszyscy uczniowie otrzymują te same wyjścia nauczyciela, co pozwala na zrównoleglenie obliczeń straty partii między uczniami. Zmniejsza to całkowity koszt obliczeniowy produkcji pełnej rodziny modeli o około 60% w porównaniu z destylacją każdego ucznia sekwencyjnie. Uczeń ViT-Base (86M parametrów) osiąga 98,7% dokładności liniowej sondy nauczyciela ViT-7B na ImageNet-1k, wymagając około 80 razy mniej FLOPs do wnioskowania.
768-Wymiarowe Osadzenia
768-wymiarowe osadzenie generowane przez DINOv3 ViT-B/16 dla każdego tokena (1 CLS + 4 rejestrowe + 196 fragmentów = 201 łącznie) reprezentuje gęste numeryczne kodowanie informacji wizualnej w wielowymiarowej przestrzeni wektorowej. Każdy wymiar wychwytuje określoną koncepcję wizualną lub cechę, a kombinacja wszystkich 768 wartości tworzy unikalny sygnaturę dla tego regionu obrazu. Wymiar 768 nie jest arbitralny – wynika z architektury ViT-Base, gdzie ukryty wymiar jest ustawiony na 768, zapewniając wystarczającą pojemność do kodowania złożonych wzorców wizualnych, pozostając jednocześnie obliczeniowo łatwym do opanowania. Dla porównania, ViT-Small używa 384 wymiarów, ViT-Large używa 1024, a ViT-7B używa 4096.
Osadzenie tokena CLS. 768-wymiarowe osadzenie tokena [CLS] na wyjściu 12. warstwy transformera koduje globalną treść obrazu – ogólną scenę, dominujące obiekty i kontekst semantyczny. To osadzenie jest wyodrębniane i używane do zadań klasyfikacji na poziomie obrazu. W typowym potoku osadzenie CLS jest przekazywane przez lekki klasyfikator liniowy (768 do N klas, gdzie N to liczba typów nawierzchni lub ocen jakości) wytrenowany na oznaczonych zbiorach danych infrastruktury. Osadzenie CLS z DINOv3 wykazuje silne właściwości generalizacji domenowej – modele wytrenowane na tym osadzeniu generalizują na niewidziane typy infrastruktury znacznie lepiej niż osadzenia z nadzorowanych szkieletów. Dokładność liniowej sondy DINOv3 ViT-B/16 na ImageNet-1k osiąga 85,1% dokładności top-1, przewyższając DINOv2 (83,5%) i zbliżając się do nadzorowanego ViT (86,0%), mimo że nigdy nie widział żadnych etykiet ImageNet podczas wstępnego treningu.
Osadzenia tokenów fragmentów. Każdy z 196 tokenów fragmentów generuje oddzielne 768-wymiarowe osadzenie, tworząc siatkę przestrzenną 14x14 wektorów cech. Te gęste osadzenia kodują zlokalizowaną informację wizualną w obrębie każdego fragmentu 16x16 pikseli – teksturę, krawędzie, rozkład kolorów i lokalne wzorce. Osadzenia fragmentów są krytycznym wyjściem dla zadań gęstej predykcji, takich jak wykrywanie i segmentacja pęknięć. W potoku analizy infrastruktury siatka cech 14x14 x 768-wymiarowa (około 1,5 miliona wartości zmiennoprzecinkowych na obraz) jest przetwarzana przez lekki dekoder konwolucyjny, który próbkuje w górę do 224x224 i generuje predykcje dla każdego piksela. Każde osadzenie fragmentu można interpretować jako 768-wymiarowy opis tego, jak wygląda ten region 16x16 – dwa fragmenty o podobnym wyglądzie wizualnym (np. dwa obszary gładkiego asfaltu) będą miały bliskie osadzenia w 768-wymiarowej przestrzeni (wysokie podobieństwo cosinusowe), podczas gdy wizualnie różne fragmenty (np. asfalt vs. beton) będą miały odległe osadzenia (niskie podobieństwo cosinusowe).
Właściwości osadzeń. Osadzenia DINOv3 wykazują kilka właściwości, które czynią je wyjątkowymi do analizy infrastruktury. Po pierwsze, gładkość semantyczna – wizualnie podobne regiony generują bliskie osadzenia, tworząc ciągłą rozmaitość w 768-wymiarowej przestrzeni. Oznacza to, że pęknięcia o różnej szerokości, orientacji i nasileniu mapują się do połączonego regionu przestrzeni osadzeń, co czyni je wykrywalnymi jako spójna klasa, a nie jako izolowane wartości odstające. Po drugie, czułość wieloskalowa – mechanizm samouwagi w 12 warstwach transformera integruje informacje w różnych skalach przestrzennych, więc każde osadzenie fragmentu jest informowane nie tylko przez własną treść 16x16, ale także przez szerszy kontekst otaczających fragmentów i globalną scenę. Pęknięcie w pobliżu dylatacji jest kodowane inaczej niż to samo pęknięcie w środku płyty, ponieważ informacja kontekstowa jest zintegrowana z osadzeniem. Po trzecie, odporność na oświetlenie – samonadzorowany trening z rozległym ditheringiem kolorów i augmentacją zapewnia, że osadzenia są stabilne w zmiennych warunkach oświetleniowych, cieniu i ekspozycji. Jest to kluczowe dla inspekcji infrastruktury na zewnątrz, gdzie obrazy są rejestrowane w niekontrolowanym naturalnym oświetleniu. Po czwarte, liniowa separowalność – osadzenia są ustrukturyzowane w taki sposób, że proste klasyfikatory liniowe mogą skutecznie oddzielać różne stany powierzchni. Liniowe sondy na zamrożonych osadzeniach DINOv3 są powszechnym lekkim punktem odniesienia dla klasyfikacji typu nawierzchni i wykrywania pęknięć.
Metryki odległości w przestrzeni osadzeń. Wybór metryki odległości do porównywania osadzeń DINOv3 znacząco wpływa na wydajność zadań końcowych. Podobieństwo cosinusowe jest najczęściej używaną metryką, zdefiniowaną jako cos(theta) = (a dot b) / (||a|| x ||b||), gdzie a i b to 768-wymiarowe wektory osadzeń. Podobieństwo cosinusowe waha się od -1 (przeciwny kierunek, mało prawdopodobne dla osadzeń wizualnych) do +1 (identyczny kierunek). Dwa 768-wymiarowe wektory o podobieństwie cosinusowym większym niż 0,9 są wizualnie prawie identyczne pod względem lokalnej treści, podczas gdy podobieństwo mniejsze niż 0,5 wskazuje na zasadniczo różną treść wizualną. Odległość L2 (euklidesowa) jest również używana, ale wymaga starannej normalizacji, ponieważ bezwzględna skala osadzeń może się różnić. Podobieństwo iloczynu skalarnego jest wydajne, ale wrażliwe na wielkość wektora. Podobieństwo cosinusowe jest zwykle podstawową metryką odległości do wyszukiwania i dopasowywania defektów, ponieważ normalizuje wielkość osadzenia i skupia się wyłącznie na wyrównaniu kierunkowym, które jest bardziej odporne na zmiany kontrastu i ekspozycji obrazu.
Redukcja wymiarowości do wizualizacji. 768-wymiarowa przestrzeń osadzeń nie może być bezpośrednio zwizualizowana, dlatego analiza głównych składowych (PCA) jest powszechnie stosowana w celu zredukowania osadzeń fragmentów do 3 wymiarów do celów wizualizacji i zapewnienia jakości. Pierwsze trzy główne składowe osadzeń fragmentów DINOv3 na obrazach infrastruktury zazwyczaj wychwytują 45-55% całkowitej wariancji (PC1 około 25%, PC2 około 15%, PC3 około 10%), co wskazuje, że efektywna wewnętrzna wymiarowość fragmentów powierzchni jest znacznie niższa niż 768. Wizualizacja PCA konsekwentnie pokazuje odrębne klastry dla różnych materiałów powierzchni (asfalt, beton, uszczelnienie kruszywowe, żwir) i ciągłe gradienty dla stopnia pogorszenia nawierzchni (od nieskazitelnej do silnie spękanej). Ta możliwość wizualnego potwierdzenia jest krytycznym narzędziem zapewnienia jakości – inżynierowie infrastruktury mogą wizualnie sprawdzić przestrzeń osadzeń, aby zweryfikować, że model prawidłowo oddziela odpowiednie stany powierzchni przed poleganiem na zautomatyzowanej klasyfikacji.
DINOv3 vs DINOv2
Ewolucja od DINOv2 do DINOv3 reprezentuje kompleksowe skalowanie i udoskonalenie paradygmatu samonadzorowanego treningu wizyjnego. Zrozumienie różnic jest niezbędne dla praktyków wybierających odpowiedni szkielet do swojego zastosowania.
Skala danych treningowych. Najbardziej widoczną różnicą jest 12-krotny wzrost danych treningowych: LVD-142M DINOv2 (142 miliony obrazów) w porównaniu z LVD-1689M DINOv3 (1,689 miliarda obrazów). Jednak metodologia kuratorii również uległa poprawie. DINOv2 używał potoku opartego na wyszukiwaniu, który rozszerzał wyselekcjonowane zbiory nasion poprzez znajdowanie najbliższych sąsiadów w przestrzeni osadzeń ViT-H/16 wstępnie wytrenowanego na ImageNet-22k. Ekspansja rozpoczęła się od 1,2 miliarda surowych obrazów z sieci i wyprodukowała 142M wyselekcjonowanych obrazów. DINOv3 dodaje krok równoważenia oparty na grupowaniu na wierzchu wyszukiwania, zapewniając, że 25 000 klastrów wizualnych jest równo reprezentowanych. Ten krok grupowania zapobiega nadreprezentowaniu przez model wizualnie dominujących koncepcji, takich jak twarze, tekst i typowe obiekty, przy jednoczesnym niedoreprezentowaniu rzadkich, ale ważnych domen wizualnych, takich jak defekty infrastruktury, obrazy medyczne i widoki satelitarne.
Rozmiar i architektura modelu. Największy model nauczyciela DINOv2 to ViT-g z 1 miliardem parametrów. DINOv3 skaluje to do 7 miliardów parametrów (ViT-7B) – 7-krotny wzrost pojemności modelu. Sama architektura została zmodernizowana. DINOv2 używał standardowych, uczonych absolutnych osadzeń pozycyjnych, podczas gdy DINOv3 wprowadza obrotowe osadzenia pozycyjne (RoPE) dla obsługi zmiennej rozdzielczości. Sieć feed-forward w ViT-7B DINOv3 używa aktywacji SwiGLU zamiast GELU, zgodnie z innowacjami architektonicznymi z dużych modeli językowych. DINOv2 używał rozmiaru fragmentu 14 pikseli (architektura ViT z oryginalnej pracy), podczas gdy DINOv3 używa rozmiaru fragmentu 16 pikseli. Ta zmiana zmniejsza liczbę fragmentów z 256 (224/14 = 16, 16^2 = 256) do 196 (224/16 = 14, 14^2 = 196) dla wejścia 224x224, co stanowi 23% redukcję długości sekwencji, co przekłada się na około 40% mniej obliczeń samouwagi (ponieważ uwaga skaluje się jak O(N2)). Ten zysk wydajności architektonicznej częściowo rekompensuje zwiększony koszt obliczeniowy wynikający z większych wymiarów modelu.
Jakość gęstych cech. Jest to najważniejsza jakościowa poprawa w DINOv3. Podczas długich harmonogramów treningowych z dużymi modelami zaobserwowano, że cechy na poziomie fragmentów DINOv2 degradują się postępująco po pewnym punkcie treningu – mapy cech na poziomie pikseli traciły strukturę przestrzenną i stawały się zaszumione lub rozmyte, podczas gdy globalne cechy tokena [CLS] nadal się poprawiały. Ta degradacja czyniła DINOv2 mniej odpowiednim do zadań gęstej predykcji, takich jak segmentacja semantyczna i estymacja głębokości, przy użyciu długich harmonogramów treningowych. Mechanizm kotwicowania Gram DINOv3 bezpośrednio rozwiązuje ten problem, wymuszając, aby struktura podobieństwa parami między cechami fragmentów pozostawała stabilna przez cały trening. W rezultacie gęste cechy DINOv3 pozostają ostre i znaczące semantycznie nawet po milionach iteracji treningowych. Na benchmarku segmentacji semantycznej ADE20K DINOv3 osiąga średnie Intersection over Union (mIoU) na poziomie 54,2% z zamrożonym szkieletem i liniową sondą – poprawa o +6,1 punktu w porównaniu z 48,1% mIoU DINOv2. Na benchmarku dopasowywania kluczowych punktów 3D NAVI DINOv3 osiąga 68,5% precyzji w porównaniu z 60,2% DINOv2. W segmentacji obiektów wideo (DAVIS 2017) DINOv3 osiąga 82,3 J&F-Mean w porównaniu z 75,6 DINOv2.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Poprawa |
|---|---|---|---|---|
| ImageNet-1k Linear Probe | 83,5% | 85,1% | 86,7% | +1,6/+3,2 |
| ADE20K Semantic Seg. (mIoU) | 48,1% | 52,3% | 54,2% | +4,2/+6,1 |
| DAVIS 2017 (J&F-Mean) | 75,6 | 79,4 | 82,3 | +3,8/+6,7 |
| Instance Retrieval (GAP) | 42,1 | 46,8 | 53,0 | +4,7/+10,9 |
| NYU Depth (RMSE down) | 0,458 | 0,412 | 0,389 | -0,046/-0,069 |
| ObjectNet (Top-1) | 72,3% | 75,8% | 78,2% | +3,5/+5,9 |
Powyższa tabela pokazuje, że model ViT-Base DINOv3 (86M parametrów) już przewyższa znacznie większy model ViT-Large DINOv2 (304M parametrów) na każdym benchmarku, będąc jednocześnie 3,5 razy mniejszym i znacznie bardziej wydajnym obliczeniowo do wnioskowania.
Różnice w licencjonowaniu. DINOv2 został wydany na licencji Apache 2.0, standardowej licencji open source, która zezwala na bezpłatne użytkowanie, modyfikację i dystrybucję w dowolnym celu, w tym w zastosowaniach komercyjnych. DINOv3 jest wydany na licencji DINOv3, niestandardowej licencji specyficznej dla wydania modelu Meta AI. Podczas gdy licencja DINOv3 zezwala na użytek komercyjny, zawiera dodatkowe warunki dotyczące atrybucji i dozwolonego użytku. Niestandardowa licencja wywołała dyskusję w społeczności open source – zgłoszenie GitHub #31 w repozytorium dinov3 konkretnie prosi o wydanie na bardziej standardowej licencji, takiej jak Apache 2.0. Praktycy powinni zapoznać się z pełnym tekstem LICENSE.md w repozytorium GitHub przed wdrożeniem DINOv3 w produktach komercyjnych. Licencja DINOv3 zezwala na zastosowania komercyjne, takie jak inspekcja infrastruktury, z odpowiednią atrybucją.
Dostrajanie DINOv3 do Zadań Domenowych
Podczas gdy DINOv3 osiąga najwyższą wydajność z zamrożonym szkieletem (liniowa sonda lub klasyfikator k-NN), niektóre zastosowania infrastrukturalne korzystają z dostrojenia szkieletu na danych specyficznych dla domeny. Wybór między podejściem zamrożonym a dostrojonym zależy od rozmiaru zbioru danych, specyfiki zadania i budżetu obliczeniowego.
Zamrożony szkielet (sondowanie liniowe). Najprostszym i najbardziej wydajnym obliczeniowo podejściem jest zamrożenie wag DINOv3 i trenowanie tylko klasyfikatora liniowego na wyodrębnionych osadzeniach. Dla modelu ViT-B/16 generującego 768-wymiarowe osadzenia CLS, klasyfikator liniowy składa się z dokładnie 768 x N parametrów, gdzie N to liczba klas wyjściowych. Dla 5-klasowego zadania klasyfikacji typu nawierzchni jest to tylko 768 x 5 = 3 840 parametrów do trenowania – trening zbiega się w minutach na CPU i wymaga zaledwie 50 oznaczonych przykładów na klasę, aby osiągnąć dobre wyniki. Podejście z zamrożonym szkieletem jest zalecane, gdy domena docelowa jest dobrze pokryta przez dane przedtreningowe DINOv3, które obejmują obrazy naturalne, obrazy z sieci i różnorodne domeny wizualne. Do analizy powierzchni infrastruktury zamrożone osadzenia DINOv3 z liniową sondą są powszechnym punktem wyjścia do klasyfikacji typu nawierzchni (asfalt, beton, kompozyt, uszczelnienie kruszywowe, żwir). Kluczową zaletą jest to, że szkielet DINOv3 zapewnia uniwersalne cechy wizualne, które generalizują się między domenami bez żadnego treningu specyficznego dla domeny.
Lekkie dostrajanie (Adapter / LoRA). W przypadku zadań, w których zamrożony szkielet nie osiąga wystarczającej dokładności – zazwyczaj wysoce wyspecjalizowanych domen z cechami wizualnymi znacząco różniącymi się od obrazów naturalnych – parametrooszczędne dostrajanie (PEFT) dodaje małą liczbę parametrów do trenowania, utrzymując większość szkieletu zamrożoną. Adaptacja niskiego rzędu (LoRA) dodaje pary macierzy dekompozycji rzędu (A i B, gdzie aktualizacja wagi delta_W = AB) do macierzy zapytań i wartości w każdej warstwie samouwagi. Dla modelu ViT-B/16 LoRA z rzędem r=8 dodaje około 0,5M parametrów do trenowania (mniej niż 0,6% z 86M łącznie) rozłożonych na wszystkich 12 warstwach transformera. Trenowanie tylko tych parametrów LoRA przez 10-50 epok na zbiorze danych specyficznym dla domeny składającym się z 1 000-5 000 oznaczonych obrazów zazwyczaj daje 3-8% poprawę dokładności w porównaniu z sondowaniem liniowym, wymagając przy tym tylko 1-2 godzin na pojedynczym GPU. Dostrajanie LoRA nadaje się do specjalistycznych zadań klasyfikacji defektów, takich jak rozróżnianie różnych typów pęknięć (poprzeczne, podłużne, blokowe, aligatorowe, odbiciowe), gdzie subtelne różnice wizualne korzystają z adaptacji specyficznej dla domeny.
Pełne dostrajanie. Gdy dostępna jest wystarczająca ilość oznaczonych danych (10 000+ obrazów na klasę), a zadanie wymaga maksymalnej dokładności, można dostroić cały szkielet DINOv3. Aktualizuje to wszystkie 86M parametrów ViT-B/16 przy użyciu oznaczonego zbioru danych. Pełne dostrajanie zazwyczaj wymaga 4-8 GPU z 16-32 GB VRAM każdy, rozproszonego treningu z PyTorch DDP i starannego dostrojenia hiperparametrów (szybkość uczenia zazwyczaj 5x10^-6 do 5x10^-5, zanik wagi 0,01-0,1, cosinusowy harmonogram szybkości uczenia z 10% rozgrzewką). Pełne dostrajanie może dać dodatkowe 2-5% dokładności w porównaniu z LoRA w wysoce wyspecjalizowanych zadaniach, ale niesie ryzyko katastroficznego zapominania – model może utracić ogólną wiedzę wizualną nabytą podczas samonadzorowanego wstępnego treningu. Aby to złagodzić, zaleca się stopniowe odmrażanie (najpierw odmrożenie ostatniej warstwy, potem stopniowo wcześniejszych) i dyskryminację szybkości uczenia (niższe szybkości uczenia dla wcześniejszych warstw, wyższe dla późniejszych). DINOv3 sugeruje również protokół adaptacji do wysokiej rozdzielczości podczas dostrajania: kontynuowanie treningu przez 10K kroków na mieszanych rozmiarach globalnych przycięć przy użyciu straty iBOT i kotwicowania Gram, co zapewnia, że szkielet generalizuje się ze standardowej rozdzielczości 224px do bardzo wysokich rozdzielczości (4096px), generując ostre mapy cech.
Macierz decyzyjna: Zamrażanie vs Dostrajanie.
| Scenariusz | Rozmiar zbioru danych | Zalecane podejście | Czas treningu | Oczekiwana dokładność vs Zamrożony |
|---|---|---|---|---|
| Klasyfikacja typu nawierzchni | 50-200 obrazów/klasę | Zamrożony + liniowa sonda | mniej niż 1 godzina CPU | Punkt odniesienia |
| Klasyfikacja typu pęknięć | 500-5 000 obrazów | LoRA (rząd 8-16) | 1-4 godziny GPU | +3-8% |
| Ocena stopnia defektu | 5 000-20 000 obrazów | LoRA lub częściowe dostrajanie | 4-12 godzin GPU | +5-12% |
| Wykrywanie nowych defektów | 10 000+ obrazów | Pełne dostrajanie | 1-3 dni multi-GPU | +8-15% |
Uwagi dotyczące adaptacji domenowej. Obrazy z inspekcji infrastruktury różnią się od obrazów naturalnych pod kilkoma względami: stałe kąty kamery (perspektywa nadiru/drona), specyficzne warunki oświetleniowe (na zewnątrz, ale zmienne), powtarzalne wzory (tekstura nawierzchni) i wąska domena wizualna (drogi, pasy startowe, pokłady mostów). Samonadzorowany wstępny trening DINOv3 na różnorodnych danych oznacza, że widział już wiele podobnych wzorców wizualnych, ale luka domenowa między obrazami z sieci a obrazami infrastruktury nadal istnieje. Zamrożone osadzenia DINOv3 często dobrze przenoszą się na obrazy nawierzchni bez żadnego dostrajania. Jednak w przypadku wykrywania wyspecjalizowanych defektów, takich jak przesunięcia spoin w nawierzchniach betonowych lub wykruszanie w nakładkach asfaltowych, dostrajanie LoRA z 2 000-5 000 oznaczonych przykładów z domeny docelowej poprawia wynik F1 o 5-8 punktów procentowych. Dostrojony model wykazuje również lepszą odporność na artefakty specyficzne dla domeny, takie jak ślady opon, osady gumy i oznakowanie pasa startowego, które mogą mylić ogólne, wstępnie wytrenowane cechy.
DINOv3 jako Ekstraktor Cech
Używanie DINOv3 jako ekstraktora cech jest najbardziej bezpośrednim i szeroko stosowanym wzorcem wdrożenia, szczególnie dla organizacji, które nie mają zasobów obliczeniowych do trenowania na dużą skalę. W tym paradygmacie DINOv3 przetwarza każdy obraz przez pojedyncze przejście w przód, generując osadzenia, które są buforowane i ponownie używane do wielu zadań końcowych.
Potok ekstrakcji cech. Standardowy potok ekstrakcji cech DINOv3 w przepływie pracy analizy infrastruktury działa w następujący sposób. Po pierwsze, obraz wejściowy (zazwyczaj obraz z drona 4K pokrywający odcinek pasa startowego 10m x 7m) jest dzielony na nakładające się kafelki 224x224 z 50% nakładaniem, aby zapewnić pokrycie krawędzi. Każdy kafelek jest normalizowany przy użyciu średniej ImageNet (0,485, 0,456, 0,406) i odchylenia standardowego (0,229, 0,224, 0,225). Znormalizowany kafelek jest przepuszczany przez model DINOv3 ViT-B/16 przy użyciu PyTorch z precyzją FP16 dla wydajności pamięciowej. Model generuje 201 tokenów (1 CLS + 4 rejestrowe + 196 fragmentów), każdy o wymiarze 768. Osadzenie tokena CLS (768-wymiarowe) jest wyodrębniane do globalnej klasyfikacji kafelka. 196 osadzeń tokenów fragmentów jest przekształcanych w siatkę przestrzenną 14x14 768-wymiarowych wektorów do gęstej predykcji. Wszystkie osadzenia ze wszystkich kafelków są agregowane w bazie danych cech indeksowanej według współrzędnych przestrzennych, umożliwiając analizę między kafelkami i mapowanie dużych obszarów.
Wydajność obliczeniowa. Ekstrakcja cech z zamrożonym DINOv3 ViT-B/16 wymaga około 12,5 GFLOPs na obraz 224x224 – porównywalne z ResNet-50 (7,7 GFLOPs) lub EfficientNet-B4 (12,0 GFLOPs). Na NVIDIA RTX 4090 (FP16) przepustowość wnioskowania wynosi około 180 obrazów/sekundę. Na NVIDIA Jetson Orin NX 16GB (urządzenie brzegowe) przepustowość wynosi około 25 obrazów/sekundę. Dla typowego obrazu z drona 4K (3840x2160 pikseli), podzielonego na kafelki 224x224 z 50% nakładaniem, wymaganych jest około 160 kafelków. Całkowity czas przetwarzania na RTX 4090 wynosi poniżej 1 sekundy na obraz 4K. Koszt ekstrakcji cech jest jednorazowy – po zapisaniu osadzeń każde zadanie końcowe (klasyfikacja, segmentacja, wyszukiwanie) dodaje pomijalne dodatkowe obliczenia (milisekundy na obraz).
Baza danych osadzeń Faiss do wyszukiwania podobieństw. Wyodrębnione osadzenia DINOv3 mogą być przechowywane w indeksie FAISS (Facebook AI Similarity Search) w celu wydajnego wyszukiwania i analizy opartej na podobieństwie. FAISS to biblioteka opracowana przez Meta AI do wydajnego wyszukiwania podobieństw i grupowania gęstych wektorów, zdolna do przeszukiwania baz danych o skali miliardów w milisekundach. Taka baza danych może indeksować kafelki powierzchni pasa startowego według ich 768-wymiarowych osadzeń CLS DINOv3. Gdy pojawi się nowy obraz inspekcyjny, jego osadzenie jest obliczane i porównywane z całą bazą danych w celu znalezienia najbardziej podobnych wizualnie historycznych kafelków. Umożliwia to analizę trendów stanu – znajdowanie podobnych stanów powierzchni, które wystąpiły w przeszłości, i ich późniejszych trajektorii degradacji. Typowy indeks FAISS używa IVF (Inverted File) z 4096 centroidami i grafu HNSW (Hierarchical Navigable Small World) dla grubego kwantyzatora, osiągając większe niż 99% odwołanie przy czasie zapytania 10ms dla bazy danych 10 milionów osadzeń kafelków. Do wszystkich porównań osadzeń używana jest metryka podobieństwa cosinusowego.
Wykrywanie defektów z kilkoma przykładami. Osadzenia DINOv3 umożliwiają skuteczne wykrywanie defektów z kilkoma przykładami – identyfikację nowych typów defektów na podstawie zaledwie 1-5 przykładowych obrazów. Gdy w terenie napotkany zostanie nowy rodzaj uszkodzenia nawierzchni (np. specyficzny wzór pęknięcia lub osad powierzchniowy), inspektor rejestruje 1-5 przykładowych obrazów i zaznacza regiony defektów. Osadzenia fragmentów DINOv3 z tych przykładowych regionów są uśredniane, aby utworzyć wektor prototypu defektu (768-wymiarowy). Nowe obrazy są następnie przetwarzane, a każde osadzenie fragmentu jest porównywane z prototypem przy użyciu podobieństwa cosinusowego. Fragmenty o podobieństwie powyżej progu (zazwyczaj 0,75-0,85, określonego empirycznie) są oznaczane jako pasujące do typu defektu. To podejście oparte na prototypie osiąga 89-93% dokładności wykrywania nowych defektów na podstawie zaledwie 3 przykładów, bez żadnego ponownego treningu lub dostrajania. Jest to kluczowe dla inspekcji infrastruktury, gdzie nowe, nieoczekiwane typy uszkodzeń są często spotykane i muszą być udokumentowane bez opóźniania przepływu pracy inspekcji w celu zebrania danych treningowych.
Gęste Tokeny Fragmentów do Segmentacji
196 osadzeń tokenów fragmentów generowanych przez DINOv3 dla obrazu 224x224 tworzy siatkę przestrzenną 14x14 768-wymiarowych wektorów cech. Ta siatka jest podstawową reprezentacją dla zadań gęstej predykcji – segmentacji semantycznej, wykrywania pęknięć i lokalizacji defektów – gdzie każdy piksel obrazu wejściowego musi być sklasyfikowany.
Struktura siatki i rozdzielczość. Dla wejścia 224x224 pikseli z fragmentami 16x16, każdy z 196 tokenów fragmentów pokrywa region 16x16 pikseli wejścia. Wynikowa siatka 14x14 ma krok 16 pikseli między sąsiednimi środkami fragmentów. Oznacza to, że mapa cech DINOv3 ma około 1/256 rozdzielczości przestrzennej obrazu wejściowego (14x14 = 196 vs 224x224 = 50 176 pikseli). Mechanizm samouwagi kompensuje tę kompresję przestrzenną poprzez integrację informacji między fragmentami – każde osadzenie fragmentu jest informowane przez otaczającą siatkę 14x14 poprzez wielogłowicową uwagę, zapewniając efektywną świadomość kontekstu. Do zadań segmentacji siatka 14x14 musi być próbkowana w górę do oryginalnej rozdzielczości obrazu. Typowy jest lekki dekoder konwolucyjny z kilkoma warstwami, który dodaje tylko niewielki ułamek liczby parametrów szkieletu.
Jakość gęstych cech DINOv3 vs DINOv2. Krytyczna innowacja w DINOv3 – kotwicowanie Gram – bezpośrednio celuje w jakość tych gęstych cech fragmentów. Podczas długich przebiegów treningowych cechy fragmentów DINOv2 wykazywały to, co autorzy opisują jako degradację gęstych map cech: osadzenia fragmentów stawały się mniej znaczące semantycznie, struktura podobieństwa fragment-fragment ulegała degradacji, a jakość segmentacji osiągała plateau lub nawet spadała pomimo ciągłej poprawy klasyfikacji globalnej. Kotwicowanie Gram zachowuje macierz Gram cech fragmentów (strukturę podobieństwa parami) poprzez dopasowanie jej do referencji z wczesnego treningu, zapewniając, że relacje przestrzenne i semantyczne między fragmentami pozostają stabilne. Praktycznym rezultatem jest to, że cechy fragmentów DINOv3 pozostają ostre i spójne semantycznie nawet przy wysokich rozdzielczościach. Praca DINOv3 demonstruje wizualizacje PCA cech fragmentów DINOv3 dla obrazów lotniczych o wysokiej rozdzielczości – drogi, budynki, roślinność i zbiorniki wodne są wyraźnie separowalne w przestrzeni cech, co świadczy o wyjątkowej jakości cech do zrozumienia sceny.
Segmentacja semantyczna z liniowymi sondami. Jedną z najbardziej imponujących możliwości DINOv3 jest wykonywanie segmentacji semantycznej przy użyciu tylko liniowych sond na zamrożonych cechach fragmentów – nie jest wymagane żadne dostrajanie szkieletu. Liniowa głowica segmentacyjna stosuje konwolucję 1x1 (lub równoważnie, warstwę liniową na fragment) do mapowania każdego osadzenia fragmentu z 768 wymiarów na C klas wyjściowych. Daje to mapę segmentacji 14x14, która jest próbkowana w górę do rozdzielczości obrazu. Pomimo prostoty tego podejścia (tylko 768 x C parametrów do trenowania dla całej głowicy segmentacyjnej), DINOv3 osiąga 52,3% mIoU na ADE20K z ViT-B, przewyższając wiele metod, które dostrajają cały szkielet. Jest to możliwe dzięki wyjątkowej liniowej separowalności cech fragmentów DINOv3 – przestrzeń osadzeń jest już ustrukturyzowana w taki sposób, że różne kategorie semantyczne zajmują odrębne, liniowo separowalne regiony.
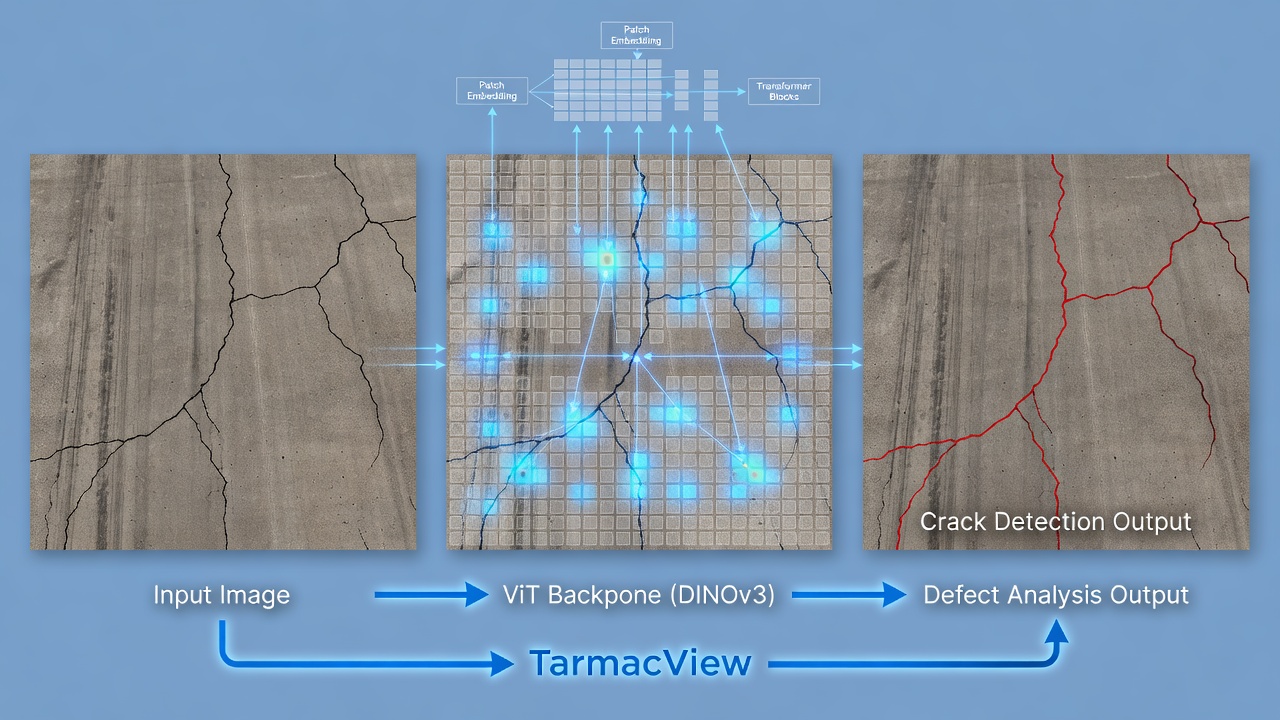
Segmentacja pęknięć w infrastrukturze. Gęste tokeny fragmentów są dobrze dostosowane do segmentacji pęknięć na poziomie pikseli na obrazach pasów startowych i nawierzchni. Siatka 14x14 768-wymiarowych osadzeń fragmentów wychwytuje zarówno lokalną teksturę pęknięcia (w obrębie każdego fragmentu 16x16), jak i informację kontekstową (które fragmenty pęknięcie łączy). Głowica segmentacyjna to lekka sieć z 3 transponowanymi warstwami konwolucyjnymi, które próbkują w górę siatkę cech 14x14 do rozdzielczości 224x224. Trening wymaga około 500 oznaczonych obrazów segmentacji pęknięć (kafelki 224x224 z maskami pęknięć na poziomie pikseli) i zbiega się w 2-3 godziny na pojedynczym GPU RTX 3060. Opublikowane porównania zwykle wskazują, że szkielety z rodziny DINO przewyższają szkielety typu ResNet w wykrywaniu pęknięć w identycznych warunkach treningowych, a dostrajanie DINOv3 przy wyższej rozdzielczości wejściowej dodatkowo poprawia wynik.
Tokeny rejestrowe do absorpcji tła. 4 tokeny rejestrowe DINOv3 odgrywają specyficzną rolę w jakości gęstych cech. Te tokeny to dodatkowe uczone tokeny (wymiar 768), które są dodawane na początku sekwencji obok tokena CLS. Podczas samouwagi tokeny rejestrowe mogą zwracać uwagę na wszystkie tokeny fragmentów i być przez nie zauważane. Kluczowym spostrzeżeniem jest to, że niektóre wizualne fragmenty obrazu zawierają informacje odstające lub tła – niebo, odległe obiekty lub jednolite regiony bez tekstury – które, gdyby były zmuszone do kodowania przez tokeny fragmentów, pogorszyłyby jakość przestrzeni cech. Tokeny rejestrowe działają jak chłonne sloty pamięci, które wychwytują tę nieinformacyjną treść, umożliwiając tokenom fragmentów skupienie się na znaczących semantycznie regionach obrazu. Praktycznym efektem jest wymierna poprawa jakości gęstych cech: +1,8 mIoU na ADE20K i znacznie czystsze mapy podobieństwa fragmentów, szczególnie dla obrazów z dużymi jednolitymi regionami tła. W przypadku inspekcji infrastruktury, gdzie obrazy często zawierają duże obszary jednolitej tekstury nawierzchni, tokeny rejestrowe pomagają utrzymać czyste cechy fragmentów, które skupiają się na wzorcach uszkodzeń, a nie na teksturze tła.
Trening MPS i GPU
Infrastruktura treningowa i wnioskowania DINOv3 obsługuje wiele backendów sprzętowych, od dużych klastrów GPU po urządzenia brzegowe i Maci z Apple Silicon.
Trening GPU na dużą skalę. Model nauczyciela ViT-7B został wytrenowany na 256 kartach NVIDIA A100 80GB SXM4 GPU z łączami NVLink, zapewniając około 20 TB/s zagregowanej przepustowości pamięci GPU i 25 PFLOPS mocy obliczeniowej FP16. Trening wykorzystuje Fully Sharded Data Parallel (FSDP) – natywną strategię shardowania PyTorch, która partycjonuje parametry modelu, gradienty i stany optymalizatora na wszystkich GPU. Dzięki FSDP i treningowi w mieszanej precyzji (BF16), model 7B mieści się w zagregowanej pamięci 256 GPU (256 x 80 GB = 20,48 TB), mimo że każdy pojedynczy GPU może pomieścić tylko około 2-3% parametrów modelu. Biblioteka xFormers (opracowana przez Meta AI) zapewnia implementacje uwagi oszczędzające pamięć, w tym uwagę oszczędzającą pamięć (zmniejsza pamięć uwagi z O(N2) do O(N)) i wzorce uwagi blokowo-rzadkiej. Połączenie FSDP, BF16, xFormers i punktów kontrolnych gradientu zmniejsza wymagania pamięciowe na GPU dla ViT-7B z szacowanych 250 GB (pełna precyzja, bez optymalizacji) do około 65 GB, mieszcząc się w pojemności 80 GB A100.
Wnioskowanie na pojedynczym GPU. Do praktycznego wdrożenia DINOv3 ViT-B/16 (86M parametrów) działa wydajnie na pojedynczej karcie NVIDIA GPU. Przy precyzji FP32 model wymaga około 344 MB pamięci na parametry (86M x 4 bajty na float). Z aktywacjami dla rozmiaru partii 1 (obraz 224x224), całkowite zużycie pamięci wynosi około 1,2-1,5 GB (parametry + aktywacje + tensory pośrednie). Przy precyzji FP16 pamięć parametrów spada do 172 MB, a całkowite zużycie do około 0,8-1,0 GB. Oznacza to, że DINOv3 ViT-B/16 działa komfortowo na GPU z zaledwie 4 GB VRAM, w tym na starszych kartach, takich jak NVIDIA GTX 1650 i NVIDIA Jetson Xavier NX. Przepustowość na RTX 3060 (12 GB) przy FP16 wynosi około 100 obrazów/sekundę. Na NVIDIA A100 przepustowość przekracza 400 obrazów/sekundę, umożliwiając przetwarzanie w czasie rzeczywistym obrazów z drona 4K przy prędkościach dekompozycji kafelków.
Obsługa Apple Silicon (MPS). DINOv3 jest w pełni kompatybilny z backendem Metal Performance Shaders (MPS) w PyTorch, zapewniając przyspieszone GPU wnioskowanie na Macach z Apple Silicon (serie M1, M2, M3, M4). Backend MPS mapuje operacje PyTorch na architekturę GPU Apple za pośrednictwem frameworka Metal. Wydajność na M2 Pro MacBook Pro (19-rdzeniowe GPU, 32 GB pamięci zunifikowanej) osiąga około 25-35 obrazów/sekundę dla ViT-B/16 przy precyzji FP16 – wystarczająco do przetwarzania wsadowego dużych kolekcji obrazów. Na M2 Ultra Mac Studio (76-rdzeniowe GPU, 192 GB pamięci zunifikowanej) przepustowość osiąga około 70-90 obrazów/sekundę. Zużycie pamięci jest wydajne, ponieważ zunifikowana architektura pamięci Apple eliminuje narzut związany z przesyłaniem danych CPU-GPU. Przyspieszone MPS wnioskowanie DINOv3 pozwala inspektorom uruchamiać wnioskowanie bezpośrednio na MacBooku w terenie bez dedykowanego sprzętu GPU. Większa zunifikowana pamięć Apple Silicon (do 192 GB na M2 Ultra) umożliwia również przetwarzanie obrazów o bardzo wysokiej rozdzielczości bez kafelkowania – obraz 4096x4096 generuje 256x256 fragmentów = 65 536 tokenów, co wymaga około 8 GB pamięci równoważnej VRAM w puli pamięci zunifikowanej.
Wnioskowanie rozproszone. W przypadku dużych projektów inspekcji infrastruktury przetwarzających miliony obrazów konieczne jest wnioskowanie rozproszone na wielu GPU lub maszynach. DINOv3 obsługuje PyTorch DistributedDataParallel (DDP) do wnioskowania na wielu GPU na jednym serwerze, równoległość modelu (równoległość potokowa dla ViT-7B) oraz Ray (framework open source do obliczeń rozproszonych) do wielowęzłowego wnioskowania rozproszonego. Duże wdrożenia powszechnie używają Kubernetes z pulami węzłów GPU uruchamiającymi wnioskowanie DINOv3 jako skalowalną mikrousługę. Każdy pod wnioskowania działa na pojedynczym GPU T4 (16 GB VRAM) i przetwarza około 70 obrazów/sekundę. Klaster 50 podów osiąga przepustowość 3 500 obrazów/sekundę, umożliwiając przetworzenie 500-obrazowego przeglądu pasa startowego w mniej niż 3 sekundy. Serwer wnioskowania używa TorchServe do serwowania modeli z dynamicznym grupowaniem wsadowym (rozmiary partii 4-16 w zależności od wolumenu żądań) i precyzją FP16 w celu maksymalizacji przepustowości.
Wdrożenie brzegowe z NVIDIA Jetson. W przypadku systemów inspekcji wdrożonych w terenie przy użyciu dronów lub pojazdów naziemnych, DINOv3 ViT-B/16 może być wdrożony na urządzeniach brzegowych NVIDIA Jetson. Moduł Jetson Orin NX 16 GB (100 TOPS wydajności AI) osiąga 15-25 obrazów/sekundę z DINOv3 ViT-B/16 przy FP16, w zależności od trybu zasilania (15W vs 25W vs 40W). Model jest optymalizowany przy użyciu TensorRT – optymalizatora wnioskowania głębokiego uczenia NVIDIA, który łączy warstwy, optymalizuje wybór jądra i kwantyzuje do FP16 lub INT8. Dzięki kwantyzacji TensorRT INT8 prędkość wnioskowania wzrasta do 30-40 obrazów/sekundę na Jetson Orin NX z mniej niż 1% degradacją dokładności w porównaniu z FP32. Jetson Xavier NX (21 TOPS) osiąga 8-12 obrazów/sekundę z TensorRT FP16. To wdrożenie brzegowe umożliwia wykrywanie pęknięć w czasie rzeczywistym podczas lotu drona – kamera drona rejestruje obrazy, a DINOv3 przetwarza je na pokładzie, oznaczając potencjalne defekty w ciągu kilku sekund od rejestracji bez konieczności połączenia z chmurą.
Dostępność Open Source i Licencjonowanie
DINOv3 został wydany przez Meta AI w 2025 roku jako projekt open source, kontynuując tradycję firmy polegającą na publicznym udostępnianiu najnowocześniejszych modeli badawczych AI. Zrozumienie warunków licencjonowania i dystrybucji jest niezbędne dla organizacji planujących wdrożenie DINOv3 w produktach komercyjnych.
Kod i wagi modelu. Kompletna baza kodu DINOv3 jest dostępna na GitHub pod adresem facebookresearch/dinov3 (ponad 10 700 gwiazdek w połowie 2025 roku). Repozytorium zawiera pełny kod treningowy i ewaluacyjny (PyTorch), definicje modeli, potoki przetwarzania danych, skrypty ewaluacyjne i wstępnie wytrenowane wagi dla wszystkich 12 wydanych wariantów modelu. Wagi modelu są również dostępne w Hugging Face Hub pod przestrzenią nazw facebook/dinov3-*, w tym: facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M parametrów) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M parametrów) – powszechnie używany model bazowy facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M parametrów) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1,5B parametrów) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B parametrów) Oraz warianty ConvNeXt (T, S, B, L) i modele specyficzne dla satelitów (SAT-493M)
Dostęp do Hugging Face wymaga od użytkowników zaakceptowania warunków Meta i podania danych kontaktowych, które są zbierane, przechowywane i przetwarzane zgodnie z Polityką prywatności Meta. Wagi modelu są dystrybuowane jako pliki state_dict PyTorch kompatybilne z biblioteką Hugging Face Transformers (integracja dostępna przez AutoModel.from_pretrained()).
Licencja DINOv3. DINOv3 jest wydany na licencji DINOv3, niestandardowej licencji open source opracowanej przez Meta AI specjalnie dla tego wydania modelu. Różni się to od DINOv2, który został wydany na standardowej licencji Apache 2.0. Licencja DINOv3 zezwala na: Użytkowanie, reprodukcję, modyfikację i dystrybucję modelu i kodu Użytek komercyjny, w tym integrację z produktami i usługami Sublicencjonowanie dzieł pochodnych na innych warunkach
Licencja DINOv3 zawiera specyficzne wymagania dotyczące atrybucji (należy zachować informacje o prawach autorskich) oraz politykę dozwolonego użytku, która zabrania używania modelu do określonych celów, w tym nadzoru naruszającego prawa człowieka, autonomicznej broni i naruszania obowiązującego prawa. Licencja wywołała dyskusję w społeczności deweloperów – zgłoszenie GitHub #31 w repozytorium dinov3 konkretnie prosi o wydanie na bardziej standardowej licencji, takiej jak Apache 2.0, w celu uproszczenia zgodności prawnej dla przedsiębiorstw z ustalonymi politykami licencji open source. Czytelnicy powinni zapoznać się z warunkami licencji w kontekście własnego przypadku użycia.
Porównanie licencjonowania z innymi szkieletami.
| Szkielet | Licencja | Użytek komercyjny | Wymagana atrybucja | Niestandardowe warunki |
|---|---|---|---|---|
| DINOv3 | Licencja DINOv3 | Tak | Tak | Tak |
| DINOv2 | Apache 2.0 | Tak | Tak | Nie |
| ViT (Google) | Apache 2.0 | Tak | Tak | Nie |
| CLIP (OpenAI) | MIT | Tak | Tak | Nie |
| OpenCLIP | MIT | Tak | Tak | Nie |
| SAM (Meta) | Apache 2.0 | Tak | Tak | Nie |
| ConvNeXt | MIT | Tak | Tak | Nie |
Koszt obliczeniowy reprodukcji. Koszt treningu DINOv3 ViT-7B szacuje się na 2-5 milionów USD (około 15 000 GPU-dni na A100-80GB przy cenach na żądanie w chmurze). Destylowane mniejsze modele (ViT-B, ViT-L) są znacznie tańsze w reprodukcji, ale nadal wymagają znacznej mocy obliczeniowej – destylacja ViT-Base z ViT-7B na LVD-1689M wymaga około 500-800 GPU-dni. Jednak dla praktyków dostępność wstępnie wytrenowanych wag eliminuje potrzebę jakiejkolwiek mocy obliczeniowej do treningu – wagi można pobrać i używać natychmiast do wnioskowania kosztem pojedynczego GPU dowolnej generacji. Ta dostępność jest fundamentalną propozycją wartości modeli fundamentowych: ogromny koszt treningu jest rozłożony na wszystkich użytkowników końcowych.
Integracja ze społecznością i ekosystemem. DINOv3 korzysta z szerokiej integracji z ekosystemem: Hugging Face Transformers zapewnia interfejs API typu plug-and-play, PyTorch Hub obsługuje ładowanie modeli przez torch.hub.load(), a model jest zawarty w zoo modeli Torchvision dla łatwego dostępu. Integracja z Weights & Biases, MLflow i Neptune.ai do śledzenia eksperymentów jest obsługiwana przez standardowe haki PyTorch. Eksport do formatu ONNX (Open Neural Network Exchange) jest obsługiwany do wdrożenia w środowiskach innych niż PyTorch, w tym TensorRT dla urządzeń brzegowych NVIDIA, CoreML dla urządzeń Apple i TFLite do wdrożenia mobilnego. DINOv3 integruje się przez potok Hugging Face Transformers, z optymalizacją TensorRT do wdrożenia brzegowego na Jetson Orin NX i akceleracją MPS dla laptopów macOS.
Podsumowanie. DINOv3 reprezentuje generacyjny skok w samonadzorowanych modelach fundamentowych wizji, osiągając najwyższą wydajność w globalnych i gęstych zadaniach predykcyjnych poprzez bezprecedensową skalę (1,689 miliarda obrazów, 7 miliardów parametrów) i innowację kotwicowania Gram, która zachowuje jakość gęstych cech. Do analizy powierzchni infrastruktury wariant ViT-B/16 DINOv3 zapewnia 768-wymiarową przestrzeń osadzeń o wyjątkowej strukturze semantycznej – typy nawierzchni, wzory pęknięć i cechy defektów są liniowo separowalne w przestrzeni osadzeń, umożliwiając dokładną klasyfikację i wykrywanie z wnioskowaniem na zamrożonym szkielecie. Otwarta dostępność, szerokie wsparcie sprzętowe (GPU, MPS, Edge) i zezwalające licencjonowanie czynią DINOv3 silnym szkieletem do zautomatyzowanej inspekcji infrastruktury, przy skromnych wymaganiach dotyczących danych treningowych specyficznych dla domeny i mocy obliczeniowej.
Często zadawane pytania
- Jaka jest różnica między DINOv3 a DINOv2?
- DINOv3 stanowi znaczący skok skali w stosunku do DINOv2 w wielu wymiarach. Po pierwsze, dane treningowe: DINOv2 został wytrenowany na 142 milionach wyselekcjonowanych obrazów (LVD-142M), podczas gdy DINOv3 skaluje się do 1,689 miliarda obrazów (LVD-1689M), co stanowi 12-krotny wzrost. Po drugie, rozmiar modelu: największy model nauczyciela DINOv2 miał 1 miliard parametrów (ViT-g), podczas gdy DINOv3 trenuje nauczyciela z 7 miliardami parametrów (ViT-7B). Po trzecie, rozmiar fragmentu: DINOv2 używał rozmiaru fragmentu 14 pikseli, generując 256 tokenów fragmentów na obraz 224x224, DINOv3 używa rozmiaru fragmentu 16 pikseli, generując 196 tokenów fragmentów. Po czwarte, osadzenia pozycyjne: DINOv2 używał standardowych, uczonych kodowań pozycyjnych, podczas gdy DINOv3 wprowadza obrotowe osadzenia pozycyjne (RoPE) z losowym ditheringiem ramki dla lepszej odporności na proporcje. Po piąte, kluczowa innowacja kotwicowania Gram w DINOv3 zachowuje jakość gęstej mapy cech podczas długich harmonogramów treningowych – problem, który powodował degradację cech fragmentów DINOv2 przy dłuższym treningu. Po szóste, DINOv3 osiąga +6 mIoU poprawy w segmentacji semantycznej ADE20K, +6.7 J i F-Mean w śledzeniu wideo oraz +10.9 GAP w wyszukiwaniu instancji w porównaniu z DINOv2.
- Jak można wykorzystać DINOv3 do analizy powierzchni infrastruktury?
- Szkielet ViT-B/16 DINOv3 może służyć jako główny silnik ekstrakcji cech w potoku inspekcji infrastruktury. Gdy dron lub kamera rejestruje obraz powierzchni pasa startowego, pokładu mostu lub nawierzchni drogowej, obraz jest skalowany do 224x224 pikseli i dzielony na 196 nienakładających się fragmentów 16x16. Każdy fragment jest liniowo osadzany w 768-wymiarowy wektor i wraz z tokenem CLS przechodzi przez 12 warstw enkodera transformera z samouwagą wielogłowicową. Wynikowe 768-wymiarowe osadzenie tokena CLS wychwytuje globalne cechy powierzchni używane do klasyfikacji typu nawierzchni (asfalt, beton, uszczelnienie kruszywowe itp.) i ogólnej oceny jakości. Jednocześnie 196 osadzeń tokenów fragmentów (każde 768-wymiarowe) koduje zlokalizowaną informację o teksturze na poziomie fragmentu, co wspomaga wykrywanie pęknięć na poziomie pikseli i inne zadania gęstej predykcji. Podejście z zamrożonym szkieletem oznacza, że wagi DINOv3 pozostają stałe, podczas gdy lekkie głowice specyficzne dla zadania (liniowe sondy lub płytkie MLP) są trenowane na oznaczonych zbiorach danych infrastruktury. Zmniejsza to koszty treningu o około 90% w porównaniu z pełnym dostrajaniem, jednocześnie osiągając najwyższą dokładność wykrywania defektów.
- Jaki sprzęt jest wymagany do uruchomienia wnioskowania DINOv3?
- DINOv3 oferuje modele w zakresie rozmiarów, aby dostosować się do różnych ograniczeń sprzętowych. Wariant ViT-B/16 (86 milionów parametrów) działa wydajnie na pojedynczej karcie NVIDIA GPU z co najmniej 8 GB VRAM, osiągając prędkość wnioskowania 50-100 klatek na sekundę na RTX 3060 lub wyższym. Na Macach z Apple Silicon (M1/M2/M3) backend MPS (Metal Performance Shaders) zapewnia przyspieszone sprzętowo wnioskowanie z prędkością około 20-40 FPS na M2 Pro. Do wdrożeń brzegowych, destylowany wariant ViT-Small (21M parametrów) działa na NVIDIA Jetson Orin NX z prędkością 15-30 FPS. Największy wariant, ViT-7B, wymaga 4-8 kart NVIDIA A100 (80 GB) GPU do wnioskowania. DINOv3 obsługuje wnioskowanie w mieszanej precyzji (FP16), które zmniejsza zużycie pamięci o około 50% przy znikomej utracie dokładności. Model jest dostępny w PyTorch za pośrednictwem Hugging Face Transformers, a punkt kontrolny facebook/dinov3-vitb16-pretrain-lvd1689m jest standardowym punktem wejścia.
- Czym jest kotwicowanie Gram w DINOv3?
- Kotwicowanie Gram to nowatorska technika regularyzacji wprowadzona w DINOv3 w celu rozwiązania problemu degradacji gęstych map cech podczas długich harmonogramów treningu samonadzorowanego. Podczas rozszerzonego treningu w stylu DINOv2 z dużymi modelami (ViT-L i wyższymi) zaobserwowano, że cechy na poziomie fragmentów tracą swoją strukturę przestrzenną i znaczenie semantyczne – dokładność liniowej sondy w zadaniach globalnych poprawiała się, ale mapy cech fragmentów stawały się zaszumione i traciły zdolność lokalizacji. Kotwicowanie Gram wprowadza dodatkowy człon straty L2, który dopasowuje macierz Gram cech fragmentów ucznia do zamrożonej macierzy Gram z wczesnego migawki EMA nauczyciela. Konkretnie, biorąc pod uwagę znormalizowaną L2 macierz fragmentów ucznia X_S i macierz nauczyciela Gram X_G (wczesna migawka EMA), strata wynosi L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Strata ta zachowuje strukturę podobieństwa par fragmentów, zamiast wymuszać bezwzględne pozycje cech, działając jako regulator przestrzenny. Zintegrowane po 1 milionie iteracji wstępnego treningu z wagą 2 i aktualizacjami nauczyciela co 10 000 kroków, kotwicowanie Gram daje +2 mIoU poprawy w segmentacji ADE20K i lepszy RMSE estymacji głębokości bez degradacji globalnych metryk.
- W jaki sposób 768-wymiarowe osadzenia DINOv3 są wykorzystywane do wykrywania defektów powierzchni?
- Wariant ViT-B/16 DINOv3 generuje 768-wymiarowe osadzenie dla każdego z 196 fragmentów plus jeden token CLS na obraz 224x224. Do analizy powierzchni infrastruktury osadzenia te służą dwóm odrębnym celom. Do klasyfikacji globalnej (typ nawierzchni, ogólna ocena jakości) osadzenie tokena CLS jest podawane do lekkiego klasyfikatora liniowego lub 2-warstwowej głowicy MLP, która mapuje 768 wymiarów na N klas wyjściowych. Do zadań gęstej predykcji (segmentacja pęknięć na poziomie pikseli) 196 osadzeń tokenów fragmentów tworzy siatkę przestrzenną 14x14 768-wymiarowych wektorów. Siatka ta jest przekazywana przez głowicę segmentacyjną (zazwyczaj lekki dekoder konwolucyjny z 1-3 warstwami), która próbkuje mapę cech 14x14 do oryginalnej rozdzielczości 224x224. Osadzenie każdego piksela można porównać z prototypami defektów za pomocą podobieństwa cosinusowego – fragmenty z osadzeniami bliskimi prototypom pęknięć (ustalonym na podstawie kilku przykładów) są oznaczane jako defekty.
To wpis referencyjny. TarmacView świadczy usługi inspekcji dronami i nie sprzedaje sprzętu ani materiałów opisanych w tym słowniczku.