Čo je DINOv3 Vision Transformer?
DINOv3 Vision Transformer pre analýzu povrchov infraštruktúry
Samoriadené učenie a DINO
Samoriadené učenie (SSL) je paradigma strojového učenia, kde sa model učí zmysluplné reprezentácie z neoznačených údajov definovaním pretextovej úlohy, ktorá nevyžaduje ľudské anotácie. Model musí predpovedať niektorú časť údajov z iných častí, pričom využíva inherentnú štruktúru a vzorce spoločného výskytu v samotných údajoch. V počítačovom videní metódy SSL prešli od ručne vytvorených pretextových úloh, ako je predpovedanie uhla rotácie obrázka (RotNet), skladanie skladačiek z premiešaných dielikov alebo kolorovanie obrázkov v odtieňoch sivej, k sofistikovanejším prístupom založeným na kontrastívnom učení a destilácii. Zásadnou výhodou SSL je, že umožňuje trénovanie na webových súboroch údajov bez prohibičných nákladov na manuálnu anotáciu. Pre infraštruktúrne aplikácie, kde sú označené súbory údajov o defektoch vzácne a nákladné na výrobu (vyžadujú certifikovaných inšpektorov a inžinierov), umožňujú kostry založené na SSL efektívne učenie prvkov z obrovského množstva neoznačených snímok pred akýmkoľvek dolaďovaním špecifickým pre danú úlohu.
TarmacView posudzovanie cestných vozoviek je v aktívnom vývoji a zatiaľ nie je ponúkané.
Kontrastívne učenie metódy ako SimCLR, MoCo a SwAV sa učia reprezentácie tak, že približujú augmentované pohľady toho istého obrázka (pozitívne páry) k sebe v priestore vložení, zatiaľ čo od seba odďaľujú pohľady rôznych obrázkov (negatívne páry). Tieto metódy vyžadujú starostlivé zaobchádzanie s negatívnymi vzorkami – príliš málo negatívov zhoršuje výkon, príliš veľa zvyšuje výpočtové náklady. Nekontrastívne metódy ako BYOL, SimSiam a DINO sa vyhýbajú potrebe negatívnych párov úplne tým, že používajú asymetrické sieťové architektúry a operácie zastavenia gradientu, aby zabránili kolapsu reprezentácie. DINO (self-DIstillation with NO labels), predstavený Caronom a kol. v Meta AI v roku 2021, patrí do tejto nekontrastívnej rodiny a stal sa jednou z najvplyvnejších metód SSL v počítačovom videní. Pôvodný článok DINO ukázal, že SSL a Vision Transformery majú jedinečnú synergiu – mechanizmy self-attention v ViT prirodzene vytvárajú sémantické segmentačné mapy bez akéhokoľvek dohľadu, čo je vlastnosť, ktorá vzniká z interakcie medzi stratégiou augmentácie viacnásobných orezov a cieľom samodestilácie.
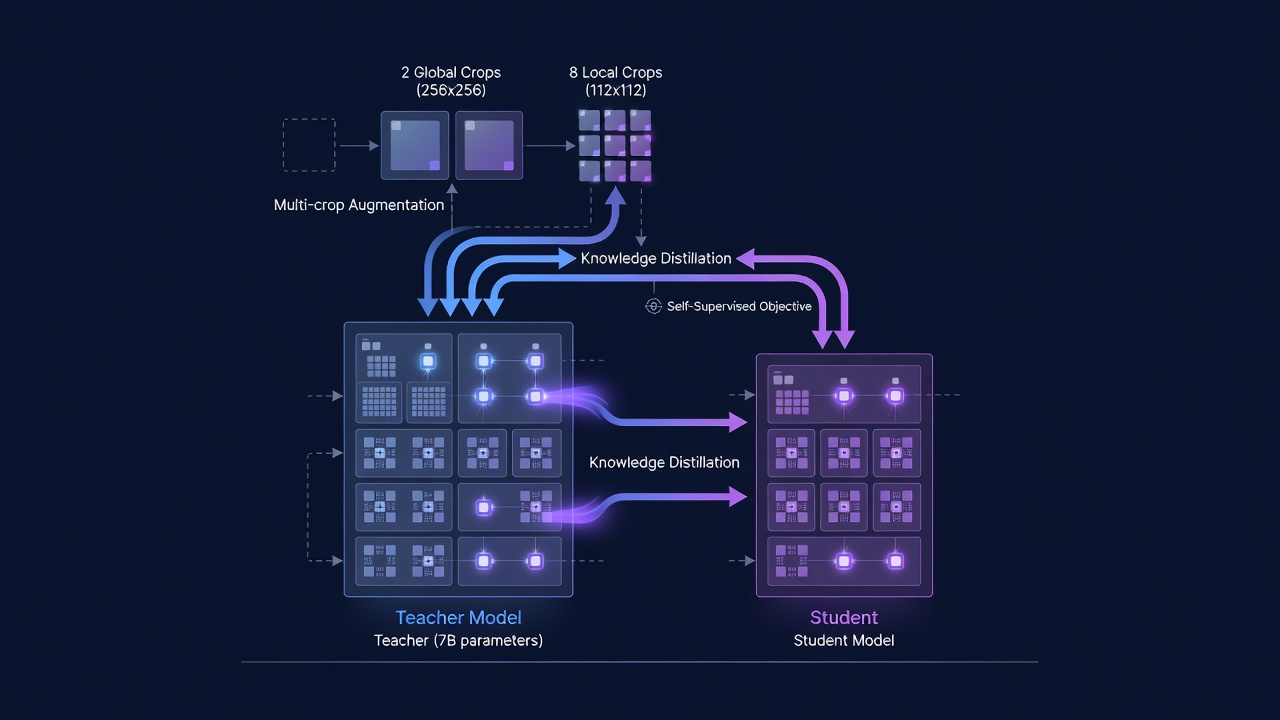
Tréningový rámec DINO funguje nasledovne. Pre každý vstupný obrázok sa vygenerujú dva globálne pohľady (pokrývajúce viac ako 50 % plochy obrázka, typicky 224x224 pixelov) a niekoľko lokálnych pohľadov (menšie orezy pokrývajúce menej ako 50 % plochy obrázka, typicky 96x96 pixelov) prostredníctvom náhodného orezu so zmenou veľkosti, farebného posunu a Gaussovho rozmazania. Všetky pohľady prechádzajú cez študentskú sieť (Vision Transformer). Globálne pohľady prechádzajú aj cez učiteľskú sieť, ktorá zdieľa rovnakú architektúru ako študent, ale má iné parametre. Parametre učiteľa sa neučia prostredníctvom gradientov – namiesto toho sa aktualizujú ako exponenciálny kĺzavý priemer (EMA) parametrov študenta. Základným tréningovým cieľom je dosiahnuť, aby výstupná distribúcia študenta zodpovedala výstupnej distribúcii učiteľa pre globálne pohľady, zatiaľ čo lokálne pohľady poskytujú dodatočný tréningový signál len prostredníctvom študenta. Toto nastavenie učiteľ-študent, známe ako samodestilácia, vytvára učebný signál, ktorý nevyžaduje označenia – študent sa učí vytvárať konzistentné reprezentácie naprieč rôznymi augmentáciami toho istého obrázka, čo ho núti zachytiť invariantný sémantický obsah skôr než povrchné detaily na úrovni pixelov.
DINOv1 (2021) demonštroval tri kľúčové emergentné vlastnosti samoriadených ViT. Po prvé, mapy pozornosti z tokenu [CLS] k dielikom obrázka prirodzene segmentujú objekty od pozadia – vlastnosť, ktorá vzniká čisto zo samoriadenia bez akýchkoľvek segmentačných označení. Po druhé, naučené prvky vykazujú vynikajúci výkon k-NN klasifikácie – jednoduchý klasifikátor najbližšieho suseda v priestore prvkov DINO dosahuje 78,2 % top-1 presnosť na ImageNet bez akéhokoľvek dolaďovania. Po tretie, prvky DINO vykazujú silnú sémantickú korešpondenciu naprieč rôznymi inštanciami rovnakej triedy objektov, čo umožňuje aplikácie v vyhľadávaní obrázkov, spolusedgmentácii a segmentácii objektov vo videu. Tieto vlastnosti urobili z DINO základnú metódu v krajine samoriadeného učenia a pripravili pôdu pre DINOv2 (2023) a DINOv3 (2025).
Architektúra ViT
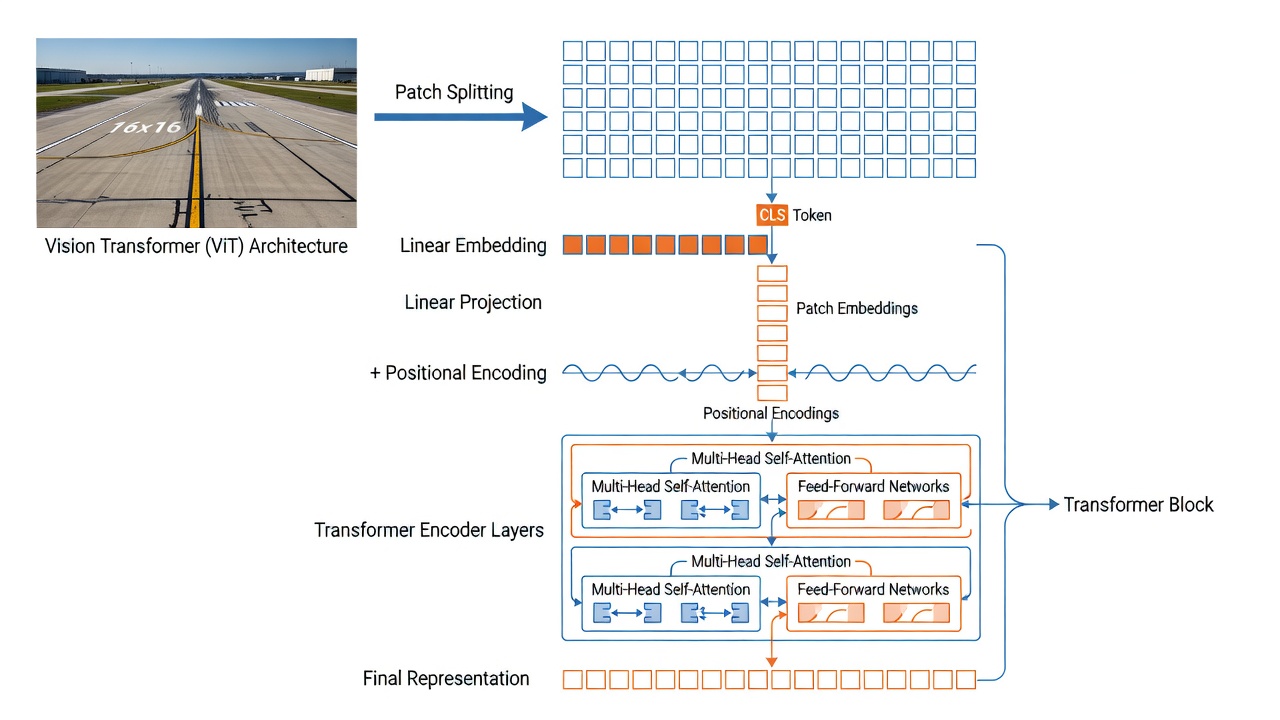
Architektúra Vision Transformer (ViT), predstavená Dosovitskiym a kol. v Google v roku 2021, adaptuje architektúru Transformer z NLP na počítačové videnie tým, že považuje dieliky obrázka za analogické tokenom slov. Na rozdiel od konvolučných neurónových sietí (CNN), ktoré spracúvajú obrázky prostredníctvom lokálnych receptívnych polí so zabudovanou transláčnou ekvivalenciou, ViT aplikujú globálnu self-attention naprieč všetkými dielikmi súčasne, čo umožňuje modelu zachytiť závislosti na veľké vzdialenosti už od prvej vrstvy. Táto architektonická voľba sa ukázala ako kľúčová pre úspech DINO – pôvodný článok DINO ukázal, že samoriadené ViT výrazne prekonávajú samoriadené CNN a že synergia medzi self-attention a samodestiláciou je zodpovedná za emergentné vlastnosti sémantickej segmentácie.
Vloženie dielika (Patch Embedding). Prvou operáciou v ViT je rozdelenie vstupného obrázka na mriežku neprekrývajúcich sa dielikov. Pre variant ViT-B/16 je veľkosť dielika 16x16 pixelov. Vstupný obrázok 224x224 pixelov vytvára (224/16) x (224/16) = 14 x 14 = 196 dielikov. Každý dielik 16x16x3 (RGB kanály) je sploštený do vektora dĺžky 768 (16x16x3). V praxi je toto vloženie dielika implementované ako jediná konvolučná vrstva s veľkosťou jadra rovnajúcou sa veľkosti dielika (16x16) a krokom rovnajúcim sa veľkosti dielika, čím vzniká 2D mriežka 14x14 vektorov prvkov, každý s dimenziou rovnajúcou sa skrytej veľkosti modelu (768 pre ViT-B). Učiteľná lineárna projekcia potom mapuje každý sploštený dielik na dimenziu vloženia. Implementácia Conv2d je výpočtovo efektívna (jedna operácia nahrádza 196 samostatných lineárnych projekcií) a je štandardom vo všetkých moderných implementáciách ViT.
Token [CLS]. Po vzore architektúry BERT v NLP je na začiatok sekvencie dielikových vložení pridaný špeciálny učenlivý klasifikačný token ([CLS]). Token [CLS] má rovnakú dimenziu (768) ako dielikové vloženia a je inicializovaný náhodne. Počas trénovania, prostredníctvom self-attention naprieč všetkými vrstvami transformeru, token [CLS] agreguje informácie zo všetkých dielikov obrázka – môže venovať pozornosť každému dieliku v každej vrstve, čím vytvára globálnu reprezentáciu celého obrázka. Na výstupe poslednej vrstvy transformeru slúži vloženie tokenu [CLS] ako reprezentácia na úrovni obrázka používaná pre klasifikačné úlohy. V DINOv3 je token [CLS] doplnený o 4 registračné tokeny – ďalšie učenlivé tokeny pridané na začiatok sekvencie, ktoré fungujú ako pamäť na písanie (scratchpad memory) na absorbovanie odľahlých alebo pozadových informácií, čím bránia tokenom [CLS] a dielikovým tokenom v korupcii irelevantnými vysokofrekvenčnými detailmi.
Polohové vloženia (Positional Embeddings). Keďže mechanizmus self-attention v Transformeri je permutačne invariantný (spracúva dieliky ako množinu, nie ako sekvenciu), polohové informácie musia byť explicitne pridané, aby modelu povedali, kam každý dielik patrí v priestorovej mriežke. DINOv3 používa Rotary Position Embeddings (RoPE) namiesto štandardných učenlivých absolútnych polohových kódovaní použitých v DINOv2. RoPE kóduje relatívne polohové informácie aplikáciou rotačnej matice na dotazovacie a kľúčové vektory v self-attention na základe ich priestorových súradníc. Frekvencia rotácie pre každú dimenziu je určená indexom dimenzie podľa geometrickej postupnosti. Kľúčovou výhodou RoPE pre analýzu infraštruktúry je jej schopnosť spracovávať vstupy s premenlivým rozlíšením – pri spracovaní obrázkov s vysokým rozlíšením (až 4096x4096 pixelov) mechanizmus RoPE prirodzene generalizuje na väčšiu priestorovú mriežku bez potreby interpolácie naučených polohových vložení. DINOv3 tiež zavádza náhodný posun okienka (random box jitter) počas aplikácie RoPE, kde sú polohové indexy náhodne posunuté v rozsahu [-s,s] s s v [0,5;2,0], čím je model robustný voči rôznym pomerom strán a vzorcom orezania.
Multi-Head Self-Attention (MHSA). Základným výpočtovým primitívom ViT je mechanizmus multi-head self-attention. V každom bloku transformeru je vstupná sekvencia N tokenov (N = 1 [CLS] + 4 registračné + 196 dielikových = 201 tokenov pre vstup 224x224) lineárne projektovaná do troch matíc: Dotazy (Q) , Kľúče (K) a Hodnoty (V) , každá s dimenziou 768 pre ViT-B/16. Mechanizmus pozornosti vypočítava párovú podobnosť medzi všetkými tokenmi ako bodový súčin Q a K^T, škálovaný druhou odmocninou z d_k (kde d_k je dimenzia kľúča na hlavu). Výsledné váhy pozornosti (normalizované softmax) určujú, koľko každý token prispieva k reprezentácii každého iného tokenu. V ViT-B/16 je 12 hláv pozornosti, pričom každá pracuje v 64-rozmernom podpriestore (768/12 = 64). Viachlavová pozornosť umožňuje modelu venovať pozornosť rôznym typom vzťahov súčasne – napríklad jedna hlava sa môže zamerať na textúrnu podobnosť medzi dielikmi, iná na priestorovú blízkosť a ďalšia na členstvo v sémantickej kategórii. Výstupy všetkých hláv sú skonkatenované a lineárne projektované späť na 768 dimenzií. Výpočtová zložitosť MHSA je O(N2d) – kvadratická v dĺžke sekvencie N, ale lineárna v dimenzii vloženia d. Pre 201-tokenovú sekvenciu v DINOv3 ViT-B/16 je to zvládnuteľné (približne 40K výpočtov pozornosti na vrstvu), ale pre obrázky s vysokým rozlíšením so 4000+ tokenmi (napr. obrázok 1024x1024 vytvára 64x64 = 4096 dielikov) sa kvadratické škálovanie stáva významným faktorom.
Blok enkodéra Transformeru. Každá z 12 (ViT-B) alebo 40 (ViT-7B) vrstiev transformeru v DINOv3 nasleduje dizajn pred-normalizácie. Layer Normalization (LayerNorm) sa aplikuje pred podvrstvami MHSA aj MLP, pričom reziduálne spojenia obchádzajú každú podvrstvu. Podvrstva MLP (multilayer perceptron) pozostáva z dvoch lineárnych vrstiev s aktiváciou GELU (Gaussian Error Linear Unit) medzi nimi. Pre ViT-B/16 je skrytá dimenzia MLP 3072 (4-násobok dimenzie vloženia), čím vzniká konfigurácia: Dimenzia vloženia 768 na MLP skrytú 3072 na GELU na MLP výstup 768. Väčší učiteľský model DINOv3 (ViT-7B) používa v MLP aktiváciu SwiGLU (Swish-Gated Linear Unit) namiesto GELU, čo nasleduje moderné trendy v architektúre LLM. SwiGLU aplikuje gating mechanizmus: výstup = (xW1) elementárne vynásobené Swish(xW2) krát W3. Táto gated aktivácia sa ukázala ako zlepšujúca stabilitu trénovania a konečný výkon pri škálovaní. Dizajn pred-normalizácie sa líši od pôvodného Transformeru s post-normalizáciou (kde normalizácia bola aplikovaná po pridaní rezídua) a ukázalo sa, že produkuje stabilnejšie trénovanie, najmä pre hlboké (12+ vrstiev) transformery.
Súhrnná tabuľka architektúry pre rodinu modelov DINOv3.
| Model | Parametre | Dimenzia vloženia | Hlavy | Vrstvy | Dimenzia MLP | Veľkosť dielika | Dielikov/224px |
|---|---|---|---|---|---|---|---|
| ViT-Small | 21M | 384 | 6 | 12 | 1536 | 16 | 196 |
| ViT-Base | 86M | 768 | 12 | 12 | 3072 | 16 | 196 |
| ViT-Large | 304M | 1024 | 16 | 24 | 4096 | 16 | 196 |
| ViT-H+ | ~1,5B | 1536 | 24 | 32 | 6144 | 16 | 196 |
| ViT-7B | 7B | 4096 | 32 | 40 | 8192 | 16 | 196 |
Architektúra ViT-Base (86M parametrov) je optimálnym kompromisom medzi kvalitou prvkov a výpočtovou efektívnosťou pre pipeline inšpekcie infraštruktúry, ponúkajúc 768-rozmerné vloženia s 12 vrstvami spracovania self-attention.
Trénovanie DINOv3 na 1,7 miliarde obrázkov
DINOv3 dosahuje svoj najmodernejší výkon prostredníctvom bezprecedentného rozsahu samoriadeného trénovania, využívajúc masívnu kurátorskú správu údajov a efektívnu distribuovanú optimalizáciu naprieč stovkami GPU.
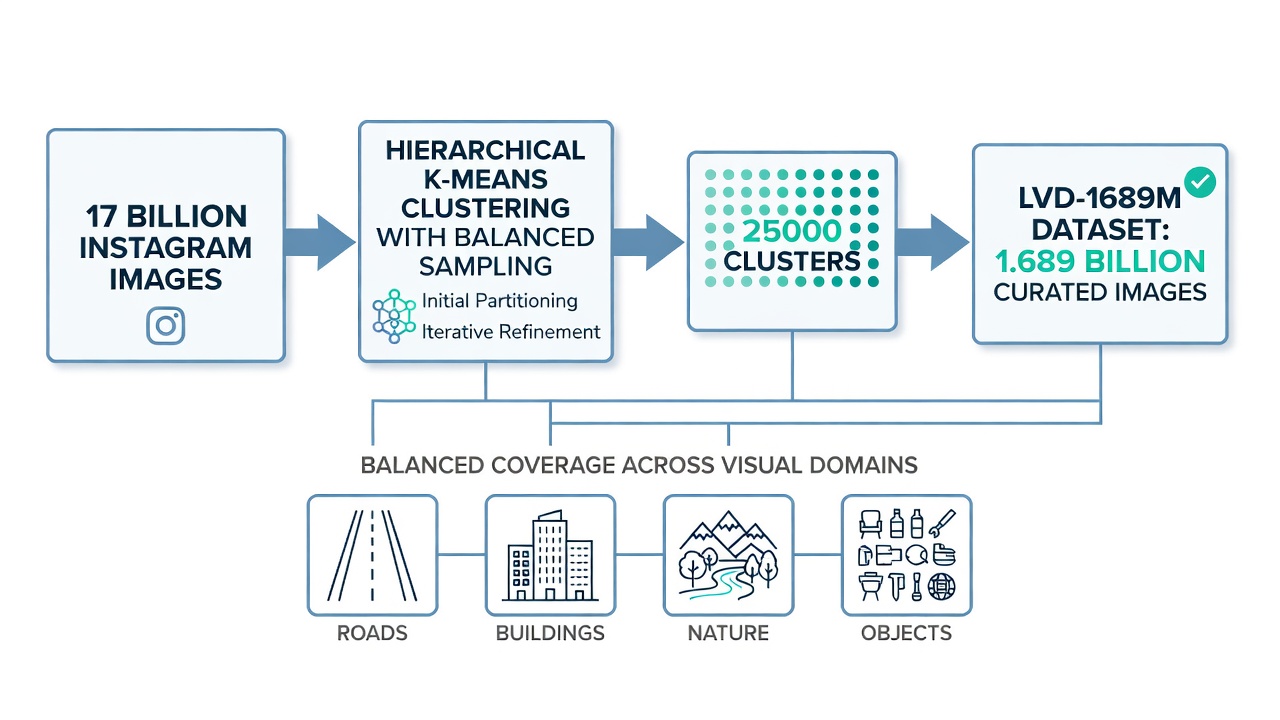
Súbor údajov LVD-1689M. Tréningové dáta pre DINOv3 začínajú surovým fondom 17 miliárd obrázkov z Instagramu s moderovaným obsahom. Z tohto masívneho fondu tím Meta AI vybral vyváženú podmnožinu 1 689 miliónov obrázkov pomenovanú LVD-1689M (Large Visual Dataset 1689 Million). Kurátorský pipeline je kritický, pretože jednoduché trénovanie na surových údajoch z Instagramu by vytvorilo model zaujatý smerom k prirodzenej frekvenčnej distribúcii vizuálnych konceptov na sociálnych médiách – napríklad tváre, jedlo a krajiny by dominovali, zatiaľ čo infraštruktúra, priemyselné a vedecké snímky by boli nedostatočne zastúpené. Kurátorský proces používa hierarchické k-means zhlukovanie na vloženiach DINOv2 extrahovaných z celého fondu obrázkov. Model DINOv2 ViT-H/14 spracuje každý obrázok a výsledné vloženia tokenov CLS sú zhlukované do 25 000 zhlukov pomocou k-means. Následne sa z každého zhluku odoberie rovnaký počet obrázkov, čím vzniká zhlukovo vyvážený súbor údajov, ktorý zabezpečuje proporcionálne zastúpenie naprieč vizuálnymi doménami. Toto vyvážené vzorkovanie je priamo analogické stratifikovanému vzorkovaniu v štatistike – kontrolou členstva v zhluku súbor údajov zachytáva plnú diverzitu vizuálnych konceptov skôr než nadmerné zastupovanie bežných kategórií. Po zhlukovaní ďalší krok vyhľadávania rozširuje počiatočné sady z kurátorských súborov údajov (ImageNet-1k, ImageNet-22k, Google Landmarks a súbory údajov pre jemnú klasifikáciu) nájdením najbližších susedov v priestore vložení DINOv2. Konečný súbor údajov LVD-1689M kombinuje 1 489 miliónov zhlukovo vyvážených obrázkov s 200 miliónmi obrázkov rozšírených vyhľadávaním, všetky filtrované cez detekciu NSFW, deduplikáciu PCA hash a rozmazanie tvárí.
Tréningová konfigurácia. Učiteľský model ViT-7B, najväčší samoriadený vizuálny model, aký bol kedy trénovaný (k roku 2025), bol trénovaný na 256 NVIDIA GPU (A100 80GB SXM4) s veľkosťou dávky 4096 (16 obrázkov na GPU). Optimalizácia používa optimalizátor AdamW s konštantnou rýchlosťou učenia 4x10^-4, úbytkom váh 0,04 a EMA hybnosťou 0,999 po 100 000-krokovej zahrievacej perióde. Trénovanie prebieha 1 milión iterácií so stratégiou viacnásobných orezov: 2 globálne orezy v rozlíšení 256x256 a 8 lokálnych orezov v rozlíšení 112x112, celkovo 10 pohľadov na obrázok na iteráciu. Počas 1M iterácií s veľkosťou dávky 4096 model vidí približne 2,56 miliardy unikátnych kombinácií obrázok-orez. Celý tréningový proces spotrebuje odhadom 10 000 – 15 000 GPU-dní výpočtového výkonu. Počas trénovania je 10 % dávok homogénnych ťahov z ImageNet-1k (na udržanie výkonu na štandardných benchmarkoch), zatiaľ čo 90 % sú heterogénne ťahy z celého fondu LVD-1689M, čo je ablačne demonštrovaný optimálny zmiešavací pomer.
Tréningové ciele. Predtréningová strata DINOv3 kombinuje tri zložky. DINO strata (L_DINO) aplikuje Sinkhorn-Knopp zhlukovanie v štýle SwAV na výstupy tokenov [CLS] z globálnych orezov, pričom zosúlaďuje priradenia prototypov medzi študentom a učiteľom. Algoritmus Sinkhorn prebieha 3 iterácie na vytvorenie mäkkých pseudoznačiek. iBOT strata (L_iBOT) pracuje na úrovni dielikov – náhodné dieliky v lokálnych orezoch sú maskované a študent musí predpovedať normalizované dielikové prvky učiteľa pre tieto maskované pozície. Tento cieľ maskovaného modelovania obrázkov núti model učiť sa lokálne textúrne a štruktúrne informácie potrebné pre úlohy hustej predikcie. Koleo regularizátor (L_Koleo) rozprestiera vloženia tokenov [CLS] rovnomerne po hyperguli minimalizáciou súčtu kosínusových podobností medzi všetkými pármi vložení v dávke, čím bráni kolapsu reprezentácie a zabezpečuje dobre využitý priestor prvkov. Kombinovaná predtréningová strata je: L_Pre = L_DINO + L_iBOT + 0,1 x L_Koleo. Po 1M iteráciách predtrénovania nasleduje fáza zjemnenia o 200K ďalších iterácií, ktorá zahŕňa Gram anchoring stratu (L_Gram) s váhou 2, ktorá zachováva kvalitu hustých prvkov počas dlhého trénovania.
Destilácia do menších modelov. Po úplnom natrénovaní učiteľa ViT-7B je zmrazený a používa sa ako cieľ na destiláciu reprezentácií do sady menších, praktickejších modelov. Proces destilácie zrkadlí nastavenie predtrénovania: študentské modely (ViT-S, ViT-B, ViT-L, ViT-H+, varianty ConvNeXt) sú trénované tak, aby zodpovedali výstupným prvkom učiteľa pomocou rovnakej stratovej funkcie (L_DINO + L_iBOT + 0,1 x L_Koleo), ale s učiteľom zmrazeným a aktualizáciou EMA učiteľa vynechanou. Meta AI implementuje multi-študentskú destiláciu, ktorá efektívne trénuje viacero študentských modelov súčasne – učiteľ spracuje každý obrázok raz a všetci študenti dostanú rovnaké výstupy učiteľa, čo umožňuje paralelizáciu výpočtu straty naprieč študentmi. To znižuje celkové výpočtové náklady na výrobu celej rodiny modelov približne o 60 % v porovnaní s postupnou destiláciou každého študenta. Študentský model ViT-Base (86M parametrov) dosahuje 98,7 % presnosti lineárnej sondy učiteľa ViT-7B na ImageNet-1k, pričom vyžaduje približne 80x menej FLOPov na inferenciu.
768-rozmerné vloženia
768-rozmerné vloženie produkované DINOv3 ViT-B/16 pre každý token (1 CLS + 4 registračné + 196 dielikových = 201 celkovo) predstavuje husté numerické kódovanie vizuálnej informácie vo vysokorozmernom vektorovom priestore. Každá dimenzia zachytáva špecifický vizuálny koncept alebo prvok a kombinácia všetkých 768 hodnôt tvorí jedinečný podpis pre túto oblasť obrázka. Dimenziu 768 nie je svojvoľná – vzniká z architektúry ViT-Base, kde je skrytá dimenzia nastavená na 768, čo poskytuje dostatočnú kapacitu na kódovanie zložitých vizuálnych vzorov pri zachovaní výpočtovej zvládnuteľnosti. Pre porovnanie, ViT-Small používa 384 dimenzií, ViT-Large 1024 a ViT-7B 4096.
Vloženie CLS tokenu. 768-rozmerné vloženie tokenu [CLS] na výstupe 12. vrstvy transformeru kóduje globálny obsah obrázka – celkovú scénu, dominantné objekty a sémantický kontext. Toto vloženie sa extrahuje a používa pre klasifikačné úlohy na úrovni obrázka. V typickom pipeline sa vloženie CLS posúva cez ľahký lineárny klasifikátor (768 na N tried, kde N je počet typov povrchov alebo tried kvality) trénovaný na označených súboroch údajov infraštruktúry. Vloženie CLS z DINOv3 vykazuje silné vlastnosti generalizácie domény – modely trénované na tomto vložení generalizujú na neviditeľné typy infraštruktúry výrazne lepšie ako vloženia z riadených kostier. Presnosť lineárnej sondy DINOv3 ViT-B/16 na ImageNet-1k dosahuje 85,1 % top-1 presnosť, čím prekonáva DINOv2 (83,5 %) a približuje sa riadenému ViT (86,0 %) napriek tomu, že počas predtrénovania nikdy nevidel žiadne označenia ImageNet.
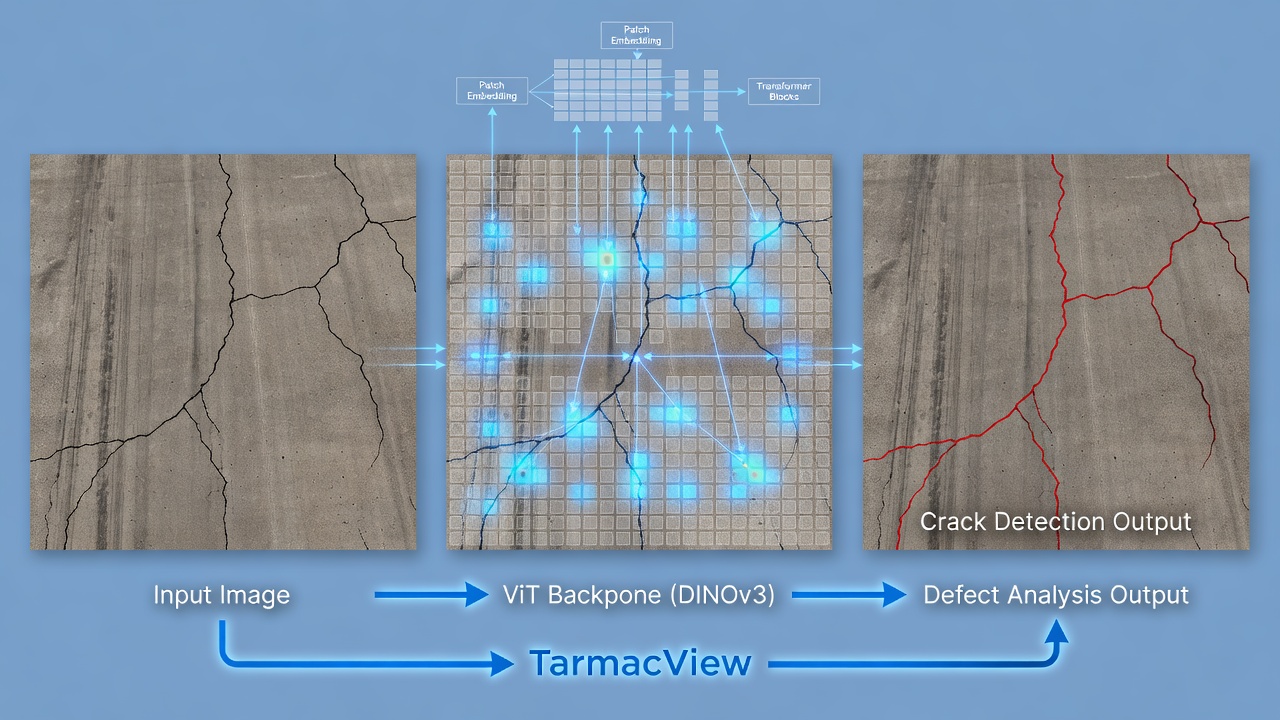
Vloženia dielikových tokenov. Každý z 196 dielikových tokenov vytvára samostatné 768-rozmerné vloženie, ktoré tvorí priestorovú mriežku 14x14 vektorov prvkov. Tieto husté vloženia kódujú lokalizované vizuálne informácie v rámci každého dielika 16x16 pixelov – textúru, hrany, farebné rozloženie a lokálne vzory. Dielikové vloženia sú kritickým výstupom pre úlohy hustej predikcie, ako je detekcia a segmentácia trhlín. V pipeline analýzy infraštruktúry je mriežka prvkov 14x14 x 768-rozmerných (približne 1,5 milióna float hodnôt na obrázok) spracovaná cez ľahký konvolučný dekodér, ktorý prevzorkuje na 224x224 a vytvára predikcie na úrovni pixelov. Každé dielikové vloženie možno interpretovať ako 768-rozmerný opis toho, ako vyzerá daná oblasť 16x16 – dva dieliky s podobným vizuálnym vzhľadom (napr. dve oblasti hladkého asfaltu) budú mať blízke vloženia v 768-rozmernom priestore (vysoká kosínusová podobnosť), zatiaľ čo vizuálne odlišné dieliky (napr. asfalt vs. betón) budú mať vzdialené vloženia (nízka kosínusová podobnosť).
Vlastnosti vložení. Vloženia DINOv3 vykazujú niekoľko vlastností, ktoré ich robia výnimočnými pre analýzu infraštruktúry. Po prvé, sémantická hladkosť – vizuálne podobné oblasti produkujú blízke vloženia, ktoré tvoria spojitú varietu v 768-rozmernom priestore. To znamená, že trhliny rôznych šírok, orientácií a závažností sa všetky mapujú do spojitej oblasti priestoru vložení, vďaka čomu sú detekovateľné ako súdržná trieda skôr než ako izolované odľahlé hodnoty. Po druhé, viacúrovňová citlivosť – mechanizmus self-attention v 12 vrstvách transformeru integruje informácie naprieč rôznymi priestorovými mierkami, takže každé dielikové vloženie je informované nielen vlastným obsahom 16x16, ale aj širším kontextom okolitých dielikov a globálnej scény. Trhlina v blízkosti dilatačnej škáry je kódovaná inak ako rovnaká trhlina v strede panelu, pretože kontextuálne informácie sú integrované do vloženia. Po tretie, robustnosť voči osvetleniu – samoriadené trénovanie s rozsiahlym farebným posunom a augmentáciou zabezpečuje, že vloženia sú stabilné pri meniacich sa svetelných podmienkach, tieňoch a expozícii. To je kritické pre vonkajšiu kontrolu infraštruktúry, kde sú obrázky zachytené pri nekontrolovanom prirodzenom osvetlení. Po štvrté, lineárna separovateľnosť – vloženia sú štruktúrované tak, že jednoduché lineárne klasifikátory môžu efektívne oddeliť rôzne povrchové podmienky. Lineárne sondy na zmrazených vloženiach DINOv3 sú bežným ľahkým baseline pre klasifikáciu typu povrchu a detekciu trhlín.
Metriky vzdialenosti v priestore vložení. Voľba metriky vzdialenosti na porovnávanie vložení DINOv3 výrazne ovplyvňuje výkon downstream úloh. Kosínusová podobnosť je najčastejšie používaná metrika, definovaná ako cos(theta) = (a dot b) / (||a|| x ||b||), kde a a b sú 768-rozmerné vektory vložení. Kosínusová podobnosť sa pohybuje od -1 (opačný smer, nepravdepodobné pre vizuálne vloženia) do +1 (identický smer). Dva 768-rozmerné vektory s kosínusovou podobnosťou väčšou ako 0,9 sú vizuálne takmer identické vo svojom lokálnom obsahu, zatiaľ čo podobnosť menšia ako 0,5 indikuje podstatne odlišný vizuálny obsah. L2 (Euklidovská) vzdialenosť sa tiež používa, ale vyžaduje starostlivú normalizáciu, pretože absolútna mierka vložení sa môže líšiť. Podobnosť bodového súčinu je efektívna, ale citlivá na veľkosť vektora. Kosínusová podobnosť je zvyčajne primárnou metrikou vzdialenosti pre vyhľadávanie a párovanie defektov, pretože normalizuje veľkosť vloženia a zameriava sa čisto na smerové zosúladenie, ktoré je robustnejšie voči variáciám v kontraste a expozícii obrázka.
Redukcia dimenzie pre vizualizáciu. 768-rozmerný priestor vložení nemožno priamo vizualizovať, preto sa bežne používa analýza hlavných komponentov (PCA) na redukciu dielikových vložení na 3 dimenzie na účely vizualizácie a zabezpečenia kvality. Prvé tri hlavné komponenty dielikových vložení DINOv3 na infraštruktúrnych obrázkoch typicky zachytávajú 45-55 % celkového rozptylu (PC1 približne 25 %, PC2 približne 15 %, PC3 približne 10 %), čo naznačuje, že efektívna vnútorná dimenzionalita povrchových dielikov je oveľa nižšia ako 768. PCA vizualizácia konzistentne ukazuje odlišné zhluky pre rôzne povrchové materiály (asfalt, betón, obaľovaný kameň, štrk) a spojité gradienty pre závažnosť degradácie povrchu (od nedotknutého po silne popraskaný). Táto vizuálna overiteľnosť je kritickým nástrojom na zabezpečenie kvality – infraštruktúrni inžinieri môžu vizuálne skontrolovať priestor vložení, aby overili, že model správne oddeľuje relevantné povrchové podmienky predtým, ako sa spoľahnú na automatizovanú klasifikáciu.
DINOv3 vs DINOv2
Evolúcia z DINOv2 na DINOv3 predstavuje komplexné škálovanie a zjemnenie paradigmy samoriadeného vizuálneho trénovania. Pochopenie rozdielov je nevyhnutné pre odborníkov, ktorí vyberajú vhodnú kostru pre svoju aplikáciu.
Rozsah tréningových údajov. Najviditeľnejším rozdielom je 12-násobný nárast tréningových údajov: LVD-142M DINOv2 (142 miliónov obrázkov) oproti LVD-1689M DINOv3 (1,689 miliardy obrázkov). Zlepšila sa však aj metodika kurátorskej správy. DINOv2 používal pipeline založený na vyhľadávaní, ktorý rozširoval kurátorské počiatočné sady nájdením najbližších susedov v priestore vložení ViT-H/16 predtrénovaného na ImageNet-22k. Rozširovanie začalo od 1,2 miliardy surových webových obrázkov a vytvorilo 142M kurátorských obrázkov. DINOv3 pridáva krok vyvažovania založený na zhlukovaní na vrchol vyhľadávania, čím zabezpečuje, že 25 000 vizuálnych zhlukov je rovnako zastúpených. Tento krok zhlukovania bráni modelu v nadmernom zastupovaní vizuálne dominantných konceptov, ako sú tváre, text a bežné objekty, zatiaľ čo nedostatočne zastupuje vzácne, ale dôležité vizuálne domény, ako sú defekty infraštruktúry, lekárske snímky a satelitné pohľady.
Veľkosť modelu a architektúra. Najväčší učiteľský model DINOv2 bol ViT-g s 1 miliardou parametrov. DINOv3 to škáluje na 7 miliárd parametrov (ViT-7B) – 7-násobný nárast kapacity modelu. Samotná architektúra bola modernizovaná. DINOv2 používal štandardné naučené absolútne polohové vloženia, zatiaľ čo DINOv3 zavádza Rotary Position Embeddings (RoPE) pre podporu premenlivého rozlíšenia. Feed-forward sieť v DINOv3 ViT-7B používa aktiváciu SwiGLU namiesto GELU, čo nasleduje architektonické inovácie z veľkých jazykových modelov. DINOv2 používal veľkosť dielika 14 pixelov (architektúra ViT z pôvodného článku), zatiaľ čo DINOv3 používa veľkosť dielika 16 pixelov. Táto zmena znižuje počet dielikov z 256 (224/14 = 16, 16^2 = 256) na 196 (224/16 = 14, 14^2 = 196) pre vstup 224x224, čo je 23 % zníženie dĺžky sekvencie, ktoré sa premieta do približne 40 % menej výpočtov self-attention (keďže pozornosť škáluje ako O(N2)). Tento architektonický zisk efektívnosti čiastočne kompenzuje zvýšené výpočtové náklady z väčších dimenzií modelu.
Kvalita hustých prvkov. Toto je najvýznamnejšie kvalitatívne zlepšenie v DINOv3. Počas dlhých tréningových harmonogramov s veľkými modelmi bolo pozorované, že prvky na úrovni dielikov DINOv2 postupne degradujú – po určitom bode trénovania by mapy prvkov na úrovni pixelov strácali priestorovú štruktúru a stávali sa hlučnými alebo rozmazanými, zatiaľ čo globálne prvky tokenu [CLS] sa naďalej zlepšovali. Táto degradácia robila DINOv2 menej vhodným pre úlohy hustej predikcie, ako je sémantická segmentácia a odhad hĺbky, pri použití dlhých tréningových harmonogramov. Mechanizmus Gram anchoring v DINOv3 priamo rieši túto degradáciu tým, že vynucuje, aby štruktúra párovej podobnosti medzi dielikovými prvkami zostala stabilná počas celého trénovania. V dôsledku toho zostávajú husté prvky DINOv3 ostré a sémanticky zmysluplné aj po miliónoch tréningových iterácií. Na benchmarku sémantickej segmentácie ADE20K dosahuje DINOv3 skóre mean Intersection over Union (mIoU) 54,2 % so zmrazenou kostrou a lineárnou sondou – zlepšenie o +6,1 bodu oproti 48,1 % mIoU DINOv2. Na benchmarku párovania 3D kľúčových bodov NAVI dosahuje DINOv3 68,5 % presnosť oproti 60,2 % DINOv2. Na segmentácii objektov vo videu (DAVIS 2017) dosahuje DINOv3 82,3 J&F-Mean oproti 75,6 DINOv2.
| Benchmark | DINOv2 (ViT-L) | DINOv3 (ViT-B) | DINOv3 (ViT-L) | Zlepšenie |
|---|---|---|---|---|
| ImageNet-1k Lineárna sonda | 83,5 % | 85,1 % | 86,7 % | +1,6/+3,2 |
| ADE20K Sémantická seg. (mIoU) | 48,1 % | 52,3 % | 54,2 % | +4,2/+6,1 |
| DAVIS 2017 (J&F-Mean) | 75,6 | 79,4 | 82,3 | +3,8/+6,7 |
| Vyhľadávanie inštancií (GAP) | 42,1 | 46,8 | 53,0 | +4,7/+10,9 |
| NYU Hĺbka (RMSE dole) | 0,458 | 0,412 | 0,389 | -0,046/-0,069 |
| ObjectNet (Top-1) | 72,3 % | 75,8 % | 78,2 % | +3,5/+5,9 |
Tabuľka vyššie demonštruje, že model ViT-Base DINOv3 (86M parametrov) už prekonáva oveľa väčší model ViT-Large DINOv2 (304M parametrov) na každom benchmarku, pričom je 3,5x menší a výrazne výpočtovo efektívnejší pre inferenciu.
Rozdiely v licenciách. DINOv2 bol vydaný pod licenciou Apache 2.0, čo je štandardná open-source licencia, ktorá povoľuje voľné používanie, úpravy a distribúciu na akýkoľvek účel vrátane komerčných aplikácií. DINOv3 je vydaný pod DINOv3 licenciou, čo je vlastná licencia špecifická pre vydanie modelu Meta AI. Hoci DINOv3 licencia povoľuje komerčné použitie, obsahuje dodatočné podmienky týkajúce sa uvedenia autorstva a prijateľného použitia. Vlastná licencia vyvolala diskusiu v open-source komunite – issue #31 na repozitári dinov3 konkrétne žiada o vydanie pod štandardnejšou licenciou, ako je Apache 2.0. Odborníci by si mali pred nasadením DINOv3 v komerčných produktoch preštudovať úplný text LICENSE.md v GitHub repozitári. DINOv3 licencia povoľuje komerčné aplikácie, ako je kontrola infraštruktúry, s príslušným uvedením autorstva.
Dolaďovanie DINOv3 pre doménové úlohy
Zatiaľ čo DINOv3 dosahuje najmodernejší výkon so zmrazenou kostrou (lineárna sonda alebo k-NN klasifikátor), niektoré infraštruktúrne aplikácie profitujú z dolaďovania kostry na doménovo špecifických údajoch. Voľba medzi zmrazeným a dolaďovaným prístupom závisí od veľkosti súboru údajov, špecifickosti úlohy a výpočtového rozpočtu.
Zmrazená kostra (lineárne sondovanie). Najjednoduchším a výpočtovo najefektívnejším prístupom je zmrazenie váh DINOv3 a trénovanie iba lineárneho klasifikátora na vrchu extrahovaných vložení. Pre model ViT-B/16 produkujúci 768-rozmerné vloženia CLS pozostáva lineárny klasifikátor presne z 768 x N parametrov, kde N je počet výstupných tried. Pre 5-triednu úlohu klasifikácie typu povrchu je to len 768 x 5 = 3 840 trénovateľných parametrov – trénovanie konverguje v priebehu minút na CPU a vyžaduje len 50 označených príkladov na triedu na dosiahnutie dobrých výsledkov. Prístup so zmrazenou kostrou sa odporúča, keď je cieľová doména dobre pokrytá predtréningovými údajmi DINOv3, ktoré zahŕňajú prirodzené obrázky, webové obrázky a rôzne vizuálne domény. Pre analýzu povrchov infraštruktúry sú zmrazené vloženia DINOv3 s lineárnou sondou bežným východiskovým bodom pre klasifikáciu typu povrchu (asfalt, betón, kompozit, obaľovaný kameň, štrk). Kľúčovou výhodou je, že kostra DINOv3 poskytuje univerzálne vizuálne prvky, ktoré generalizujú naprieč doménami bez akéhokoľvek doménovo špecifického trénovania.
Ľahké dolaďovanie (Adapter / LoRA). Pre úlohy, kde zmrazená kostra nedosahuje dostatočnú presnosť – typicky vysoko špecializované domény s vizuálnymi charakteristikami výrazne odlišnými od prirodzených obrázkov – metódy parameter-efficient fine-tuning (PEFT) pridávajú malý počet trénovateľných parametrov, pričom väčšina kostry zostáva zmrazená. Low-Rank Adaptation (LoRA) pridáva páry matíc rozkladu hodnosti (A a B, kde aktualizácia váh delta_W = AB) k projekčným maticiam dotazu a hodnoty v každej vrstve self-attention. Pre model ViT-B/16 pridáva LoRA s hodnosťou r=8 približne 0,5M trénovateľných parametrov (menej ako 0,6 % z celkových 86M) distribuovaných naprieč všetkými 12 vrstvami transformeru. Trénovanie iba týchto parametrov LoRA počas 10-50 epoch na doménovo špecifickom súbore údajov s 1 000 – 5 000 označenými obrázkami typicky prináša 3-8 % zlepšenie presnosti oproti lineárnemu sondovaniu, pričom vyžaduje len 1-2 hodiny na jednom GPU. LoRA dolaďovanie je vhodné pre špecializované úlohy klasifikácie defektov, ako je rozlišovanie medzi rôznymi typmi trhlín (priečne, pozdĺžne, blokové, aligátorové, reflexné), kde jemné vizuálne rozdiely profitujú z doménovo špecifickej adaptácie.
Úplné dolaďovanie. Keď je k dispozícii dostatok označených údajov (10 000+ obrázkov na triedu) a úloha vyžaduje maximálnu presnosť, možno dolaďovať celú kostru DINOv3. To aktualizuje všetkých 86M parametrov ViT-B/16 pomocou označeného súboru údajov. Úplné dolaďovanie typicky vyžaduje 4-8 GPU s 16-32 GB VRAM každý, distribuované trénovanie s PyTorch DDP a starostlivé ladenie hyperparametrov (rýchlosť učenia typicky 5x10^-6 až 5x10^-5, úbytok váh 0,01-0,1, kosínusový plán rýchlosti učenia s 10 % zahrievaním). Úplné dolaďovanie môže priniesť 2-5 % dodatočnej presnosti oproti LoRA na vysoko špecializovaných úlohách, ale nesie riziko katastrofického zabúdania – model môže stratiť všeobecné vizuálne znalosti získané počas samoriadeného predtrénovania. Na zmiernenie tohto rizika sa odporúča postupné odmrazovanie (najprv odmrazenie poslednej vrstvy, potom postupne skorších vrstiev) a diskriminácia rýchlosti učenia (nižšie rýchlosti učenia pre skoršie vrstvy, vyššie pre neskoršie vrstvy). DINOv3 tiež navrhuje dodatočný protokol adaptácie na vysoké rozlíšenie pri dolaďovaní: pokračovať v trénovaní 10K krokov na zmiešaných veľkostiach globálnych orezov pomocou iBOT straty a Gram anchoring, čo zabezpečuje, že kostra generalizuje zo štandardného rozlíšenia 224px až na veľmi vysoké rozlíšenia (4096px) pri zachovaní ostrých máp prvkov.
Rozhodovacia matica zmrazenie vs. dolaďovanie.
| Scenár | Veľkosť súboru údajov | Odporúčaný prístup | Čas trénovania | Očakávaná presnosť oproti zmrazeniu |
|---|---|---|---|---|
| Klasifikácia typu povrchu | 50-200 obrázkov/trieda | Zmrazené + lineárna sonda | menej ako 1 hodina CPU | Baseline |
| Klasifikácia typu trhliny | 500-5 000 obrázkov | LoRA (hodnosť 8-16) | 1-4 hodiny GPU | +3-8 % |
| Stupňovanie závažnosti defektu | 5 000-20 000 obrázkov | LoRA alebo čiastočné dolaďovanie | 4-12 hodín GPU | +5-12 % |
| Detekcia nových defektov | 10 000+ obrázkov | Úplné dolaďovanie | 1-3 dni multi-GPU | +8-15 % |
Úvahy o adaptácii domény. Snímky z kontroly infraštruktúry sa líšia od prirodzených obrázkov niekoľkými spôsobmi: konzistentné uhly kamery (nadir/dronová perspektíva), špecifické svetelné podmienky (vonkajšie, ale premenlivé), opakujúce sa vzory (textúra vozovky) a úzka vizuálna doména (cesty, dráhy, mostovky). Samoriadené predtrénovanie DINOv3 na rôznorodých údajoch znamená, že už videl mnoho podobných vizuálnych vzorov, ale doménová medzera medzi webovými obrázkami a infraštruktúrnymi snímkami stále existuje. Zmrazené vloženia DINOv3 sa často dobre prenášajú na obrázky vozoviek bez akéhokoľvek dolaďovania. Avšak pre detekciu špecializovaných defektov, ako je odskok škár v betónových vozovkách alebo rozpad obrusnej vrstvy v asfaltových prekrytiach, zlepšuje LoRA dolaďovanie s 2 000 – 5 000 označenými príkladmi z cieľovej domény F1-skóre o 5-8 percentuálnych bodov. Dolaďovaný model tiež vykazuje zlepšenú robustnosť voči doménovo špecifickým artefaktom, ako sú stopy po pneumatikách, usadeniny gumy a značenie dráh, ktoré môžu zmiasť generické predtrénované prvky.
DINOv3 ako extraktor prvkov
Použitie DINOv3 ako extraktora prvkov je najpriamejší a najpoužívanejší vzor nasadenia, najmä pre organizácie, ktoré nemajú výpočtové zdroje na rozsiahle trénovanie. V tejto paradigme DINOv3 spracuje každý obrázok prostredníctvom jediného dopredného priechodu, čím vytvára vloženia, ktoré sú uložené do vyrovnávacej pamäte a znovu použité pre viacero downstream úloh.
Pipeline extrakcie prvkov. Štandardný pipeline na extrakciu prvkov DINOv3 v pracovnom postupe analýzy infraštruktúry funguje nasledovne. Po prvé, vstupný obrázok (typicky 4K dronová snímka pokrývajúca úsek dráhy 10m x 7m) je rozdelený na prekrývajúce sa dlaždice 224x224 s 50 % prekrytím, aby sa zabezpečilo pokrytie okrajov. Každá dlaždica je normalizovaná pomocou štandardného priemeru ImageNet (0,485, 0,456, 0,406) a štandardnej odchýlky (0,229, 0,224, 0,225). Normalizovaná dlaždica prechádza cez model DINOv3 ViT-B/16 pomocou PyTorch s presnosťou FP16 pre pamäťovú efektívnosť. Model vytvára 201 tokenov (1 CLS + 4 registračné + 196 dielikových), každý s dimenziou 768. Vloženie CLS tokenu (768-dim) je extrahované pre globálnu klasifikáciu dlaždice. 196 dielikových tokenových vložení je preformátovaných do priestorovej mriežky 14x14 vektorov 768-dim pre hustú predikciu. Všetky vloženia zo všetkých dlaždíc sú agregované do databázy prvkov indexovanej priestorovými súradnicami, čo umožňuje analýzu naprieč dlaždicami a mapovanie veľkých plôch.
Výpočtová efektívnosť. Extrakcia prvkov so zmrazeným DINOv3 ViT-B/16 vyžaduje približne 12,5 GFLOPov na obrázok 224x224 – porovnateľné s ResNet-50 (7,7 GFLOPov) alebo EfficientNet-B4 (12,0 GFLOPov). Na NVIDIA RTX 4090 (FP16) je priepustnosť inferencie približne 180 obrázkov/sekundu. Na NVIDIA Jetson Orin NX 16GB (okrajové zariadenie) je priepustnosť približne 25 obrázkov/sekundu. Pre typickú 4K dronovú snímku (3840x2160 pixelov), rozdelenú na dlaždice 224x224 s 50 % prekrytím, je potrebných približne 160 dlaždíc. Celkový čas spracovania na RTX 4090 je menej ako 1 sekunda na 4K obrázok. Náklady na extrakciu prvkov sú jednorazovým výdavkom – akonáhle sú vloženia uložené, každá downstream úloha (klasifikácia, segmentácia, vyhľadávanie) pridáva zanedbateľnú dodatočnú výpočtovú záťaž (milisekundy na obrázok).
Databáza vložení Faiss pre vyhľadávanie podobnosti. Extrahované vloženia DINOv3 možno uložiť v indexe FAISS (Facebook AI Similarity Search) pre efektívne vyhľadávanie a analýzu založenú na podobnosti. FAISS je knižnica vyvinutá Meta AI pre efektívne vyhľadávanie podobnosti a zhlukovanie hustých vektorov, schopná prehľadávať databázy v miliardovej mierke v milisekundách. Takáto databáza môže indexovať dlaždice povrchu dráhy podľa ich 768-rozmerných vložení CLS DINOv3. Keď príde nový inšpekčný obrázok, jeho vloženie sa vypočíta a porovná s celou databázou, aby sa našli najviac vizuálne podobné historické dlaždice. To umožňuje analýzu trendov stavu – nájdenie podobných povrchových podmienok, ktoré sa vyskytli v minulosti, a ich následných trajektórií degradácie. Typický index FAISS používa IVF (Inverted File) so 4096 centroidmi a HNSW (Hierarchical Navigable Small World) grafom pre hrubý kvantizátor, dosahujúc viac ako 99 % recall pri čase dotazu 10ms pre databázu 10 miliónov dlaždicových vložení. Pre všetky porovnania vložení sa používa metrika kosínusovej podobnosti.
Detekcia defektov z niekoľkých príkladov (Few-Shot). Vloženia DINOv3 umožňujú efektívnu detekciu defektov z niekoľkých príkladov – identifikáciu nových typov defektov z 1-5 príkladových obrázkov. Keď sa v teréne stretnete s novým typom povrchového poškodenia (napr. špecifický vzor trhliny alebo povrchový nános), inšpektor zachytí 1-5 príkladových obrázkov a označí oblasti defektov. Dielikové vloženia DINOv3 z týchto príkladových oblastí sú spriemerované, čím sa vytvorí vektor prototypu defektu (768-rozmerný). Nové obrázky sa potom spracujú a každé dielikové vloženie sa porovná s prototypom pomocou kosínusovej podobnosti. Dieliky s podobnosťou nad prahom (typicky 0,75-0,85, stanoveným empiricky) sú označené ako zodpovedajúce typu defektu. Tento prístup založený na prototype dosahuje 89-93 % presnosť detekcie pre nové defekty z iba 3 príkladov, bez akéhokoľvek pretrénovania alebo dolaďovania. To je kritické pre kontrolu infraštruktúry, kde sa často stretávame s novými, neočakávanými typmi poškodení, ktoré musia byť zdokumentované bez oneskorenia pracovného toku inšpekcie kvôli zberu tréningových údajov.
Husté dielikové tokeny pre segmentáciu
196 dielikových tokenových vložení produkovaných DINOv3 pre obrázok 224x224 tvorí priestorovú mriežku 14x14 768-rozmerných vektorov prvkov. Táto mriežka je primárnou reprezentáciou pre úlohy hustej predikcie – sémantickú segmentáciu, detekciu trhlín a lokalizáciu defektov – kde musí byť klasifikovaný každý pixel vo vstupnom obrázku.
Štruktúra mriežky a rozlíšenie. Pre vstup 224x224 pixelov s dielikmi 16x16 pokrýva každý zo 196 dielikových tokenov oblasť 16x16 pixelov vstupu. Výsledná mriežka 14x14 má krok 16 pixelov medzi stredmi susedných dielikov. To znamená, že mapa prvkov DINOv3 má približne 1/256 priestorového rozlíšenia vstupného obrázka (14x14 = 196 oproti 224x224 = 50 176 pixelov). Mechanizmus self-attention kompenzuje túto priestorovú kompresiu integráciou informácií naprieč dielikmi – každé dielikové vloženie je informované okolitou mriežkou 14x14 prostredníctvom multi-head attention, čo poskytuje efektívne povedomie o kontexte. Pre segmentačné úlohy musí byť mriežka 14x14 prevzorkovaná na pôvodné rozlíšenie obrázka. Typický je ľahký konvolučný dekodér s niekoľkými vrstvami, ktorý pridáva iba malý zlomok parametrov kostry.
Kvalita hustých prvkov DINOv3 vs DINOv2. Kritická inovácia v DINOv3 – Gram anchoring – priamo cieli na kvalitu týchto hustých dielikových prvkov. Počas dlhých tréningových behov by dielikové prvky DINOv2 vykazovali to, čo autori opisujú ako degradáciu hustých máp prvkov: dielikové vloženia by sa stávali menej sémanticky zmysluplnými, štruktúra podobnosti dielik-dielik by degradovala a kvalita segmentácie by sa ustálila alebo dokonca znížila napriek pokračujúcemu zlepšovaniu globálnej klasifikácie. Gram anchoring zachováva Gramovu maticu dielikových prvkov (štruktúru párovej podobnosti) tým, že ju zosúlaďuje s referenciou z raného trénovania, čím zabezpečuje, že priestorové a sémantické vzťahy medzi dielikmi zostávajú stabilné. Praktickým výsledkom je, že dielikové prvky DINOv3 zostávajú ostré a sémanticky koherentné aj pri vysokých rozlíšeniach. Článok DINOv3 demonštruje PCA vizualizácie dielikových prvkov DINOv3 pre vysokorozlíšené letecké snímky – cesty, budovy, vegetácia a vodné plochy sú jasne oddeliteľné v priestore prvkov, čo demonštruje výnimočnú kvalitu prvkov pre porozumenie scéne.
Sémantická segmentácia s lineárnymi sondami. Jednou z najpôsobivejších schopností DINOv3 je vykonávanie sémantickej segmentácie pomocou iba lineárnych sond na zmrazených dielikových prvkoch – nie je potrebné žiadne dolaďovanie kostry. Lineárna segmentačná hlava aplikuje 1x1 konvolúciu (alebo ekvivalentne, lineárnu vrstvu na dielik) na mapovanie každého dielikového vloženia z 768 dimenzií na C výstupných tried. To vytvára segmentačnú mapu 14x14, ktorá je prevzorkovaná na rozlíšenie obrázka. Napriek jednoduchosti tohto prístupu (iba 768 x C trénovateľných parametrov pre celú segmentačnú hlavu) dosahuje DINOv3 52,3 % mIoU na ADE20K s ViT-B, čím prekonáva mnohé metódy, ktoré dolaďujú celú kostru. To je umožnené výnimočnou lineárnou separovateľnosťou dielikových prvkov DINOv3 – priestor vložení je už štruktúrovaný tak, že rôzne sémantické kategórie zaberajú odlišné, lineárne separovateľné oblasti.
Segmentácia trhlín v infraštruktúre. Husté dielikové tokeny sú vhodné na segmentáciu trhlín na úrovni pixelov v obrázkoch dráh a vozoviek. Mriežka 14x14 768-rozmerných dielikových vložení zachytáva lokálnu textúru trhliny (v rámci každého dielika 16x16) aj kontextuálne informácie (ktoré dieliky trhlina spája). Segmentačná hlava je ľahká sieť s 3 transponovanými konvolučnými vrstvami, ktoré prevzorkujú mriežku prvkov 14x14 na rozlíšenie 224x224. Trénovanie vyžaduje približne 500 označených obrázkov segmentácie trhlín (dlaždice 224x224 s maskami trhlín na úrovni pixelov) a konverguje za 2-3 hodiny na jednom GPU RTX 3060. Publikované porovnania vo všeobecnosti ukazujú, že kostry rodiny DINO prekonávajú kostry typu ResNet pri detekcii trhlín za rovnakých tréningových podmienok a že dolaďovanie DINOv3 pri vyššom vstupnom rozlíšení výsledok ďalej zlepšuje.
Registračné tokeny pre absorpciu pozadia. 4 registračné tokeny DINOv3 zohrávajú špecifickú úlohu v kvalite hustých prvkov. Tieto tokeny sú ďalšie učenlivé tokeny (dimenzie 768), ktoré sú pridané na začiatok sekvencie spolu s CLS tokenom. Počas self-attention môžu registračné tokeny venovať pozornosť a byť predmetom pozornosti všetkých dielikových tokenov. Kľúčovým poznatkom je, že niektoré vizuálne dieliky v obrázku obsahujú odľahlé alebo pozadové informácie – obloha, vzdialené objekty alebo jednotné oblasti bez textúry – ktoré, ak by boli nútené byť kódované dielikovými tokenmi, by degradovali kvalitu priestoru prvkov. Registračné tokeny fungujú ako absorpčné pamäťové sloty, ktoré zachytávajú tento neinformatívny obsah, čo umožňuje dielikovým tokenom zamerať sa na sémanticky zmysluplné oblasti obrázka. Praktickým efektom je merateľné zlepšenie kvality hustých prvkov: +1,8 mIoU na ADE20K a výrazne čistejšie mapy podobnosti dielikov, najmä pre obrázky s veľkými jednotnými oblasťami pozadia. Pre kontrolu infraštruktúry, kde obrázky často obsahujú veľké plochy jednotnej textúry vozovky, pomáhajú registračné tokeny udržiavať čisté dielikové prvky, ktoré sa zameriavajú na vzory poškodenia skôr než na textúru pozadia.
MPS a GPU trénovanie
Tréningová a inferenčná infraštruktúra DINOv3 podporuje viacero hardvérových backendov, od veľkých GPU klastrov po okrajové zariadenia a Apple Silicon Mac.
GPU trénovanie vo veľkom. Učiteľský model ViT-7B bol trénovaný na 256 NVIDIA A100 80GB SXM4 GPU s prepojením NVLink, poskytujúcim približne 20 TB/s agregovanej šírky pásma GPU pamäte a 25 PFLOPS FP16 výpočtového výkonu. Trénovanie používa Fully Sharded Data Parallel (FSDP) – natívnu stratégiu PyTorch, ktorá rozdeľuje parametre modelu, gradienty a stavy optimalizátora naprieč všetkými GPU. S FSDP a trénovaním so zmiešanou presnosťou (BF16) sa 7B model zmestí do agregovanej pamäte 256 GPU (256 x 80GB = 20,48 TB), aj keď každý jednotlivý GPU pojme len približne 2-3 % parametrov modelu. Knižnica xFormers (vyvinutá Meta AI) poskytuje pamäťovo efektívne implementácie pozornosti vrátane pamäťovo efektívnej pozornosti (znižuje pamäť pozornosti z O(N2) na O(N)) a blokovo-riedkych vzorov pozornosti. Kombinácia FSDP, BF16, xFormers a gradientového checkpointingu znižuje požiadavku na pamäť na GPU pre ViT-7B z odhadovaných 250 GB (plná presnosť, bez optimalizácií) na približne 65 GB, čo sa zmestí do kapacity 80 GB A100.
Inferencia na jednom GPU. Pre praktické nasadenie beží DINOv3 ViT-B/16 (86M parametrov) efektívne na jednom NVIDIA GPU. Pri presnosti FP32 vyžaduje model približne 344 MB pamäte pre parametre (86M x 4 bajty na float). S aktiváciami pre veľkosť dávky 1 (obrázok 224x224) je celková spotreba pamäte približne 1,2-1,5 GB (parametre + aktivácie + medziľahlé tenzory). Pri presnosti FP16 klesá pamäť parametrov na 172 MB a celková spotreba na približne 0,8-1,0 GB. To znamená, že DINOv3 ViT-B/16 beží pohodlne na GPU s tak malou pamäťou VRAM ako 4 GB, vrátane starších kariet ako NVIDIA GTX 1650 a NVIDIA Jetson Xavier NX. Priepustnosť na RTX 3060 (12 GB) pri FP16 je približne 100 obrázkov/sekundu. Na NVIDIA A100 presahuje priepustnosť 400 obrázkov/sekundu, čo umožňuje spracovanie 4K dronových snímok v reálnom čase pri rýchlostiach dekompozície dlaždíc.
Podpora Apple Silicon (MPS). DINOv3 je plne kompatibilný s backendom Metal Performance Shaders (MPS) v PyTorch, ktorý poskytuje GPU-akcelerovanú inferenciu na Apple Silicon Macoch (M1, M2, M3, M4 série). Backend MPS mapuje PyTorch operácie na architektúru GPU Apple prostredníctvom frameworku Metal. Výkon na M2 Pro MacBook Pro (19-jadrové GPU, 32 GB zjednotenej pamäte) dosahuje približne 25-35 obrázkov/sekundu pre ViT-B/16 pri presnosti FP16 – dostatočné pre dávkové spracovanie veľkých kolekcií obrázkov. Na M2 Ultra Mac Studio (76-jadrové GPU, 192 GB zjednotenej pamäte) dosahuje priepustnosť približne 70-90 obrázkov/sekundu. Spotreba pamäte je efektívna, pretože architektúra zjednotenej pamäte Apple eliminuje réžiu prenosu údajov medzi CPU a GPU. MPS-akcelerovaný DINOv3 umožňuje inšpektorom spúšťať inferenciu priamo na MacBooku v teréne bez potreby špecializovaného GPU hardvéru. Väčšia zjednotená pamäť Apple Silicon (až 192 GB na M2 Ultra) tiež umožňuje spracovanie obrázkov s veľmi vysokým rozlíšením bez dlaždicovania – obrázok 4096x4096 vytvára 256x256 dielikov = 65 536 tokenov, čo vyžaduje približne 8 GB pamäte ekvivalentnej VRAM v zjednotenom pamäťovom fonde.
Distribuovaná inferencia. Pre rozsiahle projekty kontroly infraštruktúry spracúvajúce milióny obrázkov je potrebná distribuovaná inferencia naprieč viacerými GPU alebo strojmi. DINOv3 podporuje PyTorch DistributedDataParallel (DDP) pre multi-GPU inferenciu na jednom serveri, modelovú paralelizáciu (pipeline paralelizmus pre ViT-7B) a Ray (open-source framework pre distribuované výpočty) pre viacuzlovú distribuovanú inferenciu. Rozsiahle nasadenia bežne používajú Kubernetes s fondmi GPU uzlov spúšťajúcimi inferenciu DINOv3 ako škálovateľnú mikroslužbu. Každý inferenčný pod beží na jednom GPU T4 (16 GB VRAM) a spracúva približne 70 obrázkov/sekundu. Klaster 50 podov dosahuje priepustnosť 3 500 obrázkov/sekundu, čo umožňuje spracovanie 500-obrázkovej obhliadky dráhy za menej ako 3 sekundy. Inferenčný server používa TorchServe pre obsluhu modelu s dynamickým dávkovaním (veľkosti dávok 4-16 v závislosti od objemu požiadaviek) a presnosťou FP16 na maximalizáciu priepustnosti.
Edge nasadenie s NVIDIA Jetson. Pre terénne nasadené inšpekčné systémy používajúce drony alebo pozemné vozidlá možno DINOv3 ViT-B/16 nasadiť na okrajových zariadeniach NVIDIA Jetson. Modul Jetson Orin NX 16GB (100 TOPS AI výkon) dosahuje 15-25 obrázkov/sekundu s DINOv3 ViT-B/16 pri FP16, v závislosti od režimu napájania (15W vs 25W vs 40W). Model je optimalizovaný pomocou TensorRT – optimalizátora inferencie hlbokého učenia NVIDIA, ktorý spája vrstvy, optimalizuje výber jadier a kvantizuje na FP16 alebo INT8. S TensorRT INT8 kvantizáciou sa rýchlosť inferencie zvyšuje na 30-40 obrázkov/sekundu na Jetson Orin NX s menej ako 1 % degradáciou presnosti v porovnaní s FP32. Jetson Xavier NX (21 TOPS) dosahuje 8-12 obrázkov/sekundu s TensorRT FP16. Toto edge nasadenie umožňuje detekciu trhlín v reálnom čase počas letu dronu – kamera dronu zachytáva obrázky a DINOv3 ich spracúva na palube, pričom označuje potenciálne defekty v priebehu sekúnd od zachytenia bez potreby cloudového pripojenia.
Open-source dostupnosť a licencovanie
DINOv3 bol vydaný spoločnosťou Meta AI v roku 2025 ako open-source projekt, čím pokračuje v tradícii spoločnosti verejne vydávať najmodernejšie výskumné modely AI. Pochopenie licenčných a distribučných podmienok je nevyhnutné pre organizácie plánujúce nasadiť DINOv3 v komerčných produktoch.
Kód a váhy modelu. Kompletný kód DINOv3 je k dispozícii na GitHub na adrese facebookresearch/dinov3 (10 700+ hviezdičiek k polovici roku 2025). Repozitár obsahuje kompletný tréningový a vyhodnocovací kód (PyTorch), definície modelov, pipeline spracovania údajov, vyhodnocovacie skripty a predtrénované váhy pre všetkých 12 vydaných variantov modelu. Váhy modelu sú tiež k dispozícii na Hugging Face Hub pod menným priestorom facebook/dinov3-*, vrátane: facebook/dinov3-vits16-pretrain-lvd1689m (ViT-Small, 21M parametrov) facebook/dinov3-vitb16-pretrain-lvd1689m (ViT-Base, 86M parametrov) – bežne používaný základný model facebook/dinov3-vitl16-pretrain-lvd1689m (ViT-Large, 304M parametrov) facebook/dinov3-vith16-pretrain-lvd1689m (ViT-H+, ~1,5B parametrov) facebook/dinov3-vit7b-pretrain-lvd1689m (ViT-7B, 7B parametrov) Plus varianty ConvNeXt (T, S, B, L) a satelitne špecifické modely (SAT-493M)
Prístup k Hugging Face vyžaduje, aby používatelia súhlasili s podmienkami Meta a poskytli kontaktné informácie, ktoré sú zhromažďované, uchovávané a spracúvané v súlade so zásadami ochrany osobných údajov Meta. Váhy modelu sú distribuované ako súbory PyTorch state_dict kompatibilné s knižnicou Hugging Face Transformers (integrácia dostupná cez AutoModel.from_pretrained()).
Licencia DINOv3. DINOv3 je vydaný pod DINOv3 licenciou, čo je vlastná open-source licencia vyvinutá spoločnosťou Meta AI špecificky pre toto vydanie modelu. To sa líši od DINOv2, ktorý bol vydaný pod štandardnou licenciou Apache 2.0. DINOv3 licencia povoľuje: Používanie, reprodukciu, úpravy a distribúciu modelu a kódu Komerčné použitie vrátane integrácie do produktov a služieb Sublicencovanie odvodených diel za iných podmienok
DINOv3 licencia zahŕňa špecifické požiadavky na uvedenie autorstva (musia byť zachované oznámenia o autorských právach) a zásady prijateľného použitia, ktoré zakazujú používanie modelu na určité účely, vrátane sledovania, ktoré porušuje ľudské práva, autonómnych zbraní a porušovania platných zákonov. Licencia vyvolala diskusiu v komunite vývojárov – issue #31 na repozitári dinov3 konkrétne žiada o vydanie pod štandardnejšou licenciou, ako je Apache 2.0, aby sa zjednodušila právna zhoda pre podniky so zavedenými politikami open-source licencií. Čitatelia by si mali preštudovať licenčné podmienky vo vzťahu k svojmu vlastnému prípadu použitia.
Porovnanie s licencovaním iných kostier.
| Kostra | Licencia | Komerčné použitie | Vyžaduje uvedenie autorstva | Vlastné podmienky |
|---|---|---|---|---|
| DINOv3 | DINOv3 licencia | Áno | Áno | Áno |
| DINOv2 | Apache 2.0 | Áno | Áno | Nie |
| ViT (Google) | Apache 2.0 | Áno | Áno | Nie |
| CLIP (OpenAI) | MIT | Áno | Áno | Nie |
| OpenCLIP | MIT | Áno | Áno | Nie |
| SAM (Meta) | Apache 2.0 | Áno | Áno | Nie |
| ConvNeXt | MIT | Áno | Áno | Nie |
Výpočtové náklady na reprodukciu. Náklady na trénovanie DINOv3 ViT-7B sa odhadujú na 2-5 miliónov USD (približne 15 000 GPU-dní na A100-80GB pri priebežných cloudových cenách). Destilované menšie modely (ViT-B, ViT-L) sú výrazne lacnejšie na reprodukciu, ale stále vyžadujú podstatný výpočtový výkon – destilácia ViT-Base z ViT-7B na LVD-1689M vyžaduje približne 500-800 GPU-dní. Avšak pre odborníkov dostupnosť predtrénovaných váh eliminuje potrebu akéhokoľvek tréningového výpočtu – váhy možno stiahnuť a okamžite použiť na inferenciu za cenu jedného GPU akejkoľvek generácie. Táto dostupnosť je základnou hodnotovou ponukou základných modelov: obrovské tréningové náklady sú amortizované naprieč všetkými downstream používateľmi.
Komunitná a ekosystémová integrácia. DINOv3 profituje zo širokej integrácie do ekosystému: Hugging Face Transformers poskytuje API na pripojenie a hneď spustenie, PyTorch Hub podporuje načítanie modelu cez torch.hub.load() a model je zahrnutý v zbierke modelov Torchvision pre jednoduchý prístup. Integrácia s Weights & Biases, MLflow a Neptune.ai pre sledovanie experimentov je podporovaná prostredníctvom štandardných PyTorch hákov. Export do formátu ONNX (Open Neural Network Exchange) je podporovaný pre nasadenie do prostredí mimo PyTorch, vrátane TensorRT pre NVIDIA edge zariadenia, CoreML pre Apple zariadenia a TFLite pre mobilné nasadenie. DINOv3 sa integruje prostredníctvom pipeline Hugging Face Transformers, s optimalizáciou TensorRT pre edge nasadenie na Jetson Orin NX a akceleráciou MPS pre macOS notebooky.
Záver. DINOv3 predstavuje generačný skok v samoriadených vizuálnych základných modeloch, dosahujúc najmodernejší výkon naprieč globálnymi a hustými predikčnými úlohami prostredníctvom bezprecedentného rozsahu (1,689 miliardy obrázkov, 7 miliárd parametrov) a inovácie Gram anchoring, ktorá zachováva kvalitu hustých prvkov. Pre analýzu povrchov infraštruktúry poskytuje variant DINOv3 ViT-B/16 768-rozmerný priestor vložení s výnimočnou sémantickou štruktúrou – typy povrchov, vzory trhlín a prvky defektov sú lineárne separovateľné v priestore vložení, čo umožňuje presnú klasifikáciu a detekciu s inferenciou so zmrazenou kostrou. Open-source dostupnosť, široká hardvérová podpora (GPU, MPS, Edge) a povoľujúce licencovanie robia z DINOv3 silnú kostru pre automatizovanú kontrolu infraštruktúry s miernymi požiadavkami na doménovo špecifické tréningové údaje a výpočtový výkon.
Často kladené otázky
- Aký je rozdiel medzi DINOv3 a DINOv2?
- DINOv3 predstavuje výrazný skok v škálovaní oproti DINOv2 vo viacerých dimenziách. Po prvé, tréningové dáta: DINOv2 bol trénovaný na 142 miliónoch kurátorských obrázkov (LVD-142M), zatiaľ čo DINOv3 škáluje na 1,689 miliardy obrázkov (LVD-1689M), čo je 12-násobný nárast. Po druhé, veľkosť modelu: najväčší učiteľský model DINOv2 mal 1 miliardu parametrov (ViT-g), zatiaľ čo DINOv3 trénuje učiteľa so 7 miliardami parametrov (ViT-7B). Po tretie, veľkosť dielika: DINOv2 používal veľkosť dielika 14 pixelov, čím vznikalo 256 dielikových tokenov na obrázok 224x224, DINOv3 používa veľkosť dielika 16 pixelov, čím vzniká 196 dielikových tokenov. Po štvrté, polohové vloženia: DINOv2 používal štandardné naučené absolútne polohové kódovania, zatiaľ čo DINOv3 zavádza Rotary Position Embeddings (RoPE) s náhodným posunom okienka pre lepšiu odolnosť voči rôznym pomerom strán. Po piate, kľúčová inovácia Gram anchoring v DINOv3 zachováva kvalitu hustej mapy prvkov počas dlhých tréningových harmonogramov – problém, ktorý spôsoboval degradáciu dielikových prvkov DINOv2 pri predĺženom tréningu. Po šieste, DINOv3 dosahuje +6 mIoU zlepšenie na ADE20K sémantickej segmentácii, +6,7 J a F-Mean na sledovaní videa a +10,9 GAP na vyhľadávaní inštancií v porovnaní s DINOv2.
- Ako možno DINOv3 použiť na analýzu povrchov infraštruktúry?
- Kostra DINOv3 ViT-B/16 môže slúžiť ako primárny motor na extrakciu prvkov v inšpekčnom pipeline infraštruktúry. Keď dron alebo kamera zachytí obrázok povrchu dráhy, mostovky alebo cestnej vozovky, obrázok sa zmení na 224x224 pixelov a rozdelí sa na 196 neprekrývajúcich sa dielikov 16x16. Každý dielik je lineárne vložený do 768-rozmerného vektora a spolu s CLS tokenom prechádzajú cez 12 vrstiev transformerového enkodéra s multi-head self-attention. Výsledné 768-rozmerné vloženie CLS tokenu zachytáva globálne charakteristiky povrchu používané na klasifikáciu typu povrchu (asfalt, betón, obaľovaný kameň atď.) a celkovej triedy kvality. Súčasne 196 dielikových tokenových vložení (každé 768-rozmerné) kóduje lokalizované textúrne informácie na úrovni dielika, ktoré podporujú detekciu trhlín na úrovni pixelov a iné úlohy hustej predikcie. Prístup so zmrazenou kostrou znamená, že váhy DINOv3 zostávajú fixné, zatiaľ čo ľahké hlavy špecifické pre úlohu (lineárne sondy alebo plytké MLP) sa trénujú na označených súboroch údajov infraštruktúry. To znižuje náklady na trénovanie približne o 90 % v porovnaní s úplným dolaďovaním pri dosahovaní presnosti detekcie defektov na úrovni najmodernejších metód.
- Aký hardvér je potrebný na spustenie inferencie DINOv3?
- DINOv3 ponúka modely v rôznych veľkostiach, aby vyhovoval rôznym hardvérovým obmedzeniam. Variant ViT-B/16 (86 miliónov parametrov) beží efektívne na jedinom NVIDIA GPU s aspoň 8 GB VRAM, pričom dosahuje rýchlosť inferencie 50-100 snímok za sekundu na RTX 3060 alebo vyššom. Na Apple Silicon Macoch (M1/M2/M3) poskytuje backend MPS (Metal Performance Shaders) hardvérovo akcelerovanú inferenciu približne 20-40 FPS na M2 Pro. Pre nasadenie na okraji (edge) beží destilovaný variant ViT-Small (21M parametrov) na NVIDIA Jetson Orin NX pri 15-30 FPS. Najväčší variant, ViT-7B, vyžaduje 4-8 NVIDIA A100 (80GB) GPU na inferenciu. DINOv3 podporuje inferenciu so zmiešanou presnosťou (FP16), ktorá znižuje spotrebu pamäte približne o 50 % so zanedbateľnou stratou presnosti. Model je k dispozícii v PyTorch cez Hugging Face Transformers, pričom kontrolný bod facebook/dinov3-vitb16-pretrain-lvd1689m je štandardným vstupným bodom.
- Čo je Gram anchoring v DINOv3?
- Gram anchoring je nová regularizačná technika zavedená v DINOv3 na vyriešenie degradácie hustých máp prvkov počas dlhých harmonogramov samoriadeného trénovania. Počas predĺženého trénovania štýlom DINOv2 s veľkými modelmi (ViT-L a vyššie) sa pozorovalo, že prvky na úrovni dielikov strácajú svoju priestorovú štruktúru a sémantický význam – presnosť lineárnej sondy na globálnych úlohách sa zlepšovala, ale mapy prvkov na úrovni dielikov sa stávali hlučnými a strácali lokalizačnú schopnosť. Gram anchoring zavádza dodatočný L2 loss člen, ktorý zosúlaďuje Gramovu maticu dielikových prvkov študenta so zmrazenou Gramovou maticou z raného EMA snímku učiteľa. Konkrétne, vzhľadom na L2-normalizovanú maticu študentských dielikov X_S a Gramovu maticu učiteľa X_G (raný EMA snímok), loss je L_Gram = ||X_S X_S^T - X_G X_G^T||_F^2. Tento loss zachováva štruktúru párovej podobnosti dielikov skôr než vynucovanie absolútnych pozícií prvkov, čo pôsobí ako priestorový regularizátor. Integrovaný po 1M tréningových iteráciách s váhou 2 a aktualizáciami učiteľa každých 10k krokov, Gram anchoring prináša +2 mIoU zlepšenie na ADE20K segmentácii a lepšiu RMSE odhadu hĺbky bez degradácie globálnych metrík.
- Ako sa 768-rozmerné vloženia DINOv3 používajú na detekciu povrchových defektov?
- Variant DINOv3 ViT-B/16 vytvára 768-rozmerné vloženie pre každý z 196 dielikov plus jeden CLS token na obrázok 224x224. Pre analýzu povrchov infraštruktúry slúžia tieto vloženia na dva odlišné účely. Pre globálnu klasifikáciu (typ povrchu, celkové hodnotenie kvality) sa vloženie CLS tokenu vloží do ľahkého lineárneho klasifikátora alebo 2-vrstvovej MLP hlavy, ktorá mapuje 768 dimenzií na N výstupných tried. Pre úlohy hustej predikcie (segmentácia trhlín na úrovni pixelov) tvorí 196 dielikových tokenových vložení priestorovú mriežku 14x14 768-rozmerných vektorov. Táto mriežka sa posúva cez segmentačnú hlavu (typicky ľahký konvolučný dekodér s 1-3 vrstvami), ktorá prevzorkuje mapu prvkov 14x14 na pôvodné rozlíšenie 224x224. Vloženie každého pixelu možno porovnať s prototypmi defektov pomocou kosínusovej podobnosti – dieliky s vloženiami blízkymi prototypom trhlín (stanoveným pomocou niekoľkých príkladov) sú označené ako defekty.
Toto je referenčný záznam. TarmacView poskytuje služby dronovej inšpekcie a nepredáva vybavenie ani materiály opísané v tomto slovníku.