Was ist Edge Computing für Echtzeit-Inspektion?
Edge Computing für Echtzeit-Inspektion
Definition und Begründung
Edge Computing ist ein verteiltes Rechenparadigma, bei dem die Datenverarbeitung am oder in der Nähe des physischen Ortes der Datengenerierung stattfindet, anstatt in einem zentralisierten Cloud-Rechenzentrum. Im Kontext der Infrastrukturinspektion bedeutet Edge Computing, KI-Inferenz direkt auf der Drohne, dem Roboterfahrzeug oder dem Handgerät auszuführen, das die Daten erfasst. Die Kernbegründung ist einfach: Die Round-Trip-Latenz beim Senden hochauflösender Bilder an die Cloud zur Verarbeitung ist für Echtzeit-Operationsentscheidungen inakzeptabel.
Das Latenzproblem wird durch die Netzwerkphysik quantifiziert. Eine typische Cloud-Inferenz-Pipeline umfasst Bildaufnahme, Komprimierung, drahtlose Übertragung (Wi-Fi, 4G/5G oder Satellit), Cloud-Vorverarbeitung, Modellinferenz, Ergebnisverpackung und Rückübertragung an den Bediener. Selbst unter optimalen 5G-Bedingungen mit Latenzen von 10-20 Millisekunden allein für die Funkverbindung liegt die End-to-End-Cloud-Inferenzlatenz zwischen 200 Millisekunden und 2 Sekunden, abhängig von Netzwerküberlastung, Serverlast und geografischer Entfernung zur Cloud-Region. Bei einer Drohne, die mit 15 m/s (54 km/h) fliegt, bedeutet eine 2-Sekunden-Round-Trip, dass sich das Luftfahrzeug 30 Meter bewegt hat, bevor es sein Erkennungsergebnis erhält – eine inakzeptable Marge für die Nahbereichs-Strukturinspektion, bei der Risse von 0,2 mm Breite aus einem Arbeitsabstand von 3-5 Metern identifiziert werden müssen.
Edge-Inferenz eliminiert dieses Problem vollständig. Auf einem NVIDIA Jetson AGX Orin, der 275 Billionen Operationen pro Sekunde (TOPS) INT8-Rechenleistung ausführt, dauert ein einzelner Vorwärtsdurchlauf eines ResNet-50-Bildklassifikators etwa 3-5 Millisekunden. Inklusive Bildvorverarbeitung, Skalierung und Ergebnisdecodierung bleibt die End-to-End-Latenz pro Frame unter 50 Millisekunden. Diese Rückkopplungsschleife unter 100 Millisekunden ermöglicht autonome Verhaltensweisen im geschlossenen Regelkreis, wie die Anpassung der Flugbahn zur erneuten Aufnahme eines verdächtigen Bereichs, das Auslösen einer sofortigen Warnung an die Bodenstation oder die Aktivierung zusätzlicher Sensormodalitäten (z.B. Wärmebild oder LiDAR) zur Kreuzbestätigung.
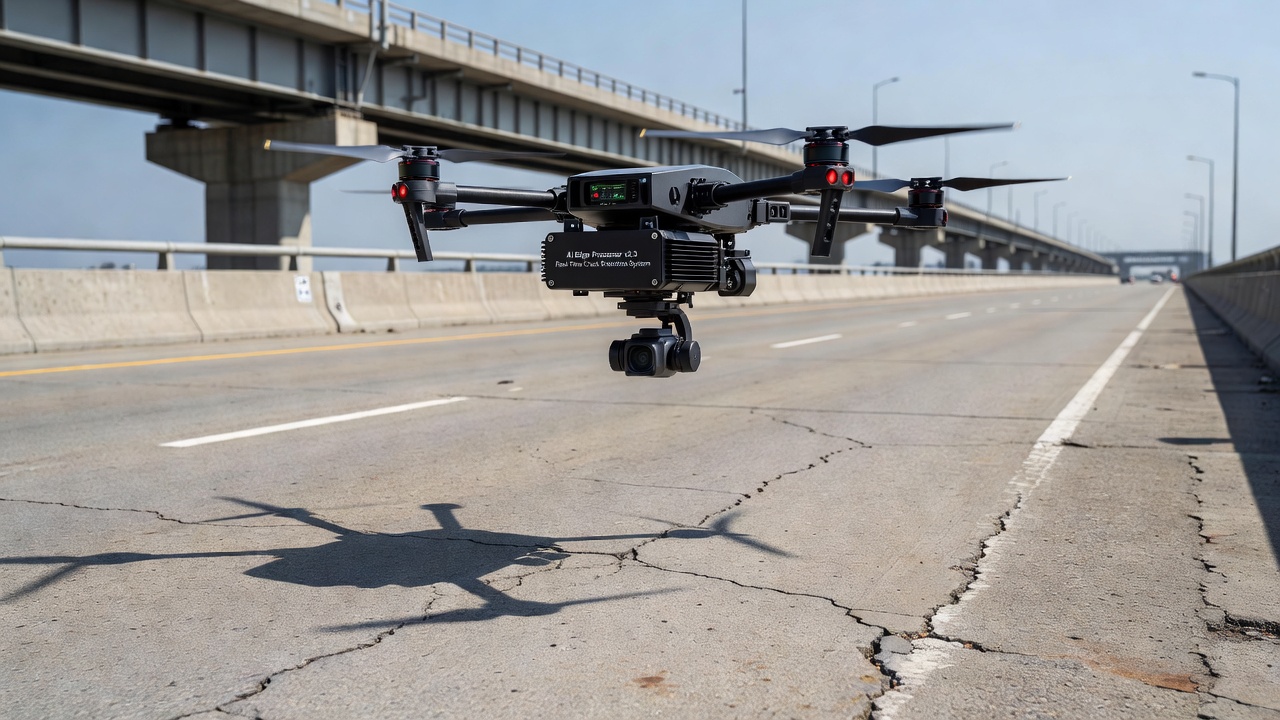
Neben der Latenz ist das Bandbreiten-Argument ebenso überzeugend. Ein 20-Megapixel-Inspektionsbild bei 8-Bit-RGB-Tiefe benötigt etwa 60 MB unkomprimierte Daten oder 3-8 MB nach JPEG-Komprimierung, abhängig von den Qualitätseinstellungen. Ein einzelner 20-minütiger Inspektionsflug mit 1 Bild pro Sekunde erzeugt 1.200 Bilder mit insgesamt 3,6-9,6 GB Daten. Bei einer Flotte von 10 Drohnen, die tägliche Inspektionen durchführen, summiert sich dies auf 36-96 GB pro Tag. Die Übertragung dieser Menge über Mobilfunk- oder Satellitenverbindungen ist teuer, langsam und oft unmöglich an abgelegenen Infrastrukturstandorten wie Bergbrücken, Offshore-Windparks oder abgelegenen Pipeline-Korridoren, wo die Konnektivität auf 1-10 Mbps begrenzt ist. Edge Computing löst dies, indem es Bilder lokal verarbeitet und nur die Ergebnisse überträgt: Erkennungskoordinaten, Schweregradklassifikationen und optional 200x200 Pixel große Ausschnitte um erkannte Defekte. Dies reduziert das übertragene Datenvolumen um 90-99% und komprimiert einen täglichen Datenstrom von 9,6 GB auf unter 100 MB.
Sicherheit und Compliance liefern eine weitere Begründung. Edge-Verarbeitung vermeidet das Senden sensibler Infrastrukturbilder, einschließlich Flugplatzbefestigungen, militärischer Anlagen oder kritischer Energieeinrichtungen, über potenziell unsichere drahtlose Verbindungen. Für Verteidigungs- und Regierungsinspektionsprogramme erfüllt dieses lokal-only-Verarbeitungsmodell Datenhoheitsanforderungen, die den Cloud-Export klassifizierter Standortbilder verbieten.
Edge-KI-Hardwareplattformen
Der praktische Einsatz von Edge-Inferenz hängt von spezialisierter Hardware ab, die Rechenleistung mit den strengen Leistungs-, Gewichts- und thermischen Einschränkungen von Drohnennutzlasten in Einklang bringt. Die folgenden Plattformen dominieren den Edge-KI-Inspektionsmarkt.
NVIDIA Jetson Familie
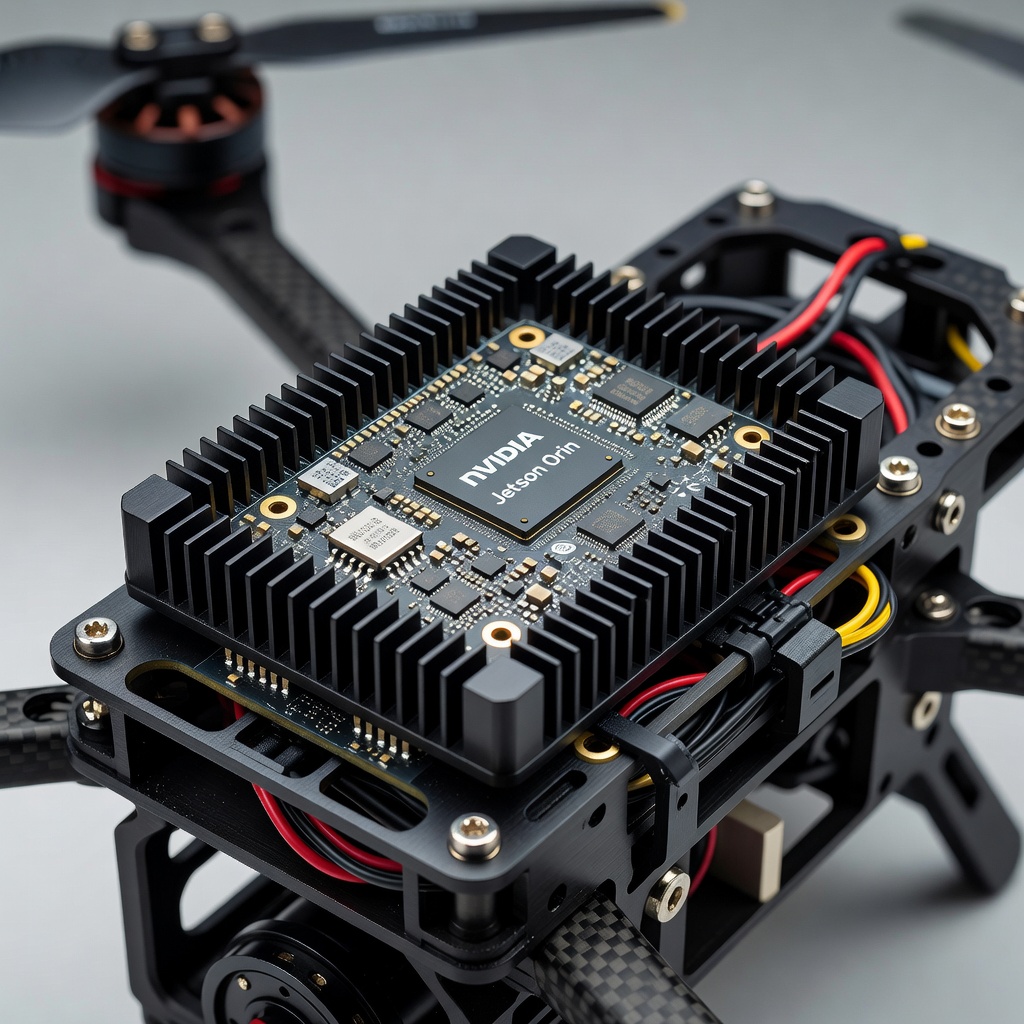
Die Jetson-Serie von NVIDIA ist die am weitesten verbreitete Edge-KI-Plattform für die Drohneninspektion und bietet eine skalierbare Architektur vom Einstiegs-Nano bis zum Flaggschiff AGX Orin. Alle Jetson-Module teilen sich einen gemeinsamen Software-Stack, das JetPack SDK, das CUDA, cuDNN, TensorRT und optimierte Vision-Bibliotheken umfasst und so die Code-Portabilität über die gesamte Familie ermöglicht.
| Modul | KI-Leistung | GPU-Architektur | Leistung (TDP) | Formfaktor | Typischer Inspektionsanwendungsfall |
|---|---|---|---|---|---|
| Jetson Nano | 472 GFLOPS (FP16) | Maxwell 128-Kern | 5-10W | 70x45mm | Leichte Riss/Kein-Riss-Klassifikation |
| Jetson TX2 | 1,3 TFLOPS (FP16) | Pascal 256-Kern | 7,5-15W | 50x87mm | Echtzeit-Objekterkennung (YOLO-Klassenmodelle) |
| Jetson Orin NX | 100 TOPS (INT8) | Ampere 1024-Kern | 10-25W | 69,6x45mm | Multi-Modell-Pipeline: Erkennung + Segmentierung + Klassifikation |
| Jetson AGX Orin | 275 TOPS (INT8) | Ampere 2048-Kern | 15-60W | 100x87mm | Vollauflösende semantische Segmentierung, Multi-Stream-Verarbeitung |
| Jetson Orin Nano | 40 TOPS (INT8) | Ampere 512-Kern | 7-15W | 69,6x45mm | Ausgewogene Effizienz für Einzelmodell-Echtzeit-Inspektion |
Der Jetson AGX Orin mit 275 TOPS liefert genug Rechenleistung, um ein U-Net-Segmentierungsmodell in 4K-Auflösung mit über 30 FPS auszuführen, was ihn für die hochauflösende Risskartierung von Fahrbahnen geeignet macht, bei der Defektbreiten unter einem Millimeter über große Flächen hinweg erkannt werden müssen. Der Jetson Orin Nano mit 40 TOPS und nur 7-15W stellt den optimalen Effizienzpunkt für die meisten Drohneninspektions-Workloads dar und bietet die 4-fache Leistung des ursprünglichen Jetson Nano bei ähnlichem Stromverbrauch.
Intel Movidius und Neural Compute Stick
Der Intel Movidius Myriad X VPU (Vision Processing Unit) bietet 4 TOPS INT8-Inferenz bei nur 1-2,5W Stromverbrauch und erreicht einen Wirkungsgrad von 2-4 TOPS/W. Der Intel Neural Compute Stick 2 (NCS2) verpackt den Myriad X in einem USB-Formfaktor, was ihn für Prototyping zugänglich macht. Die 4-TOPS-Obergrenze schränkt ihn jedoch auf leichte Modellarchitekturen ein, MobileNetV2, EfficientNet-Lite oder kleine YOLO-Varianten, und er hat Schwierigkeiten mit den tieferen ResNet- oder EfficientNet-Modellen, die für eine hochgenaue Defekterkennung bevorzugt werden. Für Anwendungen, die Segmentierung (U-Net, DeepLab) oder hochauflösende Objekterkennung (YOLOv5-large, RT-DETR) erfordern, fehlt dem Myriad X die Speicherbandbreite und Rechendichte, die für Echtzeitleistung erforderlich sind.
Qualcomm Snapdragon und KI-Engine
Qualcomms Snapdragon-Mobilplattformen integrieren Hexagon-DSPs und Adreno-GPUs mit dedizierten KI-Beschleunigern, die je nach Generation 10-30 TOPS (INT8) liefern. Der Snapdragon 8 Gen 3 erreicht 34 TOPS bei etwa 5-8W für anhaltende Inferenz-Workloads. Snapdragon-Plattformen sind besonders relevant für handgeführte Inspektionstablets und Smartphone-basierte Inspektionswerkzeuge, bei denen der KI-Prozessor bereits in das System-on-Chip integriert ist und kein zusätzliches Nutzlastgewicht oder -volumen verbraucht. Die Qualcomm AI Engine unterstützt TensorFlow Lite, ONNX Runtime und Qualcomms proprietäres SNPE (Snapdragon Neural Processing Engine) für die Modellbereitstellung.
Apple Neural Engine
Die A17 Pro- und M-Serie-Chips von Apple integrieren eine 16-Kern Neural Engine, die 35 TOPS (INT8) mit etwa 3-5W anhaltendem KI-Workload-Stromverbrauch erreicht. Während die Apple Neural Engine eine herausragende TOPS/Watt-Effizienz erzielt, ist ihr Einsatz auf das Apple-Ökosystem (iOS/iPadOS) beschränkt und erfordert eine Core ML-Modellkonvertierung. Dies macht sie für iPad-basierte Inspektionsfeldwerkzeuge geeignet, die in Architektur-, Ingenieur- und Bau (AEC)-Workflows üblich sind, aber weniger für drohnengestütztes Edge Computing, wo das CUDA-Ökosystem von NVIDIA dominiert.
Google Coral Edge TPU
Der Google Coral Edge TPU (Tensor Processing Unit) liefert 4 TOPS (INT8) bei nur 2W, was ihn zur energieeffizientesten Option pro Inferenz macht. Das Coral System-on-Module (SoM) integriert den Edge TPU mit einem i.MX 8M-System-Controller und bietet eine vollständige eingebettete Plattform in 40x48mm. Die 4-TOPS-Grenze schränkt jedoch die Modellkomplexität ein, und die Anforderung ausschließlich an TensorFlow Lite-Modelle (mit Edge TPU-kompilierten Operationen) verengt den unterstützten Architekturraum. Für einfache Defektklassifikatoren wie die 10-Klassen-MobileNetV2-Modelle, die in Qualitätsfilter-Pipelines verwendet werden, bietet der Coral Edge TPU eine außergewöhnliche Batterielebensdauerverlängerung für handgeführte Inspektionswerkzeuge.
Modelloptimierung für Edge-Bereitstellung
Die Bereitstellung tiefer neuronaler Netze auf Edge-Hardware erfordert eine aggressive Modelloptimierung, um die Echtzeit-Inferenzbeschränkungen hinsichtlich Speicher-, Rechen- und Leistungsbudgets zu erfüllen. Modelle, die auf GPU-Clustern mit 32-Bit-Gleitkomma-Genauigkeit trainiert wurden, müssen komprimiert und beschleunigt werden, ohne die Erkennungsgenauigkeit unter operative Schwellenwerte zu senken.
Quantisierung
Quantisierung reduziert die numerische Genauigkeit von Modellgewichten und Aktivierungen von 32-Bit-Gleitkomma (FP32) auf Darstellungen mit niedrigerer Bitanzahl, wie 16-Bit-Gleitkomma (FP16) oder 8-Bit-Integer (INT8). Dies ist die wirkungsvollste Optimierung für Edge-Inferenz.
INT8-Quantisierung wandelt jedes Gewicht und jede Aktivierung von 4 Bytes in 1 Byte um und reduziert den Modellspeicher-Fußabdruck um 75%. Auf NVIDIA Jetson-Plattformen mit INT8-Tensor-Core-Unterstützung führt dies zu einer 2- bis 4-fachen Durchsatzsteigerung bei Matrix-Multiplikationsoperationen im Vergleich zu FP32. Ein ResNet-50-Modell, das auf einem AGX Orin mit 120 FPS in FP32 läuft, kann in INT8 400 FPS überschreiten. Die Genauigkeitseinbußen des quantisierungsbewussten Trainings (QAT), bei dem das Modell lernt, die reduzierte Genauigkeit während des Trainings zu kompensieren, betragen typischerweise 0,1-0,5% Top-1-Genauigkeitsverschlechterung bei ImageNet-skaligen Klassifikationsaufgaben. Für inspektionsspezifische Modelle ergab eine Studie zur Betonrisserkennung, dass die INT8-Quantisierung mit TensorRT die Modellgröße von 98 MB auf 24,5 MB reduzierte, während die Validierungsgenauigkeit von 95,2% erhalten blieb, ein Rückgang von 0,8% gegenüber der FP32-Baseline von 96,0%.
FP16-Quantisierung halbiert die Modellgröße (50% Reduktion) und bietet etwa 1,5- bis 2-fache Durchsatzsteigerungen. Für die meisten Inspektionsmodelle liefert die FP16-Inferenz eine mit FP32 identische Genauigkeit innerhalb des Messrauschens (±0,1%), was sie zu einer risikoarmen Optimierung macht. Die Jetson Orin-Familie unterstützt native FP16-Tensor-Core-Operationen und erzielt so eine optimale Leistung für Modelle mit Batch-Größe 1, der Standardkonfiguration für Echtzeit-Einzelbild-Inferenz.
INT4-Quantisierung entwickelt sich zu einer Technik der nächsten Generation, die Modelle auf 0,5 Bytes pro Gewicht komprimiert. Während INT4 Genauigkeitseinbußen von 1-3% bei Bildverarbeitungsaufgaben mit sich bringt, unterstützen der NVIDIA Model Optimizer und die TensorRT Model Optimizer-Bibliothek jetzt INT4 für die Bereitstellung auf Jetson-Plattformen. Dies ermöglicht es, ein 200 MB großes Segmentierungsmodell in nur 25 MB Speicher auszuführen, was für die 8-GB-Obergrenze des einheitlichen Speichers von Jetson Orin NX-Modulen entscheidend ist.
Pruning
Pruning entfernt redundante oder niedrige Gewichte, Neuronen oder Kanäle aus einem neuronalen Netz, um seine Rechenkosten und seinen Speicher-Fußabdruck zu reduzieren.
Unstrukturiertes Pruning setzt einzelne Gewichte unterhalb einer Salienzschwelle auf Null und wandelt dichte Matrizen in dünnbesetzte Matrizen um. Typische Komprimierungsverhältnisse von 40-60% sind erreichbar, bevor die Genauigkeit um mehr als 1% abfällt. Unstrukturierte Dünnbesetztheit erfordert jedoch Hardware- oder Bibliotheksunterstützung für effiziente dünnbesetzte Matrixmultiplikation. Die Ampere-Architektur von NVIDIA bietet 2:4-strukturierte Dünnbesetztheitsunterstützung, die den Durchsatz für kompatible Schichten verdoppelt.
Strukturiertes (Kanal-)Pruning entfernt ganze Faltungskanäle oder Neuronen und erzeugt ein schmaleres Modell, das auf jeder Hardware effizient läuft, ohne dass eine Unterstützung für dünnbesetzte Berechnungen erforderlich ist. Typische Komprimierungsverhältnisse liegen bei 30-50%. Bei Inspektionsmodellen stellt das Kanal-Pruning mit Feintuning die meiste Genauigkeit wieder her. Ein auf 50% der ursprünglichen Kanalanzahl reduziertes und über 10 Epochen auf Betonrissdaten feinabgestimmtes MobileNetV2 erreichte 93,7% Genauigkeit gegenüber der unbeschnittenen Baseline von 94,5%.
Knowledge Distillation
Knowledge Distillation trainiert ein kompaktes “Studenten”-Modell, um das Verhalten eines größeren “Lehrer”-Modells zu replizieren, indem die Divergenz ihrer Ausgabewahrscheinlichkeitsverteilungen minimiert wird. Der Student lernt aus den weichen Labels des Lehrers, die reichhaltigere Informationen codieren als harte Ground-Truth-Labels, einschließlich Ähnlichkeiten zwischen Klassen und Unsicherheitsschätzungen.
Für den Edge-Einsatz in der Inspektion ermöglicht die Destillation die Verwendung eines ResNet-152 oder EfficientNet-B7 als Lehrer (200-600 MB, 50-100M Parameter) und eines MobileNetV3-Small oder EfficientNet-Lite0 als Student (5-15 MB, 2-5M Parameter). Der Student erreicht 94-96% der Genauigkeit des Lehrers, während er nur 2-10% der Rechenleistung verbraucht. Ein typischer Workflow zur Brückenrisserkennung destillierte einen ResNet-152-Lehrer (97,2% Genauigkeit) in einen MobileNetV3-Large-Studenten (95,8% Genauigkeit), ein Genauigkeitsverlust von 1,4% bei einer 12-fachen Modellgrößenreduktion und einer 20-fachen Inferenzbeschleunigung auf dem Jetson Nano.
TensorRT
NVIDIA TensorRT ist das Optimierungs-SDK für leistungsstarke Deep-Learning-Inferenz auf NVIDIA GPUs. Es führt Graphoptimierung, Kernel-Auto-Tuning, Präzisionskalibrierung und Speicherverwaltung durch, um den Durchsatz auf Jetson-Hardware zu maximieren.
Die Optimierungspipeline von TensorRT umfasst:
- Layer-Fusion: Zusammenführen benachbarter Operationen (Faltung + Batch-Normalisierung + ReLU) in einzelne Kernel, wodurch der Kernel-Start-Overhead und die Speicherbandbreite reduziert werden.
- Kernel-Auto-Tuning: Auswahl der optimalen CUDA-Kernel-Implementierung für jede Schicht und jedes Hardwareziel basierend auf empirischem Benchmarking.
- INT8-Kalibrierung: Verwendung eines repräsentativen Kalibrierungsdatensatzes zur Berechnung optimaler dynamischer Bereiche für Aktivierungen, Minimierung des Quantisierungsfehlers.
- Dynamische Forminferenz: Verarbeitung variabler Eingabe-Tensor-Dimensionen ohne Neukompilierung, wesentlich für Inspektions-Pipelines, die Bilder mit unterschiedlicher Auflösung verarbeiten.
Ein typisches Inspektionsmodell, das ohne TensorRT bereitgestellt wird, erreicht 30-50% der Spitzenhardwareauslastung. Nach der TensorRT-Optimierung erreicht die Auslastung 70-85%, wobei die End-to-End-Latenz im Vergleich zur PyTorch-Eager-Mode-Inferenz um das 2- bis 5-fache reduziert wird.
ONNX
ONNX (Open Neural Network Exchange) bietet ein interoperables Modellformat, das Modell-Trainings-Frameworks (PyTorch, TensorFlow) von Inferenz-Laufzeiten entkoppelt. In PyTorch trainierte Modelle werden in das ONNX-Format exportiert und dann für die Jetson-Bereitstellung in TensorRT-Engines konvertiert oder für Nicht-NVIDIA-Ziele (ARM-CPUs, Qualcomm, Intel) in ONNX Runtime geladen.
Der ONNX-TensorRT-Workflow ist die Standard-Pipeline: PyTorch → ONNX → TensorRT-Engine. Dies entkoppelt Training und Bereitstellung und ermöglicht es Datenwissenschaftlern, in vertrauten Frameworks zu trainieren, während Bereitstellungsingenieure für bestimmte Edge-Hardware optimieren, ohne neu trainieren zu müssen.
Echtzeit-Risserkennung am Edge
Die ausgereifteste Anwendung von Edge-KI in der Inspektion ist die Echtzeit-Risserkennung auf Beton- und Asphaltinfrastruktur. Eine wegweisende Studie aus dem Jahr 2024, veröffentlicht in Sensors (PMC11645055), demonstrierte die vollständige Pipeline: Training von Convolutional Neural Networks mit Transfer Learning, Bereitstellung auf einem NVIDIA Jetson Nano und Validierung an Labor- und Feldbetonstrukturen.
Die Studie trainierte sechs CNN-Architekturen, ResNet18, ResNet50, GoogLeNet, MobileNetV2, MobileNetV3-Small und MobileNetV3-Large, unter Verwendung von Transfer Learning von ImageNet-vortrainierten Gewichten. Der Datensatz umfasste 3.000 Bilder von Betonoberflächen (gerissen und intakt), die mit Salz-und-Pfeffer-Rauschen und Bewegungsunschärfe augmentiert wurden, um die Robustheit in der realen Welt zu verbessern. ResNet50 erreichte die höchste Validierungsgenauigkeit von 96,0% mit einem F1-Score von 95,0% bei Batch-Größe 16.
Auf dem Jetson Nano bei 5-10W bereitgestellt, klassifizierte das ResNet50-Modell ein 224x224-Bild in 38 Millisekunden, was eine Echtzeitverarbeitung mit 26 Bildern pro Sekunde ermöglicht. Dieser Durchsatz ist ausreichend für eine Drohne, die mit 5 m/s fliegt und eine 70%ige Überlappung zwischen aufeinanderfolgenden Bildern aufweist, um sicherzustellen, dass jeder Quadratzentimeter der Oberfläche mehrfach klassifiziert wird.
Für eine feinere Defektcharakterisierung liefern Segmentierungsmodelle wie U-Net und DeepLabV3+ pixelgenaue Risskarten. Die IJAMA-Brückeninspektionsstudie erreichte eine mittlere Intersection-over-Union (mIoU) von 0,86 für die Risssegmentierung unter Verwendung eines U-Net mit MobileNetV2-Encoder auf dem Jetson Orin Nano bei 22 FPS und 7W. Dies ermöglicht die Quantifizierung von Rissbreite, -länge und -orientierung, Metriken, die von Brückeninspektionsstandards wie AASHTO und den National Bridge Inspection Standards (NBIS) der Federal Highway Administration gefordert werden.
Die am Edge bereitgestellte Risserkennung wurde auf operativen Brücken validiert, darunter eine 50 Meter lange Spannbetonbrücke, bei der eine DJI Matrice 300 RTK-Drohne, ausgestattet mit einem Jetson Orin NX, während eines 12-minütigen automatisierten Inspektionsfluges 43 Risse (Breiten 0,3-3,2 mm) erkannte. Die manuelle Validierung bestätigte 41 echte Positive (95,3% Recall) bei 3 falschen Positiven (92,8% Präzision).
Edge-Qualitätsfilterung
Rohe Inspektionsbilder enthalten einen hohen Anteil an für die Analyse ungeeigneten Bildern aufgrund von Bewegungsunschärfe, falscher Belichtung, Fokusfehlern oder Umgebungsartefakten (Regentropfen auf der Linse, Sonnenblendung, Staub). Ohne Filterung blähen diese minderwertigen Bilder die Speicher-, Übertragungs- und nachgelagerten Verarbeitungskosten auf. Die Edge-Qualitätsfilterung adressiert dies, indem sie vor dem primären Defekterkennungsmodell ein leichtes Qualitätsbewertungsnetzwerk ausführt.
Die Qualitätsfilter-Pipeline besteht typischerweise aus:
Unschärfeerkennung: Analyse der Laplace-Varianz des Bildes. Ein unscharfes Bild erzeugt niedrige Varianzwerte. Ein Schwellenwert von 100 (bei einem 8-Bit-Bild) trennt typischerweise scharfe von bewegungsunscharfen Bildern. Auf Jetson dauert dies in CUDA unter 1 Millisekunde.
Belichtungsqualität: Histogrammanalyse zur Erkennung überbelichteter (gesättigt > 5% der Pixel) oder unterbelichteter (mittlere Luminanz < 40) Bilder. Akzeptable Bilder fallen typischerweise in den Bereich der mittleren Luminanz von 40-200 für die Inspektion.
Kontrastbewertung: Root-Mean-Square (RMS)-Kontrastmessung. Bilder mit niedrigem Kontrast (RMS < 0,3) werden verworfen, da ihnen die für die Risskantenerkennung erforderlichen Gradienteninformationen fehlen.
Strukturelle Ähnlichkeit: Für Videosequenzen identifiziert der Structural Similarity Index (SSIM) zwischen aufeinanderfolgenden Bildern nahezu identische Bilder (SSIM > 0,95), wobei nur ein repräsentativer Frame behalten wird, um die eindeutige Abdeckung pro Speichereinheit zu maximieren.
Der kombinierte leichte Qualitätsklassifikator, ein 3-schichtiges Faltungsnetzwerk mit 80.000 Parametern, das in der MobileNetV2-lite-Konfiguration läuft, klassifiziert Bilder in 2-4 Millisekunden auf Jetson Orin-Geräten als “bestanden” oder “abgelehnt”. Felddaten aus Pipeline-Inspektionsbetrieben zeigen, dass die Edge-Qualitätsfilterung 60-75% der Rohbilder ablehnt, was bedeutet, dass nur 25-40% zum schwereren Defekterkennungsmodell gelangen. Dies reduziert die gesamte Inferenzrechenlast um das 2,5- bis 4-fache und die Speicheranforderungen proportional.
Das Endergebnis: Ein 20-minütiger Inspektionsflug, der 1.200 Rohbilder erzeugt, produziert nur 300-480 qualitätsgefilterte Bilder. Nach der Defekterkennung werden nur 30-80 Bilder mit erkannten Defekten plus ihre geotaggten Metadaten (typischerweise 2-5 KB pro Defekt über GeoJSON-Anmerkungen) übertragen. Das tägliche Datenvolumen pro Drohne sinkt von 9,6 GB auf unter 200 MB, eine Reduktion um 98%.
Hybride Edge-Cloud-Architektur
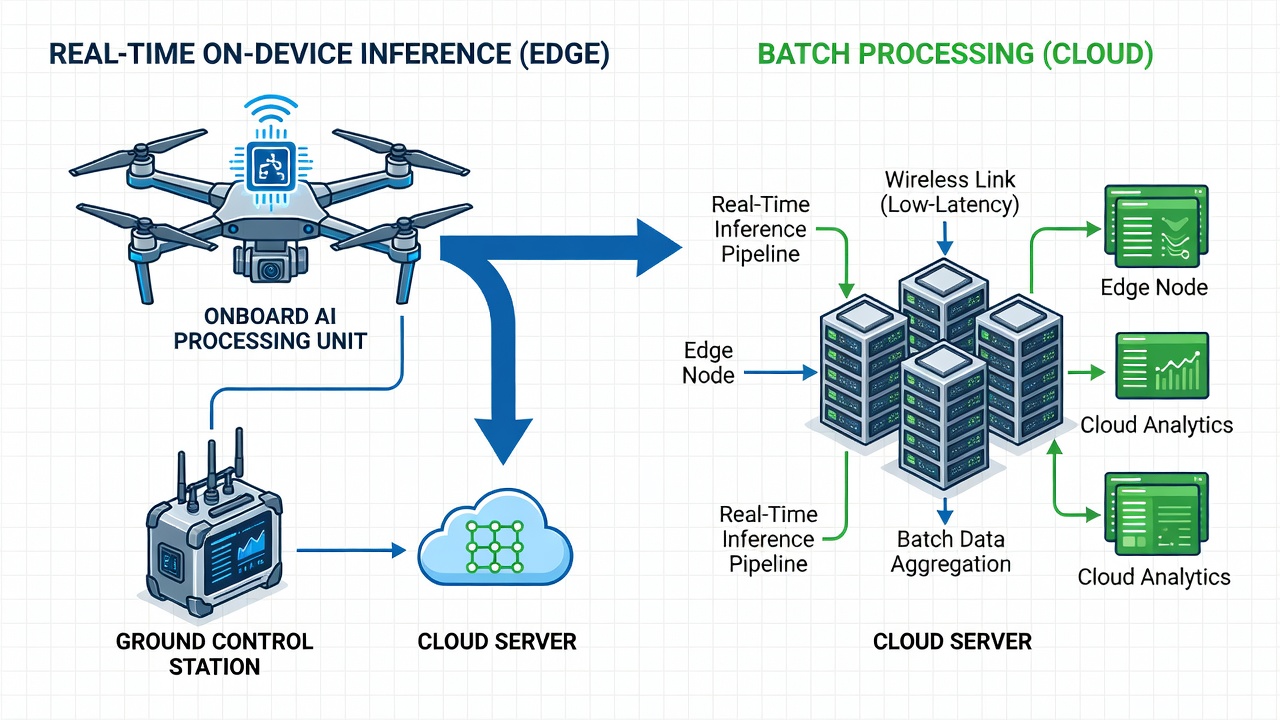
Während Edge Computing die Echtzeit-Inferenz übernimmt, bleibt die Cloud-Verarbeitung für hochauflösende Analysen, Modell-Neutraining, Flottenmanagement und Datenarchivierung unerlässlich. Die optimale Architektur ist ein hybrides Edge-Cloud-System, bei dem jede Ebene die Aufgaben ausführt, für die sie am besten geeignet ist.
Edge-Ebene (Am Erfassungspunkt)
| Funktion | Details |
|---|---|
| Echtzeit-Defekterkennung | Ausführen optimierter INT8-Modelle mit 20-30 FPS zur sofortigen Identifizierung |
| Qualitätsfilterung | Ablehnen unscharfer/überbelichteter/doppelter Bilder vor der Speicherung |
| Autonome Navigation | Erkennen und Vermeiden von Hindernissen, Anpassen der Flugbahn für erneute Aufnahme |
| Alarmgenerierung | Übertragen geotaggter Defektwarnungen in Echtzeit über eine schmalbandige Telemetrieverbindung |
| Lokale Speicherung | Behalten von Bildern in voller Auflösung erkannter Defekte auf der internen SSD (256GB-1TB) |
| Sensorfusion | Kombinieren von RGB-, Wärmebild- und LiDAR-Daten für multimodale Inferenz |
Cloud-Ebene (Nach Flugabschluss)
| Funktion | Details |
|---|---|
| Hochauflösende Analyse | Ausführen von FP32-Ensemble-Modellen oder Vision Transformers auf Bildern in voller Auflösung zur Zweitmeinungsvalidierung |
| Digitaler Zwilling-Integration | Fusionieren von Edge-Erkennungsergebnissen in 3D-BIM-Modelle für das Infrastruktur-Anlagenmanagement |
| Flottenweite Aggregation | Aggregieren von Defektstatistiken über alle Inspektionen hinweg für Trendanalysen und vorausschauende Wartungsplanung |
| Modell-Neutraining | Verwenden von am Edge erkannten falsch Positiven und übersehenen Erkennungen als Active-Learning-Stichproben zur Modellverbesserung |
| Compliance-Berichterstellung | Erstellen von Inspektionsberichten gemäß ICAO-, FAA-, ASTM- oder nationalen Infrastrukturnormen |
| Langzeitarchivierung | Speichern aller Inspektionsdaten (Edge-Metadaten + ausgewählte Vollauflösungsbilder) für behördliche Aufbewahrungsfristen (5-20 Jahre) |
Der Datenfluss durchläuft definierte Phasen. Während des Fluges arbeitet die Edge-Pipeline autonom: Erfassen, Qualitätsfilterung, Erkennung, Alarm. Nach der Landung verbindet sich die Drohne über hochbandbreiten lokalen Wi-Fi oder USB-C mit der Bodenstation oder Cloud, und die Massendatenübertragung für nicht dringende Bilder und Modelltelemetrie erfolgt. Die Cloud verarbeitet diese Batches asynchron und aktualisiert Defektdatenbanken und Modellregister.
Dieser hybride Ansatz kombiniert die Reaktionsfähigkeit der Edge-Inferenz unter 50 ms mit der analytischen Tiefe der Cloud-Verarbeitung und erreicht sowohl operative Geschwindigkeit als auch analytische Genauigkeit. Feldeinsätze mit dieser Architektur berichten von einer 97%igen Übereinstimmung zwischen anfänglichen Edge-Erkennungen und cloud-validierten Ergebnissen bei einer Stichprobe von 10.000 Inspektionsbildern.
Edge Computing für BVLOS-Operationen
Beyond Visual Line of Sight (BVLOS)-Operationen, bei denen die Drohne außerhalb der unbeaufsichtigten Sichtweite des Piloten operiert, stellen strenge Anforderungen an die Autonomie an Bord, und Edge Computing ist die Schlüsseltechnologie. Der ICAO-UAS-Regulierungsrahmen und die FAA-Regelgebung Part 108 für BVLOS-Operationen identifizieren beide die Echtzeit-Datenverarbeitung an Bord als Voraussetzung für sicheren Flug außerhalb der Sichtlinie.
Nach BVLOS-Regeln muss die Drohne einen sicheren Abstand zu Gelände, Hindernissen und anderen Luftfahrzeugen ohne direkte visuelle Überwachung durch den Piloten einhalten. Dies erfordert Detect and Avoid (DAA)-Systeme, die Sensordaten an Bord verarbeiten und innerhalb von 100-200 Millisekunden Ausweichmanöver ausführen, weit unter der Round-Trip-Latenz cloudabhängiger Architekturen. Edge Computing ermöglicht DAA durch die Ausführung von Objekterkennungsmodellen (YOLOv8, RT-DETR) auf Bordkameras und Radardaten in Echtzeit, wobei kooperativer und nicht-kooperativer Verkehr in Entfernungen von 200-1000 Metern, abhängig von der Sensorausstattung, erkannt wird.
Edge Computing ermöglicht auch den Betrieb bei gestörter Verbindung. Wenn die C2-Verbindung Paketverluste oder Signalverschlechterungen aufweist, die in bergigem Gelände, städtischen Schluchten oder über Wasser häufig vorkommen, muss die Drohne ihre Mission sicher fortsetzen. Edge-Systeme speichern den Flugplan lokal, führen die Wegpunktnavigation unter Verwendung von GPS- und IMU-Fusion an Bord durch und setzen die Inspektionsdatenverarbeitung fort, bis die Verbindung wiederhergestellt ist. Die Sensorfusion zwischen visueller Odometrie und IMU-Trägheitsnavigation am Edge hält die Positionsgenauigkeit während C2-Ausfällen von bis zu 60 Sekunden innerhalb von 1-5 Metern.
Das ICAO UAS Toolkit und der Regulierungsrahmen der EASA für UAS-Operationen in den Kategorien Spezifisch und Zertifiziert verlangen beide, dass BVLOS-fähige Drohnen die Fähigkeit nachweisen, einen sicheren Flugabbruch oder eine Rückkehr zum Startpunkt durchzuführen, ohne auf eine kontinuierliche Datenverbindung angewiesen zu sein. Edge Computing erfüllt dies, indem es alle Navigations-, Hindernisvermeidungs- und Missionsmanagementfunktionen an Bord hostet.
Für die Inspektion von langgestreckter linearer Infrastruktur, Pipelines, Stromübertragungsleitungen, Eisenbahnkorridore, ermöglichen BVLOS-Operationen mit Edge Computing die Abdeckung von 50-100 km in einem einzigen Flug. Die Drohne verarbeitet Inspektionsdaten während des 45-90-minütigen Fluges in Echtzeit und lädt nach der Landung die Ergebnisse und Bilder in voller Auflösung erkannter Defekte in die Cloud hoch. Ohne Edge-Verarbeitung wären die Speicher- und Bandbreitenkosten für die Erfassung von 60-120 GB pro Flug prohibitiv.
Leistungs- und thermische Einschränkungen
Edge-Computing-Hardware auf Drohnen arbeitet unter den restriktivsten Leistungs- und thermischen Budgets der Computerindustrie. Im Gegensatz zu Rechenzentrums-GPUs mit 300-700W Leistungsbudgets und Flüssigkeitskühlung müssen Drohnennutzlasten innerhalb von 10-60W Gesamtsystemleistung arbeiten, während sie Umgebungstemperaturen von -20°C bis +50°C, schnellen Luftgeschwindigkeitsänderungen und Sonneneinstrahlung standhalten.
Leistungsbudgetverteilung
Eine typische Inspektionsdrohne (z.B. DJI Matrice 350 RTX) hat ein gesamtes Nutzlast-Leistungsbudget von 25-50W aus dem Batteriesystem der Drohne, das sich wie folgt verteilt:
| Komponente | Typischer Stromverbrauch |
|---|---|
| Edge-KI-Rechenmodul | 7-25W |
| RGB-Kamera (Dauerbetrieb) | 3-8W |
| Wärmebildkamera (falls vorhanden) | 2-5W |
| LiDAR oder Entfernungsmesser | 5-15W |
| Kommunikationsfunk (C2 + Telemetrie) | 2-5W |
| Sensor-Gimbal-Stabilisierung | 2-4W |
Das Edge-Modul muss innerhalb seines thermischen Leistungsbudgets arbeiten. Die praktische Erfahrung zeigt, dass der Einsatz eines Jetson AGX Orin mit seiner vollen 60W-Leistung auf Drohnen unter 25 kg aufgrund von Batteriekapazitätsgrenzen selten machbar ist. Eine 60W-Rechenlast würde 30% einer 200-Wh-Drohnenbatterie über einen 60-minütigen Flug verbrauchen und nicht genügend Energie für Motoren und Sensoren übrig lassen. Der Jetson Orin Nano mit 7-15W ist die praktischste Wahl für anhaltende Inspektionsflüge von mehr als 30 Minuten.
Thermische Auslegungsleistung (TDP) und Kühlung
| Edge-Modul | TDP | Erforderliche Kühlung | Max. Umgebung (Passiv) | Max. Umgebung (Aktiv) |
|---|---|---|---|---|
| Google Coral Edge TPU | 2W | Passiv (nur Wärmeverteiler) | 70°C | N/A |
| Jetson Nano | 5-10W | Passiver Kühlkörper | 50°C | 70°C mit Lüfter |
| Jetson Orin Nano | 7-15W | Kühlkörper + optionaler Lüfter | 45°C | 65°C mit Lüfter |
| Intel Movidius NCS2 | 2,5W | Passiv | 60°C | N/A |
| Jetson Orin NX | 10-25W | Aktiver Lüfter erforderlich | N/A | 55°C |
| Jetson AGX Orin | 15-60W | Aktiver Lüfter erforderlich | N/A | 50°C |
Thermisches Drosseln ist ein kritisches Betriebsproblem. Wenn die Innentemperatur des Jetson-Moduls seinen thermischen Grenzwert überschreitet (typischerweise 80-85°C Sperrschichttemperatur für Orin-Module), reduziert der Treiber die GPU-Taktfrequenzen schrittweise. Bei 50% thermischer Drosselung sinkt der Inferenzdurchsatz um etwa 40-50%. Bei direkter Sonneneinstrahlung und 35°C Umgebungstemperatur kann ein passiv gekühlter Jetson Orin Nano, der anhaltende Inferenz ausführt, nach 8-12 Minuten 82°C erreichen. Aktive Kühlung mit einem 40x40x10 mm Lüfter erhöht die Masse um 15 Gramm und die Leistungsaufnahme um 0,8W, hält die Sperrschichttemperatur jedoch auf unbestimmte Zeit unter 70°C.
Dynamic Frequency and Voltage Scaling (DVFS) ist die Standard-Minderungsstrategie. Das Jetson-Modul passt seine Betriebsfrequenz über 5-7 Leistungszustände an und tauscht Inferenzdurchsatz gegen thermische Sicherheit. Ein typisches Flugprofil könnte während der aktiven Inspektion über einem Brückenabschnitt mit maximaler Leistung (15W, 40 TOPS) laufen und dann während des Transits zwischen Zielen auf 7W (15 TOPS) herunterfahren, wodurch die thermische Reserve erhalten bleibt und gleichzeitig der Batterieverbrauch optimiert wird.
Edge Computing im TarmacView-Kontext
TarmacView führt Flugplanung, Fotoaufnahme und seine PAPI-Licht-Engine in einer Offline-Vor-Ort-Feldbereitstellung in einem lokalen Netzwerk aus. Die Fahrbahnverarbeitung läuft dort nicht. Die Risserkennung für Flugplatzbefestigungen befindet sich in der Entwicklung, nahe an einem ersten MVP, und läuft auf einer separaten GPU-Maschine.
Zukunft der Edge-Inspektion
Edge Computing für die Inspektion entwickelt sich entlang mehrerer Technologievektoren, die grundlegend erweitern werden, was am Erfassungspunkt möglich ist.
Neuromorphes Computing
Neuromorphe Prozessoren, wie Intels Loihi 2 und SynSenses Speck, emulieren biologische neuronale Netze unter Verwendung spikender neuronaler Netze (SNNs), die Größenordnungen weniger Strom verbrauchen als herkömmliche Deep-Learning-Beschleuniger. Loihi 2 erreicht eine 10- bis 100-fach bessere TOPS/Watt-Effizienz für bestimmte Sehaufgaben im Vergleich zu Jetson-Klasse GPUs. Für die Inspektion geben neuromorphe Event-basierte Kameras nur Pixel aus, die sich ändern (Bewegungsereignisse), anstatt vollständige Bilder, wodurch die Datenbandbreite um 90-99% reduziert wird, während effektive Bildraten von über 10.000 Hz erreicht werden. Ein neuromorpher Edge-Prozessor, gekoppelt mit einer Event-Kamera, könnte einen Riss, der in einer Betonprüfprobe unter Last erscheint, mit einer Latenz von unter einer Millisekunde erkennen, bei einem Stromverbrauch von unter 100 mW, was eine kontinuierliche strukturelle Gesundheitsüberwachung von batteriebetriebenen Sensoren über Monate statt Stunden ermöglicht.
In-Sensor-Verarbeitung
Sensoren mit integrierter Verarbeitung, wie Sonys IMX500 intelligenter Bildsensor, führen CNN-Inferenz innerhalb des Bildsensors selbst durch und geben Metadaten (Begrenzungsrahmen, Klassenbezeichnungen, Zählungen) anstelle von Pixeldaten aus. Der IMX500 bietet bis zu 30 FPS Klassifikation bei 0,5W Gesamtleistung für das Sensor-plus-Prozessor-Paket, wodurch ein separates Edge-Rechenmodul für einfache Erkennungsaufgaben überflüssig wird. Für extrem leichte Drohneninspektionen ermöglicht die In-Sensor-Verarbeitung die Erkennung auf Drohnenplattformen unter 250 g, die kein Jetson-Modul tragen können.
Transformer-basierte Edge-Modelle
Vision Transformers (ViTs) und effiziente Varianten (MobileViT, EdgeNeXt, FastViT) nähern sich der CNN-Effizienz auf Edge-Hardware an. FastViT erreicht 76,7% ImageNet Top-1-Genauigkeit bei 4,8 ms Inferenzlatenz auf dem iPhone 14 Pro (Apple Neural Engine), vergleichbar mit MobileNetV2s 71,8% bei 1,5 ms, aber mit deutlich höherer Genauigkeit. Da NVIDIA TensorRT und Apple Core ML optimierte Transformer-Operator-Unterstützung hinzufügen, werden transformer-basierte Inspektionsmodelle eine höhere Genauigkeit für Defektklassifikation und -segmentierung bei Edge-kompatiblem Durchsatz liefern.
6G-Edge-Integration
Der 6G-Mobilfunkstandard, der für die erste Bereitstellung um 2030 erwartet wird, wird Edge Computing als native Netzwerkfunktion integrieren. 6G-Architekturen verteilen Rechenressourcen über das Funkzugangsnetz und ermöglichen so eine Cloud-Edge-Koordination unter 1 ms. Für die Inspektion könnte dies eine Echtzeit-Kollaborativ-Inferenz ermöglichen, bei der ein Edge-Gerät auf der Drohne ein leichtes schnelles Modell ausführt, während das 6G-Netzwerk schwierigere Fälle, mehrdeutige Defekte, neuartige Schadensmuster, innerhalb eines einzigen Netzwerk-Round-Trips an ein tieferes Cloud-Modell auslagert. Die Kombination der Terahertz-Bänder von 6G (50+ Gbps Durchsatz) mit verteiltem Edge-Compute wird die Echtzeit-Teleoperation von Inspektionsdrohnen mit 4K-Videostreaming und KI-Overlay zu einer praktischen Realität machen.
Selbstoptimierende Edge-Modelle
Föderiertes Lernen und kontinuierliche Modellanpassung werden es Edge-Inspektionssystemen ermöglichen, sich im Laufe der Zeit ohne zentrales Neutraining zu verbessern. Das Edge-Modul jeder Drohne protokolliert Erkennungsergebnisse und Bedienerkorrekturen und verwendet diese als Trainingssignale für inkrementelle Modellaktualisierungen. Über eine Flotte von 50 Inspektionsdrohnen, von denen jede 1.000 korrigierte Vorhersagen pro Woche beisteuert, verbessert sich das gemeinsame Modell um 50.000 beschriftete Stichproben pro Woche, was eine schnelle Domänenanpassung an neue Infrastrukturtypen, Wetterbedingungen und Defektmorphologien ohne manuellen Datenbeschriftungsaufwand ermöglicht.
Verwandte Begriffe
- Inferenz: Der Prozess des Ausführens eines trainierten maschinellen Lernmodells auf neuen Daten zur Erstellung von Vorhersagen.
- Cloud-Verarbeitung: Zentrale Datenanalyse, die in entfernten Rechenzentren mit hoher Rechenkapazität, aber höherer Latenz durchgeführt wird.
- Echtzeitsysteme: Computersysteme, die eine Antwort innerhalb strenger zeitlicher Beschränkungen garantieren.
- Automatisierung: Der Einsatz von Technologie zur Durchführung von Aufgaben mit reduziertem menschlichem Eingriff.
- Deep Learning: Eine Teilmenge des maschinellen Lernens, die mehrschichtige neuronale Netze zur Mustererkennung verwendet.
- Drohne (UAV): Ein unbemanntes Luftfahrzeug, das als Inspektionsplattform dient.
- Mobile GPU: Eine Grafikprozessoreinheit, die für stromsparende mobile und eingebettete Anwendungen entwickelt wurde.
- Modelloptimierung: Techniken zur Reduzierung der Modellgröße und Erhöhung der Inferenzgeschwindigkeit für die Bereitstellung.
- Quantisierung: Reduzierung der numerischen Genauigkeit in neuronalen Netzgewichten und -aktivierungen.
- BVLOS: Beyond Visual Line of Sight, Drohnenoperationen außerhalb der direkten Sichtweite des Piloten.
Häufig gestellte Fragen
- Was ist Edge Computing im Kontext der Drohneninspektion?
- Edge Computing bei der Drohneninspektion bedeutet, KI-Inferenz direkt auf dem Bordcomputer der Drohne auszuführen, anstatt alle Daten zur Verarbeitung in die Cloud zu streamen. Die Drohne nimmt hochauflösende Bilder auf und verarbeitet sie lokal mit optimierten neuronalen Netzen, wobei sie Defekte wie Risse, Korrosion oder Delamination während des Fluges in Echtzeit erkennt. Nur Erkennungsergebnisse, geotaggte Warnungen und ausgewählte Bildausschnitte werden an die Bodenstation übertragen, was die Datenübertragung im Vergleich zum Cloud-Upload in voller Auflösung um 90-99% reduziert.
- Welche Edge-KI-Hardware eignet sich am besten für die Drohneninspektion?
- Die NVIDIA Jetson-Familie ist die am weitesten verbreitete Plattform für Edge-KI in Drohnen, die vom Jetson Nano (472 GFLOPS, 10W) für leichte Klassifikation bis zum Jetson AGX Orin (275 TOPS, 60W) für Multi-Modell-Inferenz reicht. Weitere Optionen sind der Google Coral Edge TPU (4 TOPS, 2W) für extrem stromsparende Anwendungen, Intel Movidius VPUs für visionsspezifische Aufgaben und Qualcomm Snapdragon-Plattformen mit integrierten KI-Engines für Smartphone-basierte Inspektion. Die Wahl hängt vom Leistungsbudget, der Modellkomplexität und den Echtzeitanforderungen ab.
- Wie ermöglicht Modelloptimierung Edge-Inferenz?
- Modelloptimierungstechniken komprimieren tiefe neuronale Netze, um sie effizient auf ressourcenbeschränkter Edge-Hardware auszuführen. Quantisierung wandelt Modellgewichte von 32-Bit-Gleitkomma in 8-Bit-Integer (INT8) um, reduziert die Modellgröße um 75% und erhöht den Inferenzdurchsatz um das 2- bis 4-fache bei minimalem Genauigkeitsverlust (typischerweise <1%). Pruning entfernt redundante Gewichte oder Neuronen und erreicht eine Komprimierung von 40-60%. Knowledge Distillation trainiert ein kleineres Studentenmodell, um ein größeres Lehrermodell nachzuahmen. TensorRT ist das Optimierungs-SDK von NVIDIA, das Schichten fusioniert, optimierte Kernel auswählt und zielspezifische Quantisierung anwendet.
- Was ist Echtzeit-Risserkennung am Edge?
- Echtzeit-Risserkennung am Edge verwendet auf eingebetteten Geräten wie dem NVIDIA Jetson Nano bereitgestellte Convolutional Neural Networks (CNNs), um Betonoberflächenbilder während des Fluges als gerissen oder intakt zu klassifizieren. Eine Studie der University of Southern Queensland erreichte 96% Validierungsgenauigkeit mit transfer-gelerntem ResNet50 auf einem Jetson Nano bei Inferenzlatenzen unter 50ms pro 224x224 Bild. Fortgeschrittenere Segmentierungsmodelle wie U-Net erreichen bis zu 0,86 mittlere IoU bei 22 FPS auf dem Jetson Orin Nano bei nur 7W Stromverbrauch.
- Wie ermöglicht Edge Computing BVLOS-Operationen?
- Beyond Visual Line of Sight (BVLOS)-Operationen erfordern, dass die Drohne einen sicheren Flug ohne ständige menschliche visuelle Überwachung aufrechterhält. Edge Computing ermöglicht dies, indem es Hinderniserkennung, Geländekartierung und Navigationsentscheidungen in Echtzeit an Bord verarbeitet, selbst wenn die Command-and-Control (C2)-Verbindung beeinträchtigt oder vorübergehend verloren geht. Die ICAO- und FAA-Vorschriften für BVLOS betonen die Notwendigkeit autonomer Detect and Avoid (DAA)-Fähigkeiten, die auf latenzarmer Edge-KI angewiesen sind. Edge-Systeme reduzieren auch die für die Fernsteuerung erforderliche Kommunikationsbandbreite, indem sie nur Telemetrie-Zusammenfassungen und Warnungen übertragen.
- Was sind die Leistungs- und thermischen Einschränkungen von Edge Computing auf Drohnen?
- Edge Computing auf Drohnen arbeitet unter strengen Leistungsbeschränkungen. Eine typische kleine Inspektionsdrohne (z.B. DJI Matrice 300/350) hat ein gesamtes Nutzlast-Leistungsbudget von 25-50W, von dem das Edge-KI-Modul 7-25W ziehen kann. Der NVIDIA Jetson Orin Nano arbeitet mit 7-15W TDP, der Jetson AGX Orin mit 15-60W und der Google Coral mit nur 2W. Das Wärmemanagement ist ebenso kritisch: Passive Kühlung reicht für Module unter 10W aus, aber leistungsstärkere Module benötigen aktive Kühlung (Lüfter oder Kühlkörper), die Gewicht hinzufügt und zusätzliche Leistung verbraucht. Bei Umgebungstemperaturen über 40°C kann thermisches Drosseln den Inferenzdurchsatz um 30-50% reduzieren.
Dies ist ein Referenzeintrag. TarmacView bietet Drohneninspektionsdienste an und verkauft nicht die in diesem Glossar beschriebene Ausrüstung oder Materialien.