Czym jest adaptacja domenowa dla modeli inspekcji między różnymi nawierzchniami?
Adaptacja Domenowa dla Międzynawierzchniowych Modeli Inspekcyjnych: Kompletny Przewodnik Techniczny
Definicja i Problem Przesunięcia Domenowego
Adaptacja domenowa to podkategoria uczenia transferowego, która rozwiązuje fundamentalne wyzwanie we wdrażaniu modeli uczenia maszynowego: statystyczną niezgodność między danymi treningowymi a danymi wdrożeniowymi. Gdy model wytrenowany na domenie źródłowej, zbiorze danych o znanych cechach i zazwyczaj obfitującym w oznakowane przykłady, jest wdrażany na domenie docelowej o innych właściwościach statystycznych, wydajność spada. Adaptacja domenowa dostarcza metod do pokonania tej luki, umożliwiając modelom generalizację między domenami bez konieczności zbierania i oznaczania dużych nowych zbiorów danych dla każdego środowiska wdrożeniowego.
Formalnie, domena jest definiowana jako para składająca się z przestrzeni cech (X) i rozkładu prawdopodobieństwa (P(X)) nad tą przestrzenią: (D = {X, P(X)}). Zadanie to para składająca się z przestrzeni etykiet (Y) i funkcji predykcyjnej (f: X \to Y). Domena źródłowa (D_S) to domena, na której model jest początkowo trenowany z dużą ilością oznakowanych danych. Domena docelowa (D_T) to nowa domena, w której model ma działać, często z ograniczoną liczbą etykiet lub bez nich. Celem adaptacji domenowej jest nauczenie się funkcji (f_T: X_T \to Y_T) dla domeny docelowej poprzez wykorzystanie wiedzy z domeny źródłowej, pomimo niezgodności (P_S(X) \neq P_T(X)).
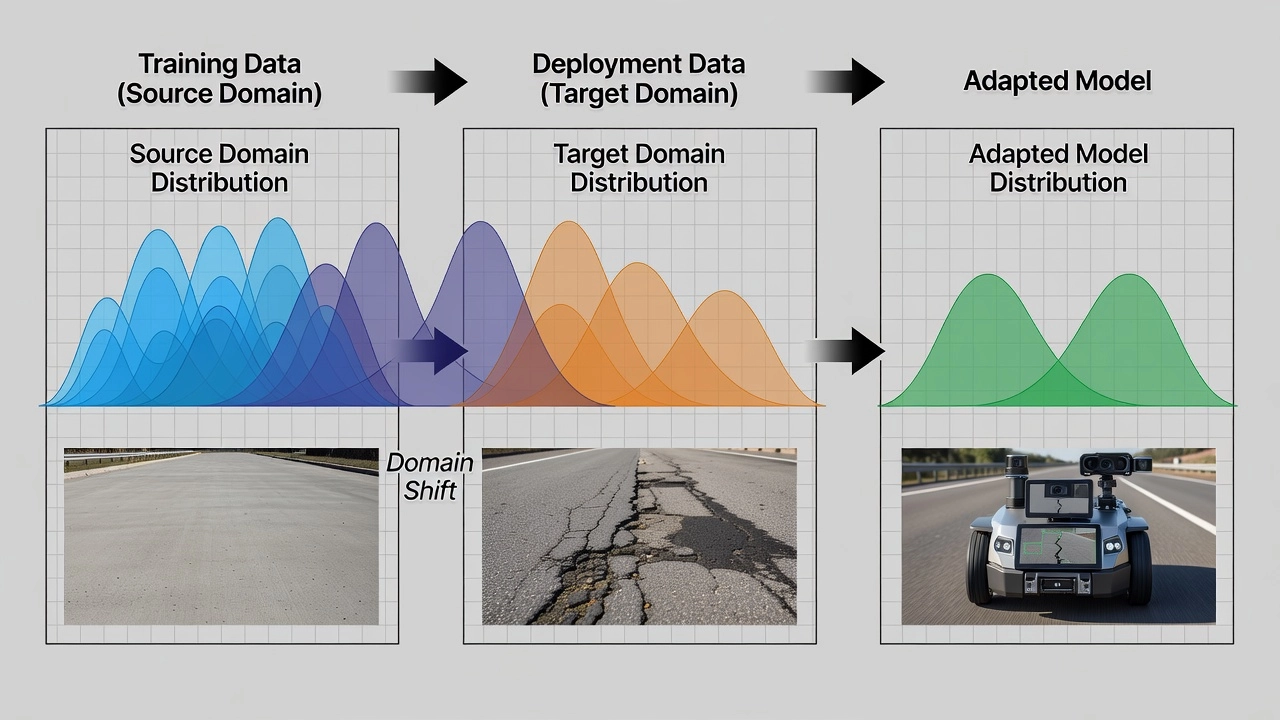
Przesunięcie domenowe (zwane również przesunięciem rozkładu lub przesunięciem zbioru danych) to zjawisko, w którym rozkład danych różni się między środowiskiem treningowym a wdrożeniowym. Gdy występuje przesunięcie domenowe, wydajność modelu spada, ponieważ nauczone mapowanie z wejść na wyjścia nie odpowiada już warunkom docelowym. Przesunięcie domenowe przejawia się w trzech głównych formach. Przesunięcie kowariancyjne występuje, gdy zmienia się rozkład cech wejściowych, podczas gdy warunkowy rozkład etykiet względem wejść pozostaje taki sam: formalnie (P_S(X) \neq P_T(X)) ale (P_S(Y|X) = P_T(Y|X)). Jest to najczęstsza forma w wizji komputerowej, wizualny wygląd pęknięcia na asfalcie różni się od pęknięcia na betonie, ale mapowanie z cech wizualnych na etykietę „pęknięty” pozostaje spójne. Przesunięcie etykiet (lub przesunięcie a priori) występuje, gdy zmienia się rozkład etykiet klas: (P_S(Y) \neq P_T(Y)) ale (P_S(X|Y) = P_T(X|Y)). Dzieje się tak, gdy gęstość pęknięć różni się między miejscem treningowym a wdrożeniowym. Przesunięcie koncepcji występuje, gdy zmienia się związek między wejściami a wyjściami: (P_S(Y|X) \neq P_T(Y|X)), na przykład, gdy wzór wizualny wskazujący na uszczelnione pęknięcie na drogach wskazuje na wadę strukturalną na pasach startowych.
Dla wizji komputerowej w inspekcji infrastruktury, przesunięcie domenowe wynika z wielu nakładających się czynników. Różnice w wyglądzie wizualnym obejmują teksturę nawierzchni (szorstki asfalt vs gładki beton), profile kolorów (ciemnoszary asfalt vs jasnoszary beton) i wzorce starzenia (utleniona powierzchnia vs świeżo położona). Warunki rejestracji takie jak oświetlenie (bezpośrednie światło słoneczne pod kątem 60° vs rozproszone światło pochmurne), rozdzielczość kamery i czułość widmowa czujnika oraz kąt rejestracji obrazu (nadir z UAV vs ukośny z pojazdu) wszystkie przyczyniają się do znaczących przesunięć rozkładu. Czynniki środowiskowe w tym mokre vs suche powierzchnie, zacienienie od konstrukcji oraz sezonowe zanieczyszczenia (liście, śnieg, stojąca woda) dodatkowo komplikują problem. Różnice w materiale nawierzchni między asfaltem a betonem, lub między starzejącymi się a świeżo położonymi powierzchniami, stanowią jedno z najtrudniejszych przesunięć domenowych dla modeli inspekcji nawierzchni.
Badania udokumentowały ilościowo dotkliwość przesunięcia domenowego w wykrywaniu pęknięć nawierzchni. Ramy DDACRN wykazały, że bez adaptacji domenowej, średni wskaźnik Intersection over Union (mIoU) wykrywania pęknięć spada z 0,72 na źródłowych danych testowych do 0,31 na międzydatasetowych danych docelowych, co stanowi 57% redukcję wydajności. DACrack wykazał, że łagodzenie przesunięcia domenowego poprzez wielopoziomowe wyrównywanie cech odzyskuje około 20 punktów procentowych wskaźnika F1 w transferach międzydatasetowych. Te empiryczne wyniki podkreślają, dlaczego adaptacja domenowa nie jest jedynie akademickim udoskonaleniem, ale operacyjną koniecznością dla każdego systemu inspekcyjnego wdrażanego na wielu lotniskach, drogach lub sieciach mostów.
Przesunięcie Domenowe w Obrazowaniu Infrastruktury
Obrazy inspekcji infrastruktury podlegają wielu oddziałującym na siebie źródłom przesunięcia domenowego, które wzajemnie się potęgują. Zrozumienie każdego źródła jest niezbędne do zaprojektowania skutecznych strategii adaptacyjnych.
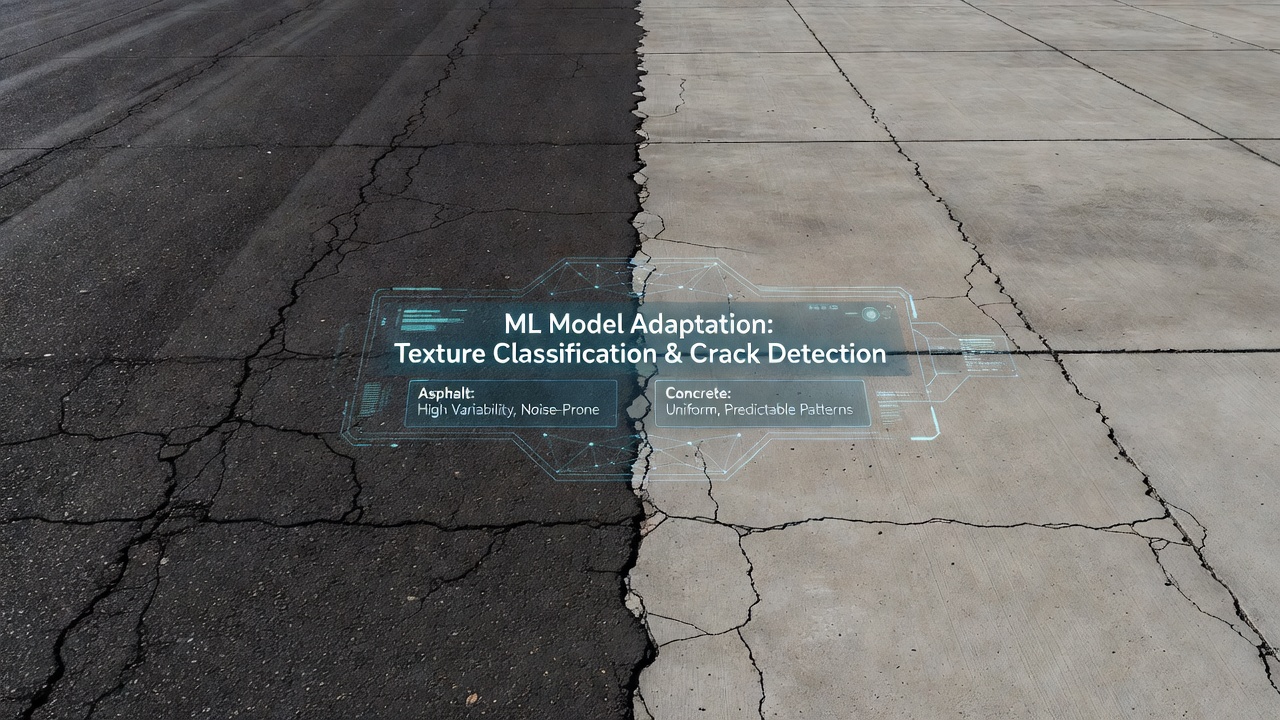
Przesunięcie materiału nawierzchni jest najbardziej widocznym przesunięciem domenowym w inspekcji infrastruktury. Nawierzchnie asfaltowe i betonowe mają fundamentalnie różne cechy wizualne. Asfalt jest ciemnoszary do czarnego, ma chropowatą i nieregularną teksturę powierzchni, a pęknięcia zazwyczaj pojawiają się jako jasne, liniowe cechy na ciemnym tle. Beton jest jasnoszary do białego, ma gładszą i bardziej jednolitą powierzchnię, a pęknięcia pojawiają się jako ciemne linie. Te różnice oznaczają, że splotowa sieć neuronowa wytrenowana na jednym typie nawierzchni uczy się filtrów i reprezentacji cech specyficznych dla statystyk wizualnych tej powierzchni. Po zastosowaniu do innego typu nawierzchni, filtry te generują aktywacje cech, których warstwy klasyfikatora nie mogą poprawnie zinterpretować. Dane z DDACRN pokazują, że międzypowierzchniowe mIoU spada z 0,72 do 0,31 bez adaptacji przy przenoszeniu z modeli trenowanych na asfalcie do testowanych na betonie.
Zmienność morfologii pęknięć wprowadza kolejną warstwę przesunięcia domenowego. Różne typy uszkodzeń nawierzchni mają odrębne sygnatury wizualne. Pęknięcia podłużne biegną równolegle do osi nawierzchni i pojawiają się jako długie, ciągłe cechy liniowe. Pęknięcia poprzeczne biegną prostopadle do osi. Pęknięcia siatkowe (zmęczeniowe) tworzą połączone sieci małych wielokątów przypominających skórę aligatora. Pęknięcia włoskowate mają szerokość mniejszą niż 1 mm i mogą być ledwo widoczne, podczas gdy szerokie pęknięcia przekraczają 5 mm i są łatwe do zidentyfikowania. Uszczelnione pęknięcia wypełnione materiałem uszczelniającym mają inny wygląd wizualny niż nieuszczelnione pęknięcia. Model wytrenowany głównie na pęknięciach podłużnych może nie wykryć pęknięć siatkowych w domenie docelowej, gdzie ten typ uszkodzenia jest bardziej powszechny.
Przesunięcie warunków oświetleniowych znacząco wpływa na wydajność modelu. Modele wytrenowane na dobrze oświetlonych obrazach dziennych uchwyconych w bezpośrednim świetle słonecznym zawodzą na obrazach o słabym oświetleniu lub o zmierzchu, obrazach z ostrymi cieniami rzucanymi przez konstrukcje lub drzewa oraz obrazach uchwyconych w warunkach pochmurnych, gdzie rozproszone oświetlenie zmniejsza kontrast. Kąt padania światła względem normalnej powierzchni zmienia wygląd krawędzi pęknięć, światło słoneczne pod niskim kątem podkreśla teksturę powierzchni, rzucając cienie wewnątrz pęknięć, podczas gdy światło słoneczne pod wysokim kątem nad głową minimalizuje widoczność pęknięć. Zacienienie od konstrukcji mostów, budynków terminali lotniskowych lub pobliskich konstrukcji powoduje lokalne ciemne obszary, w których cechy pęknięć są tłumione. Badania udokumentowały 5–12% spadki dokładności modeli wykrywania pęknięć, gdy warunki oświetleniowe odbiegają od rozkładu treningowego.
Przesunięcie kamery i czujnika wynika z różnic w sprzęcie obrazującym. Różne kamery dają różne rozdzielczości obrazu (12 MP smartfon vs 50 MP lustrzanka cyfrowa vs specjalistyczna kamera przemysłowa), różne profile kolorów i krzywe czułości widmowej czujnika, różne cechy dystorsji obiektywu oraz różne wzorce szumów. W przypadku inspekcji z użyciem UAV, wysokość lotu określa Odległość Próbkowania Gruntu (GSD), fizyczną odległość na ziemi reprezentowaną przez każdy piksel. UAV lecący na wysokości 30 m daje GSD około 0,5–1 cm/piksel, podczas gdy na wysokości 100 m daje 2–5 cm/piksel. Różnice w GSD oznaczają, że to samo pęknięcie jest reprezentowane przez różną liczbę pikseli i różną zawartość częstotliwości przestrzennej w domenie źródłowej vs docelowej. Dostrajanie z ponownym obliczaniem statystyk Normalizacji Wsadowej (BN) jest często wystarczające dla umiarkowanych przesunięć kamery, podczas gdy poważne przesunięcia wymagają adwersarialnego wyrównania domen na wielu poziomach cech.
Przesunięcie sezonowe i środowiskowe wprowadza czasową zmienność domeny. Model wytrenowany na obrazach letnich musi działać w warunkach zimowych, gdzie powierzchnie mogą być mokre, pokryte śniegiem lub częściowo zasłonięte opadłymi liśćmi. Nawierzchnie ulegają starzeniu i utlenianiu z biegiem czasu, zmieniając swój kolor i teksturę. FAA i ICAO Globalny Format Raportowania (GRF) wyraźnie uznaje warunki środowiskowe jako zmienną wpływającą na ocenę stanu pasa startowego: suche, mokre, śliskie mokre i zanieczyszczone powierzchnie każda stanowi odrębną domenę wizualną wymagającą innej interpretacji inspekcyjnej.
| Źródło Przesunięcia Domenowego | Typowy Wpływ na Wydajność | Podstawowa Strategia Łagodzenia |
|---|---|---|
| Materiał nawierzchni (asfalt vs beton) | 30–45% spadek mIoU | Adwersarialna DA + wielopoziomowe wyrównywanie cech |
| Warunki oświetleniowe (słonecznie vs pochmurnie) | 5–12% spadek dokładności | Adaptacja BN + augmentacja fotometryczna |
| Rozdzielczość kamery / czujnik | 3–8% spadek dokładności | Dostrajanie + ponowne obliczanie statystyk BN |
| Sezonowe / środowiskowe | 8–20% spadek dokładności | Generacyjne tłumaczenie domen (CycleGAN) |
| Geograficzne / regionalne | 10–25% spadek dokładności | Wieloźródłowa UDA + progresywne łączenie domen |
Dostrajanie dla Adaptacji Domenowej
Dostrajanie to najprostsza i najczęściej stosowana strategia adaptacji domenowej. Polega na wzięciu sieci neuronowej wstępnie wytrenowanej na domenie źródłowej i kontynuowaniu procesu trenowania na danych domeny docelowej, aktualizując wagi modelu, aby dostosować jego reprezentacje do rozkładu docelowego. Dostrajanie wypełnia lukę między uczeniem transferowym (gdzie zmienia się zadanie) a adaptacją domenową (gdzie zadanie pozostaje takie samo, ale zmienia się rozkład danych).
Podstawa teoretyczna dostrajania opiera się na obserwacji, że sieci neuronowe uczą się hierarchicznych reprezentacji cech. Wczesne warstwy przechwytują cechy niskiego poziomu, takie jak krawędzie, tekstury i plamy kolorów, które są w dużej mierze niezależne od domeny. Środkowe warstwy łączą je we wzorce średniego poziomu, takie jak krawędzie pęknięć, ziarno powierzchni i granice spoin. Późne warstwy uczą się cech specyficznych dla zadania, zoptymalizowanych pod kątem celu klasyfikacji lub segmentacji. Gdy domena się zmienia, zmieniają się statystyki niskiego poziomu (rozkłady kolorów, częstotliwości tekstur, cechy kontrastu), a późne warstwy, które są precyzyjnie dostrojone do rozkładów cech domeny źródłowej, tracą swoje dopasowanie.
Pełne dostrajanie aktualizuje wszystkie parametry modelu na danych docelowych. Jest to odpowiednie, gdy dostępna jest duża ilość oznakowanych danych docelowych (setki do tysięcy obrazów), a zasoby obliczeniowe pozwalają na pełne aktualizacje gradientu. Szybkość uczenia jest zazwyczaj zmniejszana 10-krotnie w stosunku do początkowego wstępnego trenowania, aby zapobiec katastroficznemu zapominaniu, zjawisku, w którym model nadpisuje użyteczną wiedzę z domeny źródłowej. Wczesne zatrzymanie na podstawie straty walidacyjnej domeny docelowej jest niezbędne do zrównoważenia zachowania wiedzy źródłowej z adaptacją docelową.
Dostrajanie ostatniej warstwy (klasyfikatora) zamraża wszystkie warstwy ekstrakcji cech i trenuje tylko końcową głowę klasyfikacyjną lub segmentacyjną. To podejście zakłada, że ekstraktor cech nauczony na domenie źródłowej wytwarza reprezentacje wystarczająco ogólne, a jedynie mapowanie z cech na etykiety wymaga dostosowania. Dostrajanie ostatniej warstwy jest skuteczne, gdy dostępna jest bardzo ograniczona ilość danych docelowych (dziesiątki obrazów), a przesunięcie domenowe dotyczy głównie przestrzeni etykiet, a nie przestrzeni cech. Wymaga minimalnych obliczeń i jest odporne na katastroficzne zapominanie.
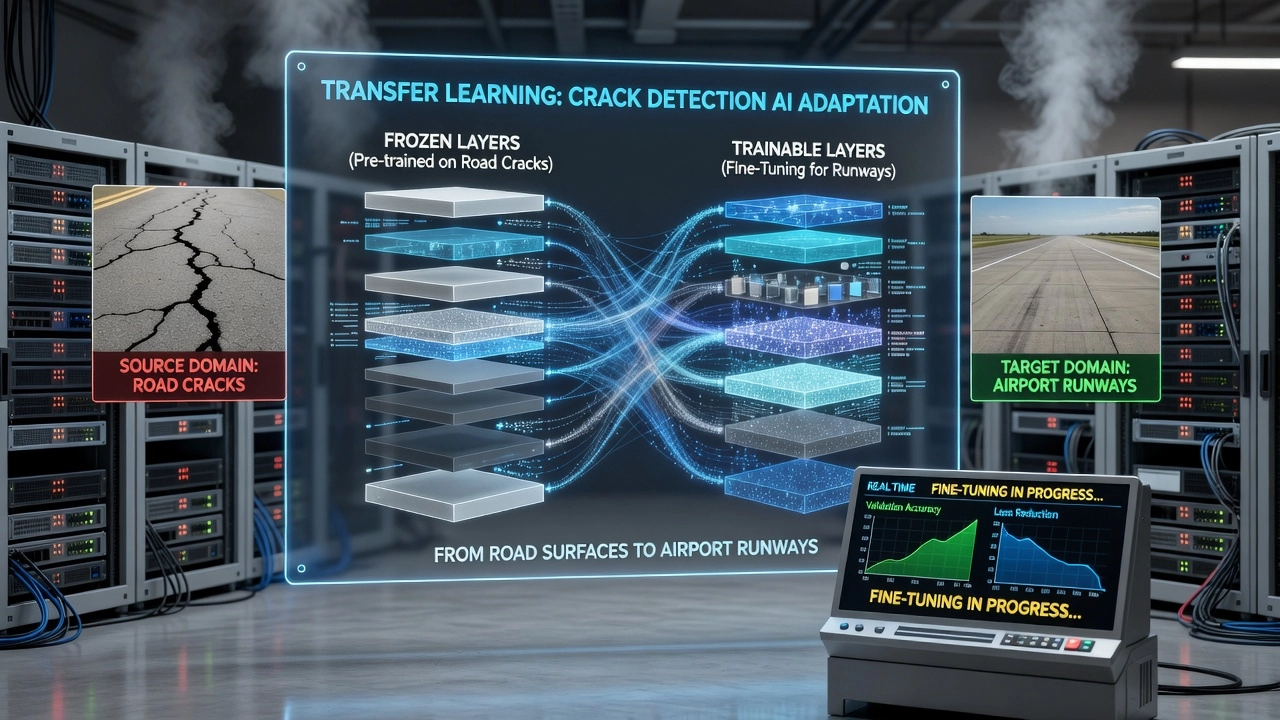
Stopniowe odblokowywanie zapewnia rozwiązanie pośrednie. Proces trenowania rozpoczyna się od zamrożenia wszystkich warstw z wyjątkiem końcowego klasyfikatora, który jest trenowany przez kilka epok. Następnie odblokowywane są najwyższe warstwy ekstrakcji cech i trenowane razem z klasyfikatorem. Proces ten jest kontynuowany, stopniowo odblokowując warstwy od góry do dołu, aż wszystkie warstwy będą dostrajane lub zostanie osiągnięty plateau wydajności. Stopniowe odblokowywanie jest odpowiednie dla umiarkowanych ilości danych docelowych (setki obrazów) i przesunięć domenowych, które wpływają na wiele poziomów hierarchii cech.
Moduły adapterów wprowadzają małe warstwy wąskiego gardła ze znacznie mniejszą liczbą parametrów niż pełna sieć. Te adaptery są wstawiane między warstwy zamrożonego wstępnie wytrenowanego rdzenia i są jedynymi parametrami aktualizowanymi podczas dostrajania. Dostrajanie oparte na adapterach jest wysoce wydajne pod względem parametrów, zazwyczaj 1–5% całkowitej liczby parametrów, i umożliwia szybkie przełączanie między wieloma docelowymi domenami poprzez przechowywanie i ładowanie różnych wag adapterów. Dla sieci inspekcji infrastruktury z milionami parametrów, moduły adapterów umożliwiają wdrożenie na dziesiątkach lotnisk bez przechowywania oddzielnych kopii pełnych wag dla każdego z nich.
Adaptacja Normalizacji Wsadowej (BN) to niezwykle lekka, a zarazem skuteczna technika. Warstwy BN obliczają bieżące średnie i wariancje statystyk podczas trenowania, aby normalizować pośrednie mapy cech. Gdy domena się zmienia, te statystyki nie reprezentują już dokładnie rozkładu docelowego. Adaptacja BN po prostu ponownie oblicza statystyki BN, przepuszczając dane domeny docelowej przez sieć z zamrożonymi wagami, aktualizując bieżącą średnią i wariancję bez żadnych aktualizacji gradientu. To samo może znacząco zmniejszyć przesunięcie domenowe, gdy główna różnica dotyczy statystyk obrazu niskiego poziomu, takich jak jasność, kontrast i rozkład kolorów. Badania nad wykrywaniem pęknięć pokazują, że adaptacja BN odzyskuje 3–8% spadków dokładności spowodowanych umiarkowanymi przesunięciami oświetlenia i kamery, wymagając tylko jednego przejścia w przód nieoznakowanych danych docelowych.
| Strategia Dostrajania | Wymagane Dane Docelowe | Zaktualizowane Parametry | Ryzyko Katastroficznego Zapominania | Najlepsze Zastosowanie |
|---|---|---|---|---|
| Ponowne obliczanie statystyk BN | Brak (nieoznakowane) | 0 (tylko statystyki BN) | Brak | Przesunięcia oświetlenia / kamery |
| Dostrajanie ostatniej warstwy | 10–50 oznakowanych | < 1% | Bardzo niskie | Zachowany rozkład cech |
| Moduły adapterów | 50–200 oznakowanych | 1–5% | Niskie | Wdrożenie wielodomenowe |
| Stopniowe odblokowywanie | 100–500 oznakowanych | Stopniowe, 10–100% | Umiarkowane | Umiarkowane przesunięcie domenowe |
| Pełne dostrajanie | 500+ oznakowanych | 100% | Wysokie | Dużo danych docelowych, duże przesunięcie |
Nadzorowana Adaptacja Domenowa
Nadzorowana adaptacja domenowa (SDA) działa przy założeniu, że niewielka ilość oznakowanych danych jest dostępna w domenie docelowej wraz z dużą ilością oznakowanych danych źródłowych. Jest to najbardziej bezpośrednie ustawienie: model ma bezpośredni dostęp do informacji o prawdzie podstawowej dotyczącej domeny docelowej, umożliwiając jawną optymalizację pod kątem wydajności docelowej.
Standardowe podejście SDA składa się z dwóch komponentów. Po pierwsze, model jest wstępnie trenowany na domenie źródłowej z jej obfitymi etykietami, co ustanawia ogólną wiedzę o zadaniu inspekcyjnym, ucząc się rozpoznawać krawędzie pęknięć, granice spoin, tekstury powierzchni i geometrie uszkodzeń. Po drugie, model jest dostrajany na oznakowanych danych docelowych przy użyciu znacznie zmniejszonej szybkości uczenia. Podczas dostrajania funkcja straty zazwyczaj łączy straty źródłowe i docelowe, aby zapobiec zapomnieniu przez model użytecznej wiedzy z domeny źródłowej. Połączona strata jest wyrażona jako:
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
gdzie (\mathcal{L}_S) to strata źródłowa obliczona na danych źródłowych, (\mathcal{L}_T) to strata docelowa obliczona na oznakowanych danych docelowych, a (\lambda) kontroluje względny wkład każdej domeny. Podczas trenowania, partie źródłowe i docelowe są naprzemiennie lub łącznie przepuszczane przez sieć.
Kluczowe techniki nadzorowanej adaptacji domenowej obejmują ważone funkcje straty, które nadają większe znaczenie próbkom domeny docelowej podczas dostrajania, wspólne trenowanie, gdzie oznakowane dane źródłowe i docelowe są mieszane w każdej partii treningowej, oraz adwersarialne trenowanie domenowe, gdzie klasyfikator domeny jest dodawany nawet w ustawieniu nadzorowanym, aby zachęcić ekstraktor cech do uczenia się reprezentacji niezmienniczych względem domeny. Strategie uczenia programowego rozpoczynają się od trenowania zdominowanego przez źródło i stopniowo przesuwają równowagę w kierunku danych docelowych w miarę postępu trenowania.
Transfer parametrów, gdzie wagi modelu wytrenowanego na źródle służą jako inicjalizacja, jest dominującą strategią w SDA. Sukces tego podejścia zależy od stopnia pokrewieństwa między domeną źródłową a docelową. Gdy domeny są blisko spokrewnione (np. różne sekcje tego samego pasa startowego lotniska), wystarczy bardzo niewiele oznakowanych przykładów docelowych, już 20–50 obrazów może odzyskać większość wydajności utraconej z powodu przesunięcia domenowego. Gdy domeny są bardziej odległe (np. droga na pas startowy), do solidnej adaptacji wymagane jest zazwyczaj 200–500 oznakowanych przykładów docelowych.
Wydajne etykietowo techniki SDA mają na celu zminimalizowanie liczby potrzebnych etykiet docelowych. Uczenie aktywne identyfikuje najbardziej informacyjne próbki docelowe do oznakowania: model jest trenowany na danych źródłowych, stosowany do nieoznakowanych danych docelowych, a próbki, co do których jest najbardziej niepewny, są wybierane do oznakowania przez człowieka. To podejście może zmniejszyć wymagania dotyczące etykietowania o 50–70% w porównaniu z losowym próbkowaniem. Samotrenowanie (lub pseudo-etykietowanie) stosuje model wytrenowany na źródle do nieoznakowanych danych docelowych, generuje tymczasowe etykiety dla prognoz o wysokim poziomie ufności i ponownie trenuje model, używając tych pseudo-etykiet jako dodatkowego nadzoru. Samotrenowanie jest szczególnie skuteczne w połączeniu z progowaniem ufności i augmentacją danych.
Kiedy stosować SDA: gdy uzyskanie małego oznakowanego zestawu z każdego docelowego miejsca wdrożenia jest wykonalne. W przypadku inspekcji pasa startowego lotniska oznacza to, że przeszkolony inspektor może oznaczyć 50–200 obrazów na lotnisko, co jest jednorazowym kosztem 1–4 godzin na miejsce. Jest to o wiele bardziej ekonomiczne niż alternatywa polegająca na zbieraniu i oznaczaniu tysięcy obrazów na lotnisko, co wymagałoby wielu dni na miejsce. FAA AC 150/5380-6C zaleca regularne badania PCI, które już angażują inspektorów badających powierzchnie nawierzchni, ci sami inspektorzy mogą dostarczyć kilkaset oznakowanych obrazów potrzebnych do SDA w ramach swojego standardowego przepływu pracy inspekcyjnej.
Nienadzorowana Adaptacja Domenowa
Nienadzorowana adaptacja domenowa (UDA) to najbardziej wymagające i aktywnie badane ustawienie adaptacji domenowej. Zakłada, że oznakowane dane istnieją tylko w domenie źródłowej, podczas gdy domena docelowa jest całkowicie nieoznakowana. UDA jest dominującym scenariuszem dla inspekcji infrastruktury, ponieważ oznaczanie danych domeny docelowej jest kosztowne, czasochłonne lub niepraktyczne w wielu miejscach wdrożenia. Model wytrenowany na obrazach nawierzchni jednego lotniska musi dostosować się do powierzchni, oświetlenia i wzorców uszkodzeń innego lotniska, bez wymagania, aby każde lotnisko wyprodukowało oznakowany zbiór danych.
Metody UDA dzielą się na trzy główne kategorie: metody adwersarialne, metody oparte na rozbieżności i metody oparte na rekonstrukcji. Wszystkie mają wspólny cel, jakim jest wyrównanie rozkładów cech źródłowych i docelowych, tak aby klasyfikator wytrenowany na cechach źródłowych generalizował na cechy docelowe.
Adwersarialna Adaptacja Domenowa
Adwersarialna adaptacja domenowa czerpie inspirację z Generacyjnych Sieci Przeciwnych (GAN). Podstawową ideą jest wytrenowanie dyskryminatora domeny (binarnego klasyfikatora, który przewiduje, czy reprezentacja cech pochodzi z domeny źródłowej, czy docelowej) obok ekstraktora cech w grze minimax. Ekstraktor cech stara się wytwarzać cechy nieodróżnialne między źródłem a celem, podczas gdy dyskryminator stara się poprawnie zidentyfikować pochodzenie każdej cechy.
Kanoniczną architekturą jest Adwersarialna Sieć Neuronowa z Odwróceniem Gradientu (DANN), wprowadzona przez Jarosława Ganina i Victora Lempitsky’ego w 2015 roku. DANN składa się z trzech komponentów: ekstraktora cech (G_f), który mapuje wejścia do przestrzeni cech (f = G_f(x, \theta_f)), predyktora etykiet (G_y), który mapuje cechy na etykiety zadań (\hat{y} = G_y(f, \theta_y)), oraz klasyfikatora domeny (G_d), który mapuje cechy na etykiety domen (\hat{d} = G_d(f, \theta_d)). Kluczową innowacją jest Warstwa Odwrócenia Gradientu (GRL) umieszczona między ekstraktorem cech a klasyfikatorem domeny. Podczas propagacji w przód, GRL działa jako transformacja tożsamościowa. Podczas wstecznej propagacji mnoży gradient przez (-\lambda), gdzie (\lambda) jest hiperparametrem kontrolującym siłę adaptacji. To odwrócenie powoduje, że ekstraktor cech uczy się cech, które maksymalizują stratę klasyfikacji domeny, skutecznie ucząc się oszukiwać klasyfikator domeny.
Funkcja straty DANN łączy stratę zadania na źródłowych etykietach minus stratę klasyfikacji domeny na cechach zarówno źródłowych, jak i docelowych:
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
W miarę postępu trenowania, ekstraktor cech uczy się reprezentacji, które są zarówno dyskryminujące dla zadania (ponieważ predyktor etykiet jest trenowany na źródłowych etykietach), jak i niezmiennicze względem domeny (ponieważ klasyfikator domeny nie może rozróżnić pochodzenia domeny). Harmonogram GRL zazwyczaj zaczyna się od (\lambda = 0) i stopniowo zwiększa do wartości maksymalnej w ciągu pierwszych kilku epok, umożliwiając sieci ustabilizowanie wydajności zadania, zanim zostanie zastosowane ciśnienie pomieszania domen.
Ostatnie osiągnięcia w adwersarialnej adaptacji domenowej obejmują Kontrastywne Trenowanie Adwersarialne (CAT), które wykorzystuje oznakowane próbki źródłowe do wzmocnienia separacji cech przy jednoczesnym utrzymaniu wyrównania domen, Sieci Współpracujące i Adwersarialne (CAN), które wykonują wielopoziomowe wyrównanie domen na różnych poziomach hierarchii cech, oraz Minimalizację Adwersarialnej Rozbieżności Stylu, która wykorzystuje transfer stylu jako cel adwersarialny. W przypadku wykrywania pęknięć nawierzchni, metody adwersarialne wykazały najsilniejszą generalizację międzydatasetową, odzyskując 15–25 punktów procentowych wydajności utraconej z powodu przesunięcia domenowego.
Metody Oparte na Rozbieżności
Metody oparte na rozbieżności przyjmują inne podejście: zamiast trenowania adwersarialnego, jawnie minimalizują statystyczną miarę odległości między rozkładami cech źródłowych i docelowych. Zaletą jest stabilność trenowania, brak dynamiki adwersarialnej wymagającej starannego dostrajania hiperparametrów, kosztem potencjalnie słabszego wyrównania.
Maksymalna Średnia Rozbieżność (MMD) jest najczęściej używaną miarą rozbieżności w adaptacji domenowej. MMD to jądrowy test statystyczny, który mierzy odległość między dwoma rozkładami w Reprodukującej się Przestrzeni Hilberta z Jądrem (RKHS). Mając źródłowe cechy (\mathbf{f}^S) i docelowe cechy (\mathbf{f}^T), kwadrat MMD wynosi:
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
gdzie (\phi) jest mapą cech do RKHS. W praktyce MMD jest obliczana przy użyciu funkcji jądra (k(x,y) = \langle \phi(x), \phi(y) \rangle), zazwyczaj jądra Gaussa RBF, często z wieloma szerokościami pasma, aby uchwycić różne poziomy podobieństwa rozkładu.
Sieci Głębokiej Adaptacji (DAN), wprowadzone przez Longa i in. w 2015 roku, dodają stratę MMD do wielu warstw specyficznych dla zadania głębokiego CNN. Całkowita strata staje się (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), gdzie (L) to zbiór warstw, na których stosowane jest wyrównanie domen. DAN wykazały, że wyrównywanie reprezentacji cech wyższego poziomu (a nie tylko ostatniej warstwy) znacząco poprawia jakość adaptacji.
Wyrównanie KORelacji (CORAL), wprowadzone przez Sun i Saenko w 2016 roku, przyjmuje prostsze podejście, minimalizując różnicę między macierzami kowariancji cech źródłowych i docelowych:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
gdzie (C_S) i (C_T) to macierze kowariancji cech odpowiednio źródłowych i docelowych, (d) to wymiar cech, a (|\cdot|_F) to norma Frobeniusa. Deep CORAL rozszerza to na głębokie sieci, dodając stratę CORAL do funkcji straty sieci. CORAL jest wydajny obliczeniowo i działa dobrze, gdy przesunięcie domenowe dotyczy głównie wariancji cech, a nie średniej.
Sieci Wspólnej Adaptacji (JAN) rozszerzają DAN poprzez wyrównywanie łącznych rozkładów wielu warstw, a nie traktowanie każdej warstwy niezależnie. JAN używa Wspólnej MMD (JMMD), zdefiniowanej na iloczynie tensorowym aktywacji z wielu warstw. Pozwala to uchwycić zależności międzywarstwowe, które pomijają indywidualne straty MMD.
Ostatnie osiągnięcia dla inspekcji infrastruktury obejmują ramy Wanga i in. (2025) do segmentacji korozji, które łączą trzy uzupełniające się moduły rozbieżności: Zachowanie Struktury Geometrycznej (GSP), które zachowuje lokalne relacje topologiczne między domenami przy użyciu regularyzacji opartej na grafach, Lokalną Rozbieżność Opartą na SVD (SLD), która wykorzystuje rozkład według wartości osobliwych do wyrównywania lokalnych podprzestrzeni cech na drobnoziarnistym poziomie, oraz Globalne Wyrównanie Spójności (GCA), które wykorzystuje MMD do pogodzenia globalnych przesunięć rozkładu. To połączone podejście, wspierane przez lekki rdzeń segmentacyjny EffSegNet, osiągnęło silną generalizację międzydomenową z laboratoryjnych obrazów korozji do warunków polowych na śluzach, tamach i infrastrukturze transportowej.
Porównanie Metod UDA
| Metoda | Kategoria | Mechanizm Wyrównania | Stabilność Trenowania | Wydajność Infrastrukturalna |
|---|---|---|---|---|
| DANN | Adwersarialna | Odwrócenie gradientu + klasyfikator domeny | Umiarkowana (wymaga strojenia (\lambda)) | Silna (odzyskuje 15–25 ppt mIoU) |
| DAN | Rozbieżność | MMD na wyjściach wielu warstw | Wysoka | Dobra (odzyskuje 10–20 ppt mIoU) |
| Deep CORAL | Rozbieżność | Wyrównanie kowariancji (statystyki 2. rzędu) | Wysoka | Umiarkowana (odzyskuje 8–15 ppt mIoU) |
| JAN | Rozbieżność | Wspólna MMD na parach warstw | Wysoka | Dobra (odzyskuje 12–18 ppt mIoU) |
| CycleGAN+Det | Generacyjna | Tłumaczenie obraz-na-obraz + model zadania | Niska (trudność trenowania GAN) | Silna, gdy tłumaczenie obrazu się powiedzie |
| CAT | Adwersarialna | Kontrastywna + adwersarialna | Umiarkowana | Silna (najnowocześniejsza na kilku benchmarkach) |
Uczenie się Cech Niezmienniczych Względem Domeny
Cechy niezmiennicze względem domeny to reprezentacje cech wytwarzane przez sieć neuronową, które mają ten sam rozkład statystyczny niezależnie od tego, z której domeny pochodzi wejście. Jeśli (f(x)) jest reprezentacją cech wyodrębnioną przez sieć, niezmienniczość domeny oznacza (P(f(X_S)) \approx P(f(X_T))). Celem jest nauczenie się mapowania (f) takiego, że odległość (d(P(f(X_S)), P(f(X_T)))) jest zminimalizowana przy jednoczesnym zachowaniu dyskryminującej mocy specyficznej dla zadania.
Cztery główne podejścia do uczenia się cech niezmienniczych względem domeny różnie radzą sobie z kompromisem między niezmienniczością a dyskryminowalnością. Uczenie adwersarialne (DANN, oparte na GAN) popycha ekstraktor cech do wytwarzania cech, których dyskryminator domeny nie może rozróżnić. Jest to najbardziej agresywny mechanizm niezmienniczości, ale ryzykuje usunięciem informacji istotnych dla zadania, jeśli tekstura pęknięcia koreluje z typem nawierzchni. Dopasowywanie momentów statystycznych (MMD, CORAL) wyrównuje momenty rozkładu, pierwszego rzędu (średnia) i drugiego rzędu (kowariancja), między cechami źródłowymi i docelowymi. Zachowuje to więcej informacji istotnych dla zadania niż pełne wyrównanie adwersarialne, ale może nie uchwycić różnic rozkładu wyższego rzędu. Optymalny transport (metody oparte na OT) znajduje mapowanie o minimalnym koszcie między rozkładami źródłowymi i docelowymi, zapewniając geometryczną interpretację wyrównania domen. Metody transferu stylu i generacyjne (CycleGAN, StarGAN) przekształcają obrazy z jednej domeny, aby wizualnie przypominały inną, zanim zostaną przepuszczone przez sieć zadaniową. Działa to na poziomie pikseli, a nie na poziomie cech, i ma tę zaletę, że wytwarza interpretowalne przekształcone obrazy.
Kompromis między niezmienniczością a dyskryminowalnością to fundamentalne napięcie w uczeniu się cech niezmienniczych względem domeny. Maksymalizacja niezmienniczości domeny może usunąć informacje istotne dla zadania, które korelują z domeną. Na przykład, jeśli krawędzie pęknięć na asfalcie mają wyższy kontrast niż na betonie, detektor cech oparty na sile kontrastu krawędzi będzie czuły zarówno na obecność pęknięcia, jak i typ nawierzchni. Wymuszenie całkowitej niezmienniczości względem typu nawierzchni może stłumić cechy kontrastu krawędzi potrzebne do wykrywania pęknięć. Zaawansowane metody rozwiązują ten problem poprzez wyrównanie wielopoziomowe, wyrównując tylko cechy semantyczne wyższego poziomu, zachowując jednocześnie wskazówki teksturowe niskiego poziomu, oraz wyrównanie warunkowe, które wyrównuje rozkłady warunkowane etykietą zadania, zachowując informacje dyskryminujące klasy.
Niezmienniczość domeny oparta na uwadze wykorzystuje mechanizmy uwagi, aby skupić się na niezależnych od domeny regionach semantycznych. Model wykrywania pęknięć z modułem uwagi przestrzennej uczy się zwracać uwagę na struktury pęknięć niezależnie od tekstury tła nawierzchni. Same mapy uwagi stają się bardziej niezmiennicze względem domeny niż surowe mapy cech, ponieważ podkreślają istotne dla zadania lokalizacje przestrzenne, jednocześnie tłumiąc specyficzne dla domeny tło. Krzyżowa uwaga między cechami źródłowymi i docelowymi dodatkowo to wzmacnia, jawnie dopasowując regiony objęte uwagą między domenami.
Samodzielna adaptacja domenowa wykorzystuje zadania pretekstowe, takie jak przewidywanie rotacji, rozwiązywanie układanek lub kontrastywne rozróżnianie instancji, aby nauczyć się cech odpornych na zmienność domeny bez konieczności stosowania jakichkolwiek etykiet domen. Rozwiązując te zadania pomocnicze, model uczy się wychwytywać właściwości strukturalne i geometryczne wejścia, które są wspólne dla domen. Samodzielnie wstępnie wytrenowane cechy często wykazują silniejszą niezmienniczość domeny niż cechy czysto nadzorowane, ponieważ zadania pretekstowe nie zależą od specyficznych dla domeny rozkładów etykiet.
Adaptacja z Drogi na Pas Startowy
Przejście z inspekcji nawierzchni drogowej na inspekcję pasa startowego lotniska stanowi jeden z najtrudniejszych problemów adaptacji domenowej w zarządzaniu majątkiem infrastrukturalnym. Drogi i pasy startowe to fundamentalnie różne konstrukcje inżynieryjne zaprojektowane dla różnych obciążeń, prędkości i wymogów bezpieczeństwa, co skutkuje dramatycznie różnym wyglądem wizualnym i charakterystyką uszkodzeń.
| Czynnik | Nawierzchnia Drogowa | Nawierzchnia Pasa Startowego Lotniska |
|---|---|---|
| Norma projektowa | Różna w zależności od jurysdykcji | ICAO Annex 14 / normy FAA |
| Obciążenie na oś | ~10 ton (pojazdy) | 50–400 ton (samoloty) |
| Podstawowy materiał nawierzchni | Asfalt (HMA) | Wysokowytrzymały beton PCC (często) lub asfalt ciężki |
| Oznakowanie | Żółte/białe oznakowanie pasów (wiele kolorów) | Tylko białe oznakowanie, złożone wzory (próg, strefa przyziemienia, punkt celowania, linia środkowa) |
| Podstawowe typy uszkodzeń | Pęknięcia, dziury, koleiny, wycieki | Pęknięcia, FOD, osady gumy, wykruszanie, degradacja tarcia, erozja odrzutowa, uszkodzenia spowodowane wyciekiem paliwa |
| Dostęp inspekcyjny | Drogi publiczne, łatwy nieograniczony dostęp | Ograniczona strefa lotniska, wymaga przepustki lotniskowej, eskorty pojazdu, łączności radiowej |
| Dominująca metoda rejestracji | Pojazdy naziemne, smartfony, ręczna | UAV na wysokości 30–100m, specjalistyczne pojazdy inspekcyjne |
| Zanieczyszczenia powierzchni | Woda, śnieg, gruz, olej | Woda, guma (krytyczne, strefy przyziemienia), płyny odladzające, paliwo lotnicze, płyn hydrauliczny |
| Krytyczny dla bezpieczeństwa parametr tarcia | Opór poślizgu dla hamowania | Współczynnik hamowania dla lądujących samolotów (kategorie ICAO GRF) |
| Ramy regulacyjne | FHWA, normy stanowych DOT | ICAO Annex 14, Doc 9137, FAA AC |
Interferencja osadów gumy jest najbardziej wymagającym problemem adaptacyjnym. Opony samolotów osadzają gumę na pasach startowych podczas lądowania, szczególnie w strefie przyziemienia, gromadząc się jako ciemne, ciągłe plamy na powierzchni nawierzchni. Te osady gumy mogą wizualnie imitować lub zasłaniać pęknięcia. Model wykrywania pęknięć wytrenowany na drogach, który nigdy nie spotkał się z osadami gumy z opon, może albo nie wykryć pęknięć pod plamami gumy, albo fałszywie klasyfikować krawędzie plam gumy jako pęknięcia. Adaptacja z drogi na pas startowy musi zatem uwzględniać modelowanie osadów gumy, albo poprzez syntetyczną augmentację danych treningowych, albo poprzez metody adaptacji domenowej, które uczą się odróżniać gumę od pęknięć.
Różnice w skali i rozdzielczości stanowią kolejną znaczącą barierę adaptacyjną. Obrazy inspekcji drogowej są zazwyczaj rejestrowane z poziomu gruntu w odległościach 1–5 metrów, dając bardzo wysoką rozdzielczość, gdzie poszczególne krawędzie pęknięć zajmują dziesiątki pikseli. Inspekcja pasa startowego z użyciem UAV na wysokości 30–100m daje obrazy o grubszej rozdzielczości, pęknięcie, które zajmuje 50 pikseli na obrazie drogowym, może zajmować tylko 5–10 pikseli na obrazie pasa startowego uchwyconym z wysokości. Pola recepcyjne ekstraktora cech i filtry zależne od skali muszą dostosować się do tej różnicy w zawartości częstotliwości przestrzennej. Wieloskalowe piramidy cech i trenowanie niezmiennicze względem skali są niezbędnymi komponentami adaptacji.
Niedopasowanie definicji uszkodzeń wymaga starannego mapowania między taksonomiami uszkodzeń dróg i pasów startowych. Podręcznik Identyfikacji Uszkodzeń FHWA LTPP definiuje uszkodzenia nawierzchni drogowych w kategoriach, które częściowo pokrywają się z uszkodzeniami nawierzchni lotniskowych zdefiniowanymi przez ASTM D5340 i ICAO Doc 9137 Part 9. Niektóre typy uszkodzeń są unikalne dla lotnisk: osady gumy, erozja odrzutowa, uszkodzenia spowodowane wyciekiem paliwa i degradacja tarcia nie mają odpowiedników drogowych. Modele wytrenowane na drogach potrzebują zatem nowych klas wyjściowych dodanych podczas adaptacji lub hierarchicznego podejścia do klasyfikacji, które najpierw wykrywa ogólne uszkodzenia, a następnie klasyfikuje je do kategorii specyficznych dla domeny.
Zgodność regulacyjna nakłada dodatkową warstwę wymagań adaptacyjnych. Modele inspekcji drogowej generują wyniki, które informują o priorytetyzacji utrzymania przez agencje DOT. Modele inspekcji pasa startowego muszą generować wyniki, które mapują się do wymaganych przez ICAO i FAA formatów raportowania: kategorii stanu Globalnego Formatu Raportowania (GRF), wskaźnika Stanu Nawierzchni (PCI) zgodnie z ASTM D5340 oraz ocen Numeru Klasyfikacji Nawierzchni (PCN). Proces adaptacji musi zatem również dostosować reprezentację wyjściową modelu do standardów raportowania regulacyjnego.
Progresywne łączenie domen, trenowanie na pośrednich zbiorach danych, które stopniowo pokonują lukę od drogi do pasa startowego, okazało się skuteczne. Typowy potok łączenia wykorzystuje trzy etapy: po pierwsze, trenowanie na zbiorach drogowych (CQU-BPDD, RDD2020, Crack500), po drugie, adaptacja do ogólnych zbiorów nawierzchni, które obejmują zarówno powierzchnie asfaltowe, jak i betonowe, po trzecie, adaptacja do zbiorów specyficznych dla pasa startowego z osadami gumy i oznakowaniem lotniskowym. Każdy etap zmniejsza lukę rozkładu, którą następny etap musi pokonać, umożliwiając bardziej stabilną i skuteczną adaptację niż bezpośredni transfer z drogi na pas startowy.
Adaptacja Między Warunkami Klimatycznymi
Warunki klimatyczne wprowadzają zmienność domeny, która jest czasowa (zmieniająca się w czasie w jednej lokalizacji) i geograficzna (zmieniająca się jednocześnie w różnych lokalizacjach). Model wdrożony na wielu lotniskach musi obsługiwać oba wymiary.
Adaptacja powierzchni mokrej vs suchej jest krytyczna, ponieważ kategorie stanu nawierzchni pasa startowego zgodnie z Globalnym Formatem Raportowania ICAO wyraźnie rozróżniają powierzchnie suche, mokre, śliskie mokre i zanieczyszczone. Mokre powierzchnie zmieniają widoczność pęknięć na kilka sposobów. Woda wypełniająca pęknięcia zmniejsza kontrast między pęknięciem a otaczającą nawierzchnią, suche pęknięcia pojawiają się jako wysokokontrastowe ciemne lub jasne cechy liniowe, ale pęknięcia wypełnione wodą pojawiają się jako cechy o niskim kontraście, które mogą być prawie niewidoczne dla modelu wytrenowanego na suchych powierzchniach. Warstwa wody na powierzchni nawierzchni tworzy odbicia zwierciadlane, które wprowadzają jasne regiony i fałszywe krawędzie, myląc detektory pęknięć. Mokra nawierzchnia wydaje się również ogólnie ciemniejsza, przesuwając histogram obrazu i zmieniając statystyki każdej warstwy w sieci.
Adaptacja do zimnego klimatu dotyczy efektów zamarzania i odmarzania, które zmieniają wygląd nawierzchni. Zamrożone powierzchnie mają inne właściwości odbiciowe niż niezamrożone. Plamy lodu na nawierzchni pojawiają się jako gładkie regiony o wysokim współczynniku odbicia, które mają cechy wizualne wspólne z uszkodzeniami powierzchni nawierzchni. Pokrywa śnieżna częściowo lub całkowicie zasłania uszkodzenia powierzchni. Przejście między cyklami zamarzania i odmarzania wytwarza unikalne wzorce uszkodzeń, pęknięcia D, łuszczenie mrozowe i wyboczenia mrozowe, których modele wytrenowane na danych z ciepłego klimatu mogą nie rozpoznawać.
Augmentacja danych dla adaptacji klimatycznej syntetycznie generuje docelowe warianty domeny z obrazów źródłowych. Dodawanie symulowanych smug deszczu, modeli odbicia mokrej powierzchni, masek pokrywy śnieżnej i nakładek cieni może rozszerzyć pokrycie domeny źródłowej o warunki klimatyczne nieobecne w oryginalnych danych treningowych. Zasady RandAugment z określonymi przekształceniami fotometrycznymi ukierunkowanymi na zmiany jasności, kontrastu i temperatury barwowej są szczególnie skuteczne w adaptacji klimatycznej. Badania pokazują, że podejścia oparte wyłącznie na augmentacji odzyskują 50–70% wydajności utraconej z powodu przesunięć domenowych związanych z oświetleniem i pogodą, co czyni je opłacalnym uzupełnieniem bardziej złożonych metod adwersarialnych lub opartych na rozbieżności.
Tłumaczenie domen oparte na CycleGAN zapewnia alternatywę poprzez uczenie się tłumaczenia obrazów między warunkami klimatycznymi. CycleGAN wytrenowany na sparowanych lub niesparowanych obrazach z suchych i mokrych pasów startowych uczy się mapować z domeny suchej do mokrej, zachowując lokalizacje i geometrie pęknięć. Modele wykrywania pęknięć wytrenowane na tych augmentowanych danych uczą się cech niezmienniczych względem obecności lub braku wody na powierzchni. Wadą jest złożoność trenowania GAN i ryzyko halucynacji lub usunięcia cech pęknięć podczas tłumaczenia.
Adaptacja Między Typami Kamer
Systemy inspekcji infrastruktury wykorzystują różne platformy obrazowania, każda z innymi cechami optycznymi, które wprowadzają przesunięcie domenowe. Adaptacja między typami kamer jest niezbędna dla każdego systemu wdrażanego na wielu lotniskach, gdzie istniejące obrazy mogą pochodzić z różnych źródeł.
Rozdzielczość i Odległość Próbkowania Gruntu (GSD) znacznie się różnią. Inspekcja z poziomu gruntu za pomocą 50 MP lustrzanki cyfrowej daje GSD rzędu 0,1–0,5 mm/piksel. Inspekcja UAV na wysokości 30 m daje 0,5–1 cm/piksel. Inspekcja UAV na wysokości 100 m daje 2–5 cm/piksel. Obrazy satelitarne mogą mieć rozdzielczość 30–50 cm/piksel. Pęknięcie o szerokości 3 mm zajmuje 6–30 pikseli na poziomie gruntu, 0,3–0,6 piksela na wysokości UAV 30 m i jest subpikselowe na wysokości 100 m. Modele wytrenowane na obrazach naziemnych o wysokiej rozdzielczości nie mogą bezpośrednio wykrywać cech przy grubszej rozdzielczości. Trenowanie wielorozdzielcze, trenowanie na obrazach w wielu skalach rozdzielczości, jest podstawową strategią. Ekstraktor cech uczy się reprezentacji niezmienniczych względem skali poprzez piramidy poolingowe, dylatowane sploty lub normalizację adaptacyjną do rozdzielczości.
Różnice w czułości widmowej czujnika między kamerami wpływają na reprezentację kolorów. Różne czujniki CMOS i CCD mają różne krzywe wydajności kwantowej w widmie widzialnym, co oznacza, że ta sama powierzchnia pojawia się z nieco innymi wartościami RGB z różnych kamer. Kalibracja kolorów przy użyciu tablicy wzorców kolorów podczas zbierania danych zmniejsza to przesunięcie, ale rzadko jest praktyczna w przypadku programów inspekcyjnych na dużą skalę. Dopasowywanie histogramu i transfer kolorów między obrazami źródłowymi i docelowymi są alternatywami przetwarzania wstępnego. Bardziej zaawansowane podejścia obejmują uczenie się cech niezmienniczych względem czujnika, które jawnie usuwa specyficzne dla czujnika informacje o kolorze z reprezentacji cech poprzez augmentację rozmycia kolorów podczas trenowania.
Dystorsja obiektywu różni się w zależności od kombinacji kamery i obiektywu. Obiektywy szerokokątne używane do wydajnego pokrycia pasa startowego wprowadzają dystorsję beczkowatą, która zmienia geometrię pęknięć, proste pęknięcia mogą wydawać się zakrzywione w pobliżu krawędzi obrazu. W przypadku zadań detekcji, ta dystorsja wpływa na przestrzenną relację między cechami obrazu. Korekcja dystorsji jako krok przetwarzania wstępnego normalizuje wszystkie obrazy do wspólnej wyprostowanej geometrii przed podaniem ich do modelu. Alternatywnie, trenowanie na obrazach z syntetyczną augmentacją dystorsji czyni model odpornym na różne poziomy dystorsji.
Efekty migawki rolowanej z platform UAV wprowadzają geometryczne zniekształcenia podczas lotu, szczególnie przy dużej prędkości lub w wietrznych warunkach. Sekwencyjna ekspozycja wierszy w czujniku CMOS z migawką rolowaną oznacza, że ruch kamery podczas ekspozycji powoduje przekrzywioną lub zniekształconą geometrię pęknięcia. To czasowe zniekształcenie jest nieobecne w kamerach z migawką globalną i w statycznym przechwytywaniu z poziomu gruntu. Adaptacja wymaga albo przetwarzania wstępnego w celu skorygowania artefaktów migawki rolowanej, albo trenowania na danych, które obejmują syntetyczną degradację migawki rolowanej.
| Zmienność Kamery | Strategia Adaptacji | Złożoność Implementacji | Typowe Odzyskanie |
|---|---|---|---|
| Rozdzielczość / GSD | Trenowanie wielorozdzielcze + piramida poolingowa | Umiarkowana | 5–10% odzyskanie dokładności |
| Odpowiedź kolorowa czujnika | Augmentacja rozmycia kolorów + dopasowywanie histogramu | Niska | 3–7% odzyskanie dokładności |
| Dystorsja obiektywu | Przetwarzanie wstępne korekcji dystorsji | Niska | 2–5% odzyskanie dokładności |
| Migawka rolowana | Syntetyczna augmentacja migawki rolowanej | Umiarkowana | 3–6% odzyskanie dokładności |
| Artefakty kompresji | Augmentacja kompresji JPEG | Niska | 1–3% odzyskanie dokładności |
Podstawy Matematyczne i Kluczowe Sformułowania
Zrozumienie adaptacji domenowej wymaga znajomości kilku podstawowych sformułowań matematycznych. Ramy Minimalizacji Ryzyka Empirycznego (ERM) stanowią punkt wyjścia. Mając domenę źródłową z oznakowanymi próbkami ({(x_i^S, y_i^S)}_{i=1}^{n_S}), standardowy model minimalizuje ryzyko empiryczne:
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
gdzie (\ell) jest funkcją straty specyficzną dla zadania (entropia krzyżowa dla klasyfikacji, strata Dice dla segmentacji). Adaptacja domenowa ma na celu minimalizację ryzyka docelowego:
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
Wyzwanie polega na tym, że (R_T) nie może być bezpośrednio minimalizowane, gdy etykiety docelowe są niedostępne. Metody adaptacji domenowej ograniczają ryzyko docelowe przez sumę ryzyka źródłowego i miary rozbieżności między rozkładami źródłowymi i docelowymi.
H-rozbieżność zapewnia teoretyczne ograniczenie dla adaptacji domenowej (Ben-David i in., 2010). Dla klasy hipotez (\mathcal{H}), H-rozbieżność między rozkładami źródłowymi i docelowymi wynosi:
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
W praktyce H-rozbieżność jest szacowana poprzez trenowanie klasyfikatora do rozróżniania próbek domeny źródłowej i docelowej, dokładnie to, co robi klasyfikator domeny w DANN. Wynik teoretyczny gwarantuje, że model wytrenowany na danych źródłowych będzie generalizował do domeny docelowej, jeśli H-rozbieżność między domenami jest mała. Zapewnia to formalne uzasadnienie dla adwersarialnej adaptacji domenowej.
MMD w formie funkcyjnej wykorzystuje charakterystyczne jądro (k) do zanurzania rozkładów prawdopodobieństwa w RKHS:
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
Przy jądrze Gaussa (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)), kwadrat MMD można obliczyć bezpośrednio ze średnich próbek:
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
Strata CORAL wyrównuje statystyki drugiego rzędu:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
gdzie (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) a (C_T) jest zdefiniowane analogicznie dla cech docelowych. Norma Frobeniusa (|\cdot|_F) to suma kwadratów elementów.
Te podstawy matematyczne przekładają się bezpośrednio na praktyczną implementację. Strata adaptacji domenowej dla sieci Deep CORAL wynosi:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Dla sieci DANN:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{domain}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
gdzie (\mathbf{D} = {0, 1}) wskazuje domenę źródłową (0) lub docelową (1), a znak minus odzwierciedla odwrócenie gradientu.
| Metoda | Funkcja Celu | Kluczowe Hiperparametry |
|---|---|---|
| ERM (bez adaptacji) | (\mathcal{L} = \mathcal{L}_{task}(D_S, Y_S)) | Szybkość uczenia, spadek wagi |
| DANN | (\mathcal{L} = \mathcal{L}{task} - \lambda \mathcal{L}{domain}) | (\lambda) (siła adaptacji), harmonogram GRL |
| DAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) na warstwę, szerokość pasma jądra (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{task} + \lambda |C_S - C_T|_F^2) | (\lambda) (waga wyrównania) |
| JAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l JMMD_l) | Pary warstw, szerokości pasma jądra |
| Dostrajanie | (\mathcal{L} = \mathcal{L}_{task}(D_T, Y_T)) zmniejszone LR | Harmonogram zamrażania, współczynnik redukcji LR |
Protokoły Ewaluacji dla Adaptacji Domenowej
Ewaluacja metod adaptacji domenowej wymaga wystandaryzowanych benchmarków międzydatasetowych, które mierzą wydajność na docelowych domenach nie widzianych podczas trenowania. Dla inspekcji infrastruktury ustanowiono kilka protokołów benchmarkowych.
Ewaluacja międzydatasetowa to standardowy protokół. Model jest trenowany na źródłowym zbiorze danych (np. CQU-BPDD, który zawiera obrazy pęknięć nawierzchni bitumicznej) i ewaluowany na docelowym zbiorze danych (np. RDD2020, który zawiera obrazy pęknięć dróg z wielu krajów). Wydajność na docelowym zbiorze danych przed adaptacją służy jako linia bazowa tylko źródłowa. Wydajność po adaptacji (z dostępem do nieoznakowanych danych docelowych dla UDA lub ograniczonych oznakowanych danych docelowych dla SDA) jest mierzona w stosunku do tej linii bazowej. Zysk adaptacji, różnica między wydajnością zaadaptowaną a niezaadaptowaną, określa ilościowo skuteczność metody adaptacji.
Typowe benchmarki dla wykrywania pęknięć nawierzchni obejmują: CQU-BPDD (Zbiór Danych Pęknięć Nawierzchni Bitumicznej) zawierający 60 088 obrazów pęknięć nawierzchni asfaltowej z Chin, RDD2020 zawierający 26 336 obrazów pęknięć dróg z Indii, Japonii i Czech, Crack500 zawierający 500 obrazów pęknięć nawierzchni w wysokiej rozdzielczości z powierzchni dróg, DeepCrack zawierający 537 obrazów pęknięć ścian budynków oraz SDNET2018 zawierający 56 000 obrazów betonowych pomostów mostów, ścian i nawierzchni. Ewaluacja międzydatasetowa na tych zbiorach, szczególnie z CQU-BPDD do RDD2020, reprezentująca transfer międzykrajowy i międzyklimatyczny, jest najbardziej rygorystycznym benchmarkiem.
Metryki dla oceny adaptacji domenowej obejmują docelowe mIoU (średni Intersection over Union dla zadań segmentacji), docelowy wskaźnik F1 (dla zadań detekcji), retencję źródłową (wydajność domeny źródłowej po adaptacji, do pomiaru katastroficznego zapominania), zysk adaptacji (poprawa w punktach procentowych w stosunku do linii bazowej tylko źródłowej) oraz wydajność etykietowania (ile oznakowanych danych docelowych jest potrzebnych do osiągnięcia danego poziomu wydajności dla metod nadzorowanych).
Testowanie istotności statystycznej jest niezbędne, ponieważ wyniki adaptacji domenowej mogą być zaszumione. Wiele uruchomień z różnymi ziarnami losowymi (zazwyczaj 5–10) jest używanych do obliczenia średniej i odchylenia standardowego metryk wydajności. Test Wilcoxona podpisanych rang lub sparowany test t jest używany do określenia, czy różnice w wydajności między metodami adaptacji są statystycznie istotne przy konwencjonalnych progach ((p < 0,05)).
Dla inspekcji infrastruktury istotne są dodatkowe metryki specyficzne dla wdrożenia: wskaźnik fałszywie pozytywnych na operacyjnych progach dotkliwości (detektor pęknięć, który generuje 100 fałszywych alarmów na inspekcję pasa startowego, jest operacyjnie bezużyteczny niezależnie od jego mIoU), czas wnioskowania na jednostkę powierzchni (adaptacja nie powinna znacząco zwiększać czasu przetwarzania) oraz ślad pamięciowy (metody oparte na adapterach powinny dodawać minimalny narzut pamięciowy na dodatkowe lotnisko).
Kluczowe Normy i Odniesienia
Praktyka adaptacji domenowej dla inspekcji infrastruktury opiera się na normach i badaniach z wielu dyscyplin.
Podstawy uczenia maszynowego: Ganin i in., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), kanoniczna praca DANN wprowadzająca odwrócenie gradientu. Long i in., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), wprowadzająca wielowarstwowe wyrównanie domen oparte na MMD. Sun i Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), wprowadzająca wyrównanie oparte na kowariancji. Ben-David i in., “A theory of learning from different domains” (Machine Learning, 2010), ramy teoretyczne dla granic generalizacji adaptacji domenowej.
Adaptacja domenowa w inspekcji infrastruktury: Liu i in., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), główne odniesienie dla adaptacji domenowej w wykrywaniu pęknięć z architekturą dwugałęziową z współdzielonymi wagami. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), wielopoziomowe wyrównywanie cech dla międzydatasetowego wykrywania pęknięć. Wang, Nguyen, Eick i in., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), trzy modułowe ramy rozbieżności dla korozji infrastrukturalnej.
Normy ICAO i FAA: ICAO Annex 14, Lotniska, Tom I (8. wydanie, 2018 z poprawkami), podstawowa międzynarodowa norma certyfikacji lotnisk, tworząca kontekst przesunięcia domenowego między lotniskami. ICAO Doc 9137, Część 9, Podręcznik Służb Lotniskowych, Praktyki Utrzymania Lotnisk, wytyczne dotyczące utrzymania nawierzchni. ICAO Globalny Format Raportowania (GRF) dla Stanu Nawierzchni Pasa Startowego (obowiązujący od listopada 2021), definiujący domeny stanu nawierzchni (sucha, mokra, zanieczyszczona). FAA AC 150/5380-6C, Wytyczne i Procedury Utrzymania Nawierzchni Lotnisk. ASTM D5340, Standardowa Metoda Badania dla Badań Wskaźnika Stanu Nawierzchni Lotnisk, ilościowe ramy oceny stanu nawierzchni, które modele zaadaptowane domenowo muszą wspierać.
Zbiory danych nawierzchni: CQU-BPDD (Uniwersytet Chongqing, 60 088 obrazów pęknięć nawierzchni asfaltowej). RDD2020 (ponad 8 300 obrazów dróg z Indii, Japonii, Czech). Crack500 (500 obrazów pęknięć nawierzchni w wysokiej rozdzielczości). SDNET2018 (56 000 obrazów pomostów mostów, ścian i nawierzchni z Uniwersytetu Stanowego Utah). Te zbiory danych zapewniają wystandaryzowane benchmarki do ewaluacji adaptacji domenowej w inspekcji nawierzchni.
Często zadawane pytania
- Czym jest adaptacja domenowa w uczeniu maszynowym?
- Adaptacja domenowa to poddziedzina uczenia transferowego, która zajmuje się problemem przesunięcia domenowego, gdzie model wytrenowany na źródłowym zbiorze danych działa słabo po wdrożeniu na docelowym zbiorze danych o innych właściwościach statystycznych. Celem jest nauczenie się reprezentacji cech niezmienniczych względem domeny, aby model generalizował między domenami bez konieczności pełnego przekwalifikowania na oznakowanych danych docelowych. Adaptacja domenowa dzieli się na nadzorowaną (dostępna ograniczona liczba oznakowanych danych docelowych), nienadzorowaną (brak oznakowanych danych docelowych) oraz częściowo nadzorowaną (część oznakowanych plus nieoznakowane dane docelowe).
- Jak przesunięcie domenowe wpływa na modele wykrywania pęknięć nawierzchni?
- Przesunięcie domenowe w wykrywaniu pęknięć nawierzchni powoduje spadek wydajności o 30–45% w średnim wskaźniku Intersection over Union (mIoU) przy przejściu z jednego zbioru danych do drugiego. Źródła przesunięcia obejmują różnice w materiale nawierzchni (asfalt vs beton), zmienność morfologii pęknięć (podłużne vs siatkowe), zmiany warunków obrazowania (kąt oświetlenia, rozdzielczość, czujnik kamery) oraz czynniki geograficzne (różne typy kruszywa i wzorce starzenia). Na przykład model wytrenowany na zbiorze CQU-BPDD osiąga 0,72 mIoU na źródłowych danych testowych, ale spada do 0,31 po przetestowaniu na docelowych danych RDD2020 bez adaptacji.
- Jaka jest różnica między uczeniem transferowym a adaptacją domenową?
- Uczenie transferowe dostosowuje model wstępnie wytrenowany do jednego zadania, aby wykonać inne zadanie, na przykład dostrajanie modelu klasyfikacji ImageNet do wykrywania pęknięć. Adaptacja domenowa dotyczy tego samego zadania, ale przy różnych rozkładach danych, na przykład dostosowanie detektora pęknięć asfaltu do wykrywania pęknięć na powierzchniach betonowych. W uczeniu transferowym zadania źródłowe i docelowe mogą się różnić, w adaptacji domenowej zadanie jest identyczne, ale różnią się rozkłady wejściowe.
- Czym są cechy niezmiennicze względem domeny?
- Cechy niezmiennicze względem domeny to reprezentacje wyodrębnione przez sieć neuronową, które mają ten sam rozkład statystyczny niezależnie od tego, z której domeny pochodzi wejście. Jeśli sieć do wykrywania pęknięć uczy się cech, które wyglądają tak samo, niezależnie od tego, czy wejście jest obrazem drogi asfaltowej, czy betonowego pasa startowego, to te cechy są niezmiennicze względem domeny. Uczy się ich poprzez trenowanie adwersarialne (dyskryminator domeny nie może stwierdzić, z której domeny pochodzą cechy), dopasowywanie momentów statystycznych (MMD, CORAL) lub techniki optymalnego transportu. Podstawowym wyzwaniem jest kompromis między niezmienniczością a dyskryminowalnością: wymuszanie zbyt dużej niezmienniczości cech może usunąć istotne dla zadania informacje, takie jak tekstura pęknięcia, która koreluje z typem nawierzchni.
- Jak działa nienadzorowana adaptacja domenowa?
- Nienadzorowana adaptacja domenowa (UDA) wykorzystuje oznakowane dane źródłowe i nieoznakowane dane docelowe do wytrenowania modelu, który generalizuje do domeny docelowej. Trzy główne podejścia to: (1) metody adwersarialne, takie jak DANN, gdzie dyskryminator domeny próbuje zidentyfikować, z której domeny pochodzą cechy, podczas gdy ekstraktor cech próbuje go oszukać, (2) metody oparte na rozbieżności, takie jak DeepCORAL i DAN, które minimalizują miary odległości statystycznej (MMD, różnica kowariancji) między rozkładami cech źródłowych i docelowych, oraz (3) metody oparte na rekonstrukcji, które wykorzystują autoenkodery lub GAN do uczenia się wspólnych reprezentacji.
- Jakie wyzwania istnieją przy adaptacji z inspekcji drogowej na lotniskową?
- Adaptacja z drogi na pas startowy napotyka fundamentalne różnice w materiale nawierzchni (asfalt vs wysokowytrzymały beton PCC), charakterystyce obciążenia (10-tonowe osie pojazdów vs 50–400 tonowe obciążenia samolotów), typach uszkodzeń (osady gumy, erozja odrzutowa, uszkodzenia spowodowane wyciekiem paliwa na pasach startowych), dostępie inspekcyjnym (drogi publiczne vs ograniczona strefa lotniska), metodach rejestracji obrazu (pojazdy naziemne vs UAV na wysokości 30–100m) oraz zgodności regulacyjnej (normy ICAO Annex 14). Szczególnie trudna jest interferencja osadów gumy, guma z kół samolotów gromadzi się jako ciemne plamy na pasach startowych, które mogą imitować lub zasłaniać pęknięcia, stan, z którym modele drogowe nigdy się nie spotykają.
- Czym jest Adwersarialna Sieć Neuronowa z Odwróceniem Gradientu (DANN)?
- Adwersarialna Sieć Neuronowa z Odwróceniem Gradientu (DANN), wprowadzona przez Ganina i Lempitsky'ego w 2015 roku, jest kanoniczną architekturą dla adwersarialnej adaptacji domenowej. Składa się z trzech komponentów: ekstraktora cech, który mapuje wejścia do wspólnej przestrzeni cech, predyktora etykiet, który wykonuje zadanie (np. klasyfikacja pęknięć), oraz klasyfikatora domeny, który przewiduje, z której domeny pochodzi wejście. Warstwa Odwrócenia Gradientu (GRL) znajduje się między ekstraktorem cech a klasyfikatorem domeny, podczas wstecznej propagacji odwraca znak gradientu, powodując, że ekstraktor cech uczy się cech maksymalizujących pomieszanie domen. Całkowita strata łączy stratę zadania na źródłowych etykietach minus stratę klasyfikacji domeny, ważoną hiperparametrem lambda.
- Które strategie adaptacji domenowej pasują do różnych ilości danych docelowych?
- Strategia zależy od dostępnych danych docelowych. Pełne dostrajanie pasuje do umiarkowanych ilości oznakowanych danych docelowych, dostrajanie ostatniej warstwy lub adapterów pasuje do bardzo ograniczonych oznakowanych danych, a adaptacja nienadzorowana z wykorzystaniem statystyk normalizacji wsadowej i wyrównywania cech jest stosowana, gdy nie ma docelowych etykiet. Stopniowe odblokowywanie warstw i augmentacja dostosowana do docelowych warunków obrazowania pomagają zaadaptowanemu modelowi zachować to, czego nauczył się z domeny źródłowej.
- Czym jest Maksymalna Średnia Rozbieżność (MMD)?
- Maksymalna Średnia Rozbieżność (MMD) to jądrowy test statystyczny używany do pomiaru odległości między dwoma rozkładami prawdopodobieństwa w Reprodukującej się Przestrzeni Hilberta z Jądrem (RKHS). W adaptacji domenowej MMD jest używana jako funkcja straty do minimalizacji luki rozkładu między źródłowymi i docelowymi reprezentacjami cech. Wzór MMD oblicza normę różnicy między średnimi zanurzeniami cech źródłowych i docelowych w RKHS. Sieci Głębokiej Adaptacji (DAN) i Sieci Wspólnej Adaptacji (JAN) wykorzystują stratę MMD na wielu warstwach sieci, aby osiągnąć wielopoziomowe wyrównanie domen.
- Jakie normy ICAO odnoszą się do adaptacji domenowej dla inspekcji pasów startowych?
- Załącznik 14 ICAO ustanawia normy dla projektowania i eksploatacji lotnisk, które tworzą naturalne zapotrzebowanie na adaptację domenową, różne lotniska mają różne materiały nawierzchni, klimaty i historie utrzymania, więc modele inspekcyjne muszą dostosowywać się między lotniskami. Globalny Format Raportowania (GRF) definiuje kategorie stanu nawierzchni pasa startowego (sucha, mokra, śliska mokra, zanieczyszczona), które reprezentują odrębne domeny wizualne. ICAO Doc 9137 Część 9 i FAA AC 150/5380-6C zawierają wytyczne dotyczące utrzymania. Podczas wdrażania inspekcji opartej na AI na różnych lotniskach, adaptacja domenowa jest niezbędna, ponieważ model wytrenowany na danych z jednego lotniska napotka inne oświetlenie, wiek nawierzchni i morfologie uszkodzeń na innym.
To wpis referencyjny. TarmacView świadczy usługi inspekcji dronami i nie sprzedaje sprzętu ani materiałów opisanych w tym słowniczku.