Qu'est-ce que l'Adaptation de Domaine pour les Modèles d'Inspection Inter-Surfaces ?
Guide Technique Complet sur l’Adaptation de Domaine pour les Modèles d’Inspection Inter-Surfaces
Définition et le Problème du Décalage de Domaine
L’adaptation de domaine est une sous-catégorie de l’apprentissage par transfert qui aborde un défi fondamental du déploiement de modèles d’apprentissage automatique : le décalage statistique entre les données d’entraînement et les données de déploiement. Lorsqu’un modèle entraîné sur un domaine source, un jeu de données aux caractéristiques connues et généralement riche en exemples étiquetés, est déployé sur un domaine cible aux propriétés statistiques différentes, les performances se dégradent. L’adaptation de domaine fournit des méthodes pour combler cet écart, permettant aux modèles de généraliser à travers les domaines sans collecter et étiqueter de grands nouveaux jeux de données pour chaque environnement de déploiement.
Formellement, un domaine est défini comme une paire constituée d’un espace de caractéristiques (X) et d’une distribution de probabilité (P(X)) sur cet espace : (D = {X, P(X)}). Une tâche est une paire constituée d’un espace d’étiquettes (Y) et d’une fonction prédictive (f: X \to Y). Le domaine source (D_S) est le domaine sur lequel le modèle est initialement entraîné avec une abondance de données étiquetées. Le domaine cible (D_T) est le nouveau domaine où le modèle doit fonctionner, souvent avec peu ou pas d’étiquettes. L’objectif de l’adaptation de domaine est d’apprendre une fonction (f_T: X_T \to Y_T) pour le domaine cible en exploitant les connaissances du domaine source, malgré le décalage (P_S(X) \neq P_T(X)).
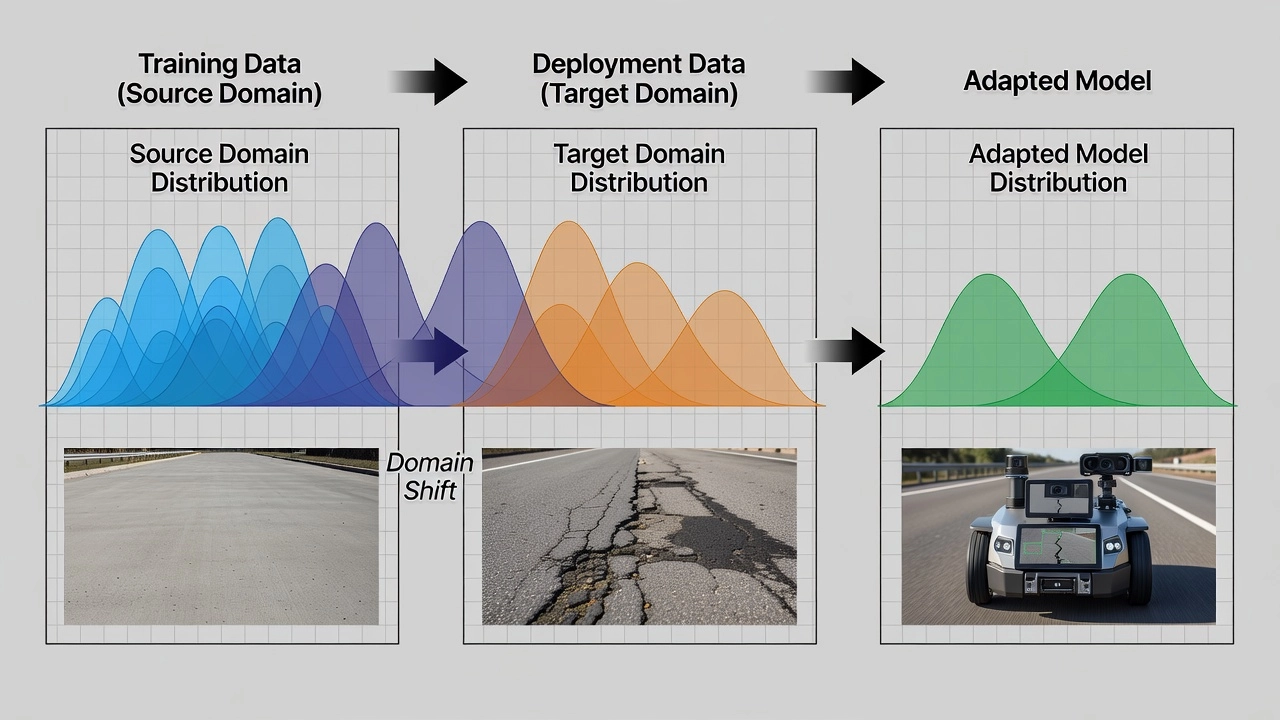
Le décalage de domaine (également appelé décalage de distribution ou décalage de jeu de données) est le phénomène par lequel la distribution des données diffère entre les environnements d’entraînement et de déploiement. Lorsque le décalage de domaine se produit, les performances du modèle se dégradent car la correspondance apprise entre les entrées et les sorties ne correspond plus aux conditions cibles. Le décalage de domaine se manifeste sous trois formes principales. Le décalage de covariable se produit lorsque la distribution des caractéristiques d’entrée change tandis que la distribution conditionnelle des étiquettes étant donné les entrées reste la même : formellement, (P_S(X) \neq P_T(X)) mais (P_S(Y|X) = P_T(Y|X)). C’est la forme la plus courante en vision par ordinateur : l’apparence visuelle d’une fissure sur l’asphalte diffère de celle sur le béton, mais la correspondance entre les caractéristiques visuelles et l’étiquette « fissuré » reste cohérente. Le décalage d’étiquette (ou décalage a priori) se produit lorsque la distribution des étiquettes de classe change : (P_S(Y) \neq P_T(Y)) mais (P_S(X|Y) = P_T(X|Y)). Cela se produit lorsque la densité de fissures diffère entre les sites d’entraînement et de déploiement. Le décalage conceptuel se produit lorsque la relation entre les entrées et les sorties change : (P_S(Y|X) \neq P_T(Y|X)), par exemple, lorsqu’un motif visuel qui indique une fissure scellée sur les routes indique un défaut structurel sur les pistes.
Pour la vision par ordinateur dans l’inspection des infrastructures, le décalage de domaine provient de multiples facteurs qui se combinent. Les différences d’apparence visuelle incluent la texture de la chaussée (asphalte rugueux vs béton lisse), les profils de couleur (gris foncé de l’asphalte vs gris clair du béton) et les motifs de vieillissement (surface oxydée vs fraîchement pavée). Les conditions de capture telles que l’éclairage (lumière directe du soleil à un angle de 60° vs lumière diffuse nuageuse), la résolution de la caméra et la sensibilité spectrale du capteur, ainsi que l’angle de capture d’image (nadir depuis un UAV vs oblique depuis un véhicule) contribuent tous à des décalages distributionnels significatifs. Les facteurs environnementaux incluant les surfaces mouillées vs sèches, l’occlusion d’ombre par les structures et les débris saisonniers (feuilles, neige, eau stagnante) aggravent encore le problème. Les différences de matériau de surface entre l’asphalte et le béton, ou entre les surfaces vieillies et fraîchement pavées, représentent l’un des décalages de domaine les plus difficiles pour les modèles d’inspection des chaussées.
La recherche a documenté quantitativement la gravité du décalage de domaine dans la détection des fissures de chaussée. Le framework DDACRN a rapporté que sans adaptation de domaine, l’Intersection sur Union moyenne (mIoU) de la détection de fissures passe de 0,72 sur les données de test source à 0,31 sur les données cibles inter-jeux de données, une réduction de performance de 57 %. DACrack a démontré que l’atténuation du décalage de domaine via un alignement de caractéristiques à plusieurs niveaux récupère environ 20 points de pourcentage du score F1 sur les transferts inter-jeux de données. Ces résultats empiriques soulignent pourquoi l’adaptation de domaine n’est pas simplement un raffinement académique mais une nécessité opérationnelle pour tout système d’inspection déployé sur plusieurs aéroports, routes ou réseaux de ponts.
Décalage de Domaine dans l’Imagerie d’Infrastructure
Les images d’inspection d’infrastructure sont soumises à de multiples sources de décalage de domaine qui interagissent et se combinent. Comprendre chaque source est essentiel pour concevoir des stratégies d’adaptation efficaces.
Le décalage de matériau de surface est le décalage de domaine le plus important dans l’inspection des infrastructures. Les chaussées en asphalte et en béton ont des caractéristiques visuelles fondamentalement différentes. L’asphalte est de couleur gris foncé à noir, a une texture de surface rugueuse et irrégulière, et les fissures apparaissent généralement comme des caractéristiques linéaires claires sur le fond sombre. Le béton est gris clair à blanc, a une surface plus lisse et uniforme, et les fissures apparaissent comme des lignes sombres. Ces différences signifient qu’un réseau de neurones convolutif entraîné sur un type de surface apprend des filtres et des représentations de caractéristiques spécifiques aux statistiques visuelles de cette surface. Lorsqu’il est appliqué à l’autre type de surface, ces filtres produisent des activations de caractéristiques que les couches de classification ne peuvent pas interpréter correctement. Les données de DDACRN montrent que la mIoU inter-surface passe de 0,72 à 0,31 sans adaptation lors du transfert de modèles entraînés sur l’asphalte vers des tests sur le béton.
La variation de morphologie des fissures introduit une autre couche de décalage de domaine. Différents types de détresse de chaussée ont des signatures visuelles distinctes. Les fissures longitudinales sont parallèles à l’axe de la chaussée et apparaissent comme des caractéristiques linéaires longues et continues. Les fissures transversales sont perpendiculaires à l’axe. Les fissures en peau de crocodile (fatigue) forment des réseaux interconnectés de petits polygones ressemblant à de la peau de crocodile. Les fissures capillaires mesurent moins de 1 mm de largeur et peuvent être à peine visibles, tandis que les fissures larges dépassent 5 mm et sont facilement identifiables. Les fissures scellées remplies de matériau d’étanchéité ont une apparence visuelle différente de celle des fissures non scellées. Un modèle entraîné principalement sur des fissures longitudinales peut ne pas détecter les fissures en peau de crocodile dans un domaine cible où ce type de détresse est plus répandu.
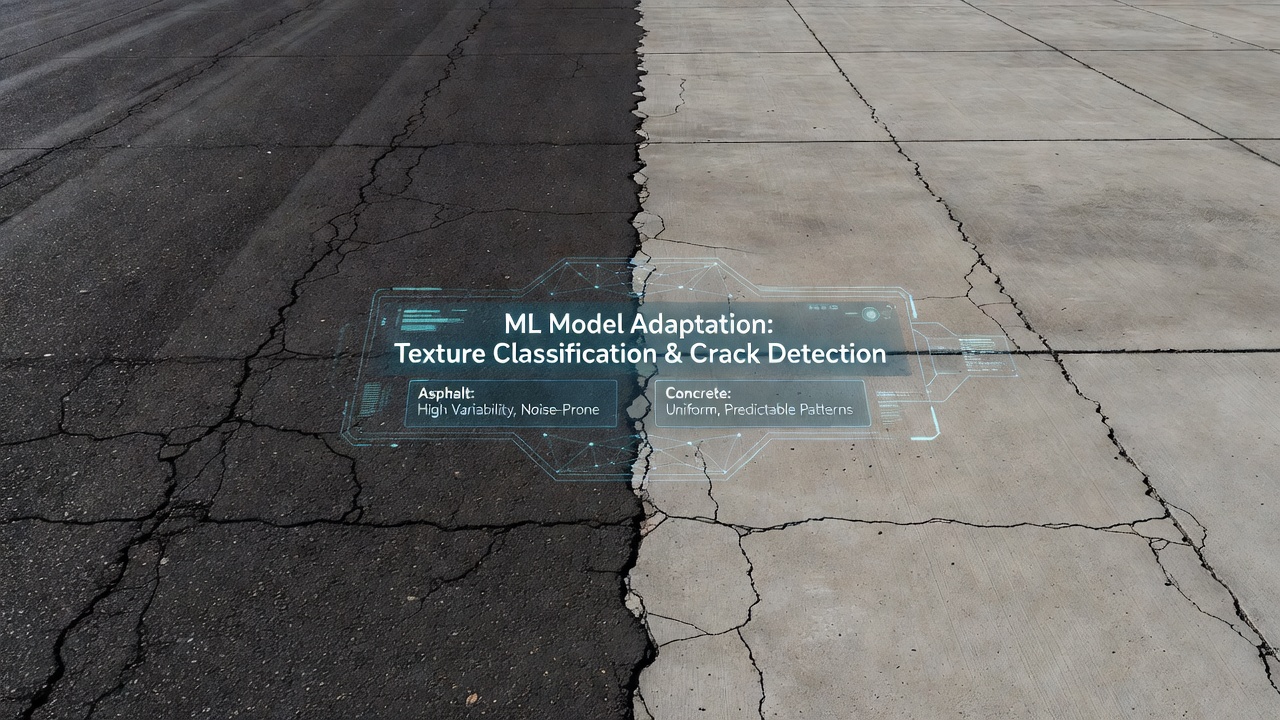
Le décalage de condition d’éclairage affecte significativement les performances du modèle. Les modèles entraînés sur des images de jour bien éclairées sous la lumière directe du soleil échouent sur les images en faible lumière ou au crépuscule, les images avec des ombres prononcées projetées par des structures ou des arbres, et les images capturées sous des conditions nuageuses où l’éclairage diffus réduit le contraste. L’angle de la lumière incidente par rapport à la normale de la surface change l’apparence des bords des fissures : la lumière du soleil à faible angle accentue la texture de la surface en projetant des ombres à l’intérieur des fissures, tandis que la lumière du soleil à angle élevé zénithal minimise la visibilité des fissures. L’occlusion d’ombre provenant des superstructures de ponts, des bâtiments des terminaux aéroportuaires ou des structures proches produit des régions sombres localisées où les caractéristiques des fissures sont supprimées. Des études ont documenté des baisses de précision de 5 à 12 % pour les modèles de détection de fissures lorsque les conditions d’éclairage s’écartent de la distribution d’entraînement.
Le décalage de caméra et de capteur provient des différences dans le matériel d’imagerie. Différentes caméras produisent différentes résolutions d’image (12 MP smartphone vs 50 MP reflex numérique vs caméra industrielle spécialisée), différents profils de couleur et courbes de sensibilité spectrale du capteur, différentes caractéristiques de distorsion d’objectif et différents motifs de bruit. Pour l’inspection par UAV, l’altitude de vol détermine la Distance d’Échantillonnage au Sol (GSD), la distance physique au sol représentée par chaque pixel. Un UAV volant à 30 m produit environ 0,5–1 cm/pixel de GSD, tandis qu’à 100 m, il produit 2–5 cm/pixel. Les différences de GSD signifient que la même fissure est représentée par un nombre différent de pixels et un contenu de fréquence spatiale différent dans les domaines source et cible. L’ajustement avec le recalcul des statistiques de Normalisation par Lots (BN) est souvent suffisant pour les décalages de caméra modérés, tandis que les décalages sévères nécessitent un alignement contradictoire de domaine à plusieurs niveaux de caractéristiques.
Le décalage saisonnier et environnemental introduit une variation de domaine temporelle. Un modèle entraîné sur des images d’été doit fonctionner dans des conditions hivernales où les surfaces peuvent être mouillées, couvertes de neige ou partiellement obstruées par des feuilles mortes. Les surfaces de chaussée subissent un vieillissement et une oxydation au fil du temps, changeant leur couleur et leur texture. La FAA et le Format de Rapport Global (GRF) de l’OACI reconnaissent explicitement la condition environnementale comme une variable qui affecte l’évaluation de la surface de la piste : les surfaces sèches, mouillées, mouillées glissantes et contaminées représentent chacune des domaines visuels distincts nécessitant une interprétation d’inspection différente.
| Source de Décalage de Domaine | Impact Typique sur les Performances | Stratégie d’Atténuation Principale |
|---|---|---|
| Matériau de surface (asphalte vs béton) | Baisse de mIoU de 30–45 % | DA contradictoire + alignement de caractéristiques multi-niveaux |
| Condition d’éclairage (ensoleillé vs nuageux) | Baisse de précision de 5–12 % | Adaptation BN + augmentation photométrique |
| Résolution de la caméra / capteur | Baisse de précision de 3–8 % | Ajustement + recalcul des statistiques BN |
| Saisonnier / environnemental | Baisse de précision de 8–20 % | Traduction de domaine générative (CycleGAN) |
| Géographique / régional | Baisse de précision de 10–25 % | UDA multi-source + pontage progressif de domaine |
Ajustement pour l’Adaptation de Domaine
L’ajustement (fine-tuning) est la stratégie d’adaptation de domaine la plus simple et la plus largement utilisée. Elle consiste à prendre un réseau de neurones pré-entraîné sur le domaine source et à poursuivre le processus d’entraînement sur les données du domaine cible, en mettant à jour les poids du modèle pour aligner ses représentations avec la distribution cible. L’ajustement comble le fossé entre l’apprentissage par transfert (où la tâche change) et l’adaptation de domaine (où la tâche reste la même mais la distribution des données change).
Le fondement théorique de l’ajustement repose sur l’observation que les réseaux de neurones apprennent des représentations de caractéristiques hiérarchiques. Les premières couches capturent des caractéristiques de bas niveau telles que les bords, les textures et les taches de couleur qui sont en grande partie indépendantes du domaine. Les couches intermédiaires combinent celles-ci en motifs de niveau intermédiaire tels que les bords de fissures, le grain de surface et les limites de joints. Les dernières couches apprennent des caractéristiques spécifiques à la tâche, optimisées pour l’objectif de classification ou de segmentation. Lorsque le domaine change, les statistiques de bas niveau (distributions de couleur, fréquences de texture, caractéristiques de contraste) changent, et les dernières couches qui sont finement réglées sur les distributions de caractéristiques du domaine source perdent leur alignement.
L’ajustement complet met à jour tous les paramètres du modèle sur les données cibles. Cela est approprié lorsqu’une abondance de données cibles étiquetées est disponible (des centaines à des milliers d’images) et que les ressources informatiques permettent des mises à jour de gradient complètes. Le taux d’apprentissage est généralement réduit d’un facteur 10 par rapport au pré-entraînement initial pour éviter l’oubli catastrophique, le phénomène où le modèle écrase les connaissances utiles du domaine source. L’arrêt précoce basé sur la perte de validation cible est essentiel pour équilibrer la rétention des connaissances source avec l’adaptation cible.
L’ajustement de la dernière couche (classifieur) gèle toutes les couches d’extraction de caractéristiques et n’entraîne que la tête de classification ou de segmentation finale. Cette approche suppose que l’extracteur de caractéristiques appris sur le domaine source produit des représentations suffisamment générales, et que seul le mappage des caractéristiques aux étiquettes doit être ajusté. L’ajustement de la dernière couche est efficace lorsqu’une quantité très limitée de données cibles est disponible (dizaines d’images) et que le décalage de domaine se situe principalement dans l’espace des étiquettes plutôt que dans l’espace des caractéristiques. Il nécessite un minimum de calcul et résiste à l’oubli catastrophique.
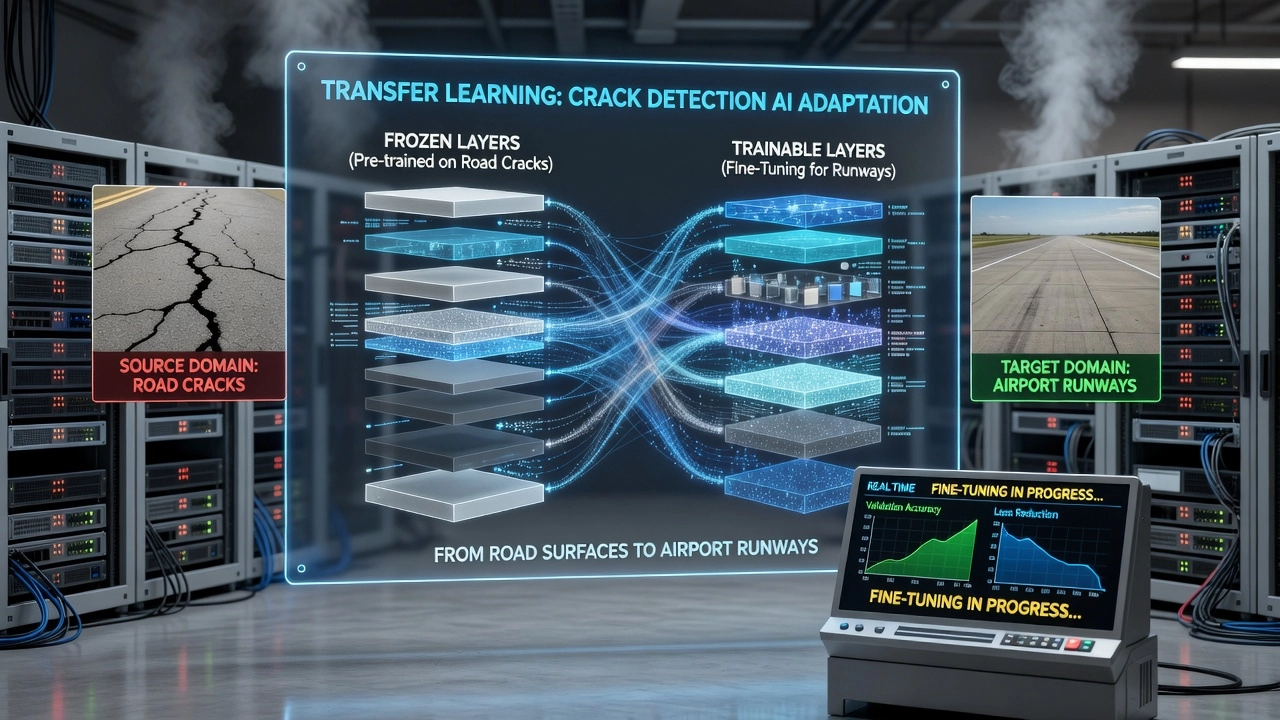
Le dégel progressif offre un compromis. Le processus d’entraînement commence avec toutes les couches gelées à l’exception du classifieur final, qui est entraîné pendant plusieurs époques. Ensuite, les couches d’extraction de caractéristiques les plus hautes sont dégelées et entraînées avec le classifieur. Ce processus se poursuit, dégelant progressivement les couches du haut vers le bas, jusqu’à ce que toutes les couches soient ajustées ou qu’un plateau de performance soit atteint. Le dégel progressif est approprié pour des quantités modérées de données cibles (des centaines d’images) et des décalages de domaine qui affectent plusieurs niveaux de la hiérarchie des caractéristiques.
Les modules adaptateurs introduisent de petites couches de goulot d’étranglement avec significativement moins de paramètres que le réseau complet. Ces adaptateurs sont insérés entre les couches d’un backbone pré-entraîné gelé et sont les seuls paramètres mis à jour lors de l’ajustement. L’ajustement basé sur des adaptateurs est très efficace en termes de paramètres, généralement 1 à 5 % du nombre total de paramètres, et permet un changement rapide entre plusieurs domaines cibles en stockant et en chargeant différents poids d’adaptateur. Pour les réseaux d’inspection d’infrastructure avec des millions de paramètres, les modules adaptateurs permettent le déploiement sur des dizaines d’aéroports sans stocker des copies de poids complets séparées pour chacun.
L’adaptation de la Normalisation par Lots (BN) est une technique remarquablement légère mais efficace. Les couches BN calculent des statistiques de moyenne et de variance courantes pendant l’entraînement pour normaliser les cartes de caractéristiques intermédiaires. Lorsque le domaine change, ces statistiques ne représentent plus avec précision la distribution cible. L’adaptation BN recalcule simplement les statistiques BN en faisant passer les données du domaine cible à travers le réseau avec des poids gelés, mettant à jour la moyenne et la variance courantes sans aucune mise à jour de gradient. Cela seul peut réduire significativement le décalage de domaine lorsque la différence principale réside dans les statistiques d’image de bas niveau telles que la luminosité, le contraste et la distribution des couleurs. Des études sur la détection de fissures montrent que l’adaptation BN récupère 3 à 8 % des baisses de précision causées par des décalages d’éclairage et de caméra modérés, ne nécessitant qu’une seule passe avant de données cibles non étiquetées.
| Stratégie d’Ajustement | Données Cibles Requises | Paramètres Mis à Jour | Risque d’Oubli Catastrophique | Meilleur Cas d’Utilisation |
|---|---|---|---|---|
| Recalcul des statistiques BN | Aucune (non étiquetée) | 0 (stats BN seulement) | Aucun | Décalages d’éclairage / caméra |
| Ajustement de la dernière couche | 10–50 étiquetées | < 1 % | Très faible | Distribution des caractéristiques préservée |
| Modules adaptateurs | 50–200 étiquetées | 1–5 % | Faible | Déploiement multi-domaine |
| Dégel progressif | 100–500 étiquetées | Graduel, 10–100 % | Modéré | Décalage de domaine modéré |
| Ajustement complet | 500+ étiquetées | 100 % | Élevé | Données cibles abondantes, grand décalage |
Adaptation de Domaine Supervisée
L’adaptation de domaine supervisée (SDA) fonctionne sous l’hypothèse qu’une petite quantité de données étiquetées est disponible dans le domaine cible en plus des données source étiquetées abondantes. C’est le cadre le plus simple : le modèle a un accès direct à des informations de vérité terrain sur le domaine cible, permettant une optimisation explicite pour les performances cibles.
L’approche SDA standard comporte deux composantes. Premièrement, le modèle est pré-entraîné sur le domaine source avec ses étiquettes abondantes, cela établit des connaissances générales sur la tâche d’inspection, apprenant à reconnaître les bords de fissures, les limites de joints, les textures de surface et les géométries de défauts. Deuxièmement, le modèle est ajusté sur les données cibles étiquetées en utilisant un taux d’apprentissage sensiblement réduit. Lors de l’ajustement, la fonction de perte combine généralement les pertes source et cible pour éviter que le modèle n’oublie les connaissances utiles du domaine source. La perte combinée s’exprime ainsi :
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
où (\mathcal{L}_S) est la perte source calculée sur les données source, (\mathcal{L}_T) est la perte cible calculée sur les données cibles étiquetées, et (\lambda) contrôle la contribution relative de chaque domaine. Pendant l’entraînement, les lots source et cible sont alternativement ou conjointement transmis à travers le réseau.
Les techniques clés pour l’adaptation de domaine supervisée incluent les fonctions de perte pondérées qui donnent une importance plus élevée aux échantillons du domaine cible lors de l’ajustement, l’entraînement conjoint où les données étiquetées source et cible sont mélangées dans chaque lot d’entraînement, et l’entraînement contradictoire de domaine où un classificateur de domaine est ajouté même dans le cadre supervisé pour encourager l’extracteur de caractéristiques à apprendre des représentations invariantes de domaine. Les stratégies d’apprentissage curriculaire commencent par un entraînement dominé par la source et transfèrent progressivement l’équilibre vers les données cibles à mesure que l’entraînement progresse.
Le transfert de paramètres, où les poids du modèle entraîné sur la source servent d’initialisation, est la stratégie dominante en SDA. Le succès de cette approche dépend du degré de parenté entre les domaines source et cible. Lorsque les domaines sont étroitement liés (par exemple, différentes sections de la même chaussée d’aéroport), très peu d’exemples cibles étiquetés sont suffisants, aussi peu que 20 à 50 images peuvent récupérer la majeure partie de la performance perdue due au décalage de domaine. Lorsque les domaines sont plus éloignés (par exemple, de la route à la piste), 200 à 500 exemples cibles étiquetés sont généralement nécessaires pour une adaptation robuste.
Les techniques SDA économes en étiquettes visent à minimiser le nombre d’étiquettes cibles nécessaires. L’apprentissage actif identifie les échantillons cibles les plus informatifs à étiqueter : le modèle est entraîné sur les données source, appliqué aux données cibles non étiquetées, et les échantillons pour lesquels il est le plus incertain sont sélectionnés pour un étiquetage humain. Cette approche peut réduire les besoins d’étiquetage de 50 à 70 % par rapport à l’échantillonnage aléatoire. L’auto-apprentissage (ou pseudo-étiquetage) applique le modèle entraîné sur la source aux données cibles non étiquetées, génère des étiquettes provisoires pour les prédictions à haute confiance, et ré-entraîne le modèle en utilisant ces pseudo-étiquettes comme supervision supplémentaire. L’auto-apprentissage est particulièrement efficace lorsqu’il est combiné avec un seuillage de confiance et une augmentation de données.
Quand utiliser la SDA : lorsque l’obtention d’un petit ensemble étiqueté de chaque site de déploiement cible est réalisable. Pour l’inspection des pistes d’aéroport, cela signifie qu’un inspecteur formé peut étiqueter 50 à 200 images par aéroport, un coût unique de 1 à 4 heures par site. C’est beaucoup plus économique que l’alternative de collecter et d’étiqueter des milliers d’images par aéroport, ce qui nécessiterait plusieurs jours par site. Le FAA AC 150/5380-6C recommande des relevés PCI réguliers qui impliquent déjà des inspecteurs examinant les surfaces de chaussée, ces mêmes inspecteurs peuvent fournir les quelques centaines d’images étiquetées nécessaires à la SDA dans le cadre de leur flux de travail d’inspection standard.
Adaptation de Domaine Non Supervisée
L’adaptation de domaine non supervisée (UDA) est le cadre d’adaptation de domaine le plus difficile et le plus activement recherché. Elle suppose que des données étiquetées n’existent que dans le domaine source, tandis que le domaine cible est complètement non étiqueté. L’UDA est le scénario dominant pour l’inspection des infrastructures car l’étiquetage des données du domaine cible est coûteux, chronophage ou peu pratique sur de nombreux sites de déploiement. Un modèle entraîné sur les images de chaussée d’un aéroport doit s’adapter aux surfaces, à l’éclairage et aux motifs de défauts d’un aéroport différent sans que chaque aéroport doive produire un jeu de données étiqueté.
Les méthodes UDA se répartissent en trois catégories principales : les méthodes contradictoires, les méthodes basées sur l’écart et les méthodes basées sur la reconstruction. Toutes partagent l’objectif central d’aligner les distributions de caractéristiques source et cible afin qu’un classifieur entraîné sur les caractéristiques source généralise aux caractéristiques cibles.
Adaptation de Domaine Contradictoire
L’adaptation de domaine contradictoire s’inspire des Réseaux Adverses Génératifs (GAN). L’idée centrale est d’entraîner un discriminateur de domaine (un classifieur binaire qui prédit si une représentation de caractéristique provient du domaine source ou cible) en même temps que l’extracteur de caractéristiques dans un jeu minimax. L’extracteur de caractéristiques essaie de produire des caractéristiques impossibles à distinguer entre source et cible, tandis que le discriminateur essaie d’identifier correctement l’origine de chaque caractéristique.
L’architecture canonique est le Réseau de Neurones Contradictoire de Domaine (DANN), introduit par Yaroslav Ganin et Victor Lempitsky en 2015. DANN se compose de trois composants : un extracteur de caractéristiques (G_f) qui mappe les entrées vers un espace de caractéristiques (f = G_f(x, \theta_f)), un prédicteur d’étiquettes (G_y) qui mappe les caractéristiques vers les étiquettes de tâche (\hat{y} = G_y(f, \theta_y)), et un classifieur de domaine (G_d) qui mappe les caractéristiques vers les étiquettes de domaine (\hat{d} = G_d(f, \theta_d)). L’innovation critique est la Couche de Renversement de Gradient (GRL) placée entre l’extracteur de caractéristiques et le classifieur de domaine. Lors de la propagation avant, la GRL agit comme une transformation identité. Lors de la rétropropagation, elle multiplie le gradient par (-\lambda), où (\lambda) est un hyperparamètre contrôlant la force de l’adaptation. Ce renversement amène l’extracteur de caractéristiques à apprendre des caractéristiques qui maximisent la perte de classification de domaine, apprenant ainsi efficacement à tromper le classifieur de domaine.
La fonction de perte DANN combine la perte de tâche sur les étiquettes source moins la perte de classification de domaine sur les caractéristiques source et cible :
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
À mesure que l’entraînement progresse, l’extracteur de caractéristiques apprend des représentations qui sont à la fois discriminantes pour la tâche (car le prédicteur d’étiquettes est entraîné sur les étiquettes source) et invariantes de domaine (car le classifieur de domaine ne peut pas distinguer l’origine du domaine). La programmation de la GRL commence généralement avec (\lambda = 0) et augmente progressivement jusqu’à une valeur maximale au cours des premières époques, permettant au réseau de stabiliser ses performances de tâche avant que la pression de confusion de domaine ne soit appliquée.
Les avancées récentes dans l’adaptation de domaine contradictoire incluent l’Entraînement Contradictoire Contrastif (CAT), qui exploite les échantillons source étiquetés pour renforcer la séparation des caractéristiques tout en maintenant l’alignement du domaine, les Réseaux Collaboratifs et Adverses (CAN), qui effectuent un alignement de domaine à plusieurs niveaux à différents niveaux de la hiérarchie des caractéristiques, et la Minimisation de l’Écart de Style Adversarial, qui utilise le transfert de style comme objectif contradictoire. Pour la détection de fissures de chaussée, les méthodes contradictoires ont démontré la plus forte généralisation inter-jeux de données, récupérant 15 à 25 points de pourcentage de la performance perdue due au décalage de domaine.
Méthodes Basées sur l’Écart
Les méthodes basées sur l’écart adoptent une approche différente : au lieu d’un entraînement contradictoire, elles minimisent explicitement une mesure de distance statistique entre les distributions de caractéristiques source et cible. L’avantage est la stabilité de l’entraînement, pas de dynamiques contradictoires nécessitant un réglage minutieux des hyperparamètres, au prix d’un alignement potentiellement plus faible.
La Divergence Maximale Moyenne (MMD) est la mesure d’écart la plus largement utilisée pour l’adaptation de domaine. La MMD est un test statistique basé sur un noyau qui mesure la distance entre deux distributions dans un Espace de Hilbert à Noyau Reproduisant (RKHS). Étant données les caractéristiques source (\mathbf{f}^S) et cible (\mathbf{f}^T), la MMD au carré est :
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
où (\phi) est le plongement de caractéristiques dans le RKHS. En pratique, la MMD est calculée en utilisant une fonction de noyau (k(x,y) = \langle \phi(x), \phi(y) \rangle), généralement le noyau RBF gaussien, souvent avec plusieurs largeurs de bande pour capturer différents niveaux de similarité de distribution.
Les Réseaux d’Adaptation Profonde (DAN), introduits par Long et al. en 2015, ajoutent une perte MMD à plusieurs couches spécifiques à la tâche d’un CNN profond. La perte totale devient (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), où (L) est l’ensemble des couches auxquelles l’alignement de domaine est appliqué. DAN a démontré que l’alignement des représentations de caractéristiques de plus haut niveau (plutôt que seulement la dernière couche) améliore significativement la qualité de l’adaptation.
L’Alignement de CORrélation (CORAL), introduit par Sun et Saenko en 2016, adopte une approche plus simple en minimisant la différence entre les matrices de covariance des caractéristiques source et cible :
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
où (C_S) et (C_T) sont les matrices de covariance des caractéristiques source et cible respectivement, (d) est la dimension des caractéristiques, et (|\cdot|_F) est la norme de Frobenius. Deep CORAL étend cela aux réseaux profonds en ajoutant la perte CORAL à la fonction de perte du réseau. CORAL est informatiquement efficace et fonctionne bien lorsque le décalage de domaine se situe principalement dans la variance des caractéristiques plutôt que dans la moyenne.
Les Réseaux d’Adaptation Conjointe (JAN) étendent DAN en alignant les distributions conjointes de plusieurs couches plutôt que de traiter chaque couche indépendamment. JAN utilise la MMD Conjointe (JMMD), définie sur le produit tensoriel des activations de plusieurs couches. Cela capture les dépendances inter-couches que les pertes MMD individuelles manquent.
Les avancées récentes pour l’inspection des infrastructures incluent le framework de Wang et al. (2025) pour la segmentation de corrosion, qui combine trois modules d’écart complémentaires : la Préservation de la Structure Géométrique (GSP) qui conserve les relations topologiques locales à travers les domaines en utilisant une régularisation basée sur les graphes, l’Écart Local basé sur la Décomposition en Valeurs Singulières (SLD) qui utilise la décomposition en valeurs singulières pour aligner les sous-espaces de caractéristiques locaux à un niveau fin, et l’Alignement de Cohérence Globale (GCA) qui utilise la MMD pour concilier les décalages distributionnels globaux. Cette approche combinée, soutenue par le backbone de segmentation léger EffSegNet, a atteint une forte généralisation inter-domaines de l’imagerie de corrosion en laboratoire aux conditions de terrain sur les écluses, les barrages et les infrastructures de transport.
Comparaison des Méthodes UDA
| Méthode | Catégorie | Mécanisme d’Alignement | Stabilité d’Entraînement | Performance Infrastructure |
|---|---|---|---|---|
| DANN | Contradictoire | Renversement de gradient + classifieur de domaine | Modérée (nécessite réglage (\lambda)) | Forte (récupère 15–25 ppt mIoU) |
| DAN | Écart | MMD sur les sorties de plusieurs couches | Élevée | Bonne (récupère 10–20 ppt mIoU) |
| Deep CORAL | Écart | Alignement de covariance (stats 2nd ordre) | Élevée | Modérée (récupère 8–15 ppt mIoU) |
| JAN | Écart | MMD conjointe sur les paires de couches | Élevée | Bonne (récupère 12–18 ppt mIoU) |
| CycleGAN+Det | Génératif | Traduction image-à-image + modèle de tâche | Faible (difficulté d’entraînement GAN) | Forte lorsque la traduction d’image réussit |
| CAT | Contradictoire | Contrastif + contradictoire | Modérée | Forte (état de l’art sur plusieurs benchmarks) |
Apprentissage de Caractéristiques Invariantes de Domaine
Les caractéristiques invariantes de domaine sont des représentations de caractéristiques produites par un réseau de neurones qui ont la même distribution statistique quel que soit le domaine d’origine de l’entrée. Si (f(x)) est la représentation de caractéristique extraite par le réseau, l’invariance de domaine signifie (P(f(X_S)) \approx P(f(X_T))). L’objectif est d’apprendre un mappage (f) tel que la distance (d(P(f(X_S)), P(f(X_T)))) soit minimisée tout en préservant le pouvoir discriminant spécifique à la tâche.
Les quatre approches principales de l’apprentissage de caractéristiques invariantes de domaine gèrent différemment le compromis invariance-discriminabilité. L’apprentissage contradictoire (DANN, basé sur GAN) pousse l’extracteur de caractéristiques à produire des caractéristiques qu’un discriminateur de domaine ne peut pas distinguer. C’est le mécanisme d’invariance le plus agressif mais il risque de supprimer des informations pertinentes pour la tâche si la texture de la fissure est corrélée au type de surface. L’appariement de moments statistiques (MMD, CORAL) aligne les moments de distribution, premier ordre (moyenne) et second ordre (covariance), entre les caractéristiques source et cible. Cela préserve plus d’informations pertinentes pour la tâche qu’un alignement contradictoire complet mais peut ne pas capturer les différences de distribution d’ordre supérieur. Le transport optimal (méthodes basées sur OT) trouve un mappage de coût minimal entre les distributions source et cible, fournissant une interprétation géométrique de l’alignement de domaine. Les méthodes de transfert de style et génératives (CycleGAN, StarGAN) transforment les images d’un domaine pour ressembler visuellement à un autre avant de les passer à travers le réseau de tâche. Cela opère au niveau des pixels plutôt qu’au niveau des caractéristiques et a l’avantage de produire des images transformées interprétables.
Le compromis invariance-discriminabilité est une tension fondamentale dans l’apprentissage de caractéristiques invariantes de domaine. Maximiser l’invariance de domaine peut supprimer des informations pertinentes pour la tâche qui sont corrélées au domaine. Par exemple, si les bords de fissures sur l’asphalte ont un contraste plus élevé que sur le béton, un détecteur de caractéristiques qui repose sur la force du contraste des bords sera sensible à la fois à la présence de fissures et au type de chaussée. Forcer une invariance complète au type de chaussée peut supprimer les caractéristiques de contraste des bords nécessaires à la détection des fissures. Les méthodes avancées abordent cela par un alignement multi-niveaux, n’alignant que les caractéristiques sémantiques de plus haut niveau tout en conservant les indices de texture de bas niveau, et un alignement conditionnel qui aligne les distributions conditionnées par l’étiquette de tâche, préservant les informations discriminantes de classe.
L’invariance de domaine basée sur l’attention exploite les mécanismes d’attention pour se concentrer sur les régions sémantiques indépendantes du domaine. Un modèle de détection de fissures avec un module d’attention spatiale apprend à se concentrer sur les structures de fissures quelle que soit la texture de fond de la chaussée. Les cartes d’attention elles-mêmes deviennent plus invariantes de domaine que les cartes de caractéristiques brutes car elles mettent en évidence les emplacements spatiaux pertinents pour la tâche tout en supprimant le fond spécifique au domaine. L’attention croisée entre les caractéristiques source et cible renforce encore cela en faisant correspondre explicitement les régions attentives à travers les domaines.
Les méthodes d’adaptation de domaine auto-supervisées utilisent des tâches prétextes telles que la prédiction de rotation, la résolution de puzzles ou le contraste d’instances discriminatives pour apprendre des caractéristiques robustes à la variation de domaine sans nécessiter d’étiquettes de domaine. En résolvant ces tâches auxiliaires, le modèle apprend à capturer des propriétés structurelles et géométriques de l’entrée qui sont partagées entre les domaines. Les caractéristiques pré-entraînées auto-supervisées présentent souvent une invariance de domaine plus forte que les caractéristiques purement supervisées car les tâches prétextes ne dépendent pas des distributions d’étiquettes spécifiques au domaine.
Adaptation de la Route à la Piste
La transition de l’inspection des chaussées routières à l’inspection des pistes d’aéroport représente l’un des problèmes d’adaptation de domaine les plus difficiles dans la gestion des actifs d’infrastructure. Les routes et les pistes sont des structures conçues fondamentalement différentes, destinées à des charges, vitesses et exigences de sécurité différentes, produisant des apparences visuelles et des caractéristiques de défauts radicalement différentes.
| Facteur | Chaussée Routière | Chaussée de Piste d’Aéroport |
|---|---|---|
| Norme de conception | Variable selon la juridiction | Annexe 14 de l’OACI / normes FAA |
| Charge par essieu | ~10 tonnes (véhicules) | 50–400 tonnes (aéronefs) |
| Matériau de surface principal | Asphalte (HMA) | Béton PCC à haute résistance (courant) ou asphalte lourd |
| Marquages | Marques de voie jaunes/blanches (couleurs multiples) | Marques blanches uniquement, motifs complexes (seuil, zone de toucher des roues, point d’aboutement, axe) |
| Types de défauts principaux | Fissures, nids-de-poule, orniérage, ressuage | Fissures, FOD, dépôts de caoutchouc, désenrobage, dégradation de la friction, érosion par jet, dommages dus au carburant |
| Accès à l’inspection | Routes publiques, accès facile non restreint | Côté piste restreint, nécessite un laissez-passer, escorte de véhicule, communication radio |
| Méthode de capture dominante | Véhicules au sol, smartphones, manuelle | UAV à 30–100 m d’altitude, véhicules d’inspection spécialisés |
| Contaminants de surface | Eau, neige, débris, huile | Eau, caoutchouc (critique, zones de toucher des roues), fluides de dégivrage, carburant aviation, fluide hydraulique |
| Paramètre de friction critique pour la sécurité | Résistance au dérapage pour le freinage | Coefficient d’action de freinage pour l’atterrissage des aéronefs (catégories GRF OACI) |
| Cadre réglementaire | Normes FHWA, DOT des États | Annexe 14 de l’OACI, Doc 9137, AC FAA |
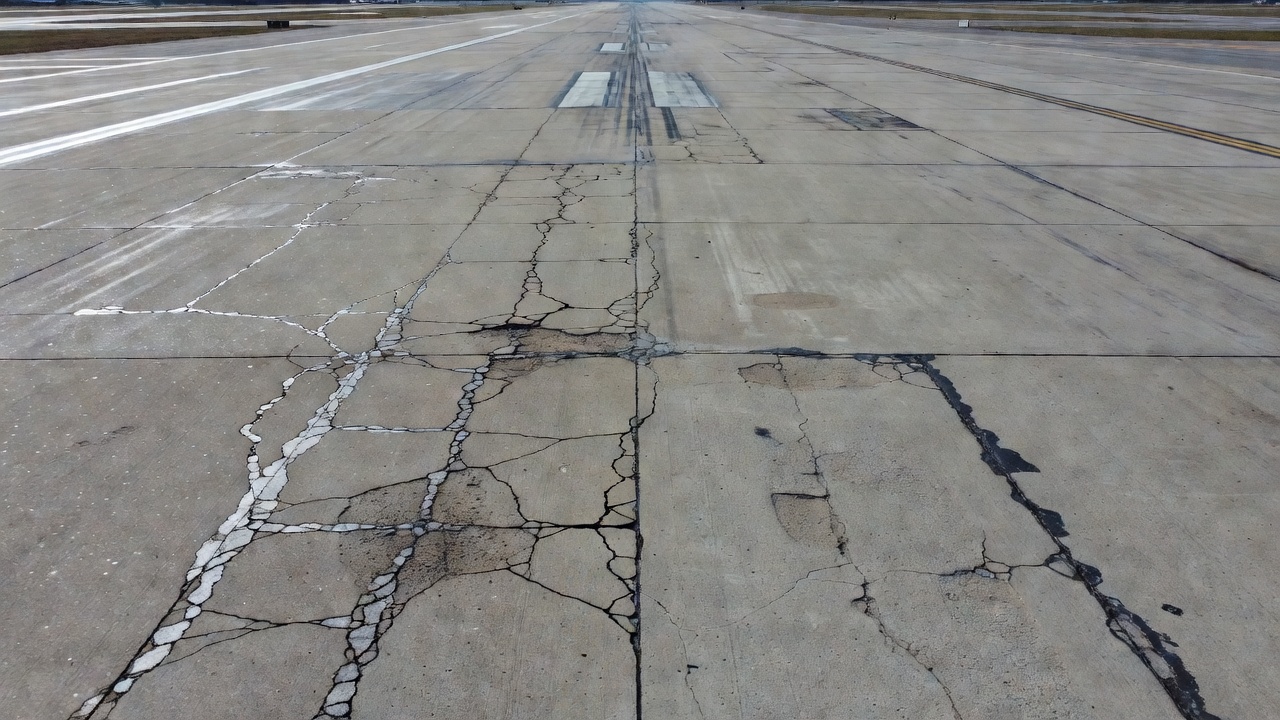
L’interférence des dépôts de caoutchouc est le problème d’adaptation le plus difficile. Les pneus d’aéronef déposent du caoutchouc sur les pistes lors de l’atterrissage, en particulier dans la zone de toucher des roues, s’accumulant sous forme de plaques sombres et continues sur la surface de la chaussée. Ces dépôts de caoutchouc peuvent visuellement imiter ou masquer les fissures. Un modèle de détection de fissures entraîné sur route, qui n’a jamais rencontré de dépôts de caoutchouc de pneus, peut soit ne pas détecter les fissures sous les plaques de caoutchouc, soit classer faussement les bords des plaques de caoutchouc comme des fissures. L’adaptation route-vers-piste doit donc intégrer la modélisation des dépôts de caoutchouc, soit par une augmentation synthétique des données d’entraînement, soit par des méthodes d’adaptation de domaine qui apprennent à distinguer le caoutchouc des fissures.
Les différences d’échelle et de résolution sont une autre barrière d’adaptation significative. Les images d’inspection routière sont généralement capturées au niveau du sol à des distances de 1 à 5 mètres, offrant une très haute résolution où les bords de fissures individuels s’étendent sur des dizaines de pixels. L’inspection des pistes à l’aide d’UAV à 30–100 m d’altitude produit des images avec une résolution plus grossière : une fissure qui s’étend sur 50 pixels dans une image routière peut ne s’étendre que sur 5 à 10 pixels dans une image de piste capturée depuis l’altitude. Les champs récepteurs de l’extracteur de caractéristiques et les filtres dépendants de l’échelle doivent s’adapter à cette différence de contenu de fréquence spatiale. Les pyramides de caractéristiques multi-échelles et l’entraînement invariant à l’échelle sont des composants d’adaptation essentiels.
Le décalage de définition des défauts nécessite un mappage minutieux entre les taxonomies de détresse des routes et des pistes. Le Manuel d’Identification de la Détresse LTPP de la FHWA définit les défauts de chaussée routière dans des catégories qui chevauchent partiellement les défauts de chaussée aéroportuaire définis par l’ASTM D5340 et le Doc 9137 Partie 9 de l’OACI. Certains types de défauts sont uniques aux aérodromes : les dépôts de caoutchouc, l’érosion par jet, les dommages dus au carburant et la dégradation de la friction n’ont pas d’équivalents routiers. Les modèles entraînés sur route ont donc besoin de nouvelles classes de sortie ajoutées lors de l’adaptation, ou d’une approche de classification hiérarchique qui détecte d’abord les défauts génériques puis les classe en catégories spécifiques au domaine.
La conformité réglementaire impose une couche supplémentaire d’exigence d’adaptation. Les modèles d’inspection routière produisent des sorties qui informent la priorisation de la maintenance par les agences DOT. Les modèles d’inspection des pistes doivent produire des sorties qui correspondent aux formats de rapport imposés par l’OACI et la FAA : les catégories de conditions du Format de Rapport Global (GRF), l’Indice de Condition de Chaussée (PCI) selon l’ASTM D5340, et les évaluations du Numéro de Classification de Chaussée (PCN). Le processus d’adaptation doit donc également adapter la représentation de sortie du modèle pour s’aligner sur les normes de reporting réglementaires.
Le pontage progressif de domaine, un entraînement sur des jeux de données intermédiaires qui couvrent progressivement l’écart entre la route et la piste, s’est avéré efficace. Un pipeline de pontage typique comporte trois étapes : premièrement, s’entraîner sur des jeux de données routiers (CQU-BPDD, RDD2020, Crack500), deuxièmement, s’adapter à des jeux de données de chaussée généraux qui incluent à la fois des surfaces en asphalte et en béton, troisièmement, s’adapter à des jeux de données spécifiques aux pistes avec des dépôts de caoutchouc et des marquages aéronautiques. Chaque étape réduit l’écart de distribution que l’étape suivante doit combler, permettant une adaptation plus stable et plus efficace qu’un transfert direct route-vers-piste.
Adaptation à Travers les Conditions Climatiques
Les conditions climatiques introduisent une variation de domaine qui est à la fois temporelle (changeant au fil du temps sur un seul site) et géographique (variant selon les sites simultanément). Un modèle déployé sur plusieurs aéroports doit gérer les deux dimensions.
L’adaptation surface mouillée vs sèche est critique car les catégories de conditions de surface de piste dans le cadre du Format de Rapport Global (GRF) de l’OACI distinguent explicitement les surfaces sèches, mouillées, mouillées glissantes et contaminées. Les surfaces mouillées modifient la visibilité des fissures de plusieurs manières. L’eau remplissant les fissures réduit le contraste entre la fissure et la chaussée environnante : les fissures sèches apparaissent comme des caractéristiques linéaires sombres ou claires à haut contraste, mais les fissures remplies d’eau apparaissent comme des caractéristiques à faible contraste qui peuvent être presque invisibles pour un modèle entraîné sur des surfaces sèches. Le film d’eau sur la surface de la chaussée crée des réflexions spéculaires qui introduisent des régions lumineuses et de fausses arêtes, ce qui perturbe les détecteurs de fissures. La chaussée mouillée apparaît également globalement plus sombre, décalant l’histogramme de l’image et modifiant les statistiques de chaque couche du réseau.
L’adaptation au climat froid aborde les effets de gel-dégel qui modifient l’apparence de la chaussée. Les surfaces gelées ont des propriétés de réflectance différentes de celles des surfaces non gelées. Les plaques de glace sur la chaussée apparaissent comme des régions lisses à haute réflectivité qui partagent des caractéristiques visuelles avec les défauts de surface de la chaussée. La couverture de neige masque partiellement ou complètement les défauts de surface. La transition entre les cycles de gel et de dégel produit des motifs de détresse uniques (fissuration en D, écaillage par gel-dégel, soulèvement par le gel) que les modèles entraînés sur des données de climat chaud peuvent ne pas reconnaître.
L’augmentation de données pour l’adaptation climatique génère synthétiquement des variations du domaine cible à partir d’images du domaine source. L’ajout de traînées de pluie simulées, de modèles de réflectance de surface mouillée, de masques de couverture neigeuse et de superpositions d’ombres peut étendre la couverture du domaine source pour inclure des conditions climatiques non présentes dans les données d’entraînement originales. Les politiques RandAugment avec des transformations photométriques spécifiques ciblant les décalages de luminosité, de contraste et de température de couleur sont particulièrement efficaces pour l’adaptation climatique. Des études montrent que les approches basées uniquement sur l’augmentation récupèrent 50 à 70 % de la performance perdue due aux décalages de domaine d’éclairage et de météo, ce qui en fait un complément rentable aux méthodes contradictoires ou basées sur l’écart plus complexes.
La traduction de domaine basée sur CycleGAN fournit une alternative en apprenant à traduire des images entre conditions climatiques. Un CycleGAN entraîné sur des images appariées ou non appariées de pistes sèches et mouillées apprend à mapper du domaine sec au domaine mouillé tout en préservant les emplacements et les géométries des fissures. Les modèles de détection de fissures entraînés sur ces données augmentées apprennent des caractéristiques invariantes à la présence ou à l’absence d’eau sur la surface. L’inconvénient est la complexité d’entraînement des GAN et le risque d’halluciner ou de supprimer des caractéristiques de fissures lors de la traduction.
Adaptation à Travers les Types de Caméra
Les systèmes d’inspection d’infrastructure utilisent une variété de plateformes d’imagerie, chacune avec des caractéristiques optiques différentes qui introduisent un décalage de domaine. L’adaptation à travers les types de caméra est essentielle pour tout système déployé sur plusieurs aéroports, où l’imagerie existante peut provenir de différentes sources.
La résolution et la Distance d’Échantillonnage au Sol (GSD) varient considérablement. L’inspection au niveau du sol avec un reflex numérique de 50 MP produit des GSD de 0,1–0,5 mm/pixel. L’inspection par UAV à 30 m d’altitude produit 0,5–1 cm/pixel. L’inspection par UAV à 100 m d’altitude produit 2–5 cm/pixel. L’imagerie satellite peut avoir une résolution de 30–50 cm/pixel. Une fissure de 3 mm de large s’étend sur 6–30 pixels au niveau du sol, 0,3–0,6 pixels à 30 m d’altitude UAV, et est sous-pixel à 100 m. Les modèles entraînés sur des images au sol à haute résolution ne peuvent pas détecter directement les caractéristiques à des résolutions plus grossières. L’entraînement multi-résolution, un entraînement sur des images à plusieurs échelles de résolution, est la stratégie principale. L’extracteur de caractéristiques apprend des représentations invariantes à l’échelle grâce au pooling pyramidal, aux convolutions dilatées ou à la normalisation adaptative à la résolution.
Les différences de sensibilité spectrale du capteur entre les caméras affectent la représentation des couleurs. Différents capteurs CMOS et CCD ont différentes courbes d’efficacité quantique sur le spectre visible, ce qui signifie que la même surface apparaît avec des valeurs RVB légèrement différentes selon les caméras. L’étalonnage des couleurs à l’aide d’une carte de charte de couleurs lors de la collecte de données réduit ce décalage mais est rarement pratique pour les programmes d’inspection à grande échelle. L’appariement d’histogrammes et le transfert de couleur entre les images source et cible sont des alternatives de prétraitement. Les approches plus sophistiquées incluent l’apprentissage de caractéristiques invariantes au capteur qui supprime explicitement les informations de couleur spécifiques au capteur des représentations de caractéristiques grâce à une augmentation de la gigue de couleur pendant l’entraînement.
La distorsion d’objectif varie selon les combinaisons d’appareil photo et d’objectif. Les objectifs grand angle utilisés pour une couverture efficace des pistes introduisent une distorsion en barillet qui modifie la géométrie des fissures : les fissures droites peuvent apparaître courbes près des bords de l’image. Pour les tâches de détection, cette distorsion affecte la relation spatiale entre les caractéristiques de l’image. La correction de distorsion en tant qu’étape de prétraitement normalise toutes les images à une géométrie rectifiée commune avant de les fournir au modèle. Alternativement, un entraînement sur des images avec une augmentation de distorsion synthétique rend le modèle robuste à différents niveaux de distorsion.
Les effets d’obturateur roulant des plateformes UAV introduisent une distorsion géométrique pendant le vol, en particulier à grande vitesse ou par vent fort. L’exposition séquentielle des lignes dans un capteur CMOS à obturateur roulant signifie que le mouvement de la caméra pendant l’exposition produit une géométrie de fissure déformée ou décalée. Cette distorsion temporelle est absente des caméras à obturateur global et de la capture statique au niveau du sol. L’adaptation nécessite soit un prétraitement pour corriger les artefacts de l’obturateur roulant, soit un entraînement sur des données qui incluent une dégradation synthétique de l’obturateur roulant.
| Variation de Caméra | Stratégie d’Adaptation | Complexité d’Implémentation | Récupération Typique |
|---|---|---|---|
| Résolution / GSD | Entraînement multi-résolution + pooling pyramidal | Modérée | 5–10 % de récupération de précision |
| Réponse couleur du capteur | Augmentation de la gigue de couleur + appariement d’histogrammes | Faible | 3–7 % de récupération de précision |
| Distorsion d’objectif | Prétraitement de correction de distorsion | Faible | 2–5 % de récupération de précision |
| Obturateur roulant | Augmentation synthétique de l’obturateur roulant | Modérée | 3–6 % de récupération de précision |
| Artefacts de compression | Augmentation de la compression JPEG | Faible | 1–3 % de récupération de précision |
Fondements Mathématiques et Formulations Clés
Comprendre l’adaptation de domaine nécessite une familiarité avec plusieurs formulations mathématiques centrales. Le cadre de la Minimisation du Risque Empirique (ERM) fournit le point de départ. Étant donné un domaine source avec des échantillons étiquetés ({(x_i^S, y_i^S)}_{i=1}^{n_S}), un modèle standard minimise le risque empirique :
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
où (\ell) est la fonction de perte spécifique à la tâche (entropie croisée pour la classification, perte Dice pour la segmentation). L’adaptation de domaine vise à minimiser le risque cible :
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
Le défi est que (R_T) ne peut pas être minimisé directement lorsque les étiquettes cibles ne sont pas disponibles. Les méthodes d’adaptation de domaine bornent le risque cible par la somme du risque source et d’une mesure de divergence entre les distributions source et cible.
La H-divergence fournit une borne théorique pour l’adaptation de domaine (Ben-David et al., 2010). Pour une classe d’hypothèses (\mathcal{H}), la H-divergence entre les distributions source et cible est :
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
En pratique, la H-divergence est estimée en entraînant un classifieur à discriminer entre les échantillons du domaine source et cible, exactement ce que fait le classifieur de domaine dans DANN. Le résultat théorique garantit qu’un modèle entraîné sur des données source généralisera au domaine cible si la H-divergence entre les domaines est faible. Cela fournit la justification formelle de l’adaptation de domaine contradictoire.
La MMD sous forme fonctionnelle utilise un noyau caractéristique (k) pour plonger les distributions de probabilité dans un RKHS :
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
Avec le noyau gaussien (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)), la MMD au carré peut être calculée directement à partir des moyennes des échantillons :
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
La perte CORAL aligne les statistiques de second ordre :
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
où (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) et (C_T) est défini de manière analogue pour les caractéristiques cibles. La norme de Frobenius (|\cdot|_F) est la somme élémentaire des carrés.
Ces fondements mathématiques se traduisent directement en implémentation pratique. La perte d’adaptation de domaine pour un réseau Deep CORAL est :
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Pour un réseau DANN :
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{domain}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
où (\mathbf{D} = {0, 1}) indique le domaine source (0) ou cible (1), et le signe négatif reflète le renversement de gradient.
| Méthode | Fonction Objectif | Hyperparamètres Clés |
|---|---|---|
| ERM (pas d’adaptation) | (\mathcal{L} = \mathcal{L}_{task}(D_S, Y_S)) | Taux d’apprentissage, décroissance du poids |
| DANN | (\mathcal{L} = \mathcal{L}{task} - \lambda \mathcal{L}{domain}) | (\lambda) (force d’adaptation), planning GRL |
| DAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) par couche, largeur de bande du noyau (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{task} + \lambda |C_S - C_T|_F^2) | (\lambda) (poids d’alignement) |
| JAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l JMMD_l) | Paires de couches, largeurs de bande du noyau |
| Ajustement | (\mathcal{L} = \mathcal{L}_{task}(D_T, Y_T)) LR réduit | Planning de gel, facteur de réduction LR |
Protocoles d’Évaluation pour l’Adaptation de Domaine
L’évaluation des méthodes d’adaptation de domaine nécessite des benchmarks standardisés inter-jeux de données qui mesurent les performances sur les domaines cibles non vus pendant l’entraînement. Pour l’inspection des infrastructures, plusieurs protocoles de benchmark ont été établis.
L’évaluation inter-jeux de données est le protocole standard. Le modèle est entraîné sur un jeu de données source (par exemple, CQU-BPDD, qui contient des images de fissures de chaussée bitumineuse) et évalué sur un jeu de données cible (par exemple, RDD2020, qui contient des images de fissures routières de plusieurs pays). La performance sur le jeu de données cible avant adaptation sert de référence source uniquement. La performance après adaptation (avec accès aux données cibles non étiquetées pour UDA ou aux données cibles étiquetées limitées pour SDA) est mesurée par rapport à cette référence. Le gain d’adaptation, la différence entre la performance adaptée et non adaptée, quantifie l’efficacité de la méthode d’adaptation.
Les benchmarks courants pour la détection de fissures de chaussée incluent : CQU-BPDD (Jeu de données de fissures de chaussée bitumineuse) contenant 60 088 images de fissures de chaussée en asphalte de Chine, RDD2020 contenant 26 336 images de fissures routières d’Inde, du Japon et de la République tchèque, Crack500 contenant 500 images haute résolution de fissures de chaussée sur surfaces routières, DeepCrack contenant 537 images de fissures de murs de bâtiments, et SDNET2018 contenant 56 000 images de tabliers de ponts en béton, de murs et de chaussées. L’évaluation inter-jeux de données sur ces ensembles, en particulier de CQU-BPDD à RDD2020, représentant un transfert inter-pays et inter-climat, est le benchmark le plus rigoureux.
Les métriques pour l’évaluation de l’adaptation de domaine incluent la mIoU du domaine cible (Intersection sur Union moyenne pour les tâches de segmentation), le score F1 du domaine cible (pour les tâches de détection), la rétention source (performance du domaine source après adaptation, pour mesurer l’oubli catastrophique), le gain d’adaptation (amélioration en points de pourcentage par rapport à la référence source uniquement) et l’efficacité d’étiquetage (la quantité de données cibles étiquetées nécessaire pour atteindre un niveau de performance donné pour les méthodes supervisées).
La signification statistique est essentielle car les résultats de l’adaptation de domaine peuvent être bruyants. Des exécutions multiples avec différentes graines aléatoires (généralement 5 à 10) sont utilisées pour calculer la moyenne et l’écart type des métriques de performance. Le test de Wilcoxon signé ou le test t apparié est utilisé pour déterminer si les différences de performance entre les méthodes d’adaptation sont statistiquement significatives aux seuils conventionnels ((p < 0,05)).
Pour l’inspection des infrastructures, des métriques supplémentaires spécifiques au déploiement sont pertinentes : le taux de faux positifs aux seuils de sévérité opérationnelle (un détecteur de fissures qui génère 100 fausses alarmes par inspection de piste est inutile sur le plan opérationnel quel que soit sa mIoU), le temps d’inférence par unité de surface (l’adaptation ne devrait pas augmenter significativement le temps de traitement), et l’empreinte mémoire (les méthodes basées sur des adaptateurs devraient ajouter une surcharge de stockage minimale par aéroport supplémentaire).
Normes et Références Clés
La pratique de l’adaptation de domaine pour l’inspection des infrastructures s’appuie sur des normes et des recherches provenant de multiples disciplines.
Fondements de l’apprentissage automatique : Ganin et al., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), l’article canonique DANN introduisant le renversement de gradient. Long et al., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), introduisant l’alignement de domaine multi-couche basé sur MMD. Sun et Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), introduisant l’alignement basé sur la covariance. Ben-David et al., “A theory of learning from different domains” (Machine Learning, 2010), le cadre théorique pour les bornes de généralisation de l’adaptation de domaine.
Adaptation de domaine pour l’inspection des infrastructures : Liu et al., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), la référence principale pour l’adaptation de domaine de la détection de fissures avec une architecture à deux branches à poids partagés. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), alignement de caractéristiques multi-niveaux pour la détection de fissures inter-jeux de données. Wang, Nguyen, Eick et al., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), framework à trois modules d’écart pour la corrosion des infrastructures.
Normes OACI et FAA : Annexe 14 de l’OACI, Aérodromes, Volume I (8e édition, 2018 avec amendements), norme internationale principale pour la certification des aérodromes, créant le contexte de décalage de domaine entre les aéroports. Doc 9137 de l’OACI, Partie 9, Manuel des Services d’Aéroport, Pratiques de Maintenance des Aéroports, guide de maintenance des chaussées. Format de Rapport Global (GRF) de l’OACI pour les Conditions de Surface de Piste (effectif novembre 2021), définissant les domaines de conditions de surface (sec, mouillé, contaminé). FAA AC 150/5380-6C, Lignes Directrices et Procédures pour l’Entretien des Chaussées d’Aéroport. ASTM D5340, Méthode d’Essai Normale pour les Relevés d’Indice de Condition de Chaussée d’Aéroport, le cadre quantitatif pour l’évaluation de l’état de la chaussée que les modèles adaptés au domaine doivent soutenir.
Jeux de données de chaussée : CQU-BPDD (Université de Chongqing, 60 088 images de fissures de chaussée en asphalte). RDD2020 (8 300+ images routières d’Inde, du Japon, de la République tchèque). Crack500 (500 images haute résolution de fissures de chaussée). SDNET2018 (56 000 images de tabliers de ponts, murs et chaussées de l’Utah State University). Ces jeux de données fournissent les benchmarks standardisés pour l’évaluation de l’adaptation de domaine dans l’inspection des chaussées.
Foire aux questions
- Qu'est-ce que l'adaptation de domaine en apprentissage automatique ?
- L'adaptation de domaine est un sous-domaine de l'apprentissage par transfert qui aborde le problème du décalage de domaine, où un modèle entraîné sur un jeu de données source fonctionne mal lorsqu'il est déployé sur un jeu de données cible avec des propriétés statistiques différentes. L'objectif est d'apprendre des représentations de caractéristiques invariantes de domaine afin que le modèle généralise à travers les domaines sans nécessiter de réentraînement complet sur des données cibles étiquetées. L'adaptation de domaine est catégorisée en variantes supervisée (données cibles étiquetées limitées disponibles), non supervisée (aucune donnée cible étiquetée) et semi-supervisée (quelques données cibles étiquetées plus non étiquetées).
- Comment le décalage de domaine affecte-t-il les modèles de détection de fissures de chaussée ?
- Le décalage de domaine dans la détection de fissures de chaussée provoque des baisses de performance de 30 à 45 % de l'Intersection sur Union moyenne (mIoU) lors du passage d'un jeu de données à un autre. Les sources de décalage incluent les différences de matériau de surface (asphalte vs béton), la variation de la morphologie des fissures (fissures longitudinales vs en peau de crocodile), les changements des conditions d'imagerie (angle d'éclairage, résolution, capteur de caméra) et les facteurs géographiques (différents types de granulats et motifs de vieillissement). Par exemple, un modèle entraîné sur le jeu de données CQU-BPDD obtient 0,72 mIoU sur les données de test source mais chute à 0,31 lorsqu'il est testé sur les données cibles RDD2020 sans adaptation.
- Quelle est la différence entre l'apprentissage par transfert et l'adaptation de domaine ?
- L'apprentissage par transfert adapte un modèle pré-entraîné sur une tâche pour effectuer une tâche différente, par exemple, affiner un modèle de classification ImageNet pour la détection de fissures. L'adaptation de domaine aborde la même tâche à travers différentes distributions de données, par exemple, adapter un détecteur de fissures sur asphalte pour détecter les fissures sur surfaces en béton. Dans l'apprentissage par transfert, les tâches source et cible peuvent différer, tandis que dans l'adaptation de domaine, la tâche est identique mais les distributions d'entrée diffèrent.
- Que sont les caractéristiques invariantes de domaine ?
- Les caractéristiques invariantes de domaine sont des représentations extraites par un réseau de neurones qui ont la même distribution statistique quel que soit le domaine d'origine de l'entrée. Si un réseau de détection de fissures apprend des caractéristiques qui se ressemblent, que l'entrée soit une image de route asphaltée ou de piste en béton, ces caractéristiques sont invariantes de domaine. Elles sont apprises via un entraînement contradictoire (un discriminateur de domaine ne peut pas dire de quel domaine proviennent les caractéristiques), l'appariement de moments statistiques (MMD, CORAL) ou des techniques de transport optimal. Le défi fondamental est le compromis invariance-discriminabilité : forcer les caractéristiques à être trop invariantes de domaine peut supprimer des informations pertinentes pour la tâche, comme la texture de la fissure qui est corrélée au type de surface.
- Comment fonctionne l'adaptation de domaine non supervisée ?
- L'adaptation de domaine non supervisée (UDA) utilise des données source étiquetées et des données cibles non étiquetées pour entraîner un modèle qui généralise au domaine cible. Les trois principales approches sont : (1) les méthodes contradictoires comme DANN, où un discriminateur de domaine essaie d'identifier de quel domaine proviennent les caractéristiques tandis que l'extracteur de caractéristiques essaie de le tromper, (2) les méthodes basées sur l'écart comme DeepCORAL et DAN, qui minimisent les mesures de distance statistique (MMD, différence de covariance) entre les distributions de caractéristiques source et cible, et (3) les méthodes basées sur la reconstruction qui utilisent des autoencodeurs ou des GAN pour apprendre des représentations partagées.
- Quels défis existent lors de l'adaptation de l'inspection routière à l'inspection des pistes ?
- L'adaptation de domaine route-vers-piste fait face à des différences fondamentales dans le matériau de surface (asphalte vs béton PCC à haute résistance), les caractéristiques de charge (essieux de véhicules de 10 tonnes vs charges d'aéronefs de 50 à 400 tonnes), les types de défauts (dépôts de caoutchouc, érosion par jet, dommages dus au carburant sur les pistes), l'accès à l'inspection (routes publiques vs côté piste restreint), les méthodes de capture d'images (véhicules au sol vs UAV à 30–100 m d'altitude) et la conformité réglementaire (normes de l'Annexe 14 de l'OACI). L'interférence des dépôts de caoutchouc est particulièrement difficile : le caoutchouc des pneus s'accumule sous forme de taches sombres sur les pistes qui peuvent imiter ou masquer les fissures, une condition que les modèles routiers ne rencontrent jamais.
- Qu'est-ce que le Réseau de Neurones Contradictoire de Domaine (DANN) ?
- Le Réseau de Neurones Contradictoire de Domaine (DANN), introduit par Ganin et Lempitsky en 2015, est l'architecture canonique pour l'adaptation de domaine contradictoire. Il se compose de trois composants : un extracteur de caractéristiques qui mappe les entrées dans un espace de caractéristiques partagé, un prédicteur d'étiquettes qui effectue la tâche (par exemple, la classification de fissures) et un classificateur de domaine qui prédit à quel domaine appartient l'entrée. Une Couche de Renversement de Gradient (GRL) se trouve entre l'extracteur de caractéristiques et le classificateur de domaine. Lors de la rétropropagation, elle inverse le signe du gradient, ce qui amène l'extracteur de caractéristiques à apprendre des caractéristiques qui maximisent la confusion de domaine. La perte globale combine la perte de tâche sur les étiquettes source moins la perte de classification de domaine, pondérée par un hyperparamètre lambda.
- Quelles stratégies d'adaptation de domaine conviennent à différentes quantités de données cibles ?
- La stratégie suit la quantité de données cibles disponibles. L'ajustement complet convient aux quantités modérées de données cibles étiquetées, l'ajustement de la dernière couche ou basé sur des adaptateurs convient aux données étiquetées très limitées, et l'adaptation non supervisée utilisant les statistiques de normalisation par lots et l'alignement des caractéristiques est utilisée lorsqu'aucune étiquette cible n'existe. Le dégel progressif et l'augmentation adaptée aux conditions d'imagerie cibles aident le modèle adapté à conserver ce qu'il a appris du domaine source.
- Qu'est-ce que la Divergence Maximale Moyenne (MMD) ?
- La Divergence Maximale Moyenne (MMD) est un test statistique basé sur un noyau utilisé pour mesurer la distance entre deux distributions de probabilité dans un Espace de Hilbert à Noyau Reproduisant (RKHS). Dans l'adaptation de domaine, la MMD est utilisée comme fonction de perte pour minimiser l'écart de distribution entre les représentations de caractéristiques source et cible. La formule MMD calcule la norme de la différence entre les plongements moyens des caractéristiques source et cible dans le RKHS. Les Réseaux d'Adaptation Profonde (DAN) et les Réseaux d'Adaptation Conjointe (JAN) intègrent la perte MMD à plusieurs couches du réseau pour réaliser un alignement de domaine à plusieurs niveaux.
- Quelles normes de l'OACI concernent l'adaptation de domaine pour l'inspection des pistes ?
- L'Annexe 14 de l'OACI établit des normes pour la conception et l'exploitation des aérodromes qui créent un besoin naturel d'adaptation de domaine : différents aéroports ont différents matériaux de chaussée, climats et historiques de maintenance, donc les modèles d'inspection doivent s'adapter entre les aéroports. Le Format de Rapport Global (GRF) définit les catégories d'état de surface de piste (sèche, mouillée, mouillée glissante, contaminée) qui représentent des domaines visuels distincts. Le Doc 9137 Partie 9 de l'OACI et l'AC 150/5380-6C de la FAA fournissent des conseils de maintenance. Lors du déploiement de l'inspection basée sur l'IA dans les aéroports, l'adaptation de domaine est essentielle car un modèle entraîné sur les données d'un aéroport rencontrera un éclairage, un âge de chaussée et des morphologies de défauts différents dans un autre.
Ceci est une entrée de référence. TarmacView fournit des services d'inspection par drone et ne vend pas l'équipement ou les matériaux décrits dans ce glossaire.