Was ist Domain Adaptation für oberflächenübergreifende Inspektionsmodelle?
Domain Adaptation für oberflächenübergreifende Inspektionsmodelle: Vollständiger technischer Leitfaden
Definition und das Problem des Domain Shift
Domain Adaptation ist eine Unterkategorie des Transfer Learnings, die eine grundlegende Herausforderung beim Einsatz von Modellen des maschinellen Lernens adressiert: die statistische Diskrepanz zwischen Trainingsdaten und Einsatzdaten. Wenn ein Modell, das auf einer Quelldomäne trainiert wurde – einem Datensatz mit bekannten Eigenschaften und typischerweise zahlreichen beschrifteten Beispielen – auf einer Zieldomäne mit anderen statistischen Eigenschaften eingesetzt wird, verschlechtert sich die Leistung. Domain Adaptation bietet Methoden, um diese Lücke zu überbrücken und Modellen zu ermöglichen, über Domänen hinweg zu generalisieren, ohne für jede Einsatzumgebung große neue Datensätze sammeln und beschriften zu müssen.
Formal wird eine Domäne als ein Paar definiert, bestehend aus einem Merkmalsraum (X) und einer Wahrscheinlichkeitsverteilung (P(X)) über diesen Raum: (D = {X, P(X)}). Eine Aufgabe ist ein Paar, bestehend aus einem Labelraum (Y) und einer Vorhersagefunktion (f: X \to Y). Die Quelldomäne (D_S) ist die Domäne, auf der das Modell ursprünglich mit zahlreichen beschrifteten Daten trainiert wird. Die Zieldomäne (D_T) ist die neue Domäne, in der das Modell arbeiten muss, oft mit begrenzten oder keinen Labels. Das Ziel der Domain Adaptation ist es, eine Funktion (f_T: X_T \to Y_T) für die Zieldomäne zu lernen, indem Wissen aus der Quelldomäne genutzt wird, trotz der Diskrepanz (P_S(X) \neq P_T(X)).
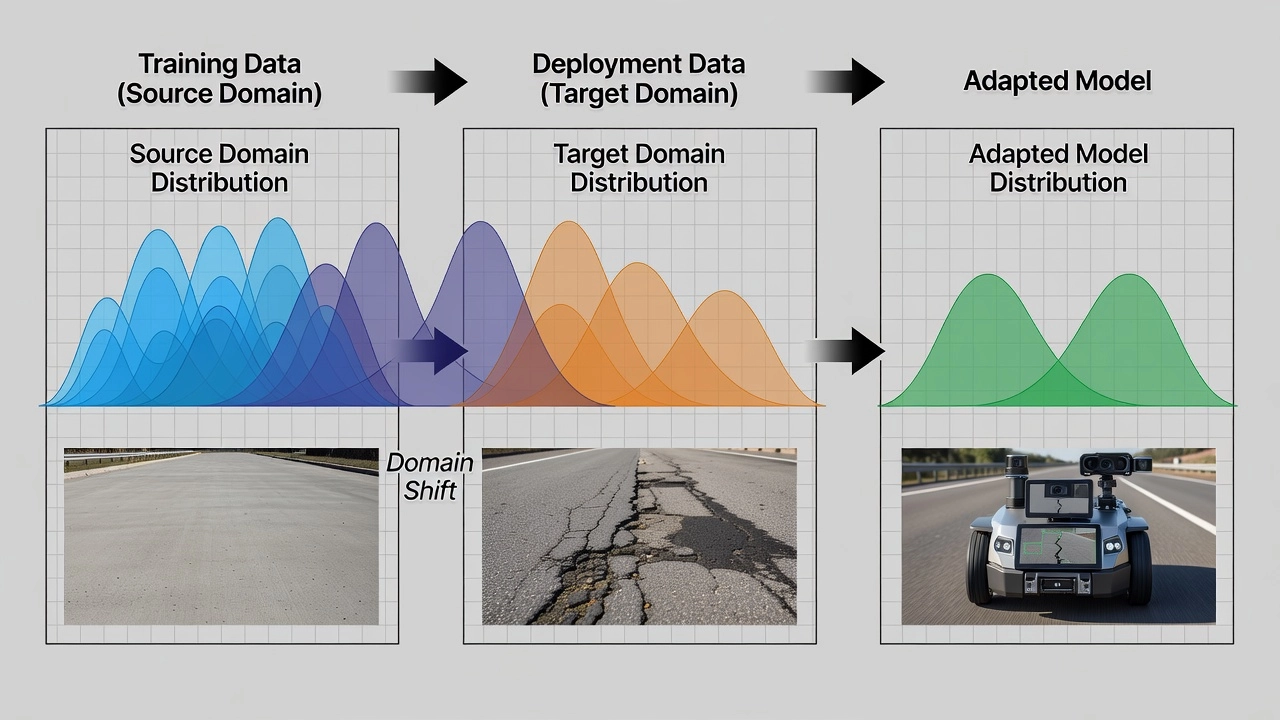
Domain Shift (auch Verteilungsverschiebung oder Datensatzverschiebung genannt) ist das Phänomen, bei dem sich die Datenverteilung zwischen Trainings- und Einsatzumgebungen unterscheidet. Wenn ein Domain Shift auftritt, verschlechtert sich die Modellleistung, da die gelernte Abbildung von Eingaben auf Ausgaben nicht mehr mit den Zielbedingungen übereinstimmt. Domain Shift manifestiert sich in drei Hauptformen. Kovariatverschiebung tritt auf, wenn sich die Verteilung der Eingabemerkmale ändert, während die bedingte Verteilung der Labels bei gegebenen Eingaben gleich bleibt: formal (P_S(X) \neq P_T(X)) aber (P_S(Y|X) = P_T(Y|X)). Dies ist die häufigste Form in der Computer Vision: Das visuelle Erscheinungsbild eines Risses auf Asphalt unterscheidet sich von dem auf Beton, aber die Abbildung von visuellen Merkmalen auf das Label „gerissen“ bleibt konsistent. Labelverschiebung (oder Priorverschiebung) tritt auf, wenn sich die Verteilung der Klassenlabels ändert: (P_S(Y) \neq P_T(Y)) aber (P_S(X|Y) = P_T(X|Y)). Dies geschieht, wenn sich die Rissdichte zwischen Trainings- und Einsatzorten unterscheidet. Konzeptverschiebung tritt auf, wenn sich die Beziehung zwischen Eingaben und Ausgaben ändert: (P_S(Y|X) \neq P_T(Y|X)), zum Beispiel wenn ein visuelles Muster, das auf einen versiegelten Riss auf Straßen hinweist, auf Startbahnen auf einen strukturellen Schaden hinweist.
Für die Computer Vision in der Infrastrukturinspektion entsteht Domain Shift durch mehrere sich überlagernde Faktoren. Visuelle Erscheinungsbildunterschiede umfassen Belagstextur (rauer Asphalt vs. glatter Beton), Farbprofile (dunkelgrauer Asphalt vs. hellgrauer Beton) und Alterungsmuster (oxidierte Oberfläche vs. frisch verlegt). Aufnahmebedingungen wie Beleuchtung (direktes Sonnenlicht in 60°-Winkel vs. diffuses Licht bei Bewölkung), Kameraauflösung und spektrale Empfindlichkeit des Sensors sowie Bildaufnahmewinkel (Nadir von UAV vs. schräg von Fahrzeug) tragen alle zu erheblichen Verteilungsverschiebungen bei. Umweltfaktoren wie nasse vs. trockene Oberflächen, Schattenverdeckung durch Bauwerke und saisonaler Schmutz (Blätter, Schnee, stehendes Wasser) verschärfen das Problem zusätzlich. Oberflächenmaterialunterschiede zwischen Asphalt und Beton oder zwischen gealterten und frisch verlegten Oberflächen stellen eine der größten Herausforderungen für Domain Shift bei Belagsinspektionsmodellen dar.
Die Forschung hat die Schwere des Domain Shift in der Risserkennung von Belägen quantitativ dokumentiert. Das DDACRN-Framework berichtete, dass ohne Domain Adaptation der mittlere Intersection over Union (mIoU) der Risserkennung von 0,72 auf Quelldaten auf 0,31 auf datensatzübergreifenden Zieldaten fällt – eine Leistungsminderung von 57 %. DACrack zeigte, dass die Abschwächung des Domain Shift durch mehrstufige Merkmalsausrichtung etwa 20 Prozentpunkte im F1-Score bei datensatzübergreifenden Übertragungen zurückgewinnt. Diese empirischen Ergebnisse unterstreichen, warum Domain Adaptation nicht nur eine akademische Verfeinerung ist, sondern eine betriebliche Notwendigkeit für jedes Inspektionssystem, das über mehrere Flughäfen, Straßen oder Brückennetze hinweg eingesetzt wird.
Domain Shift in der Infrastrukturbildgebung
Infrastrukturinspektionsbilder unterliegen mehreren interagierenden Quellen von Domain Shift, die sich gegenseitig verstärken. Das Verständnis jeder Quelle ist für die Entwicklung effektiver Anpassungsstrategien unerlässlich.
Oberflächenmaterialverschiebung ist der prominenteste Domain Shift in der Infrastrukturinspektion. Asphalt- und Betonbeläge haben grundlegend unterschiedliche visuelle Eigenschaften. Asphalt ist dunkelgrau bis schwarz, hat eine grobe und unregelmäßige Oberflächentextur, und Risse erscheinen typischerweise als helle lineare Merkmale vor dem dunklen Hintergrund. Beton ist hellgrau bis weiß, hat eine glattere und gleichmäßigere Oberfläche, und Risse erscheinen als dunkle Linien. Diese Unterschiede bedeuten, dass ein Convolutional Neural Network, das auf einer Oberflächenart trainiert wurde, Filter und Merkmalsrepräsentationen lernt, die für die visuelle Statistik dieser Oberfläche spezifisch sind. Wenn es auf die andere Oberflächenart angewendet wird, erzeugen diese Filter Merkmalsaktivierungen, die die Klassifikatorschichten nicht korrekt interpretieren können. Daten von DDACRN zeigen, dass der oberflächenübergreifende mIoU ohne Anpassung von 0,72 auf 0,31 fällt, wenn Modelle von Asphalt auf Beton übertragen werden.
Rissmorphologievariation führt eine weitere Ebene des Domain Shift ein. Verschiedene Belagsschadensarten haben unterschiedliche visuelle Signaturen. Längsrisse verlaufen parallel zur Belagsmitte und erscheinen als lange, durchgehende lineare Merkmale. Querrisse verlaufen senkrecht zur Mitte. Netzrisse (Ermüdungsrisse) bilden miteinander verbundene Netzwerke kleiner Polygone, die an Krokodilhaut erinnern. Haarrisse sind weniger als 1 mm breit und möglicherweise kaum sichtbar, während breite Risse 5 mm überschreiten und leicht identifizierbar sind. Mit Dichtungsmasse gefüllte Risse haben ein anderes visuelles Erscheinungsbild als unversiegelte Risse. Ein Modell, das überwiegend auf Längsrissen trainiert wurde, kann Netzrisse in einer Zieldomäne, in der diese Schadensart häufiger vorkommt, möglicherweise nicht erkennen.
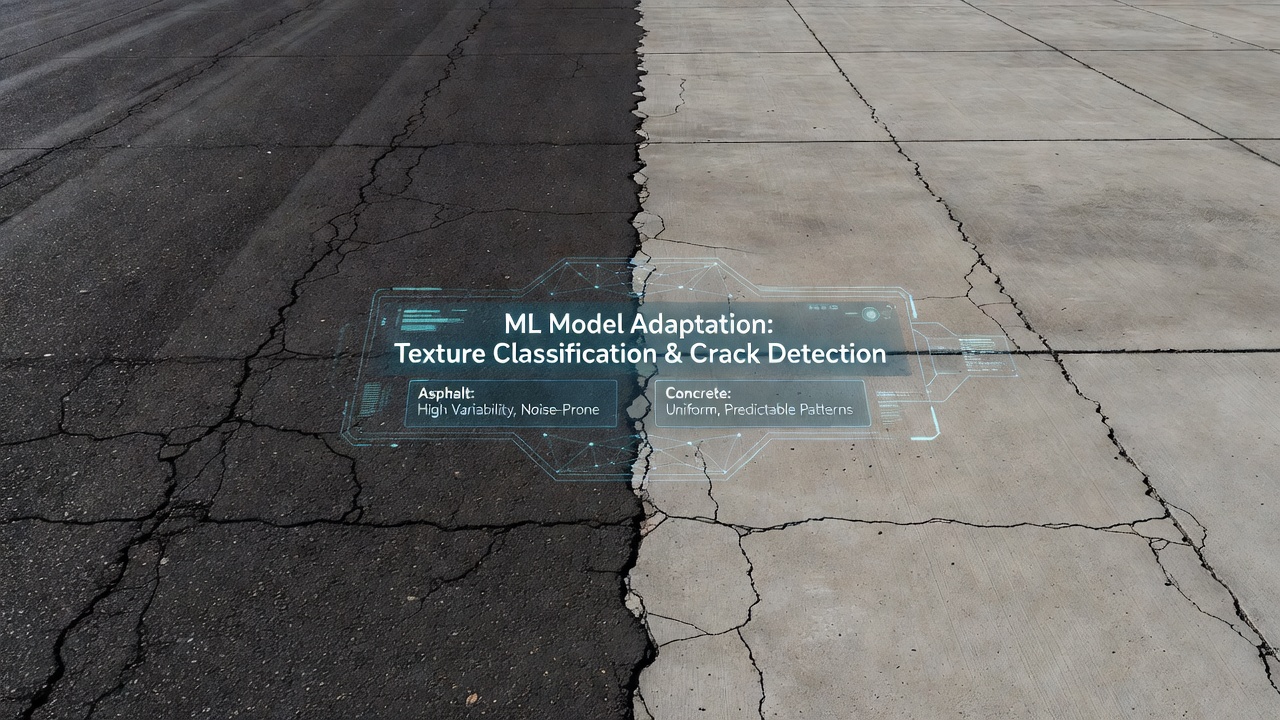
Beleuchtungsbedingungsverschiebung beeinflusst die Modellleistung erheblich. Modelle, die auf gut beleuchteten Tagesbildern unter direktem Sonnenlicht trainiert wurden, versagen bei Bildern mit wenig Licht oder in der Dämmerung, Bildern mit harten Schatten von Bauwerken oder Bäumen und Bildern unter bewölkten Bedingungen, bei denen diffuses Licht den Kontrast verringert. Der Winkel des einfallenden Lichts relativ zur Oberflächennormalen verändert das Erscheinungsbild von Risskanten: Flaches Sonnenlicht betont die Oberflächentextur, indem es Schatten in Risse wirft, während hochstehendes Sonnenlicht die Rissichtbarkeit minimiert. Schattenverdeckung durch Brückenüberbauten, Flughafenterminals oder nahegelegene Bauwerke erzeugt lokalisierte dunkle Bereiche, in denen Rissmerkmale unterdrückt werden. Studien haben Genauigkeitseinbußen von 5–12 % für Risserkennungsmodelle dokumentiert, wenn sich die Beleuchtungsbedingungen von der Trainingsverteilung unterscheiden.
Kamera- und Sensorverschiebung entsteht durch Unterschiede in der Bildaufnahmehardware. Verschiedene Kameras erzeugen unterschiedliche Bildauflösungen (12 MP Smartphone vs. 50 MP DSLR vs. spezielle Industriekamera), unterschiedliche Farbprofile und spektrale Empfindlichkeitskurven des Sensors, unterschiedliche Linsenverzerrungseigenschaften und unterschiedliche Rauschmuster. Bei der UAV-basierten Inspektion bestimmt die Flughöhe den Ground Sampling Distance (GSD), die physikalische Entfernung auf dem Boden, die jedes Pixel repräsentiert. Ein UAV, das in 30 m Höhe fliegt, erzeugt etwa 0,5–1 cm/Pixel GSD, während eines in 100 m Höhe 2–5 cm/Pixel erzeugt. Unterschiede im GSD bedeuten, dass derselbe Riss durch eine unterschiedliche Anzahl von Pixeln und unterschiedliche räumliche Frequenzinhalte in Quell- und Zieldomäne repräsentiert wird. Die Feinabstimmung mit Batch-Normalisierungsstatistiken (BN) ist oft ausreichend für moderate Kameraverschiebungen, während starke Verschiebungen eine adversarielle Domänenausrichtung auf mehreren Merkmalsebenen erfordern.
Saisonale und umweltbedingte Verschiebung führt zeitliche Domänenvariation ein. Ein auf Sommerbildern trainiertes Modell muss im Winter funktionieren, wenn Oberflächen nass, schneebedeckt oder teilweise durch Laub verdeckt sein können. Belagsoberflächen altern und oxidieren im Laufe der Zeit, was ihre Farbe und Textur verändert. Das Global Reporting Format (GRF) der FAA und ICAO erkennt Umweltbedingungen explizit als Variable an, die die Beurteilung der Startbahnoberfläche beeinflusst: trockene, nasse, rutschig nasse und kontaminierte Oberflächen stellen jeweils unterschiedliche visuelle Domänen dar, die eine unterschiedliche Inspektionsinterpretation erfordern.
| Domain-Shift-Quelle | Typische Leistungsauswirkung | Primäre Minderungsstrategie |
|---|---|---|
| Oberflächenmaterial (Asphalt vs. Beton) | 30–45 % mIoU-Abfall | Adversarielle DA + mehrstufige Merkmalsausrichtung |
| Beleuchtungsbedingung (sonnig vs. bewölkt) | 5–12 % Genauigkeitsabfall | BN-Adaptation + photometrische Augmentierung |
| Kameraauflösung / Sensor | 3–8 % Genauigkeitsabfall | Feinabstimmung + BN-Statistik-Neuberechnung |
| Saisonal / Umweltbedingt | 8–20 % Genauigkeitsabfall | Generative Domänenübersetzung (CycleGAN) |
| Geografisch / Regional | 10–25 % Genauigkeitsabfall | Multi-Source UDA + progressive Domänenüberbrückung |
Feinabstimmung für Domain Adaptation
Feinabstimmung ist die einfachste und am weitesten verbreitete Domain-Adaptation-Strategie. Dabei wird ein auf der Quelldomäne vortrainiertes neuronales Netz genommen und der Trainingsprozess auf Zieldomänendaten fortgesetzt, wobei die Gewichte des Modells aktualisiert werden, um seine Repräsentationen an die Zielverteilung anzupassen. Die Feinabstimmung überbrückt die Lücke zwischen Transfer Learning (bei dem sich die Aufgabe ändert) und Domain Adaptation (bei dem die Aufgabe gleich bleibt, sich aber die Datenverteilung ändert).
Die theoretische Grundlage der Feinabstimmung beruht auf der Beobachtung, dass neuronale Netze hierarchische Merkmalsrepräsentationen lernen. Frühe Schichten erfassen niedrigstufige Merkmale wie Kanten, Texturen und Farbkleckse, die weitgehend domänenunabhängig sind. Mittlere Schichten kombinieren diese zu mittelstufigen Mustern wie Risskanten, Oberflächenkörnungen und Fugenrändern. Späte Schichten lernen aufgabenspezifische Merkmale, die für das Klassifikations- oder Segmentierungsziel optimiert sind. Wenn sich die Domäne verschiebt, ändern sich die niedrigstufigen Statistiken (Farbverteilungen, Texturfrequenzen, Kontrasteigenschaften), und die späteren Schichten, die auf die Merkmalsverteilungen der Quelldomäne feinabgestimmt sind, verlieren ihre Ausrichtung.
Vollständige Feinabstimmung aktualisiert alle Modellparameter auf Zieldaten. Dies ist geeignet, wenn reichlich beschriftete Zieldaten verfügbar sind (Hunderte bis Tausende von Bildern) und die Rechenressourcen vollständige Gradientenaktualisierungen zulassen. Die Lernrate wird typischerweise um den Faktor 10 im Vergleich zum anfänglichen Vortraining reduziert, um katastrophales Vergessen zu verhindern, das Phänomen, bei dem das Modell nützliches Wissen aus der Quelldomäne überschreibt. Frühes Stoppen basierend auf dem Zielvalidierungsverlust ist unerlässlich, um die Beibehaltung von Quellwissen mit der Zielanpassung in Einklang zu bringen.
Letzte-Schicht-Abstimmung (Klassifikator) friert alle Merkmalsextraktionsschichten ein und trainiert nur den endgültigen Klassifikations- oder Segmentierungskopf. Dieser Ansatz geht davon aus, dass der auf der Quelldomäne gelernte Merkmalsextraktor ausreichend allgemeine Repräsentationen erzeugt und nur die Abbildung von Merkmalen auf Labels angepasst werden muss. Die letzte-Schicht-Abstimmung ist effektiv, wenn nur sehr begrenzte Zieldaten verfügbar sind (Zehner von Bildern) und der Domain Shift hauptsächlich im Labelraum und nicht im Merkmalsraum liegt. Sie erfordert minimale Rechenleistung und ist resistent gegen katastrophales Vergessen.
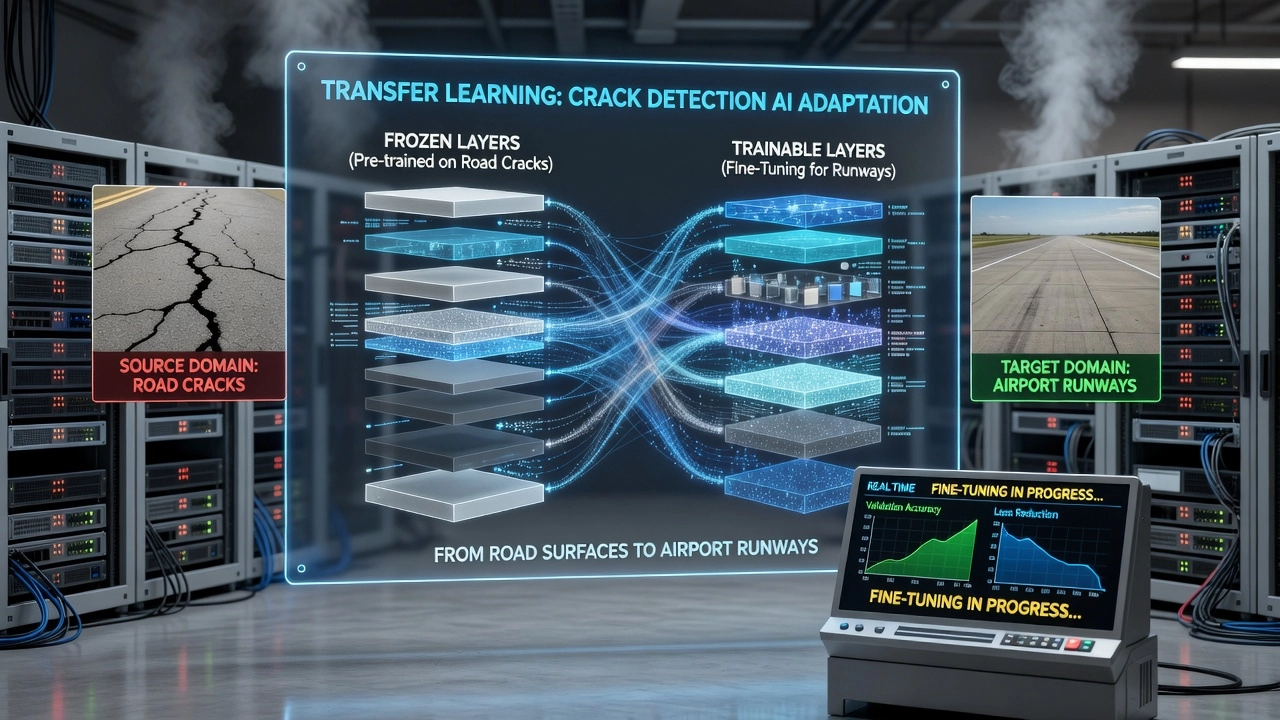
Progressives Auftauen bietet einen Mittelweg. Der Trainingsprozess beginnt mit allen eingefrorenen Schichten außer dem endgültigen Klassifikator, der für mehrere Epochen trainiert wird. Dann werden die obersten Merkmalsextraktionsschichten aufgetaut und zusammen mit dem Klassifikator trainiert. Dieser Prozess wird fortgesetzt, wobei die Schichten schrittweise von oben nach unten aufgetaut werden, bis alle Schichten feinabgestimmt sind oder ein Leistungsplateau erreicht ist. Progressives Auftauen eignet sich für moderate Mengen an Zieldaten (Hunderte von Bildern) und Domain Shifts, die mehrere Ebenen der Merkmalshierarchie betreffen.
Adapter-Module führen kleine Engpassschichten mit deutlich weniger Parametern als das gesamte Netzwerk ein. Diese Adapter werden zwischen die Schichten eines eingefrorenen vortrainierten Rückgrats eingefügt und sind die einzigen Parameter, die während der Feinabstimmung aktualisiert werden. Die Adapter-basierte Feinabstimmung ist äußerst parametereffizient, typischerweise 1–5 % der Gesamtparameterzahl, und ermöglicht ein schnelles Umschalten zwischen mehreren Zieldomänen durch Speichern und Laden verschiedener Adaptergewichte. Für Infrastrukturinspektionsnetzwerke mit Millionen von Parametern ermöglichen Adapter-Module den Einsatz auf Dutzenden von Flughäfen, ohne für jeden separate vollständige Gewichtskopien speichern zu müssen.
Batch-Normalisierungs-Adaptation (BN) ist eine bemerkenswert leichte und dennoch effektive Technik. BN-Schichten berechnen während des Trainings laufende Mittelwert- und Varianzstatistiken, um Zwischenmerkmalskarten zu normalisieren. Wenn sich die Domäne verschiebt, repräsentieren diese Statistiken die Zielverteilung nicht mehr genau. Die BN-Adaptation berechnet einfach die BN-Statistiken neu, indem Zieldomänendaten mit eingefrorenen Gewichten durch das Netzwerk geleitet werden, wobei die laufenden Mittelwerte und Varianzen ohne Gradientenaktualisierungen aktualisiert werden. Dies allein kann den Domain Shift erheblich reduzieren, wenn der Hauptunterschied in niedrigstufigen Bildstatistiken wie Helligkeit, Kontrast und Farbverteilung liegt. Studien zur Risserkennung zeigen, dass die BN-Adaptation 3–8 % der Genauigkeitseinbußen durch moderate Beleuchtungs- und Kameraverschiebungen zurückgewinnt und nur einen einzigen Vorwärtsdurchlauf unbeschrifteter Zieldaten erfordert.
| Feinabstimmungsstrategie | Erforderliche Zieldaten | Aktualisierte Parameter | Risiko des katastrophalen Vergessens | Bester Anwendungsfall |
|---|---|---|---|---|
| BN-Statistik-Neuberechnung | Keine (unbeschriftet) | 0 (nur BN-Statistiken) | Keines | Beleuchtungs-/Kameraverschiebungen |
| Letzte-Schicht-Abstimmung | 10–50 beschriftet | < 1 % | Sehr gering | Merkmalsverteilung erhalten |
| Adapter-Module | 50–200 beschriftet | 1–5 % | Gering | Multi-Domänen-Einsatz |
| Progressives Auftauen | 100–500 beschriftet | Schrittweise, 10–100 % | Moderat | Moderater Domain Shift |
| Vollständige Feinabstimmung | 500+ beschriftet | 100 % | Hoch | Reichlich Zieldaten, großer Shift |
Überwachte Domain Adaptation
Überwachte Domain Adaptation (SDA) arbeitet unter der Annahme, dass eine kleine Menge beschrifteter Daten in der Zieldomäne zusammen mit reichlich beschrifteten Quelldaten verfügbar ist. Dies ist die einfachste Umgebung: Das Modell hat direkten Zugriff auf Ground-Truth-Informationen über die Zieldomäne, was eine explizite Optimierung für die Zielleistung ermöglicht.
Der Standard-SDA-Ansatz hat zwei Komponenten. Zunächst wird das Modell auf der Quelldomäne mit ihren reichlich vorhandenen Labels vortrainiert. Dies etabliert allgemeines Wissen über die Inspektionsaufgabe. Es lernt, Risskanten, Fugenränder, Oberflächentexturen und Schadensgeometrien zu erkennen. Zweitens wird das Modell mit einer deutlich reduzierten Lernrate auf den beschrifteten Zieldaten feinabgestimmt. Während der Feinabstimmung kombiniert die Verlustfunktion typischerweise Quell- und Zielverluste, um zu verhindern, dass das Modell nützliches Wissen aus der Quelldomäne vergisst. Der kombinierte Verlust wird ausgedrückt als:
(\mathcal{L}_{\text{SDA}} = \mathcal{L}_S(\theta) + \lambda \mathcal{L}_T(\theta))
wobei (\mathcal{L}_S) der Quellverlust ist, der auf Quelldaten berechnet wird, (\mathcal{L}_T) der Zielverlust, der auf beschrifteten Zieldaten berechnet wird, und (\lambda) den relativen Beitrag jeder Domäne steuert. Während des Trainings werden Quell- und Zielbatches abwechselnd oder gemeinsam durch das Netzwerk geleitet.
Schlüsseltechniken für überwachte Domain Adaptation umfassen gewichtete Verlustfunktionen, die Ziel-Domänen-Stichproben während der Feinabstimmung eine höhere Bedeutung beimessen, gemeinsames Training, bei dem beschriftete Quell- und Zieldaten in jedem Trainingsbatch gemischt werden, und adversarielles Domänentraining, bei dem selbst in der überwachten Umgebung ein Domänenklassifikator hinzugefügt wird, um den Merkmalsextraktor zu ermutigen, domäneninvariante Repräsentationen zu lernen. Curriculum-Learning-Strategien beginnen mit quellendominiertem Training und verschieben das Gleichgewicht im Laufe des Trainings schrittweise in Richtung Zieldaten.
Parameterübertragung, bei der die Gewichte des quellentrainierten Modells als Initialisierung dienen, ist die dominierende Strategie in SDA. Der Erfolg dieses Ansatzes hängt vom Grad der Verwandtschaft zwischen Quell- und Zieldomäne ab. Wenn die Domänen eng verwandt sind (z. B. verschiedene Abschnitte desselben Flughafenbelags), reichen sehr wenige beschriftete Zielbeispiele aus. Bereits 20–50 Bilder können den größten Teil der durch Domain Shift verlorenen Leistung wiederherstellen. Wenn die Domänen weiter voneinander entfernt sind (z. B. Straße zu Startbahn), sind typischerweise 200–500 beschriftete Zielbeispiele für eine robuste Anpassung erforderlich.
Label-effiziente SDA-Techniken zielen darauf ab, die Anzahl der benötigten Ziellabels zu minimieren. Aktives Lernen identifiziert die informativsten Zielstichproben für die Beschriftung: Das Modell wird auf Quelldaten trainiert, auf unbeschriftete Zieldaten angewendet, und die Stichproben, bei denen es am unsichersten ist, werden zur menschlichen Beschriftung ausgewählt. Dieser Ansatz kann den Beschriftungsaufwand im Vergleich zur Zufallsstichprobe um 50–70 % reduzieren. Selbsttraining (oder Pseudo-Labeling) wendet das quellentrainierte Modell auf unbeschriftete Zieldaten an, generiert vorläufige Labels für Vorhersagen mit hoher Konfidenz und trainiert das Modell unter Verwendung dieser Pseudo-Labels als zusätzliche Aufsicht neu. Selbsttraining ist besonders effektiv in Kombination mit Konfidenzschwellenwertsetzung und Daten-Augmentierung.
Wann SDA verwendet werden sollte: wenn es machbar ist, einen kleinen beschrifteten Satz von jedem Ziel-Einsatzort zu erhalten. Für die Inspektion von Startbahnen bedeutet dies, dass ein geschulter Inspektor 50–200 Bilder pro Flughafen beschriften kann, ein einmaliger Aufwand von 1–4 Stunden pro Standort. Dies ist weitaus wirtschaftlicher als die Alternative, Tausende von Bildern pro Flughafen zu sammeln und zu beschriften, was mehrere Tage pro Standort erfordern würde. Die FAA AC 150/5380-6C empfiehlt regelmäßige PCI-Erhebungen, bei denen Inspektoren bereits Belagsoberflächen untersuchen. Dieselben Inspektoren können die wenigen hundert beschrifteten Bilder, die für SDA benötigt werden, als Teil ihres Standardinspektionsablaufs bereitstellen.
Unüberwachte Domain Adaptation
Unüberwachte Domain Adaptation (UDA) ist die anspruchsvollste und am aktivsten erforschte Domain-Adaptation-Umgebung. Sie geht davon aus, dass beschriftete Daten nur in der Quelldomäne existieren, während die Zieldomäne vollständig unbeschriftet ist. UDA ist das dominierende Szenario für die Infrastrukturinspektion, da die Beschriftung von Zieldomänendaten über viele Einsatzorte hinweg teuer, zeitaufwändig oder unpraktisch ist. Ein auf den Belagsbildern eines Flughafens trainiertes Modell muss sich an die Oberflächen, Beleuchtung und Schadensmuster eines anderen Flughafens anpassen, ohne dass jeder Flughafen einen beschrifteten Datensatz erstellen muss.
UDA-Methoden fallen in drei Hauptkategorien: adversarielle Methoden, diskrepanzbasierte Methoden und rekonstruktionsbasierte Methoden. Alle teilen das Kernziel, die Merkmalsverteilungen von Quelle und Ziel auszurichten, sodass ein auf Quellmerkmalen trainierter Klassifikator auf Zielmerkmale generalisiert.
Adversarielle Domain Adaptation
Adversarielle Domain Adaptation lässt sich von Generative Adversarial Networks (GANs) inspirieren. Die Kernidee besteht darin, einen Domänendiskriminator (einen binären Klassifikator, der vorhersagt, ob eine Merkmalsrepräsentation aus der Quell- oder Zieldomäne stammt) zusammen mit dem Merkmalsextraktor in einem Minimax-Spiel zu trainieren. Der Merkmalsextraktor versucht, Merkmale zu erzeugen, die zwischen Quelle und Ziel nicht unterscheidbar sind, während der Diskriminator versucht, die Herkunft jedes Merkmals korrekt zu identifizieren.
Die kanonische Architektur ist das Domain-Adversarial Neural Network (DANN), eingeführt von Yaroslav Ganin und Victor Lempitsky im Jahr 2015. DANN besteht aus drei Komponenten: einem Merkmalsextraktor (G_f), der Eingaben auf einen Merkmalsraum abbildet (f = G_f(x, \theta_f)), einem Label-Prädiktor (G_y), der Merkmale auf Aufgabenlabels abbildet (\hat{y} = G_y(f, \theta_y)), und einem Domänenklassifikator (G_d), der Merkmale auf Domänenlabels abbildet (\hat{d} = G_d(f, \theta_d)). Die entscheidende Innovation ist die Gradient Reversal Layer (GRL), die zwischen dem Merkmalsextraktor und dem Domänenklassifikator platziert ist. Während der Vorwärtspropagation fungiert die GRL als Identitätstransformation. Während der Rückwärtspropagation multipliziert sie den Gradienten mit (-\lambda), wobei (\lambda) ein Hyperparameter ist, der die Anpassungsstärke steuert. Diese Umkehrung bewirkt, dass der Merkmalsextraktor Merkmale lernt, die den Domänenklassifikationsverlust maximieren, und somit effektiv lernt, den Domänenklassifikator zu täuschen.
Die DANN-Verlustfunktion kombiniert den Aufgabenverlust auf Quell-Labels minus den Domänenklassifikationsverlust auf sowohl Quell- als auch Zielmerkmalen:
(\mathcal{L}(\theta_f, \theta_y, \theta_d) = \frac{1}{n_S}\sum_{x_i \in D_S} \mathcal{L}y(G_y(G_f(x_i)), y_i) - \frac{\lambda}{n_S + n_T}\sum{x_i \in D_S \cup D_T} \mathcal{L}_d(G_d(G_f(x_i)), d_i))
Im Laufe des Trainings lernt der Merkmalsextraktor Repräsentationen, die sowohl für die Aufgabe diskriminativ sind (da der Label-Prädiktor auf Quell-Labels trainiert wird) als auch domäneninvariant (da der Domänenklassifikator die Domänenherkunft nicht unterscheiden kann). Die GRL-Planung beginnt typischerweise mit (\lambda = 0) und erhöht sich allmählich auf einen Maximalwert über die ersten Epochen, sodass das Netzwerk seine Aufgabenleistung stabilisieren kann, bevor der Domänenverwirrungsdruck ausgeübt wird.
Jüngste Fortschritte bei der adversariellen Domain Adaptation umfassen Contrastive Adversarial Training (CAT), das beschriftete Quellstichproben nutzt, um die Merkmalstrennung zu verstärken und gleichzeitig die Domänenausrichtung beizubehalten, Collaborative and Adversarial Networks (CAN), die eine mehrstufige Domänenausrichtung auf verschiedenen Ebenen der Merkmalshierarchie durchführen, und Adversarial Style Discrepancy Minimization, das Stilübertragung als adversarielles Ziel verwendet. Für die Risserkennung in Belägen haben adversarielle Methoden die stärkste datensatzübergreifende Generalisierung gezeigt und 15–25 Prozentpunkte der durch Domain Shift verlorenen Leistung zurückgewonnen.
Diskrepanzbasierte Methoden
Diskrepanzbasierte Methoden verfolgen einen anderen Ansatz: Anstelle von adversariellem Training minimieren sie explizit ein statistisches Distanzmaß zwischen den Merkmalsverteilungen von Quelle und Ziel. Der Vorteil ist die Trainingsstabilität – keine adversarielle Dynamik, die eine sorgfältige Hyperparameter-Abstimmung erfordert –, allerdings auf Kosten einer potenziell schwächeren Ausrichtung.
Maximum Mean Discrepancy (MMD) ist das am weitesten verbreitete Diskrepanzmaß für Domain Adaptation. MMD ist ein kernelbasierter statistischer Test, der den Abstand zwischen zwei Verteilungen in einem Reproducing Kernel Hilbert Space (RKHS) misst. Gegeben Quellmerkmale (\mathbf{f}^S) und Zielmerkmale (\mathbf{f}^T) ist das quadrierte MMD:
(MMD^2(\mathbf{f}^S, \mathbf{f}^T) = \left|\frac{1}{n_S}\sum_{i=1}^{n_S}\phi(f_i^S) - \frac{1}{n_T}\sum_{j=1}^{n_T}\phi(f_j^T)\right|_{\mathcal{H}}^2)
wobei (\phi) die Merkmalsabbildung in den RKHS ist. In der Praxis wird das MMD unter Verwendung einer Kernelfunktion (k(x,y) = \langle \phi(x), \phi(y) \rangle) berechnet, typischerweise dem Gaußschen RBF-Kernel, oft mit mehreren Bandbreiten, um verschiedene Ebenen der Verteilungsähnlichkeit zu erfassen.
Deep Adaptation Networks (DAN), eingeführt von Long et al. im Jahr 2015, fügen den MMD-Verlust zu mehreren aufgabenspezifischen Schichten eines tiefen CNN hinzu. Der Gesamtverlust wird zu (\mathcal{L} = \mathcal{L}S + \lambda \sum{l \in L} MMD^2(\mathbf{f}_l^S, \mathbf{f}_l^T)), wobei (L) die Menge der Schichten ist, auf denen die Domänenausrichtung angewendet wird. DAN zeigte, dass die Ausrichtung von Merkmalsrepräsentationen auf höherer Ebene (und nicht nur der letzten Schicht) die Anpassungsqualität erheblich verbessert.
CORrelation ALignment (CORAL), eingeführt von Sun und Saenko im Jahr 2016, verfolgt einen einfacheren Ansatz, indem es die Differenz zwischen den Kovarianzmatrizen der Quell- und Zielmerkmale minimiert:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
wobei (C_S) und (C_T) die Kovarianzmatrizen der Merkmale von Quelle bzw. Ziel sind, (d) die Merkmalsdimension ist und (|\cdot|_F) die Frobenius-Norm ist. Deep CORAL erweitert dies auf tiefe Netzwerke, indem es den CORAL-Verlust zur Verlustfunktion des Netzwerks hinzufügt. CORAL ist recheneffizient und funktioniert gut, wenn der Domain Shift hauptsächlich in der Merkmalsvarianz und nicht im Mittelwert liegt.
Joint Adaptation Networks (JAN) erweitern DAN, indem sie die gemeinsamen Verteilungen mehrerer Schichten ausrichten, anstatt jede Schicht unabhängig zu behandeln. JAN verwendet Joint MMD (JMMD), definiert auf dem Tensorprodukt von Aktivierungen aus mehreren Schichten. Dies erfasst Abhängigkeiten zwischen den Schichten, die einzelne MMD-Verluste übersehen.
Jüngste Fortschritte für die Infrastrukturinspektion umfassen das Framework von Wang et al. (2025) für die Korrosionssegmentierung, das drei komplementäre Diskrepanzmodule kombiniert: Geometric Structure Preservation (GSP), das lokale topologische Beziehungen über Domänen hinweg unter Verwendung graphbasierter Regularisierung beibehält, SVD-based Local Discrepancy (SLD), das die Singulärwertzerlegung verwendet, um lokale Merkmalsunterräume auf einer feinkörnigen Ebene auszurichten, und Global Consistency Alignment (GCA), das MMD verwendet, um globale Verteilungsverschiebungen in Einklang zu bringen. Dieser kombinierte Ansatz, unterstützt durch das leichte EffSegNet-Segmentierungsrückgrat, erzielte eine starke domänenübergreifende Generalisierung von Labor-Korrosionsbildern zu Feldbedingungen an Schleusen, Dämmen und Verkehrsinfrastruktur.
Vergleich der UDA-Methoden
| Methode | Kategorie | Ausrichtungsmechanismus | Trainingsstabilität | Infrastrukturleistung |
|---|---|---|---|---|
| DANN | Adversariell | Gradientenumkehr + Domänenklassifikator | Moderat (erfordert Abstimmung von (\lambda)) | Stark (gewinnt 15–25 ppt mIoU zurück) |
| DAN | Diskrepanz | MMD auf mehreren Schichtausgaben | Hoch | Gut (gewinnt 10–20 ppt mIoU zurück) |
| Deep CORAL | Diskrepanz | Kovarianzausrichtung (Statistiken 2. Ordnung) | Hoch | Moderat (gewinnt 8–15 ppt mIoU zurück) |
| JAN | Diskrepanz | Joint MMD auf Schichtpaaren | Hoch | Gut (gewinnt 12–18 ppt mIoU zurück) |
| CycleGAN+Det | Generativ | Bild-zu-Bild-Übersetzung + Aufgabenmodell | Niedrig (GAN-Trainingsschwierigkeit) | Stark, wenn Bildübersetzung gelingt |
| CAT | Adversariell | Kontrastiv + adversariell | Moderat | Stark (State-of-the-Art auf mehreren Benchmarks) |
Lernen domäneninvarianter Merkmale
Domäneninvariante Merkmale sind Merkmalsrepräsentationen, die von einem neuronalen Netz erzeugt werden und unabhängig davon, aus welcher Domäne die Eingabe stammt, dieselbe statistische Verteilung aufweisen. Wenn (f(x)) die vom Netzwerk extrahierte Merkmalsrepräsentation ist, bedeutet Domäneninvarianz (P(f(X_S)) \approx P(f(X_T))). Das Ziel ist es, eine Abbildung (f) zu lernen, so dass der Abstand (d(P(f(X_S)), P(f(X_T)))) minimiert wird, während die aufgabenspezifische Diskriminationsfähigkeit erhalten bleibt.
Die vier Hauptansätze zum Lernen domäneninvarianter Merkmale handhaben den Invarianz-Diskriminierbarkeits-Kompromiss jeweils unterschiedlich. Adversarielles Lernen (DANN, GAN-basiert) drängt den Merkmalsextraktor dazu, Merkmale zu erzeugen, die ein Domänendiskriminator nicht unterscheiden kann. Dies ist der aggressivste Invarianzmechanismus, birgt jedoch das Risiko, aufgabenrelevante Informationen zu entfernen, wenn die Risstextur mit der Oberflächenart korreliert. Statistisches Moment-Matching (MMD, CORAL) gleicht Verteilungsmomente, erster Ordnung (Mittelwert) und zweiter Ordnung (Kovarianz), zwischen Quell- und Zielmerkmalen ab. Dies bewahrt mehr aufgabenrelevante Informationen als eine vollständige adversarielle Ausrichtung, erfasst jedoch möglicherweise keine Unterschiede in Verteilungen höherer Ordnung. Optimaler Transport (OT-basierte Methoden) findet eine minimal kostspielige Abbildung zwischen Quell- und Zielverteilungen und bietet eine geometrische Interpretation der Domänenausrichtung. Stilübertragung und generative Methoden (CycleGAN, StarGAN) transformieren Bilder von einer Domäne, um visuell einer anderen zu ähneln, bevor sie durch das Aufgabennetzwerk geleitet werden. Dies arbeitet auf Pixelebene und nicht auf Merkmalsebene und hat den Vorteil, interpretierbare transformierte Bilder zu erzeugen.
Der Invarianz-Diskriminierbarkeits-Kompromiss ist eine grundlegende Spannung beim Lernen domäneninvarianter Merkmale. Die Maximierung der Domäneninvarianz kann aufgabenrelevante Informationen entfernen, die mit der Domäne korrelieren. Wenn beispielsweise Risskanten auf Asphalt einen höheren Kontrast haben als auf Beton, wird ein Merkmalsdetektor, der auf die Kantenkontraststärke angewiesen ist, sowohl für das Vorhandensein von Rissen als auch für die Belagsart empfindlich sein. Das Erzwingen vollständiger Invarianz gegenüber der Belagsart kann die Kantenkontrastmerkmale unterdrücken, die für die Risserkennung benötigt werden. Fortgeschrittene Methoden adressieren dies durch mehrstufige Ausrichtung, die nur höherstufige semantische Merkmale ausrichtet, während niedrigstufige Texturhinweise erhalten bleiben, und bedingte Ausrichtung, die Verteilungen in Abhängigkeit vom Aufgabenlabel ausrichtet und so klassendiskriminative Informationen bewahrt.
Aufmerksamkeitsbasierte Domäneninvarianz nutzt Aufmerksamkeitsmechanismen, um sich auf domänenunabhängige semantische Regionen zu konzentrieren. Ein Risserkennungsmodell mit einem räumlichen Aufmerksamkeitsmodul lernt, sich unabhängig von der Hintergrundbelagstextur auf Rissstrukturen zu konzentrieren. Die Aufmerksamkeitskarten selbst werden domäneninvarianter als die rohen Merkmalskarten, da sie aufgabenrelevante räumliche Positionen hervorheben, während sie domänenspezifische Hintergründe unterdrücken. Cross-Attention zwischen Quell- und Zielmerkmalen verstärkt dies weiter, indem es aufmerksame Regionen explizit über Domänen hinweg abgleicht.
Selbstüberwachte Domain Adaptation-Methoden verwenden Vorwandaufgaben wie Rotationsvorhersage, Puzzle-Lösen oder kontrastive Instanzdiskriminierung, um Merkmale zu lernen, die robust gegenüber Domänenvariation sind, ohne dass Domänenlabels erforderlich sind. Durch das Lösen dieser Hilfsaufgaben lernt das Modell, strukturelle und geometrische Eigenschaften der Eingabe zu erfassen, die über Domänen hinweg gemeinsam sind. Die selbstüberwachten vortrainierten Merkmale weisen oft eine stärkere Domäneninvarianz auf als rein überwachte Merkmale, da die Vorwandaufgaben nicht von domänenspezifischen Labelverteilungen abhängen.
Anpassung von der Straße zur Startbahn
Der Übergang von der Straßenbelagsinspektion zur Inspektion von Startbahnen stellt eines der anspruchsvollsten Domain-Adaptation-Probleme im Infrastruktur-Anlagenmanagement dar. Straßen und Startbahnen sind grundlegend unterschiedliche technische Bauwerke, die für unterschiedliche Lasten, Geschwindigkeiten und Sicherheitsanforderungen ausgelegt sind, was zu dramatisch unterschiedlichen visuellen Erscheinungsbildern und Schadenseigenschaften führt.
| Faktor | Straßenbelag | Startbahnbelag |
|---|---|---|
| Planungsstandard | Variiert nach Rechtsordnung | ICAO Annex 14 / FAA-Standards |
| Last pro Achse | ~10 Tonnen (Fahrzeuge) | 50–400 Tonnen (Flugzeuge) |
| Primäres Oberflächenmaterial | Asphalt (HMA) | Hochfester PCC-Beton (üblich) oder Schwerlastasphalt |
| Markierungen | Gelbe/weiße Fahrbahnmarkierungen (mehrere Farben) | Nur weiße Markierungen, komplexe Muster (Schwelle, Aufsetzzone, Zielpunkt, Mittellinie) |
| Primäre Schadensarten | Risse, Schlaglöcher, Spurrinnen, Ausbluten | Risse, FOD, Gummiablagerungen, Abrieb, Reibungsverlust, Strahltriebwerkserosion, Treibstoffschäden |
| Inspektionszugang | Öffentliche Straßen, einfacher uneingeschränkter Zugang | Eingeschränkter Vorfeldbereich, erfordert Flugplatzausweis, Fahrzeugeskorte, Funkkommunikation |
| Dominante Aufnahmemethode | Bodenfahrzeuge, Smartphones, manuell | UAV in 30–100 m Höhe, spezielle Inspektionsfahrzeuge |
| Oberflächenverunreinigungen | Wasser, Schnee, Schmutz, Öl | Wasser, Gummi (kritisch, Aufsetzzonen), Enteisungsflüssigkeiten, Kerosin, Hydraulikflüssigkeit |
| Sicherheitskritischer Reibungsparameter | Griffigkeit für Bremsen | Bremswirkungskoeffizient für landende Flugzeuge (ICAO GRF-Kategorien) |
| Regulierungsrahmen | FHWA, staatliche DOT-Standards | ICAO Annex 14, Doc 9137, FAA ACs |
Gummiablagerungsinterferenz ist das mit Abstand schwierigste Anpassungsproblem. Flugzeugreifen hinterlassen bei der Landung Gummi auf Startbahnen, insbesondere in der Aufsetzzone, der sich als dunkle, durchgehende Flecken auf der Belagsoberfläche ansammelt. Diese Gummiablagerungen können Risse visuell imitieren oder verdecken. Ein straßentrainiertes Risserkennungsmodell, das noch nie auf Reifengummiablagerungen gestoßen ist, kann entweder Risse unter Gummiflecken nicht erkennen oder Gummifleckenränder fälschlicherweise als Risse klassifizieren. Die Anpassung von der Straße zur Startbahn muss daher die Modellierung von Gummiablagerungen beinhalten, entweder durch synthetische Augmentierung von Trainingsdaten oder durch Domain-Adaptation-Methoden, die lernen, Gummi von Rissen zu unterscheiden.
Skalierungs- und Auflösungsunterschiede sind eine weitere bedeutende Anpassungsbarriere. Straßeninspektionsbilder werden typischerweise von Bodenebene aus Entfernungen von 1–5 Metern aufgenommen, was eine sehr hohe Auflösung ergibt, bei der einzelne Risskanten Dutzende von Pixeln überspannen. Die Startbahninspektion mit UAVs in 30–100 m Höhe erzeugt Bilder mit gröberer Auflösung. Ein Riss, der in einem Straßenbild 50 Pixel überspannt, kann in einem aus der Höhe aufgenommenen Startbahnbild nur 5–10 Pixel überspannen. Die rezeptiven Felder und skalierungsabhängigen Filter des Merkmalsextraktors müssen sich an diesen Unterschied im räumlichen Frequenzgehalt anpassen. Mehrskalige Merkmalspyramiden und skalierungsinvariantes Training sind wesentliche Anpassungskomponenten.
Schadensdefinitionsdiskrepanz erfordert eine sorgfältige Zuordnung zwischen den Taxonomien von Straßen- und Startbahnschäden. Das FHWA LTPP Distress Identification Manual definiert Straßenbelagsschäden in Kategorien, die teilweise mit den von ASTM D5340 und ICAO Doc 9137 Part 9 definierten Flughafenbelagsschäden überlappen. Einige Schadensarten sind einzigartig für Flugplätze: Gummiablagerungen, Strahltriebwerkserosion, Treibstoffschäden und Reibungsverlust haben keine Entsprechung im Straßenbau. Straßentrainierte Modelle benötigen daher entweder neue Ausgabeklassen, die während der Anpassung hinzugefügt werden, oder einen hierarchischen Klassifikationsansatz, der zuerst generische Schäden erkennt und sie dann in domänenspezifische Kategorien einordnet.
Einhaltung gesetzlicher Vorschriften fügt eine weitere Ebene der Anpassungsanforderung hinzu. Straßeninspektionsmodelle erzeugen Ausgaben, die die Wartungspriorisierung durch DOT-Behörden unterstützen. Startbahninspektionsmodelle müssen Ausgaben erzeugen, die den von ICAO und FAA vorgeschriebenen Meldeformaten entsprechen: den Zustandskategorien des Global Reporting Format (GRF), dem Pavement Condition Index (PCI) gemäß ASTM D5340 und den Pavement Classification Number (PCN)-Bewertungen. Der Anpassungsprozess muss daher auch die Ausgaberepräsentation des Modells an die regulatorischen Melde standards anpassen.
Progressive Domänenüberbrückung, das Training auf Zwischendatensätzen, die die Lücke von der Straße zur Startbahn allmählich überbrücken, hat sich als effektiv erwiesen. Eine typische Überbrückungspipeline verwendet drei Stufen: Erstens Training auf Straßendatensätzen (CQU-BPDD, RDD2020, Crack500), zweitens Anpassung an allgemeine Belagsdatensätze, die sowohl Asphalt- als auch Betonoberflächen umfassen, drittens Anpassung an startbahnspezifische Datensätze mit Gummiablagerungen und Flugplatzmarkierungen. Jede Stufe reduziert die Verteilungslücke, die die nächste Stufe überbrücken muss, und ermöglicht so eine stabilere und effektivere Anpassung als die direkte Übertragung von der Straße zur Startbahn.
Anpassung an verschiedene Klimabedingungen
Klimabedingungen führen zu Domänenvariation, die zeitlich (sich im Laufe der Zeit an einem einzigen Standort ändernd) und geografisch (gleichzeitig an verschiedenen Standorten variierend) ist. Ein Modell, das auf mehreren Flughäfen eingesetzt wird, muss beide Dimensionen bewältigen.
Anpassung an nasse vs. trockene Oberflächen ist kritisch, da die Zustandskategorien der Startbahnoberfläche nach dem ICAO Global Reporting Format explizit zwischen trockenen, nassen, rutschig nassen und kontaminierten Oberflächen unterscheiden. Nasse Oberflächen verändern die Rissichtbarkeit auf verschiedene Weise. Wasser, das Risse füllt, verringert den Kontrast zwischen dem Riss und dem umgebenden Belag. Trockene Risse erscheinen als kontrastreiche dunkle oder helle lineare Merkmale, aber wassergefüllte Risse erscheinen als kontrastarme Merkmale, die für ein auf trockene Oberflächen trainiertes Modell nahezu unsichtbar sein können. Wasserfilm auf der Belagsoberfläche erzeugt spiegelnde Reflexionen, die helle Regionen und falsche Kanten einführen und Rissdetektoren verwirren. Nasser Belag erscheint auch insgesamt dunkler, verschiebt das Bildhistogramm und verändert die Statistik jeder Schicht im Netzwerk.
Anpassung an kaltes Klima adressiert Frost-Tau-Effekte, die das Belagserscheinungsbild verändern. Gefrorene Oberflächen haben andere Reflexionseigenschaften als ungefrorene Oberflächen. Eisflächen auf dem Belag erscheinen als glatte, stark reflektierende Regionen, die visuelle Eigenschaften mit Belagsoberflächenschäden teilen. Schneebedeckung verdeckt Oberflächenschäden teilweise oder vollständig. Der Übergang zwischen Frost-Tau-Zyklen erzeugt einzigartige Schadensmuster (D-Cracking, Frost-Tau-Abplatzungen, Frostaufbrüche), die auf warmem Klima trainierte Modelle möglicherweise nicht erkennen.
Daten-Augmentierung für die Klimaanpassung erzeugt synthetisch Ziel-Domänen-Variationen aus Quell-Domänen-Bildern. Das Hinzufügen simulierter Regenstreifen, Nassoberflächen-Reflexionsmodelle, Schneebedeckungsmasken und Schattenüberlagerungen kann die Abdeckung der Quelldomäne auf Klimabedingungen ausdehnen, die in den ursprünglichen Trainingsdaten nicht vorhanden sind. RandAugment-Richtlinien mit spezifischen photometrischen Transformationen, die auf Helligkeit, Kontrast und Farbtemperaturverschiebungen abzielen, sind besonders effektiv für die Klimaanpassung. Studien zeigen, dass reine Augmentierungsansätze 50–70 % der durch Beleuchtungs- und Wetter-Domain-Shifts verlorenen Leistung zurückgewinnen, was sie zu einer kosteneffektiven Ergänzung zu komplexeren adversariellen oder diskrepanzbasierten Methoden macht.
CycleGAN-basierte Domänenübersetzung bietet eine Alternative, indem sie lernt, Bilder zwischen Klimabedingungen zu übersetzen. Ein CycleGAN, das auf gepaarten oder ungepaarten Bildern von trockenen und nassen Startbahnen trainiert wurde, lernt, von der trockenen Domäne in die nasse Domäne abzubilden, während Risspositionen und -geometrien erhalten bleiben. Risserkennungsmodelle, die auf diesen augmentierten Daten trainiert werden, lernen Merkmale, die gegenüber dem Vorhandensein oder Fehlen von Wasser auf der Oberfläche invariant sind. Der Nachteil ist die Trainingskomplexität von GANs und das Risiko, während der Übersetzung Rissmerkmale zu halluzinieren oder zu entfernen.
Anpassung an verschiedene Kameratypen
Infrastrukturinspektionssysteme verwenden eine Vielzahl von Bildgebungsplattformen, jede mit unterschiedlichen optischen Eigenschaften, die Domain Shift verursachen. Die Anpassung an verschiedene Kameratypen ist für jedes System, das auf mehreren Flughäfen eingesetzt wird, unerlässlich, da vorhandene Bilder möglicherweise aus verschiedenen Quellen stammen.
Auflösung und Ground Sampling Distance (GSD) variieren stark. Bodennahe Inspektion mit einer 50 MP DSLR erzeugt GSDs von 0,1–0,5 mm/Pixel. UAV-Inspektion in 30 m Höhe erzeugt 0,5–1 cm/Pixel. UAV-Inspektion in 100 m Höhe erzeugt 2–5 cm/Pixel. Satellitenbilder können eine Auflösung von 30–50 cm/Pixel haben. Ein 3 mm breiter Riss überspannt 6–30 Pixel auf Bodenebene, 0,3–0,6 Pixel in 30 m UAV-Höhe und ist bei 100 m subpixelig. Modelle, die auf hochauflösenden Bodenbildern trainiert wurden, können Merkmale bei gröberen Auflösungen nicht direkt erkennen. Multi-Resolution-Training, das Training auf Bildern mit mehreren Auflösungsskalen, ist die primäre Strategie. Der Merkmalsextraktor lernt skalierungsinvariante Repräsentationen durch Pyramid Pooling, dilatierte Faltungen oder auflösungsadaptive Normalisierung.
Unterschiede in der spektralen Empfindlichkeit des Sensors zwischen Kameras beeinflussen die Farbdarstellung. Verschiedene CMOS- und CCD-Sensoren haben unterschiedliche Quanteneffizienzkurven über das sichtbare Spektrum, was bedeutet, dass dieselbe Oberfläche von verschiedenen Kameras mit leicht unterschiedlichen RGB-Werten erscheint. Farbkalibrierung mit einer Farbkarte während der Datenerfassung reduziert diese Verschiebung, ist aber für groß angelegte Inspektionsprogramme selten praktikabel. Histogrammabgleich und Farbübertragung zwischen Quell- und Zielbildern sind Vorverarbeitungsalternativen. Anspruchsvollere Ansätze umfassen sensorinvariantes Merkmalslernen, das sensorspezifische Farbinformationen explizit aus Merkmalsrepräsentationen durch Farbjitter-Augmentierung während des Trainings entfernt.
Linsenverzerrung variiert je nach Kamera- und Objektivkombination. Weitwinkelobjektive, die für eine effiziente Startbahnabdeckung verwendet werden, führen zu tonnenförmiger Verzerrung, die die Rissgeometrie verändert. Gerade Risse können in der Nähe von Bildrändern gekrümmt erscheinen. Für Erkennungsaufgaben beeinflusst diese Verzerrung die räumliche Beziehung zwischen Bildmerkmalen. Verzerrungskorrektur als Vorverarbeitungsschritt normalisiert alle Bilder auf eine gemeinsame entzerrte Geometrie, bevor sie dem Modell zugeführt werden. Alternativ macht das Training auf Bildern mit synthetischer Verzerrungs-Augmentierung das Modell robust gegenüber unterschiedlichen Verzerrungsgraden.
Rolling-Shutter-Effekte von UAV-Plattformen führen während des Flugs zu geometrischer Verzerrung, insbesondere bei hoher Geschwindigkeit oder windigen Bedingungen. Die sequentielle Belichtung von Zeilen in einem Rolling-Shutter-CMOS-Sensor bedeutet, dass Kamerabewegung während der Belichtung zu verzerrter oder verzerrter Rissgeometrie führt. Diese zeitliche Verzerrung fehlt bei Global-Shutter-Kameras und bei statischer Aufnahme auf Bodenebene. Die Anpassung erfordert entweder eine Vorverarbeitung zur Korrektur von Rolling-Shutter-Artefakten oder ein Training auf Daten, die eine synthetische Rolling-Shutter-Verschlechterung enthalten.
| Kameravariation | Anpassungsstrategie | Implementierungskomplexität | Typische Wiederherstellung |
|---|---|---|---|
| Auflösung / GSD | Multi-Resolution-Training + Pyramid Pooling | Moderat | 5–10 % Genauigkeitswiederherstellung |
| Sensor-Farbantwort | Farbjitter-Augmentierung + Histogrammabgleich | Niedrig | 3–7 % Genauigkeitswiederherstellung |
| Linsenverzerrung | Verzerrungskorrektur-Vorverarbeitung | Niedrig | 2–5 % Genauigkeitswiederherstellung |
| Rolling Shutter | Synthetische Rolling-Shutter-Augmentierung | Moderat | 3–6 % Genauigkeitswiederherstellung |
| Kompressionsartefakte | JPEG-Kompressions-Augmentierung | Niedrig | 1–3 % Genauigkeitswiederherstellung |
Mathematische Grundlagen und Schlüsselformulierungen
Das Verständnis von Domain Adaptation erfordert Vertrautheit mit mehreren Kernformulierungen. Das Empirical Risk Minimization (ERM)-Framework bietet den Ausgangspunkt. Gegeben eine Quelldomäne mit beschrifteten Stichproben ({(x_i^S, y_i^S)}_{i=1}^{n_S}) minimiert ein Standardmodell das empirische Risiko:
(\hat{R}S(\theta) = \frac{1}{n_S}\sum{i=1}^{n_S} \ell(f_\theta(x_i^S), y_i^S))
wobei (\ell) die aufgabenspezifische Verlustfunktion ist (Kreuzentropie für Klassifikation, Dice-Verlust für Segmentierung). Domain Adaptation zielt darauf ab, das Zielrisiko zu minimieren:
(R_T(\theta) = \mathbb{E}{(x, y) \sim P_T}[\ell(f\theta(x), y)])
Die Herausforderung besteht darin, dass (R_T) nicht direkt minimiert werden kann, wenn Ziellabels nicht verfügbar sind. Domain-Adaptation-Methoden begrenzen das Zielrisiko durch die Summe des Quellrisikos und eines Divergenzmaßes zwischen Quell- und Zielverteilungen.
Die H-Divergenz liefert eine theoretische Grenze für Domain Adaptation (Ben-David et al., 2010). Für eine Hypothesenklasse (\mathcal{H}) ist die H-Divergenz zwischen Quell- und Zielverteilungen:
(d_{\mathcal{H}}(D_S, D_T) = 2 \sup_{h \in \mathcal{H}} \left| \Pr_{x \sim D_S}[h(x) = 1] - \Pr_{x \sim D_T}[h(x) = 1] \right|)
In der Praxis wird die H-Divergenz durch Training eines Klassifikators geschätzt, der zwischen Quell- und Ziel-Domänen-Stichproben unterscheidet – genau das, was der Domänenklassifikator in DANN tut. Das theoretische Ergebnis garantiert, dass ein auf Quelldaten trainiertes Modell auf die Zieldomäne generalisiert, wenn die H-Divergenz zwischen den Domänen klein ist. Dies liefert die formale Rechtfertigung für adversarielle Domain Adaptation.
Das MMD in funktionaler Form verwendet einen charakteristischen Kernel (k), um Wahrscheinlichkeitsverteilungen in einen RKHS einzubetten:
(MMD(P_S, P_T) = \sup_{|f|{\mathcal{H}} \leq 1} (\mathbb{E}{x \sim P_S}[f(x)] - \mathbb{E}_{x \sim P_T}[f(x)]))
Mit dem Gaußschen Kernel (k(x, y) = \exp(-|x - y|^2 / 2\sigma^2)) kann das quadrierte MMD direkt aus Stichprobenmittelwerten berechnet werden:
(MMD^2 = \frac{1}{n_S^2}\sum_{i,j} k(x_i^S, x_j^S) + \frac{1}{n_T^2}\sum_{i,j} k(x_i^T, x_j^T) - \frac{2}{n_S n_T}\sum_{i,j} k(x_i^S, x_j^T))
Der CORAL-Verlust gleicht Statistiken zweiter Ordnung aus:
(\mathcal{L}_{CORAL} = \frac{1}{4d^2}|C_S - C_T|_F^2)
wobei (C_S = \frac{1}{n_S - 1}(\mathbf{F}_S^\top \mathbf{F}_S - \frac{1}{n_S}(\mathbf{1}^\top \mathbf{F}_S)^\top (\mathbf{1}^\top \mathbf{F}_S))) und (C_T) analog für Zielmerkmale definiert ist. Die Frobenius-Norm (|\cdot|_F) ist die elementweise Summe der Quadrate.
Diese mathematischen Grundlagen übersetzen sich direkt in die praktische Implementierung. Der Domain-Adaptation-Verlust für ein Deep CORAL-Netzwerk ist:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) + \lambda{CORAL} \cdot \mathcal{L}_{CORAL}(\mathbf{F}_S, \mathbf{F}_T))
Für ein DANN-Netzwerk:
(\mathcal{L} = \mathcal{L}{task}(D_S, Y_S) - \lambda{DANN} \cdot \mathcal{L}_{domain}(\mathbf{F}_S, \mathbf{F}_T, \mathbf{D}))
wobei (\mathbf{D} = {0, 1}) die Quell- (0) oder Zieldomäne (1) angibt und das negative Vorzeichen die Gradientenumkehr widerspiegelt.
| Methode | Zielfunktion | Schlüssel-Hyperparameter |
|---|---|---|
| ERM (keine Anpassung) | (\mathcal{L} = \mathcal{L}_{task}(D_S, Y_S)) | Lernrate, Gewichtsabfall |
| DANN | (\mathcal{L} = \mathcal{L}{task} - \lambda \mathcal{L}{domain}) | (\lambda) (Anpassungsstärke), GRL-Plan |
| DAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l MMD_l^2) | (\lambda_l) pro Schicht, Kernel-Bandbreite (\sigma) |
| Deep CORAL | (\mathcal{L} = \mathcal{L}_{task} + \lambda |C_S - C_T|_F^2) | (\lambda) (Ausrichtungsgewicht) |
| JAN | (\mathcal{L} = \mathcal{L}_{task} + \sum_l \lambda_l JMMD_l) | Schichtpaare, Kernel-Bandbreiten |
| Feinabstimmung | (\mathcal{L} = \mathcal{L}_{task}(D_T, Y_T)) reduzierte LR | Einfrierplan, LR-Reduktionsfaktor |
Evaluationsprotokolle für Domain Adaptation
Die Bewertung von Domain-Adaptation-Methoden erfordert standardisierte datensatzübergreifende Benchmarks, die die Leistung auf Zieldomänen messen, die während des Trainings nicht gesehen wurden. Für die Infrastrukturinspektion wurden mehrere Benchmark-Protokolle etabliert.
Datensatzübergreifende Evaluierung ist das Standardprotokoll. Das Modell wird auf einem Quelldatensatz (z. B. CQU-BPDD, der Bitumenbelags-Rissbilder enthält) trainiert und auf einem Zieldatensatz (z. B. RDD2020, der Straßenrissbilder aus mehreren Ländern enthält) evaluiert. Die Leistung auf dem Zieldatensatz vor der Anpassung dient als Quell-nur-Baseline. Die Leistung nach der Anpassung (mit Zugang zu unbeschrifteten Zieldaten für UDA oder begrenzten beschrifteten Zieldaten für SDA) wird gegen diese Baseline gemessen. Der Anpassungsgewinn, die Differenz zwischen angepasster und nicht angepasster Leistung, quantifiziert die Wirksamkeit der Anpassungsmethode.
Gängige Benchmarks für die Risserkennung in Belägen umfassen: CQU-BPDD (Bituminous Pavement Crack Dataset) mit 60.088 Bildern von Asphaltbelagsrissen aus China, RDD2020 mit 26.336 Bildern von Straßenrissen aus Indien, Japan und der Tschechischen Republik, Crack500 mit 500 hochauflösenden Bildern von Belagsrissen von Straßenoberflächen, DeepCrack mit 537 Bildern von Gebäudewandrissen und SDNET2018 mit 56.000 Bildern von Betonbrückenfahrbahnen, -wänden und -belägen. Die datensatzübergreifende Evaluierung über diese Datensätze hinweg, insbesondere von CQU-BPDD zu RDD2020, die eine länder- und klimaübergreifende Übertragung darstellt, ist der strengste Benchmark.
Metriken für die Bewertung der Domain Adaptation umfassen Zieldomänen-mIoU (mittlerer Intersection over Union für Segmentierungsaufgaben), Zieldomänen-F1-Score (für Erkennungsaufgaben), Quellbeibehaltung (Quelldomänenleistung nach der Anpassung, zur Messung des katastrophalen Vergessens), Anpassungsgewinn (prozentuale Punktverbesserung gegenüber der Quell-nur-Baseline) und Label-Effizienz (wie viele beschriftete Zieldaten benötigt werden, um ein bestimmtes Leistungsniveau für überwachte Methoden zu erreichen).
Statistische Signifikanz-Tests sind unerlässlich, da Domain-Adaptation-Ergebnisse verrauscht sein können. Mehrere Läufe mit verschiedenen Zufallskeimen (typischerweise 5–10) werden verwendet, um Mittelwert und Standardabweichung der Leistungsmetriken zu berechnen. Der Wilcoxon-Vorzeichen-Rang-Test oder der gepaarte t-Test wird verwendet, um festzustellen, ob Leistungsunterschiede zwischen Anpassungsmethoden bei konventionellen Schwellenwerten ((p < 0,05)) statistisch signifikant sind.
Für die Infrastrukturinspektion sind zusätzliche einsatzspezifische Metriken relevant: Falsch-Positiv-Rate bei operativen Schweregradschwellen (ein Rissdetektor, der 100 Fehlalarme pro Startbahninspektion erzeugt, ist betrieblich unbrauchbar, unabhängig von seinem mIoU), Inferenzzeit pro Flächeneinheit (die Anpassung sollte die Verarbeitungszeit nicht wesentlich erhöhen) und Speicherbedarf (Adapter-basierte Methoden sollten minimalen Speicher-Overhead pro zusätzlichem Flughafen hinzufügen).
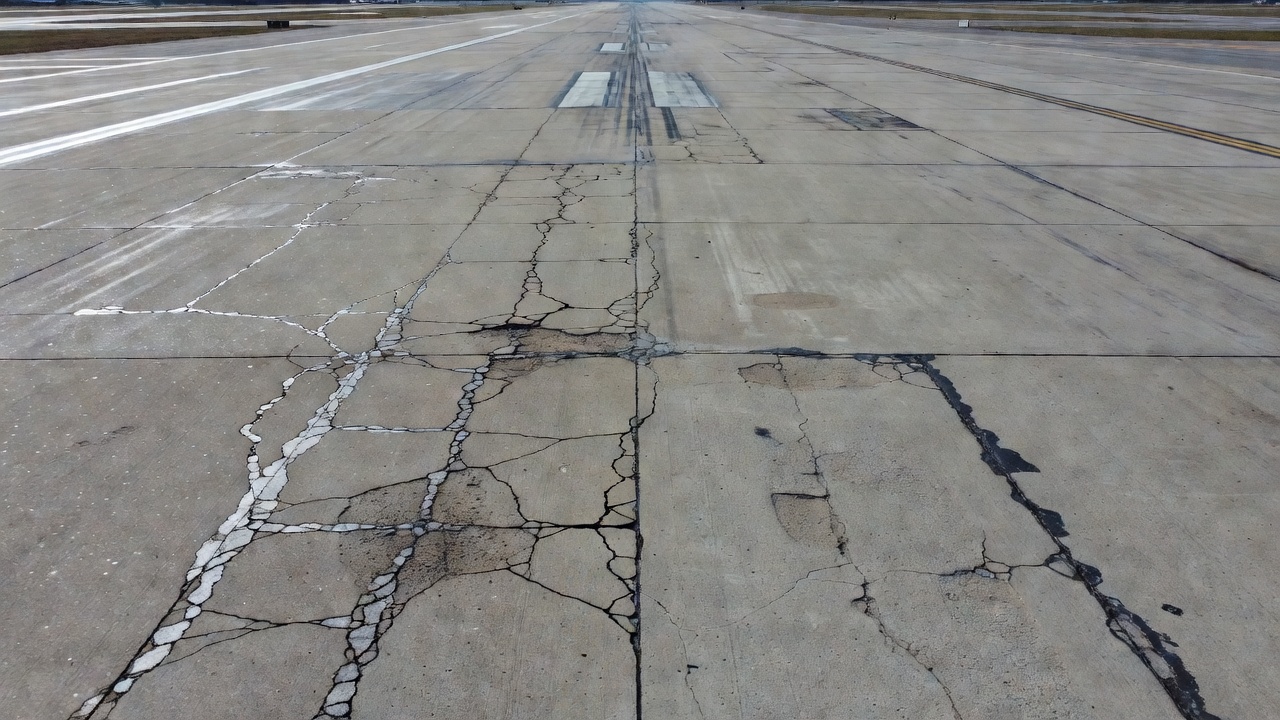
Wichtige Standards und Referenzen
Die Praxis der Domain Adaptation für die Infrastrukturinspektion stützt sich auf Standards und Forschung aus mehreren Disziplinen.
Grundlagen des maschinellen Lernens: Ganin et al., “Domain-Adversarial Training of Neural Networks” (Journal of Machine Learning Research, 2016), das kanonische DANN-Papier, das die Gradientenumkehr einführt. Long et al., “Learning Transferable Features with Deep Adaptation Networks” (ICML, 2015), das MMD-basierte mehrschichtige Domänenausrichtung einführt. Sun und Saenko, “Deep CORAL: Correlation Alignment for Deep Domain Adaptation” (ECCV, 2016), das kovarianzbasierte Ausrichtung einführt. Ben-David et al., “A theory of learning from different domains” (Machine Learning, 2010), der theoretische Rahmen für Generalisierungsgrenzen der Domain Adaptation.
Domain Adaptation für die Infrastrukturinspektion: Liu et al., “DDACRN: Deep Domain Adaptation-based Crack Detection Network” (IEEE Transactions on Intelligent Transportation Systems, 2023), die primäre Referenz für die Domain Adaptation der Risserkennung mit einer Zwei-Zweig-Architektur mit gemeinsamen Gewichten. “DACrack: Unsupervised Domain Adaptation for Crack Detection” (Automation in Construction, 2023), mehrstufige Merkmalsausrichtung für datensatzübergreifende Risserkennung. Wang, Nguyen, Eick et al., “Efficient Domain Adaptation Network for Corrosion Segmentation in Infrastructure” (Journal of Civil Structural Health Monitoring, 2025), Drei-Modul-Diskrepanz-Framework für Infrastrukturkorrosion.
ICAO- und FAA-Standards: ICAO Annex 14, Aerodromes, Volume I (8. Ausgabe, 2018 mit Änderungen), primärer internationaler Standard für die Flugplatzzertifizierung, der den Domain-Shift-Kontext zwischen Flughäfen schafft. ICAO Doc 9137, Part 9, Airport Services Manual, Airport Maintenance Practices, Wartungsleitlinien für Beläge. ICAO Global Reporting Format (GRF) for Runway Surface Conditions (wirksam November 2021), Definition von Oberflächenzustandsdomänen (trocken, nass, kontaminiert). FAA AC 150/5380-6C, Guidelines and Procedures for Maintenance of Airport Pavements. ASTM D5340, Standard Test Method for Airport Pavement Condition Index Surveys, der quantitative Rahmen für die Belagszustandsbewertung, den domänenangepasste Modelle unterstützen müssen.
Belagsdatensätze: CQU-BPDD (Chongqing University, 60.088 Asphaltbelags-Rissbilder). RDD2020 (8.300+ Straßenbilder aus Indien, Japan, Tschechische Republik). Crack500 (500 hochauflösende Belagsrissbilder). SDNET2018 (56.000 Brückenfahrbahn-, Wand- und Belagsbilder von der Utah State University). Diese Datensätze bieten die standardisierten Benchmarks für die Bewertung der Domain Adaptation in der Belagsinspektion.
Häufig gestellte Fragen
- Was ist Domain Adaptation im maschinellen Lernen?
- Domain Adaptation ist ein Teilgebiet des Transfer Learnings, das das Problem des Domain Shift adressiert, bei dem ein auf einem Quelldatensatz trainiertes Modell bei der Bereitstellung auf einem Zieldatensatz mit anderen statistischen Eigenschaften schlecht abschneidet. Das Ziel ist es, domäneninvariante Merkmalsrepräsentationen zu lernen, damit das Modell über Domänen hinweg generalisiert, ohne ein vollständiges Neutraining auf beschrifteten Zieldaten zu erfordern. Domain Adaptation wird in überwachte (begrenzte beschriftete Zieldaten verfügbar), unüberwachte (keine beschrifteten Zieldaten) und semi-überwachte (einige beschriftete plus unbeschriftete Zieldaten) Varianten unterteilt.
- Wie wirkt sich Domain Shift auf Modelle zur Risserkennung in Belägen aus?
- Domain Shift bei der Risserkennung in Belägen verursacht Leistungseinbußen von 30–45 % im mittleren Intersection over Union (mIoU) beim Wechsel von einem Datensatz zu einem anderen. Ursachen für den Shift sind Unterschiede im Oberflächenmaterial (Asphalt vs. Beton), Variationen der Rissmorphologie (Längsrisse vs. Netzrisse), Änderungen der Aufnahmebedingungen (Lichtwinkel, Auflösung, Kamerasensor) und geografische Faktoren (verschiedene Gesteinskörnungen und Alterungsmuster). Beispielsweise erreicht ein auf dem CQU-BPDD-Datensatz trainiertes Modell 0,72 mIoU auf Quelldaten, fällt aber auf 0,31, wenn es ohne Anpassung auf RDD2020-Zieldaten getestet wird.
- Was ist der Unterschied zwischen Transfer Learning und Domain Adaptation?
- Transfer Learning passt ein auf einer Aufgabe vortrainiertes Modell an, um eine andere Aufgabe auszuführen, zum Beispiel die Feinabstimmung eines ImageNet-Klassifikationsmodells für die Risserkennung. Domain Adaptation adressiert dieselbe Aufgabe über verschiedene Datenverteilungen hinweg, zum Beispiel die Anpassung eines Asphalt-Rissdetektors an die Erkennung von Rissen auf Betonoberflächen. Beim Transfer Learning können sich Quell- und Zielaufgabe unterscheiden, bei der Domain Adaptation ist die Aufgabe identisch, aber die Eingabeverteilungen unterscheiden sich.
- Was sind domäneninvariante Merkmale?
- Domäneninvariante Merkmale sind Repräsentationen, die von einem neuronalen Netz extrahiert werden und unabhängig davon, aus welcher Domäne die Eingabe stammt, dieselbe statistische Verteilung aufweisen. Wenn ein Risserkennungsnetzwerk Merkmale lernt, die gleich aussehen, egal ob die Eingabe ein Asphaltstraßen- oder ein Betonstartbahnbild ist, sind diese Merkmale domäneninvariant. Sie werden durch adversariales Training (ein Domänendiskriminator kann nicht sagen, aus welcher Domäne Merkmale stammen), statistisches Moment-Matching (MMD, CORAL) oder optimale Transporttechniken gelernt. Die grundlegende Herausforderung ist der Invarianz-Diskriminierbarkeits-Kompromiss: Das Erzwingen zu starker Domäneninvarianz kann aufgabenrelevante Informationen wie die Rissstruktur entfernen, die mit der Oberflächenart korreliert.
- Wie funktioniert unüberwachte Domain Adaptation?
- Unüberwachte Domain Adaptation (UDA) verwendet beschriftete Quelldaten und unbeschriftete Zieldaten, um ein Modell zu trainieren, das auf die Zieldomäne generalisiert. Die drei Hauptansätze sind: (1) adversarielle Methoden wie DANN, bei denen ein Domänendiskriminator versucht zu identifizieren, aus welcher Domäne Merkmale stammen, während der Merkmalsextraktor versucht, ihn zu täuschen, (2) diskrepanzbasierte Methoden wie DeepCORAL und DAN, die statistische Distanzmaße (MMD, Kovarianzdifferenz) zwischen Quell- und Zielmerkmalverteilungen minimieren, und (3) rekonstruktionsbasierte Methoden, die Autoencoder oder GANs verwenden, um gemeinsame Repräsentationen zu lernen.
- Welche Herausforderungen gibt es bei der Anpassung von der Straßen- zur Startbahninspektion?
- Die Domain Adaptation von der Straße zur Startbahn steht vor grundlegenden Unterschieden im Oberflächenmaterial (Asphalt vs. hochfester PCC-Beton), den Lasteigenschaften (10-Tonnen-Fahrzeugachsen vs. 50–400 Tonnen Flugzeuglasten), den Schadensarten (Gummiablagerungen, Strahltriebwerkserosion, Treibstoffschäden auf Startbahnen), dem Inspektionszugang (öffentliche Straßen vs. eingeschränkter Vorfeldbereich), den Bildaufnahmemethoden (Bodenfahrzeuge vs. UAV in 30–100 m Höhe) und der Einhaltung von Vorschriften (ICAO Annex 14 Standards). Besonders herausfordernd sind Gummiablagerungen: Flugzeugreifengummi sammelt sich als dunkle Flecken auf Startbahnen, die Risse imitieren oder verdecken können – ein Zustand, den Straßenmodelle nie antreffen.
- Was ist das Domain-Adversarial Neural Network (DANN)?
- Das Domain-Adversarial Neural Network (DANN), eingeführt von Ganin und Lempitsky im Jahr 2015, ist die kanonische Architektur für adversarielle Domain Adaptation. Es besteht aus drei Komponenten: einem Merkmalsextraktor, der Eingaben in einen gemeinsamen Merkmalsraum abbildet, einem Label-Prädiktor, der die Aufgabe ausführt (z. B. Rissklassifikation), und einem Domänenklassifikator, der vorhersagt, aus welcher Domäne die Eingabe stammt. Eine Gradient Reversal Layer (GRL) sitzt zwischen Merkmalsextraktor und Domänenklassifikator. Während der Rückwärtspropagation kehrt sie das Gradientenvorzeichen um, wodurch der Merkmalsextraktor lernt, Merkmale zu extrahieren, die die Domänenverwirrung maximieren. Der Gesamtverlust kombiniert den Aufgabenverlust auf Quell-Labels minus den Domänenklassifikationsverlust, gewichtet durch einen Hyperparameter Lambda.
- Welche Domain-Adaptation-Strategien passen zu unterschiedlichen Mengen an Zieldaten?
- Die Strategie folgt den verfügbaren Zieldaten. Vollständige Feinabstimmung eignet sich für moderate Mengen beschrifteter Zieldaten, letzte Schicht- oder Adapter-basierte Abstimmung für sehr begrenzte beschriftete Daten, und unüberwachte Adaptation unter Verwendung von Batch-Normalisierungsstatistiken und Merkmalsabgleich wird verwendet, wenn keine Ziel-Labels existieren. Progressives Auftauen und auf die Zielaufnahmebedingungen zugeschnittene Augmentierung helfen dem angepassten Modell, das Gelernte aus der Quelldomäne zu bewahren.
- Was ist Maximum Mean Discrepancy (MMD)?
- Maximum Mean Discrepancy (MMD) ist ein kernelbasierter statistischer Test, der verwendet wird, um den Abstand zwischen zwei Wahrscheinlichkeitsverteilungen in einem Reproducing Kernel Hilbert Space (RKHS) zu messen. In der Domain Adaptation wird MMD als Verlustfunktion verwendet, um die Verteilungslücke zwischen Quell- und Zielmerkmalrepräsentationen zu minimieren. Die MMD-Formel berechnet die Norm der Differenz zwischen den mittleren Einbettungen von Quell- und Zielmerkmalen im RKHS. Deep Adaptation Networks (DAN) und Joint Adaptation Networks (JAN) integrieren den MMD-Verlust auf mehreren Netzwerkschichten, um eine mehrstufige Domänenausrichtung zu erreichen.
- Welche ICAO-Standards beziehen sich auf Domain Adaptation für die Startbahninspektion?
- ICAO Annex 14 legt Standards für die Planung und den Betrieb von Flugplätzen fest, die eine natürliche Anforderung an Domain Adaptation schaffen: Verschiedene Flughäfen haben unterschiedliche Belagsmaterialien, Klimazonen und Wartungshistorien, daher müssen Inspektionsmodelle zwischen Flughäfen angepasst werden. Das Global Reporting Format (GRF) definiert Kategorien des Startbahnzustands (trocken, nass, rutschig nass, kontaminiert), die unterschiedliche visuelle Domänen darstellen. ICAO Doc 9137 Teil 9 und FAA AC 150/5380-6C geben Wartungsleitlinien. Beim Einsatz KI-basierter Inspektion über mehrere Flughäfen ist Domain Adaptation unerlässlich, da ein auf Daten eines Flughafens trainiertes Modell auf andere Beleuchtung, Belagsalter und Schadensmorphologien trifft.
Dies ist ein Referenzeintrag. TarmacView bietet Drohneninspektionsdienste an und verkauft nicht die in diesem Glossar beschriebene Ausrüstung oder Materialien.